
零门槛造数字员工,门槛到底藏在哪?
一、这本书想让你干什么
先看它的形状。12 章,作者自己概括成四个阶段:认知、制作、案例、进阶。前 4 章解决“Skill 是什么、长什么样、有什么风险、去哪装”;5 到 8 章教“怎么做”——从一次对话里把专家脑子里的东西掏出来,写成工作流,配上知识库,再让脚本和 MCP 去干活;9 到 11 章是 9 个案例,公文、简历、数据分析、选题、公众号排版、视频播客、教学动画、出试卷、长文翻译;第 12 章讲怎么管一队数字员工。
它要教的东西其实就一句话:Skill 就是一个文件夹。里面一份 SKILL.md 写“什么情况下用我、第一步干什么第二步干什么、哪些事不许干”,一个 references/ 目录放知识和资料,一个 scripts/ 目录放脚本,一个 assets/ 目录放模板。就这么四样。作者反复画这个目录树,几乎每章末尾都画一遍,一开始觉得啰嗦,读到第 10 章发现是对的——因为读者真正的困难不是“理解概念”,是“我到底该建哪几个文件”。
这个定位让它在同类书里比较特别。市面上讲 AI 应用的书,多数停在“提示词怎么写”;讲智能体的书,多数停在“ReAct 循环怎么转”。这本既不碰提示词技巧,也不碰智能体原理,它只回答一个问题:怎么把一个人脑子里的专业判断,变成一台机器每次都能照着执行的流程。前言里作者自我介绍:“我是一个典型的技术信徒……第一次写计算机程序的时候大约只有 10 岁”,二十多年技术生涯,信息学奥赛保送。这个背景在书里的痕迹很明显:他讲案例时最兴奋的地方不是“AI 多神奇”,是“这三个脚本的接口终于对上了”。
第 12 章快结束时,作者把整本书的立意收成了这么一句:提示词让 AI 学会说话,工具调用给 AI 装上双手,MCP 让 AI 有了通用接口,智能体赋予了 AI 自主决策的灵魂,而 Skill 把这一切整合起来,让通用的 AI 变成了特定领域的专家。这句话有点宣传味,但方向没错——它确实是这条演进线上最靠“落地”的一环,因为前面几环都是模型厂商的事,这一环是用户自己的事。
二、全书最值钱的一句,藏在一个不起眼的小节里
6.6 节,标题叫“节省上下文”。这一节的核心判断只有一句话:
能在上下文外面干的活,就不要搬到上下文里面来干。
翻过去只要三秒钟,但整本书后面所有的工程判断都是从这句推出来的。作者给的例子很具体:一张 10 万行的销售表,如果让智能体读进去再算,上下文当场就爆了,算到一半还会开始丢三落四;正确做法是让脚本把表读完、算完,只把一句结论搬回对话里——“上月总销售额 320 万元,同比增长 12%”。
这句话之所以值钱,是因为它给了读者一把尺子。一件事该交给脚本还是交给 AI,不再靠感觉,而是看它需不需要判断。批量访问网站、提取正文、按编号重命名文件、切分长文、合并音视频,这些全是“不需要判断”的活,一行脚本能干一万次不出错,让大模型干则是又慢又贵又不稳。反过来,判断这份简历合不合岗位、这段文案配插画还是配动效、用户说的“翻译腔太重”到底指什么,这些脚本干不了,才轮到模型上场。
11.3 节的长文翻译 Skill 是这条原则推到极端的形态,作者自己也点明了它的特殊性:前面的案例里智能体是主力、脚本是辅助,这个 Skill 反过来,脚本是主力,智能体退到幕后。一本 5 万字的书,切成一两千字一片,二十多个片段,每个片段一次 API 调用,加上试译,总共二三十次请求,全程不占智能体的上下文。翻译 5 万字和翻译 5 千字,对智能体的负担是一样的——因为它根本没读原文。
三、三个真能直接抄的工程细节
这本书案例多,但真正有复用价值的工程手法就三个,作者都写到了可以照做的颗粒度。
第一个,知识与指令分离。SKILL.md 里只写流程,所有会变的东西——产品目录、术语表、筛选规则、公司制度——全部放 references/ 里。这样换一个业务领域,只换知识库,流程一个字都不用动。翻译 Skill 里的术语表就是典型:术语表是知识,翻译流程是指令,两者分开之后,“agent 该翻成智能体还是代理”这种争论只影响一个文件。作者还补了一句我觉得很实用的观察:术语表可以跨文档复用,你今天翻完一本 AI 技术书,攒下的术语表下次翻同领域的文档直接沿用,“翻译得越多,术语表越完善,这本身就是一种知识资产的积累”。
第二个,先把接口写死,再让 AI 写脚本。10.3 节的视频播客 Skill 要串三个脚本,作者的解法不是让 AI 一次写个大的,而是先定死中间那份分镜文件的字段名:
分镜脚本的字段名必须提前定死,不能随便改。它相当于整条流水线的合同,各个脚本按合同办事才不会出乱子。
配合的还有文件命名规则:语音脚本输出 segment_01.mp3,画面脚本输出 segment_01.jpg,合成脚本靠文件名里的编号把同一段的音频和画面配成一对。三个脚本谁都不用懂对方的代码,只认文件名。他给的一条经验我照着试过,确实管用:让 AI 写脚本时,在需求里附上输入输出的具体样例,格式和命名一贴出来,来回调试的次数能少一大半——比写三百字文字描述靠谱。
第三个,滑动窗口。长文切片翻译,每一片单独调用 API,片与片之间没有共享记忆,接缝处一定断气。作者的做法是:翻第二片时,把第一片最后几段原文和对应译文一起塞进提示词,让模型知道前面是什么语气、句子断在哪。他打了个比方,像接力赛的交接区,前一棒和后一棒有一段重叠的并跑距离。技术上这叫滑动窗口,但这个比方比术语好懂。
这三个细节之外,翻译那章还有一处设计我觉得是全书最聪明的:试译。全量翻一本 5 万字的书要花几十块、等半小时,如果翻完才发现风格不对,全部重来。所以流程里插了一步“只翻前两三片给你看”,用户读完提意见——“翻译腔太重”“术语直接留英文别硬翻”“段落太长帮我拆短”——这些全是模糊的人话,脚本听不懂。
用户说的是人话,脚本需要的是规则,智能体在中间做翻译。
这句是 11.3.4 节的收尾,也是我认为整本书对“人机分工”讲得最准的一句。智能体在这个流程里几乎不碰原文和译文,它干的活是把“翻译腔太重”翻译成一条可执行的提示词规则,写进策略文件,再让脚本按新规则重跑。作者顺着这个思路反问了一句:既然重活全是脚本干的,那能不能跳过 Skill 直接跑脚本?他的回答是可以,但体验会差很多——因为用户记不住那个脚本的七八个命令行参数,因为“这是技术手册还是法律合同”这种判断脚本做不了,因为试译那一环脚本根本接不住人的反馈。
四、分级策略:不是所有事都值得写脚本
跟“重活推到上下文外”配套的另一条,是 8.3 节的分级策略:提示词能解决的不上脚本,脚本能解决的不上 MCP。从省事那头开始选,别一上来就架重型装备。
11.1 节的可视化教学动画 Skill 是这条原则的样板——它一个脚本都没有,全靠提示词。但“全靠提示词”不等于“提示词很简单”,恰恰相反,这一节列了五条硬约束,每一条都是踩坑踩出来的:
输出必须是自包含的单文件网页,GSAP 从公共 CDN 加载,用户双击就能开;必须限定一个固定分辨率的容器,不然元素会飞出屏幕或者互相压住;必须指定浅色配色方案,因为模型默认配色往往不协调;必须要求分步文字旁白从头讲到尾,否则它容易只画不问,好看但看不懂;必须明确禁止加播放/暂停按钮,打开就自动播——因为模型会“好心”地给你加一个。作者的总结是:这些约束看起来琐碎,但每一条都是踩坑之后总结的经验,把它们写进 Skill,以后每次生成都能自动避开这些坑,这正是 Skill 的价值所在,把踩过的坑变成可复用的知识。
这段话说出了一个很多人没意识到的事:Skill 的本质不是“让 AI 更聪明”,是“让 AI 别犯你已经犯过的错”。你踩一次坑,写一条约束,此后一万次都不再踩。这也解释了为什么这本书里那么多案例读起来像“事故复盘”——因为它们本来就是。
五、硬伤一:同一段话,相邻两页原样印两遍
说完好的,说问题。这本书最扎眼的一处毛病不在内容,在校对。
10.3 节的结尾有一段总结,讲三个 Skill 可以串成一条内容生产线:选题 Skill 找选题、文案 Skill 写稿、视频 Skill 出片。这段话在相邻的两页上各出现了一次,一字不差。第二页除了这段话,底下还带着“下一章”的翻页提示——也就是说它不是滚动没滚完留下的残影,是两页各自完整地印了一遍。
同样的情形至少还有两处。11.3.5 节讲翻译成本的那两段——“一本 5 万字的英文书按两三千字一片切,会有 20 多个片段……总成本在几元到十几元之间”——连同后面讲模型梯队的那段,在相邻两页又整段重来了一遍。书末“全书完”那一页也是。
这里我得说清楚我的判断边界:我读的是电子版,理论上不能完全排除阅读器渲染重复。但这三处重复的边界都是整段对齐的——从段首到段尾完整重合,中间没有半句话的错位,也没有光标位置的重叠痕迹。真要是滚动残留,接缝处一定会有半行重复。所以我倾向于认为这是排版环节的贴重,是最后一校没做。
这个毛病本身不致命,读者一眼就跳过去了。但它透露的信息有点分量:这本书是快速成书的,赶在 Skill 这个概念还热的时候出来。同样的证据还有图 11-1——那张“水的三态变化”动画截图,在电子版里被切成了两页,我看到的只有 100℃ 和 0℃ 两个角落,中间最关键的分子排列画面没了。这类问题单看都是小事,凑在一起就说明一件事:书稿在作者交出去之后,没有得到一次完整的通读。
六、硬伤二:「零门槛」的门槛,藏在四个账号和一张账单里
书名四个字“零门槛”,是这本书最大的卖点,也是它自己拆得最狠的地方。
严格说,“零门槛”在书里有一个精确含义:不用会编程。这个承诺它做到了——全书没有要求读者写一行代码,所有脚本都是让 AI 写、让 AI 调。作者原话是“整个过程不需要你会编程”,这话不假。
但读者真正会撞上的门槛,是另外两样。
第一样是账号。10.3 节的视频播客 Skill,要跑通得注册:MiniMax 或百度智能云或讯飞(语音合成)、即梦或通义万相或 Gemini(文生图)、Seedance 或 Sora(视频生成),再加一个跑流程的大模型 API。每个平台都要实名、都要在后台翻半天找到那个“创建密钥”的按钮。作者写得很实在:“你唯一需要自己做的事情是,去 MiniMax 的开放平台注册一个账号,在后台创建一个 API 密钥。这和前文介绍获取大模型 API 密钥的过程一模一样,就是注册、登录、单击几下按钮复制一串字符。”——这句话对写过的人来说确实是“几下按钮”,对没写过的人来说是四个平台各来一遍。
第二样是钱。书里给了账:翻译一本 5 万字的书,二三十次 API 请求,用国内模型几元到十几元,用海外或旗舰模型“几十元级别”。这价格不高,但它不是零。也就是说,这本讲“零门槛”的书,实际使用成本是“免费学,按次付费跑”。
更要紧的是,作者自己在 10.3.1 节把话说透了:
这是本书案例中复杂度最高的一个,涉及多个 API 对接和 3 个脚本的串联,建议使用 Claude Opus 等旗舰模型来运行。智能体能力越强,调试过程越顺畅。整个制作和调试过程可能需要一些耐心,脚本之间要反复对齐接口,第一次跑可能会遇到各种小问题。
“需要一些耐心”“第一次跑可能会遇到各种小问题”——这是全书最诚实的一段话,也是和书名冲突最大的一段话。我不觉得这是欺骗,更像是这类书的通病:标题写给还没开始的人看,正文写给已经开始的人看。真正该被记住的是这句提醒——如果你手上的模型不是第一梯队,这个案例大概率跑不起来,别硬磕,先做前面那些不需要多脚本串联的。
七、短板:第 12 章讲管理,讲的其实是文件夹
第 12 章标题是“管理你的数字员工团队”,占了全书近十分之一的篇幅。读完我的感觉是:内容不坏,但和 Skill 关系不大。
这一章讲了三件事。一是分类存放、写索引清单、养成备份习惯,一个人的时候做到这三件就够。二是团队场景下要统一存放(Git 仓库或共享目录)、指定每个 Skill 的负责人、写更详细的索引文档、每季度审查一次。三是版本控制和权限:手动复制加日期、网盘的历史版本、Git 的提交与回退、语义化版本号(1.2.3 分别对应大装修、换家具、修水龙头)、更新日志,权限上则是私有仓库、只给负责人写权限、用 NAS 的目录权限做数据隔离、在 license 字段里标 Proprietary。
这些都成立,而且作者反复强调“管理方式要匹配你的规模”“一个人的时候别搞企业级流程,那是用大炮打蚊子”,这个分寸感是好的。但问题是:把“Skill”这个词换成“一堆 Markdown 文档”,这一章一个字都不用改。分类、索引、备份、版本号、权限,是任何文件资产的通用管理办法,不是 Skill 特有的东西。这一章真正属于 Skill 的洞见只有半句:Skill 本质就是文件夹,所以所有管文件的成熟工具都能直接用——这个观察很对,但它撑不起一章。
12.3 节还暴露了另一个反差。前面 11 章每个案例都能看到作者调试的痕迹:哪个接口对不上、哪一步降级了、为什么要加这条约束。而 12.3 讲多智能体协同时,突然变成了新闻综述:Kimi K2.5 的 Agent Swarm 能自主拆分任务、最多调度 100 个子智能体并行;Anthropic 在推的 Agent Teams 曾用 16 个智能体并行协作,从零写出一个 10 万行代码的编译器。这些是别人跑出来的结果,作者是转述。
公允地说,他转述时很克制,加了“这意味着什么”“当然,AI 自己写的 Skill 一定需要人来审核确认”“自动生成不等于自动生效,最终的确认权始终在人手里”。但一个亲手跑过 9 个案例的作者,和一个读新闻转述的作者,笔下的质感完全不同,读到这儿能明显感觉到换挡。
八、那这本书该怎么读
顺序上,别从第 1 章顺着读。我的建议是:先读第 2 章,把那个目录树记牢,这是全书的地基;再跳到第 6 章,把“能在上下文外面干的活别搬进来”和分级策略吃透,这两条决定了你后面所有设计;然后第 8 章,学怎么让 AI 写脚本(关键是输入、输出、处理逻辑、异常怎么办、运行环境这五要素说全);之后按你自己的需要挑 9 到 11 章的案例,做内容的挑选题和排版那两节,做教育的挑教学动画和出试卷,做翻译的直接看 11.3。
第 4 章可以快翻。那章讲怎么装 Skill、去哪找(GitHub 看 star 数、看最近更新时间、看 LICENSE,然后 Code → Download ZIP),技术内容半小时能看完,但有一半篇幅在介绍作者自己的知识星球和公众号。全书这样的引流转折出现了不止一次,9 到 11 章好几个案例的开头都是“圈友提问”。这不影响方法本身,但你得知道自己在读什么。
要抄的只有三样东西:目录结构(SKILL.md + references/ + scripts/ + assets/);SKILL.md 的分节方式(使用场景、工作流程、注意事项,把“不许干什么”单独列一段);references 里放什么(纯文本优先,作者提醒过 Word 和 PDF 处理慢,能用 .md 就别用 .docx,并且要在 SKILL.md 里明确写出“请查阅 references/产品目录.md”,不写它不会主动去翻)。
至于适合谁:适合已经天天在用 AI、但每次都得重讲一遍背景的人——你已经能感觉到“我在重复自己”,这本书就是教你怎么把那些重复的部分固化下来。适合小团队里那个“什么都要问一遍”的人,把答案写成 Skill,从此没人再来问。不适合谁:不适合想搞明白 Skill 底层机制的人,这本书全程是使用者视角,不碰它怎么被加载、怎么被裁剪、怎么和工具调用抢上下文;也不适合指望照抄就能跑通全部 9 个案例的人,第 10 章那三个脚本的流水线,第一梯队模型之外基本跑不动。
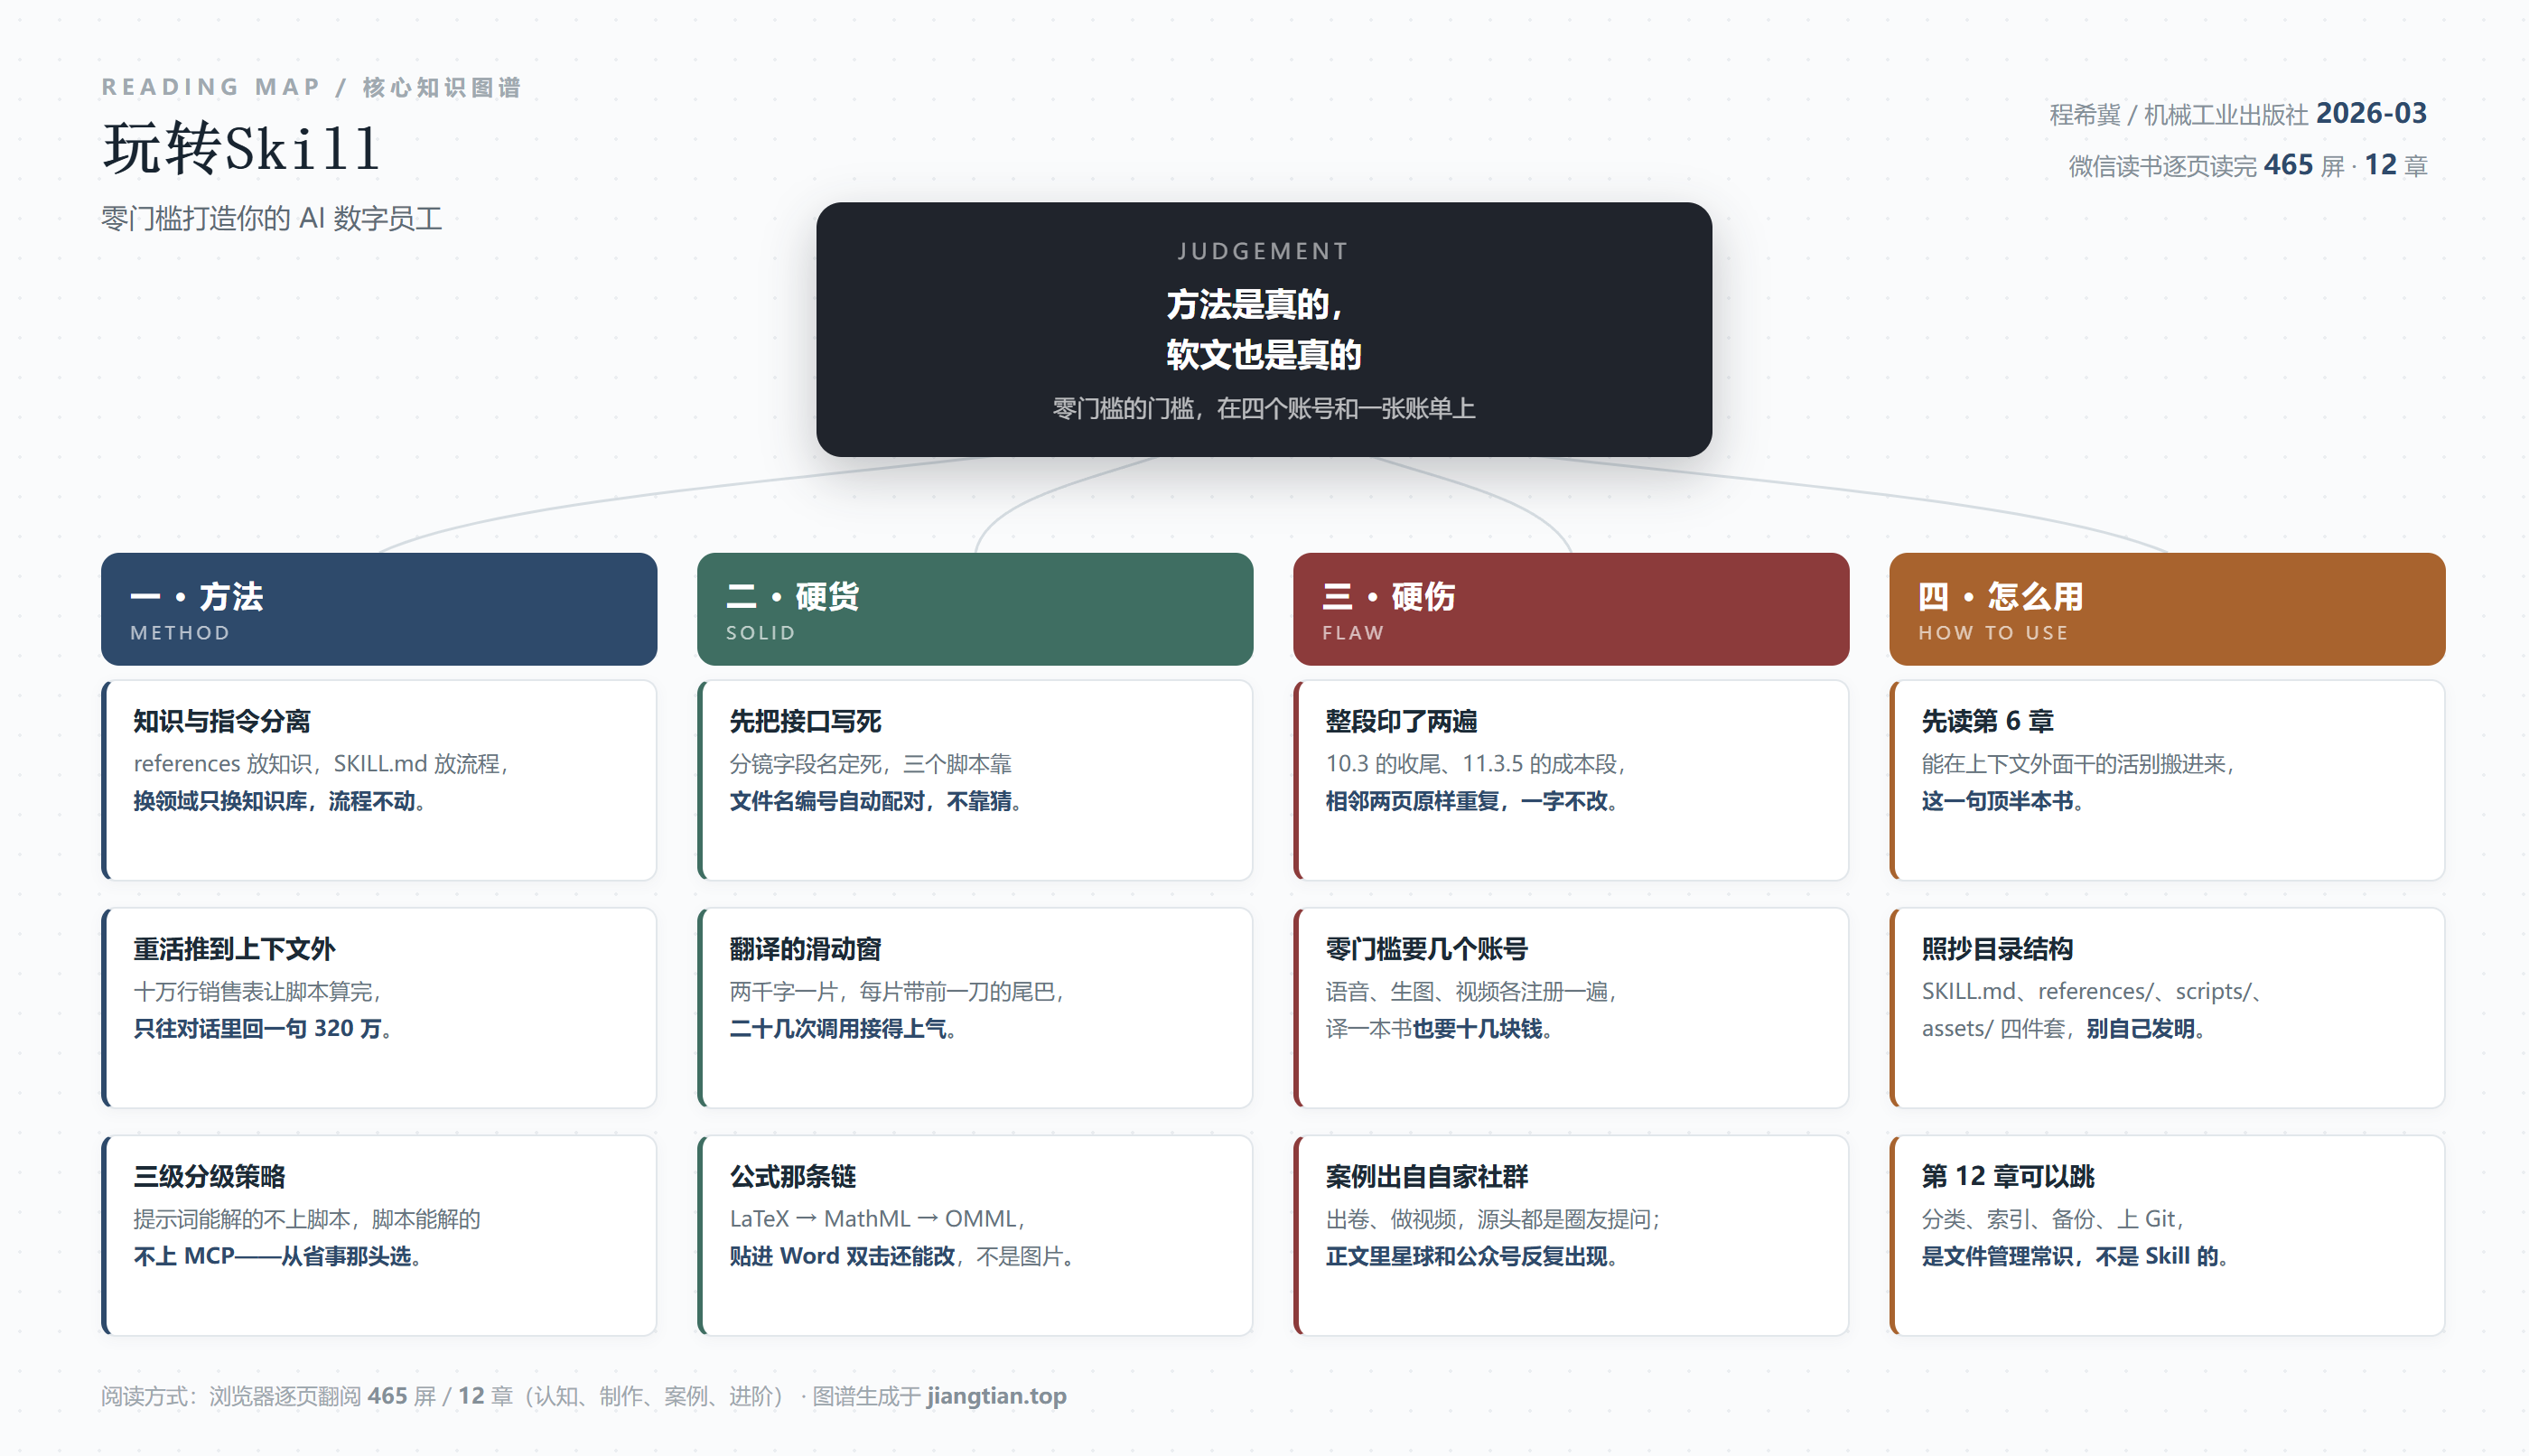
最后说一句我自己的感受。这本书最像“真东西”的地方,是 6.6 节那句话和它背后的判断力——把重活推到上下文外面去,只把干净的结果搬进来。这句话不是从文档里抄的,是从成本账单和失败里长出来的。最不像的地方,是 11.3.4 节那句“用户说的是人话,脚本需要的是规则,智能体在中间做翻译”——它太漂亮了,漂亮到你几乎能听见一句广告语在背后等着。一本书里同时有这两样东西,其实很正常:前者是作者真会的东西,后者是作者真信的东西。读者的活儿,是把这两样分开装。
它教你把经验折成一个文件夹,只是这个文件夹的门牌号写着“零门槛”,推门进去还得先办四张卡。
阅读记录 · 程希冀《玩转Skill:零门槛打造你的AI数字员工》,机械工业出版社,2026 年 3 月第 1 版,ISBN 9787111807766。全书 12 章,我在微信读书网页版逐屏翻阅 465 屏,从版权页读至末页“全书完”,书末显示推荐值 83.1%。文中引文、目录树与代码片段均照录原书。因原书为图片版,OCR 存在个别字符误差(例如把「智能体」认成「智能往」、把「替代」认成「蔡代」),凡引用处均已对照上下文校正,未改写原意;书中的真实 API 密钥与个人信息未作引用。第五节所述整段重复,我读到的是电子版,无法完全排除阅读器渲染因素,但三处重复的边界均为整段对齐、接缝处无半行错位,故判断为排版重复而非滚动残留。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: