
DeepSeek驱动的软件全生命周期智能化开发:分工说清楚了,失败没摊开
微信读书《DeepSeek 驱动的软件全生命周期智能化开发》,李经纬 著,电子工业出版社,2026 年 3 月出版,ISBN 9787121523656。作者现任 NIIT 中国区副总裁,书前推荐序由杨天若(加拿大工程院院士、加拿大工程研究院院士、欧洲科学院院士、郑州大学学术副校长)撰写。全书十章,一个"信息技术资产管理系统"(ITAM)的案例从第 4 章一直做到第 10 章,前面三章讲方法论,后面七章按"架构—详细设计—数据层—质量—部署—安全—本地化"的顺序往下推。我从版权页读到"全书完",没有跳章。
说明:以下引号里的句子都是从原文照录,可以逐字核对。我要谈的不是它讲了哪些技术,而是它哪几处真的想清楚了、哪几处把 AI 的自我表述当成了事实、以及它为什么在最关键的一页上收了笔。
先把结论放在前面。这本书最有价值的部分不在它讲的技术栈里,而在第 3 章那句"人类负责想什么,AI 负责怎么做";但它全书唯一一次承认 AI 交出了不合格的东西,只用了两段就翻过去了。一本讲"全生命周期"的书,把失败的部分写得最薄,这件事本身比书里任何一段代码都更值得说。
还有一个数字,要读到最后一页才看得到:这本书在微信读书上的推荐值是 65.0%,标签停在"一般"。以它的配置——出版社正规、作者头衔硬、推荐序由院士执笔、案例贯穿十章——65% 不算冤枉,也算不上刻薄。它是一本合格的工程手册,但它没有成为一本能让人改变做法的书,原因就在我下面要说的地方。
一、它最想说的一句话,其实是一个分工
第 3 章第 3 节,作者写了一句全书的题眼:"人类负责'想什么',AI 负责'怎么做'。"他把这叫作"设计先行"。
这句话不新。亚马逊的 Kiro 把这件事写成了三份文档——需求、设计、任务;GitHub 那边的说法是 spec-driven development;再往前,任何一本讲需求工程的老教材都在说同一件事。作者自己也知道,所以他在书里老老实实把 Kiro 的 requirements.md、design.md、tasks.md 列了出来,没有掠美。
但这句话放在 2026 年的一本 AI 编程书里,位置是对的,而且它站到了"提示词工程"的对立面。这个对立很关键:提示词工程的隐含假设是"你说得够清楚,它就能做对",而设计先行的假设是"有些东西根本说不清,只能先画出来、再让它照着画填"。前者是把责任压在句子上,后者是把责任压在结构上。
作者把它讲成了一个五层结构:问题域层问"我们要解决什么问题",解决方案层答"我们如何解决",实现层负责"具体怎么做",再往下是测试验证层和部署运维层。然后他把 AI 放进这五层里量了一遍,得出一个排序——实现层是 AI 的主场,测试与运维层它能当助手,问题域层是它的短板,解决方案层是它的挑战区。
这个排序站得住。它和很多人的实际体感一致:让 AI 写一个 SessionManager、写一段单链表、写一个策略模式的四个实现,它做得比多数人快且规范;让它判断"这个需求该不该做、这个模块该不该拆",它给的是漂亮的通用答案,落不到你的约束上。书里没有停在这句结论上,而是给出了一条可操作的推论:既然它在实现层最强、在问题域最弱,那人的力气就该花在把问题域和方案层写清楚,而不是花在反复重写提示词去纠正实现层的偏差。
这条推论有代价,作者也说了:写清楚很贵。第 3 章里那份"用户实体设计"的示例,光是字段定义、业务规则、API 约定、安全要求、数据库约束就写了整整两页。他给的解释是"优质的设计文档是 AI 生成高质量代码的必要前提"。这话对,但也是这本书最容易被读者忽略的一句——因为它要求你先干活。
二、五层与三个陷阱:这本书真正的骨架
如果只保留一章,我建议保留第 3 章,把后面的代码全部删掉。
这一章讲了三个陷阱,讲得比多数同题书实在。
第一个是"垃圾进,垃圾出"。作者拿"用户管理系统"做对照:如果只丢一句"请帮我生成一个用户管理系统的代码",AI 会给一套增删改查,没有业务规则、没有数据校验、没有安全约束、没有异常恢复;如果你把密码必须 bcrypt、用户名 3 到 20 字符唯一、删除要做软删除并留审计、接口要 JWT 且 24 小时过期这些一条条写出来,同一句需求产出的东西完全不是一个量级。这个对照很朴素,但它把"AI 不行"这个笼统的抱怨拆成了"你说得不行"。
第二个陷阱我以为是全书最好的一段:局部最优,全局失控。作者写得具体——AI 给用户模块生成的是基于 ORM 的优雅代码,给订单模块生成的是原生 SQL 的高性能代码,给商品模块又换了第三种数据访问模式;每个模块单看都漂亮,合起来是"四不像"。接口不匹配也是同一个病根:AI 设计接口时只看这个模块自己的需要,不看它跟谁对接。还有一条更隐蔽——它为每个需求独立生成,不复用已有模块,于是同一个通用功能在五个地方各写一遍,改的时候要改五处。
第三个陷阱是技术债加速。这一段我抄下来,因为它罕见地写出了"快"的代价:"最令人担忧的是,当 AI 生成的代码量达到一定规模时,人类开发者可能无法完全理解和掌控这些代码。系统逐渐演变成一个'黑盒'。"他把原因归结得很准:传统开发里,写代码本身耗时,这个耗时天然给了人思考和反省的间隙;AI 把间隙抽掉了,代码生成得越快,人越来不及理解,债滚得越快。
这三段是有重量的经验,不是从别处搬来的口号。同一本书里,第 7 章还有一句话,我读到时停了一下——它说多层次质量体系"本质上是对 AI 创造力进行系统性的'约束'和'驯化'"。用"驯化"这个词的人,是知道这东西不听话的。
问题在这儿:这三段讲完,作者就转身去写代码了。第 4 章之后,前面说的"局部最优""黑盒""技术债"再没有被拿回来验证过一次。他提出了一套判断标准,然后用七章演示怎么生成代码,却没有一章回头问:按我自己定的标准,这七章生成的系统合格吗?
三、让 AI 自己交证据:图 4.2 那一段
第 4 章有一处,我认为是全书的软肋,而且软得很明显。
作者让 DeepSeek 画了 ITAM 系统的类图,接着提了一个很好的问题:"请提供这一具体设计的来源。"这个动作值得肯定——他在要求 AI 给出处,这是一种本能的怀疑。
然后 DeepSeek 出了一张图(书里编号图 4.2),标题是"DeepSeek 提出的设计来源",图上分了四块:核心架构理论来源、技术选型依据、行业案例参考、学术研究支持。文字里写着它采纳了 Cockburn 的六边形架构原始设计理念,结合了领域驱动设计的核心概念,遵循 Spring 官方架构指南,还"深入分析了相关行业案例和学术研究成果"。
作者的评语是这一句:"这充分证明了其在软件设计和架构设计方面的专业能力。"
这句话站不住。模型说自己参考了什么,和它真的参考了什么,是两件完全不同的事。语言模型没有引用能力,它有的是"关于引用的话语能力"——你问它出处,它就能生成一段看起来像出处的文字,格式、术语、人名俱全。图 4.2 上的四个板块,恰恰是"出处"这个词最容易被生成成什么样子的标准样板:理论、选型、案例、学术,四平八稳,一个具体的论文标题、一个具体的案例名都没有。
更麻烦的是这个动作的性质。你问被告"你有没有罪",他说"我没有,而且我依据的是刑法学界的主流观点",然后把这句话记进判决书当证据——这不是核实,这是把自述当自证。作者本来想做的是核实,做出来的却是背书。
我特意在这一段前后读了两遍,想找找有没有第二种可能:会不会书里其实做了交叉验证,只是 OCR 没读到?没有。紧接着的段落就转去讲"我们可以进一步要求 DeepSeek 生成具体的代码"。这一处没有补救。
这个失误的性质,比它看起来严重。因为这本书的方法论是"设计先行"——先有设计,再让 AI 填。那么设计的对错由谁裁定?作者的答案是"由人"。可图 4.2 这一幕恰好说明:当人把裁定权交给 AI 的自述时,设计先行就变成了"AI 说什么就是什么,只是多绕了一道流程"。
四、唯一的失败,只值两段
全书最该展开的地方,在第 4 章中间,大约两段,一百多字。
作者让 DeepSeek 生成了 ITAM 的 Spring Boot 包结构,然后自己检查了一遍,写下这句:
"通过分析 DeepSeek 生成的包结构,我们发现该结构存在诸多功能缺失,如资产全生命周期管理、组织架构管理、资产位置追踪以及使用状态监控等核心需求都未能得到满足。完全依赖 DeepSeek 生成符合需求的代码结构实际上面临着巨大挑战。"
这是我在整本书里看到的唯一一次,作者明确说 AI 交出来的东西不合格,而且不合格得很彻底——不是少个字段、漏个判空,是四个核心需求整块没做。这是一个真实、具体、可复现的失败。
然后他就翻页了。下一页的开头是"基于这些考虑和上一章我们学到的知识,软件工程的本质在于系统化思维,而非简单的代码生成"。失败被当成了一个路标,用来指向结论,然后扔掉。
我不满意的地方在这儿:这个失败明明是全书论点的最好证据,却被当成了引文。
如果它被认真拆一遍,能拆出很多东西。为什么漏?回看作者给的那句提示——"系统应能维护一个组织所拥有的所有硬件和软件资产的完整库存,系统应能跟踪资产的位置、状态和使用情况,包括资产的使用人、上次维修时间和更换时间,系统应能管理资产从采购到处置的整个生命周期"。这句话里明明有"位置"、有"使用情况"、有"生命周期",DeepSeek 交出来的包里却没有 Location、没有 UsageStatistics、没有状态机。
这说明的不是"AI 笨",而是一件更值得写的事:AI 只做它读到的名词,不做名词之间隐含的关系。"生命周期"在人的脑子里是一张状态迁移图——采购、入库、分配、维护、退役,每一跳有前置条件和权限;在模型的输出里,它只是一个词,配一个枚举就算交差。你可以说这是"理解深度不够",也可以说这是"设计没画到那一层"——两种说法都成立,而后者正是作者自己的"设计先行"要解决的问题。
问题在于,如果他顺着这条线追下去,就必须回答一个更难的问题:设计要细到什么程度,AI 才不漏?书里给的答案是"按照需求,逐步完善设计,而不是给出所有需求,一次性完善"。这句话是对的,但它是一句原则,不是一把尺子。读者合上书,还是不知道自己那份设计够不够——而这恰恰是"设计先行"能不能用的分水岭。
还有一处同类的小失败,作者处理得更轻。第 5 章生成折旧策略,第一版代码把"成本除以使用年限"当成了直线折旧,既没减残值,也没处理年限为零。作者的评语是"此提示将返回乍看起来正确的方法,但其实不然",然后补了一句更精确的公式重问,就改对了。这段写得好——它精确地演示了"提示里没有的约束,模型不会替你想"。可惜只有一段,没有变成一条规律。
五、当度量变成求签
第 7 章讲质量度量,有一串对话我读完有点发凉。
作者让 DeepSeek 算 BusinessCostVisitor 这个类的循环复杂度。这个类干什么?两个方法,一个算出硬件折余价,一个直接返回软件采购价,第三个方法把所有资产加起来。DeepSeek 答:每个方法复杂度 1,总共 3。
这个答案是对的,但也是必然的——一个方法体里只有 return,复杂度不可能是别的数。接着作者问了一句:"1 是优秀的循环复杂度吗?"DeepSeek 答:"是的,循环复杂度为1是最优的复杂度值。"然后它解释了三条理由:可测试性好、认知负担低、可维护性高。
这不是度量,这是求签。你拿一个必然为 1 的数去问"1 好不好",得到的必然是"好"。整个过程里没有一个环节需要判断力,得到的却是一个看起来很专业的结论:这个类"代码结构清晰,易于理解,维护成本较低"。
真正该问的问题一个都没问。比如:这个系统的成本计算为什么分散在访问者(算折余价)和策略(算折旧额)两处?访问者里先 getPurchasePrice() 再 subtract(calculateDepreciation()),而折旧额又是策略按另一套公式算出来的——这两套算法有没有对齐过?如果没对齐,一个资产在报表里的净值和在折旧表里的净值会对不上。这个问题跟循环复杂度没关系,但它才是这个设计真正的风险。
再往下,作者又让 DeepSeek 算了霍尔斯特德复杂度、算了可维护性指数,得到"约 99 分(满分 100)",然后问"我们应该要高可维护性指数还是低可维护性指数",AI 答"应该追求高"。同一个模式又走了一遍。后面还有一份代码评审清单,AI 自己给自己挑毛病:说 getTotalCost() 里新建了 visitor 实例导致状态不一致、说没有判空、说要并行流、说要加日志。
这份清单不算错,但它挑的全是"通用最佳实践"级别的毛病。真正该挑的那条——两套算法不一致——它没挑出来。这恰好印证了第 3 章作者自己写的:AI 擅长在局部做优化,不擅长在全局找矛盾。可到了第 7 章,他自己忘了这条,把 AI 的评审当成了评审。
六、安全那一章,它终于把链条闭上了
说完不满意的,得说一段我认为这本书真正立住了的地方,在第 9 章。
第 9 章用 STRIDE 做威胁建模——身份欺骗、数据篡改、行为抵赖、信息泄露、拒绝服务、权限提升,六个维度。这一段本身不难,任何一本安全教材都有。它值钱的是后面三步。
第一步,把抽象的威胁翻译成"安全用户故事"。针对"数据篡改",DeepSeek 给出的故事是:"作为一名管理员,我希望系统能够校验资产状态变更请求的完整性签名,以防止中间人攻击篡改资产价值。"配的滥用案例更具体:"攻击者截获并修改 HTTP 请求中的 assetValue 字段。"防御要求写死了两条:后端实施基于 HMAC 的参数签名校验,或者在更新前强制比对数据库快照版本。
第二步,把用户故事翻译成可验收的标准:任何资产价值更新接口必须包含 X-Signature 头;签名校验失败返回 400 并触发安全警报。这两条已经不是"建议",是可以写进测试用例的判据。
第三步,生成对应的测试。书里那段 JUnit 代码很短,但它干的事很对:先算出合法签名,然后把请求体里的 5000.00 替换成 1.00,签名保留原样,断言返回 400 且抛出的异常是签名异常。这是一个"攻击者模拟",不是"覆盖率填充"。
威胁 → 需求 → 验收标准 → 测试,四步闭合,每一步都能指认出上一步的产物。作者给这件事起了个名字,叫"证据链闭环"。我认为这是全书唯一一处,方法论和代码真正咬合上了的地方。它比前面讲的工厂模式、建造者模式有价值得多,因为那些模式只是"生成得对不对",这一条是"生成的东西防不防得住"。
同一章还有一个细节,我认为体现了作者的工程直觉。他讨论 STRIDE 的时候专门说了一句:这类模型的知识有截止日期,必须和 OWASP、NIST 的最新文档交叉验证。这句话比图 4.2 那段的水平高一档——他知道该怀疑什么,只是在第 4 章那一刻没做到。
七、一处它当场否决了自己
第 8 章有一处,是全书唯一一次,作者在 AI 的输出面前当场踩了刹车。
他让 DeepSeek 生成腾讯云的 Terraform 配置,用来开一台 CVM 装 Docker。生成的代码里,安全组规则是这样的:允许 ingress,协议 tcp,端口 8080,来源 0.0.0.0/0。
作者的评语写得很硬:"在真实的生产环境中,绝不应该这样做。我们应将其限制为可信的 IP 地址范围,例如前置负载均衡器的 IP。"
这个刹车踩得对,而且他点出了根因的一半:这是"为了简化演示而设置的"。我愿意把另一半补上——模型之所以会给出 0.0.0.0/0,是因为它学的海量教程代码里,这一行几乎都是这么写的。教程要的是"你一复制就能跑通",所以它默认把门开到最大;模型忠实继承了这个默认值。
这件事的严重性在于场景的特殊性。写错一个 Java 方法,你还能在测试里发现;写错一条安全组规则,一次 apply 就是真实的公网暴露面,而且它不会报错。IaC 是最不能"跑通就行"的地方,偏偏 AI 在这一层的默认值,是按"跑通就行"训练出来的。
所以这一节真正该教的,不是"记得改安全组",而是一条更硬的规矩:AI 生成的每一条默认值,都要当成一个陌生工程师写的、未经审查的默认值来对待,尤其是它长得最像标准答案的时候。书里这句话没说,但这一节的行为已经把话说了一半。
八、拿一道题测两个模型
第 10 章讲本地化,做了一件我觉得很有意思、但做得不够的事:把同一个问题同时丢给 671b 和本地 7b,比一比。
问题是"用纯 Java 计算一个列表的标准偏差"。结果 671b 给的代码有输入校验、有判空、有注释,分成 mean、variance、standardDeviation 三个方法;7b 给的代码把所有东西塞在 main 里,参数写死成 1 到 5,类型用 List<Integer>。
然后作者跑了一个 100 万数据点的基准,10 次取平均,得到两个数:671b 生成的代码 45 毫秒,7b 生成的 62 毫秒;计算精度 1.000 对 0.9998。结论是"这些量化数据表明,虽然 7b 略逊,但考虑到显存要求低,资源受限场景下仍是好选择"。
我要挑三个毛病。
第一,样本量是一。一道题、一种任务类型、单次运行,这三件事凑在一起,测不出任何关于"模型能力"的结论。它能测出的只是"这一次生成的两段代码,谁跑得快"。而这两段代码的差别里,最大的一项根本不是模型强弱——7b 用的是 Integer,浮点精度天然丢在整数转换上,这是它自己选的类型,不是它算不动。
第二,算法说错了。45 和 62,说 671b"平均执行时间比 7b 快约 27%",这个 27% 是按 (62−45)/62 算的,意思是"7b 的时间里有 27% 是白花的";但从读者直觉上,说"7b 慢了 38%"更准确(45 到 62 涨了 38%)。同一组数,两种说法差 11 个百分点。这类小账不算清,读者对"7b 到底差多少"的印象就会偏。
第三,也是最要紧的:这三个数字被写成了"量化数据表明",而它实际是"一次实验观察到"。这本书里这个句式反复出现——AI 给什么,作者就称量什么,称完就写"表明"。第 4 章的"充分证明"、第 7 章的"最优值"、第 10 章的"量化数据表明",是同一个动作的三次重复。
顺带说一句,这一章真正的价值其实不在这个对比,而在那个显存公式:所需显存约等于参数量 × 每参数字节 ÷ 量化倍数 × 1.2。7b 模型在 FP16 下约 16.8GB,INT8 下约 8GB——这个数能直接帮人做采购决策,比 45 毫秒有用得多。
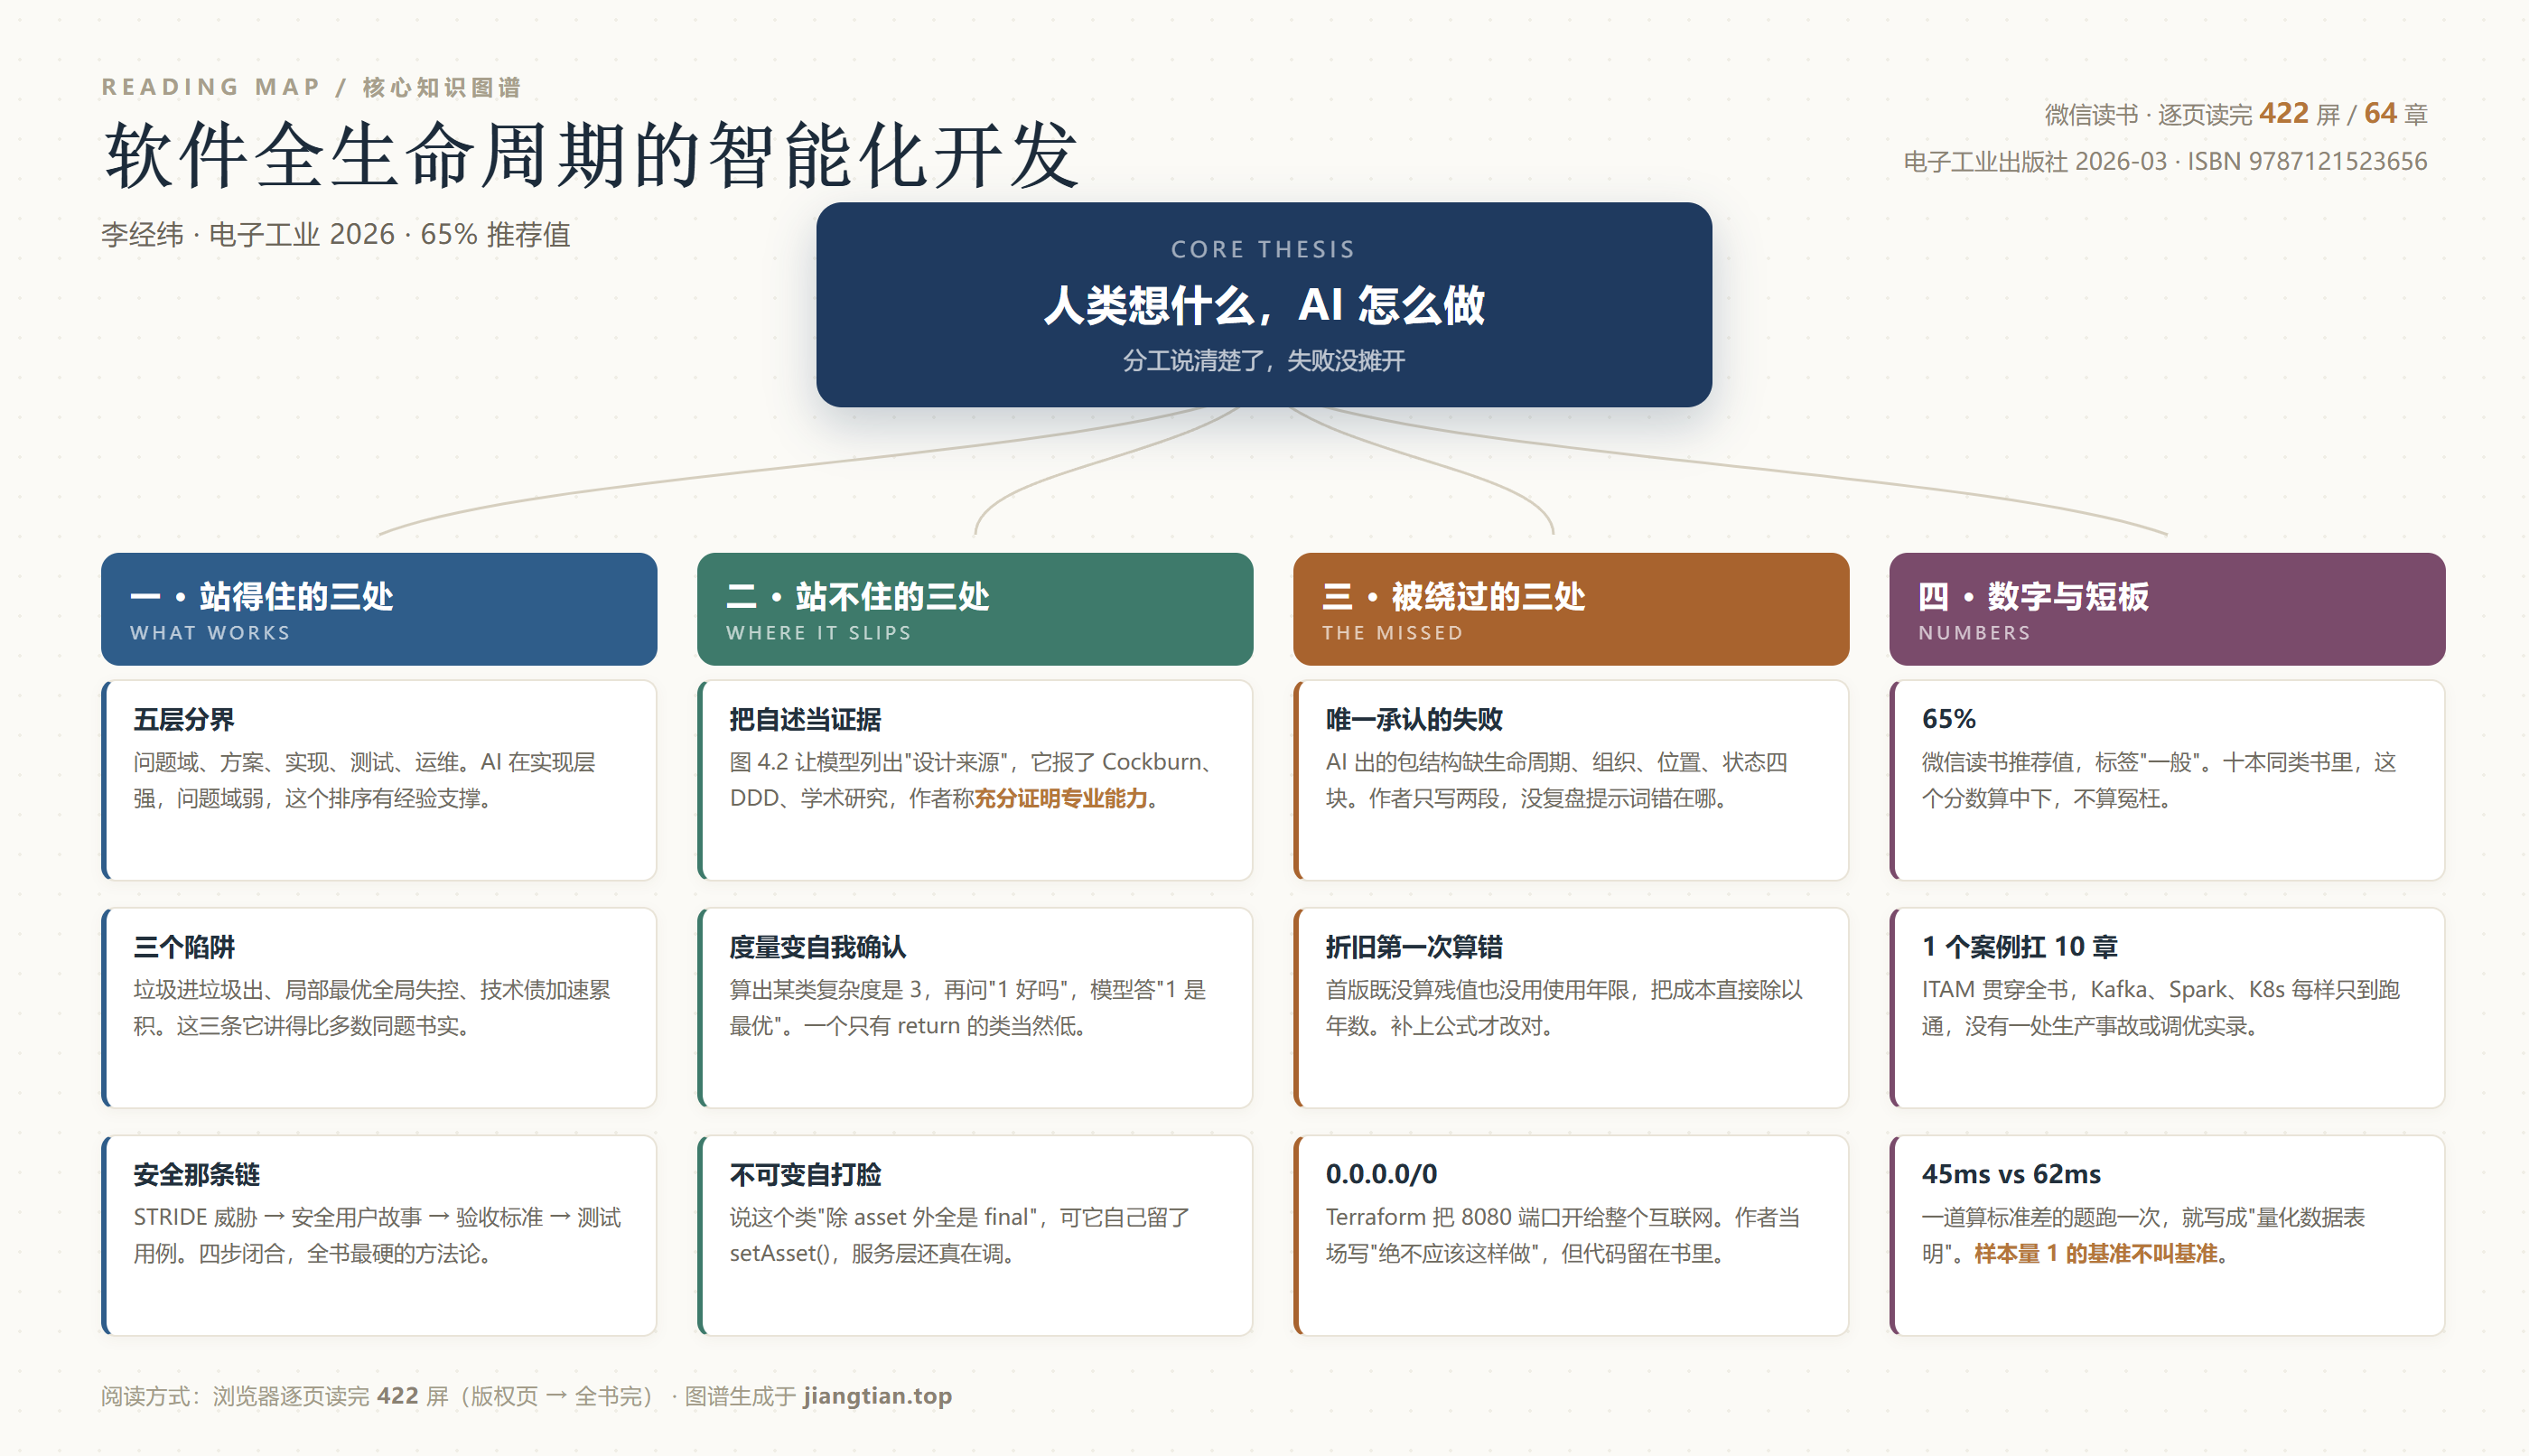
九、它的短板
按老规矩,这一节我要说得直白些。
第一,一个案例扛十章,每个技术都只到"跑通"。ITAM 系统从架构设计做到 Kafka、Spark、Kubernetes、模型微调,场面铺得很大,但每一处都停在"能运行"。Kafka 主题是 1 分区 1 副本,作者说"适用于开发和测试环境",然后就没有然后了;Spark 那段用 Haversine 算资产离上海是否超过 25 公里,25 这个数是拍的,为什么是 25 不是 50,没有交代;K8s 部署写 2 个副本,也没有说为什么是 2。这些恰恰是工程判断发生的地方,书里全部省略了。一本讲"全生命周期"的书,把生命周期里最需要判断的那些岔路口都走成了直路。
第二,十章的"本章总结"高度重复,多段与正文逐字雷同。读电子版时这一点格外刺眼:某一章的总结段落,几乎是把该章开头的导语和中间的核心段落重新拼一遍,连"本章深入探讨了……"这个句式都一模一样。十次。这不是写作习惯问题,是编辑没有拦。
第三,代码里留着与自身主张冲突的地方。最明显的一处:GitHub Actions 流水线里,构建命令是 mvn clean package -DskipTests——测试被跳过了。而第 7 章刚刚用整章论证"测试是 AI 生成代码的最后防线"。前面说测试是防线,后面的 CI 把防线拆了,只留一句"为了提升构建效率"。这个矛盾书里没有解释。
还有一处更技术的:Dockerfile 用 openjdk:8-jdk-alpine,作者称它"遵循了 Docker 的最佳实践"。这个标签在官方仓库里早已停止维护,Alpine 上的 JDK8 分支多年没更新;而且用 jdk 而不是 jre,等于把编译器一起装进生产镜像。一本 2026 年 3 月出版的书,全程 Java 8、javax 而不是 jakarta、Spring Boot 2 时代的写法——案例成型得早,这可以理解,但作者没有在任何地方提醒读者"这套技术栈的版本已经偏旧"。
第四,关键交付物被放到了书外。第 4 章末尾有一句:完整的 Mermaid 文档"读者可以扫描本书封底的二维码获得"。也就是说,书里印出来的类图是删节版,读者手上拿不到完整设计。对一本主打"设计先行"的书,这等于把最该给的那份图纸裁了一半。同一章还有一句"此图略有删节",前后出现不止一次。
第五,也是最根本的一条:它没有一处失败复盘的数据。改了几版提示才把包结构改对?返工了多少次?AI 生成的两千行代码里,最后被留下的占几成?第 4 章那个"四个核心需求整块缺失"的失败,如果作者肯花五页写清楚"我怎么发现的、我怎么改的提示、改完还漏了什么",这本书的价值会翻一倍。他没有。全书七章实操,没有一个数字是关于"返工"的,全是关于"成果"的。
把这几条放在一起看,会看到同一个模式:这本书很会记录"做成了什么",不太会记录"哪里没做成"。而这恰恰是 AI 辅助开发最需要被记录的部分——因为 AI 最大的风险不是它做不出来,是它做出来的东西看起来很对。
十、一句话
这本书把"人该干什么、AI 该干什么"这条线画对了,也用一整章的安全案例证明了自己有能力把方法论落到代码上;但它在自己唯一一次抓到 AI 交白卷的地方收得太早——那一页本该是全书的重心,最后只当了过渡句。
如果你要在半小时内决定读不读它:读第 3 章和第 9 章的第 3 节,其余的当工具书查。第 3 章给你一套判断标准,第 9 章给你一条能闭合的证据链,这两样东西,市面上讲 AI 编程的书里,讲得比它清楚的不多。至于那七章代码演示——它们证明了一件事:AI 确实能陪你把一个系统从架构写到部署。但"能写完"和"能上线",中间隔着的那些判断,这本书没有替你说。
65% 的推荐值,大概是读者对这个落差的本能反应:想看的是一本讲"哪里会塌"的书,拿到的是一本讲"怎么盖起来"的书。
阅读记录:微信读书电子版,从版权页读到"全书完",全书十章、64 个章节节点,一个 ITAM 案例贯穿第 4 至第 10 章。文中引号内文字均为原文照录。图谱与本文同步制作,可在页内查看。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: