
Spec-Kit实战:它把 AI 的不确定性,换成了你的审查工时
微信读书《Spec-Kit实战:AI编程全流程落地》,黄桂钊、茹炳晟 著,人民邮电出版社,2026 年 8 月出版,ISBN 9787115700667。全书分三部分共 9 章:第一部分讲 SDD 的理论与 Spec-Kit 的核心概念,第二部分用四个案例走完整流程(用户名片组件、任务看板、后端 API 与联调、安全加固),第三部分讲存量系统改造与未来展望。我从版权页读到结语最后一行,全书读完,没有跳章。
说明:这本书卖的是一套方法论,不是一个工具。所以我只谈四件事——它真正回答对了哪个问题、它在哪些地方把方法论写成了操作手册、它给出的那些数字为什么不能全信、以及它始终没算的那笔账。凡是加引号的句子,都是从原文照录,可以在书里逐字核对。
先把结论放在前面:这是国内第一本把"规范驱动开发"讲成完整流程的书,它的价值集中在最后三分之一;前三分之二,是一本 CodeBuddy 的图文操作手册。如果你只打算读一章,读第 8 章;如果你打算照着做,先把第 1.1 节抄下来贴在显示器边上。
这本书的问题意识,是我在同类书里见过最准的一句:
"AI将编码成本几乎降为零,却将意图对齐的成本无限放大。"
这句话在第 1.2.3 节,是全书的理论支点。它说清了 2024 年之后写代码这件事到底变了什么——不是"写得更快",是瓶颈换位置了。以前卡在敲键盘,现在卡在"你到底要什么"。当一个人能在一下午生成两千行代码的时候,稀缺的东西不再是代码,是那句能把两千行代码钉死在正确位置上的说明。
一、它诊断对了病,但药方的成本被藏起来了
第 1.1 节列了氛围编程的四重局限,四条我都认:代码质量像在沙子上建塔、可维护性被严重透支、团队协作变成"各自即兴"、结果不可复现。写得最好的是第二条里的那个例子——某团队用氛围编程两周搭了个三千行的内部工具,三个月后要改核心逻辑,"花费了与首次开发相当的时间才完成重构,因为没有任何文档说明当初的设计意图"。这个场景不需要任何数据支撑,每个做过维护的人都懂。
然后它给出 SDD 的定义:"在代码生成之前先定义它应该做什么。"并且把规范抬到了"可执行、可验证、可版本化"的位置。三根支柱分别是规范即契约(对应确定性)、规范驱动实现(对应团队协作)、规范即知识库(对应可维护性)。这个三元结构是自洽的,也确实对应上了前面四个痛点。
但请注意它在这里做的一个动作:它把"对齐成本"从 AI 那边,整体搬到了人这边,然后宣布问题解决了。书里从头到尾没有一处计算过"写规范要花多少时间"。第 9.4 节倒是提了一句"请亲自试一次。测量从需求到上线的时间,而不是从需求到第一行可运行代码的时间",这是全书唯一一次正面回应成本质疑,但它给的是体感建议,不是账。
我不认为这是疏忽,我认为这是这类书的通病:方法论必须假定自己的执行成本可以忽略,否则前半部分就没法写了。真正需要读者自己补上的那半句是——规范的成本,等于你要写的那份说明的字数,乘以你改它的次数。一个每周改三次需求的功能,规范维护成本高到多数团队养不起。
二、四个制品:这套东西真正落地时长的样子
第 2 章把 Spec-Kit 拆成"脚手架 + 工作流引擎 + 工具包"三重定位,落到具体就是四个制品,全部存在项目的 .specify/ 目录下:
宪法(constitution.md),放在 memory/ 子目录里,作用是被 AI 每次对话自动加载,相当于把团队对"什么叫好代码"的默认认知写成一段提示词前缀。规范(spec.md),只写"要做什么",明确禁止出现技术栈、框架、API、数据存储。计划(plan.md,连带 data-model.md、contracts/openapi.yaml、research.md、quickstart.md),这时候 Vue、React、Spring Boot 才登场。任务(tasks.md),把技术方案切成原子步骤,按用户故事分组,可并行的打 [P] 标记,要求测试任务排在实现任务之前。
这个四级结构最聪明的地方,是把"技术选型"往后推到了第三级。书里有一句话我觉得比很多架构文章都实在:规范阶段"允许产品负责人、业务分析师、测试人员与开发者使用同一份文档对话,无须提前绑定技术方案"。这话没错,但它同时意味着——写规范的人必须懂业务,且必须有能力把业务写成可判定的句子。这个能力,比会写代码稀缺得多。
配套的斜杠命令一共七个:/speckit.constitution、/speckit.specify、/speckit.clarify、/speckit.plan、/speckit.tasks、/speckit.implement,外加质检用的 /speckit.analyze 和 /speckit.checklist。安装方式是 uv tool install specify-cli,前置要 Python 3.11+、Git 2.30+。书中示例锁的版本是 v0.5.0。
这里我停一下。这套命令的设计逻辑其实不是"管住 AI",是把一次性的长对话,切成七次有产物、可回溯的短对话。每一次结束都落一个文件,下一次从这个文件开始。第 4.5 节把它总结成"审视—停止—再启动"的节奏,这是全书反复出现的一句话,出现频率高到我数不过来。
三、用户名片组件:流程里最贵的那个动作,是"停"
第 4 章是第一个完整案例,做一个用户名片组件。技术上没什么可说的(Vue 3 + Vite + TypeScript,单组件不超两百行,覆盖率不低于 80%,交互反馈不超 100ms,这些指标是作者在宪法里自己定的)。值得看的是它的节奏:
先 specify init user-card 起骨架,然后 /speckit.constitution 写六条原则,生成完弹出确认框,选 Yes。接着 Ctrl+C 退出。再进入 /speckit.specify 描述功能,生成 spec.md,确认,退出。再 /speckit.plan 定技术方案,一次弹出四五个文件的创建确认(plan、research、data-model、contracts、quickstart),逐个选 Yes,然后退出。再 /speckit.tasks 拆任务,确认,退出。最后 /speckit.implement 执行。
书里在 4.3.2 节专门写了一段提示:计划生成后 CodeBuddy 可能会问要不要继续做任务分解,"请不要选择 Yes 让其创建任务列表文件,因为此时我们需要先停下来审视技术方案的合理性"。类似的警告在第 6.4 节又出现一次:"不要让 AI 自动推进到下一步"。
我读到这里才反应过来,这套流程真正在防的不是 AI 乱写代码,是人顺手点 Yes。七个命令的价值,不在于每一步 AI 写得多好,而在于它强制在每一步之间插进一个必须由人做判断的停顿。这个设计是对的——因为人一旦可以一路回车到底,前面写的宪法和规范就全都白写了,那不过是把氛围编程换了个更长的提示词。
但也正因为如此,这本书的隐含前提清清楚楚地露出来了:每一个停顿处,你都得有能力判断 AI 交出来的东西对不对。书的读者定位写的是"软件开发领域的新手"也能读,这是它的宣传口径里最不老实的一句。新手在这个流程里唯一能做的动作,就是点 Yes。
四、第二部分的真相:一本 CodeBuddy 的图文操作手册
第 2.1 节说 Spec-Kit 有"技术栈中立与 AI 可选性两大特点",specify check 的截图里也确实列了二十多个代理——GitHub Copilot、Claude Code、Gemini CLI、Cursor、Qwen Code、Codex CLI、Windsurf、Kilo Code、Auggie、Roo Code、Amazon Q、CodeBuddy。但翻到第 3.2 节,选择就定了:
"本书选择以 CLI 形态运行,这种形态天然适合与 Spec-Kit 的斜杠命令工作流深度集成。"
然后是为什么选 CodeBuddy——腾讯云出品,插件、IDE、CLI 三端。"选择哪种 AI 编程代理,并不会影响 Spec-Kit 的工作流本身……差异仅体现在 AI 模型的理解能力和生成质量上。"这句话技术上没错,但接下来四百多页的每一张截图都是 CodeBuddy 的界面,每一句"输入以下命令"、"选择 Yes"、"按 Ctrl+C 退出"都是 CodeBuddy 的交互习惯,连"在实测中,CodeBuddy 需要 node.js 18.20.8 版本"这种细节都写了。
这就是这本书最明显的结构性偏斜:它宣称工具中立,实际是一本单品牌操作手册。你换成 Claude Code,第 4 章到第 7 章的所有截图全部失效,因为界面行为不同——什么时候弹确认框、按什么键退出、上下文文件叫什么名字(CodeBuddy 是 CODEBUDDY.md,别家是 CLAUDE.md 或 AGENTS.md)。
说句公道话,这未必是作者的私心,更像是出版和厂商生态合作的自然结果——人邮的异步图书做技术书,配套资源和代理商单是常见的资源置换。但读者得知道自己买到的是什么:你买的是方法论,附赠一份特定工具的操作说明;不是一份可以平移到任何代理的通用指南。
第二部分的另一个问题是重复。第 4 章做了一个组件,第 5 章做一个任务看板(React 18 + Context + useReducer + @hello-pangea/dnd + localStorage),第 6 章把数据层换成 Spring Boot 3.2 + MySQL 8.0 的后端,第 7 章加 Spring Security + JWT + BCrypt 的认证。四个案例,每个都从"打开终端、执行 specify init"开始,每个都把宪法重新写一遍,每个都完整走一遍 constitution → specify → clarify → plan → tasks → implement。到第 7 章的时候,我已经能预判下一段是"选择 Yes 后,CodeBuddy 将自动……"。
这些篇幅不是没有信息量,但信息密度在明显下降。真正新的东西只有三处:第 5 章的 /speckit.clarify、第 6 章的 API 契约对齐检查(把前端 TypeScript 类型和后端 OpenAPI 逐字段比对,标出 status 枚举值格式、createdAt 时间格式的"待确认"),第 7 章"安全加固不应改变现有接口的功能逻辑,变化的只是调用前需要先登录"这个判断。其余都是流水账。
五、clarify 是全书最聪明的一个命令
第 5.2 节里,作者写完任务看板的需求规范后,输入:
"/speckit.clarify 重点关注拖拽交互、搜索功能和边界条件中未明确的细节。"
然后 AI 会扫描规范,把描述模糊的地方逐个变成问题,人逐条回答,答案追加进规范的 Clarifications 段落。
这个命令为什么聪明?因为它把"我没想清楚"这件最难受的事,翻译成了"这里有七个问题,请回答"。写需求最贵的不是写字,是意识到自己漏了什么。人能靠经验列出三五个坑,AI 能列二十个——其中可能十五个是废话,但那五个你没想到的,就值回票价了。
我更看重的是它顺带解决的一个组织问题:澄清的产物是文件,不是聊天记录。三个星期后有人问"当时为什么规定拖拽后状态立即更新而不是等接口返回",答案在 clarifications.md 里,不在某个人的微信里。这一条比它宣称的所有"提升效率"都更实。
可惜书里对这个命令只给了半页,没有给出正反例对比——什么样的模糊描述能被 clarify 抓住,什么样的抓不住。这本来是全书最该扩写的地方,却被四个重复的案例挤掉了。
六、第 8 章才是这本书的心脏
翻到第三部分,画风突变。第 8 章讲存量系统,开篇第一句就把读者按在椅子上:
"我见过太多团队,项目的 Wiki 最后一次更新是两年前,设计文档里的架构图跟现在的代码完全对不上。唯一可信的'文档'就是源代码本身。"
接下来是这一章真正的贡献——它把 SDD 在存量系统里的角色,从"发明规范"改成了"提取规范"。这个转向非常关键。前面七章都在讲"先写规范,再让 AI 生成代码",可是面对一个跑了五年、没人说得清行为的系统,你根本没有资格"发明"规范,你只能从代码、日志、流量、数据库里把已有的行为挖出来,固化下来。
方法给得也细:静态分析看模块结构和调用链(jdeps、Graphviz、IDE 的 Call Hierarchy、ArchUnit),动态分析看运行时行为(ELK/SkyWalking 的日志、Postman 存请求、tcpdump 抓包、GoReplay 复制生产流量),数据模型用 SchemaSpy 逆向出 ER 图,然后去查那些"理论上只有三种取值、实际查出五种"的字段——多出来的两种是哪来的。这个"五比三多出来的两种"是整本书最像一线工程师写的一句话。
然后是全书写得最好的一节,8.6.3。作者拿一个跑了五年的中型电商订单系统做试点,把提取出来的规范转成自动化测试跑在现有系统上,结果"有好多个场景失败了",列了三个:
第一,普通用户买预售商品、付尾款时用优惠券,测试失败——优惠券的校验条件写错了,用户能用不满足条件的券。这是个真 bug,只是之前的测试没覆盖,所以从来没人发现。第二,商品已发货、用户申请退款,规范要求进"退款中",实际代码直接置"已退款",绕过了退货流程。第三,规范写"待支付→已取消"只能由买家在 30 分钟内发起,但实际有个后台批处理会无条件取消超过 24 小时的未支付订单,这条规则从来没被文档化。
这三个例子比前面七章加起来都有说服力。因为它们说明的不是"规范让你写得更好",而是"把现有行为写成断言,能照出你自以为熟悉的系统里那些没人知道的角落"。作者自己也说,发现这些问题后,"团队对 SDD 的态度从怀疑变成了信服"。
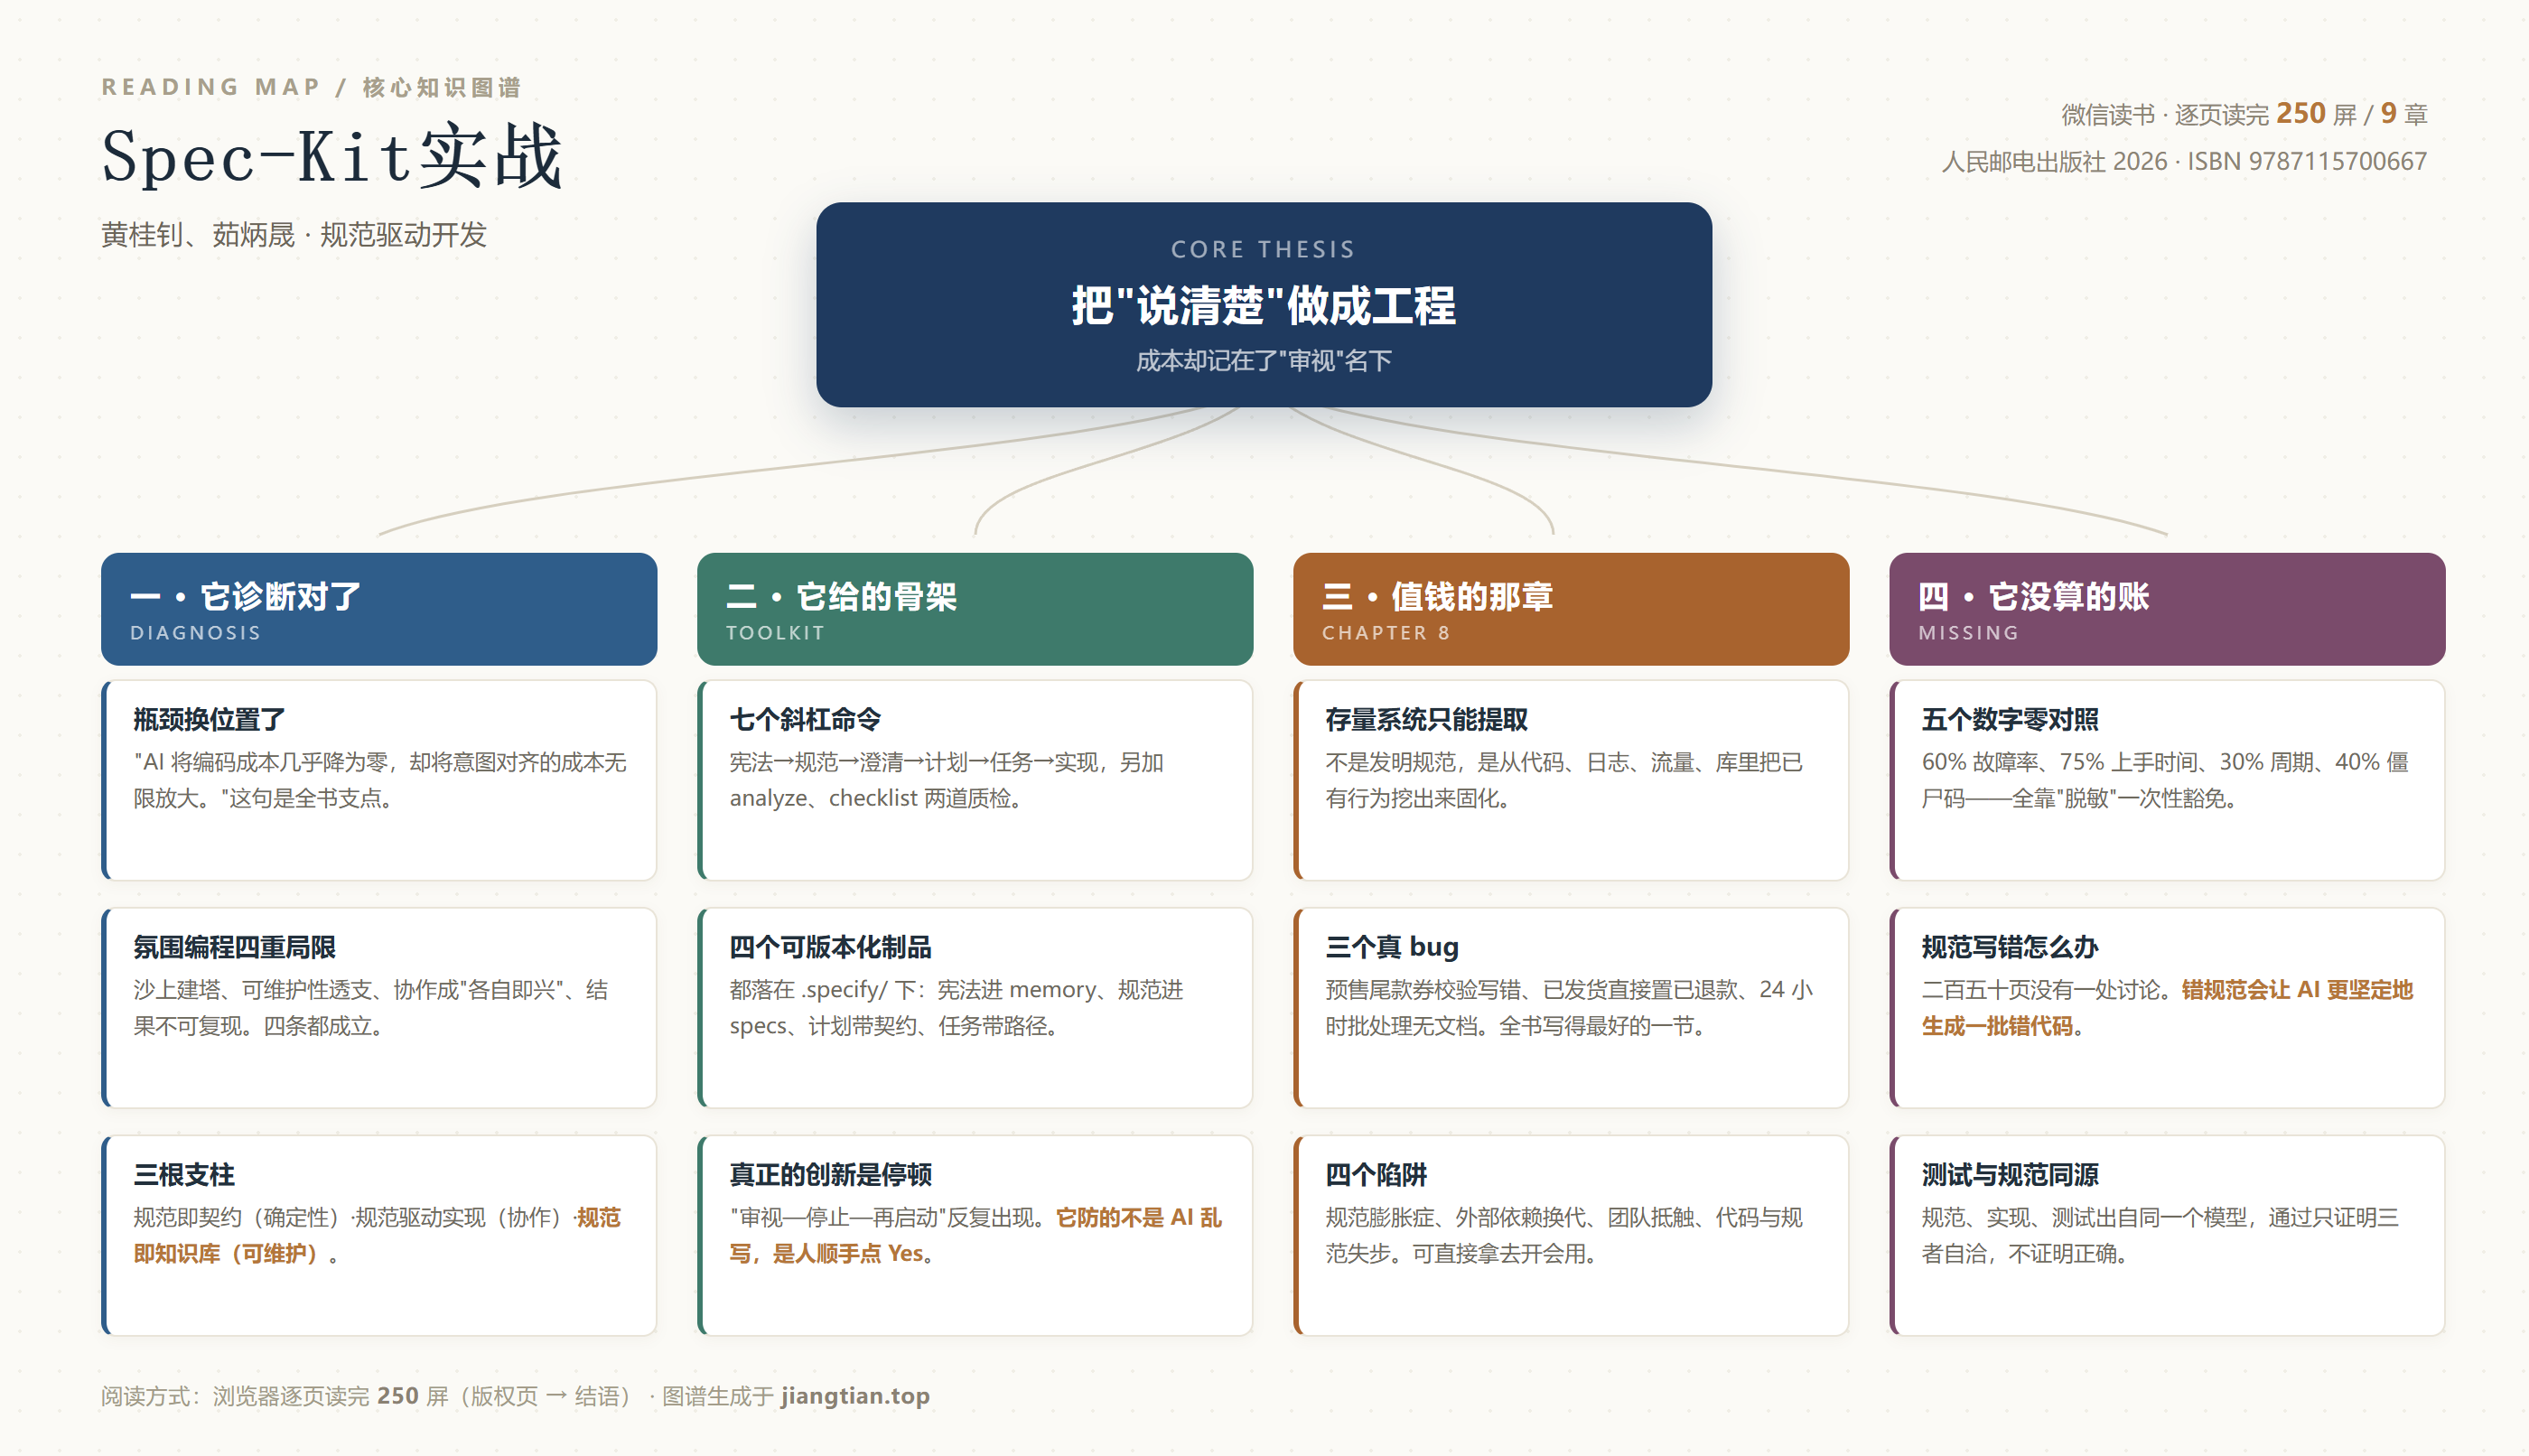
配套的还有 8.7 节的四个陷阱,写得比正文更诚实。「规范膨胀症」——团队尝到甜头后给每一行代码都提取规范,结果"规范文件的数量和体积迅速超过源代码本身",没人看了;解法是二八原则,"20% 的核心业务逻辑产生了 80% 的价值和风险"。「忽略外部依赖的行为变化」——支付网关把 SUCCESS 改成 SUCCEEDED,你的规范就全废了;解法是加适配器层,规范只约定适配器接口的行为。「团队抵触」——"写规范的时间我都能改完两个 bug 了";解法是把规范评审写进"完成的定义"、把写规范一起估点、找一个"出血点"做实验。 「规范与代码失步」——热修之后"明天再补",然后永远不补;解法是 CI 强制阻断,而且"决不允许任何例外,一旦开了口子,口子就会越来越大"。
这四段是可以直接拿去开会用的。也正因为这四段写得好,我更确认了一件事:作者真正的功力在"改造旧系统"这件事上,不在"用 AI 造新系统"上。第 1 到 7 章是方法论的教学演示,第 8 章是经验的复盘。两者不是同一个水平的东西。
七、它的短板
说完好的,说不好听的。五条。
第一,所有效果数字都不可核验,而且是被"脱敏"两个字一次性豁免的。8.6 节给了五个数字:新入职开发人员理解订单核心逻辑的时间缩短 75%、订单相关故障率下降 60%、开发周期比预估缩短 30%、重构时删掉 40% 的僵尸代码、API 集成故障率"甚至有可能下降 70%"。这五个数字全部来自"我们在一个中型电商平台的实际经历,我们对涉及的名字和细节做了脱敏处理"。没有样本量,没有时间窗口,没有对照组,没有说这 60% 是从多少降到多少。最后那个 70% 连"有可能"都写在里面,却被放在成果叙述的段落里。这不是造假,这是用不可验证的经验数据给方法论背书,读者没有任何办法自己复核其中任何一个。
第二,规范写错的代价,全书一次都没写。结语里有一段很漂亮的对照:"氛围编程第一天就能让程序运行起来,但第十天你可能还在修复边界 bug;采用 SDD,或许第三天代码才能运行,但到第十天它已经稳定运行了 7 天。"这话读着痛快,但它默认了"SDD 第三天写出来的代码是对的"。而如果规范本身写歪了呢?一份错误的规范会让 AI 高效地、一致地、可复现地生成一批错误代码——而且因为"有规范",团队反而更信任它。这是 SDD 独有的失败模式,比氛围编程的失败更贵,因为氛围编程的错你一跑就看见了。这本书 250 页里,没有一处讨论过这个场景。
第三,审查工时没有被计量,而它是这套流程里最大的一项支出。我数了一下,书里明确要求人停下来审视的地方:宪法生成后、规范生成后、澄清答案后、plan 生成后、每个附属文件创建前、tasks 生成后、implement 的每个阶段之间。第 6.2.4 节甚至给了一份"前后端一致性检查"的四步清单,逐字段比对、逐场景验证、还要检查契约里有没有泄露技术实现细节。这些都是实打实的工作量。而这套流程的全部卖点是"AI 帮你省时间"——省下来的编码时间,被等量甚至超额转移到了审查上,只是不再叫"写代码",叫"审视"。书里对这件事的处理方式是反复写"务必仔细审视",仿佛提醒得够多,成本就不存在了。
第四,测试的循环论证没有被讨论。全书坚持测试先行、TDD 嵌入任务拆解、覆盖率不低于 80%,第 8 章还提出"规范即测试"这个我认为全书最有价值的概念。但有一个问题绕不过去:这些测试是谁写的?书里的答案几乎总是 AI 写的(第 4 章的 tasks.md 里有专门一段"Verify tests FAIL before implementing",第 6 章的 implement 日志里直接是 AI 写测试再跑 mvn clean test)。如果测试和实现由同一个模型、基于同一份规范生成,那么"测试通过"证明的只是"两份输出互相自洽",不是"符合真实意图"。规范、实现、测试三者同源,一致性极高,正确性没有任何增量保障。这个问题在第 8 章反而被解决了——那里测试是从真实流量和老系统行为里提取的,是外部锚点。这也再次说明,最好的用法在最后。
第五,"宪法"这个核心比喻,作者自己都不放心。第 2.2.1 节专门加了一段免责声明:"本书中的'宪法'是软件工程与 SDD 中的一个比喻性术语……它不指代,也绝不关联任何国家或政治实体的宪法。"能理解这个谨慎,但一个需要作者当场声明"我不是在说那个"的术语,说明它在中文语境里是有摩擦的。更实质的问题是:书里给的宪法样例,内容是"组件不超过 200 行、覆盖率不低于 80%、交互反馈不超过 100ms、禁止引入非必要依赖"——这是一组可量化的工程指标,不是价值判断。把它叫"宪法",是一种拔高;它实际的作用,是一段每次对话都会被加载进上下文的系统提示词。名字取得太重,会让人误以为写完了就一劳永逸,而它其实和所有提示词一样,会随模型版本变化而失效。
最后还有一条不算短板但值得说的:这本书在微信读书上的推荐值是 77.0%。对一本讲方法论的技术书来说,这个分数不低——它说明大部分读者确实从里面拿到了东西,很可能是第 8 章那三个 bug 的案例,或者 8.7 节那四个陷阱。同时也说明有三成读者没被说服,我猜他们的理由和我上面写的差不多。
八、这本书该被怎么用
如果要我给一个用法,是这样的:
把第 1.1 节和第 8.1 节当成诊断工具,拿去问自己手上的项目——它是不是已经出现了"文档跟代码对不上""改一行不知道影响哪里""新人两个月看不懂流程"这三个症状。有,就往下读;没有,这本书对你暂时没用,别为了用方法论而制造问题。
把第 8.3 到 8.5 节当成操作规程。挑一个高业务价值、低耦合、可独立验证的子域(书里推荐"订单状态机"或"价格计算模块",避开支付网关对接这种深度耦合的),用静态 + 动态分析理解它,用 OpenAPI + Gherkin + 状态转换表把行为提取出来,转成测试跑一遍老系统,把不一致的地方一条条查清楚。这一步的产出不是文档,是一份能照出 bug 的测试基线。这件事的价值,和用不用 AI 无关,和用不用 Spec-Kit 也无关。
第 2 到 7 章,当成 Spec-Kit 这个工具的说明书翻,别当方法论读。它的命令清单、目录结构、制品命名是准确的,照抄能跑通;但把里面的四个案例当成"AI 编程的标准姿势",你会得到一个仪式感很足、产出很慢的开发流程,而且换一个 AI 代理就得重学一遍。
合上书,我最认同的其实是结语里那句被放在最后的话:
"规范就像是公路的护栏:它不决定你要去哪里,但它确保你不会在加速的时候冲出悬崖。"
这个比喻比"宪法"准确得多。护栏的成本是可算的——按公里算钱;护栏的收益也是可算的——某段路的坠落事故率。这本书讲了护栏怎么装,讲得很好;但它没告诉你这段路该不该装、装一公里多少钱、以及装了护栏之后是不是所有人都敢开更快了。
它教你把意图写成断言,却没说断言写错时,AI 会比你更坚定地执行它。
阅读记录 · 黄桂钊、茹炳晟《Spec-Kit实战:AI编程全流程落地》,人民邮电出版社,2026 年 8 月,ISBN 9787115700667。全书三部分 9 章,从版权页读至结语,读完全书。文中所引原句均照录自书中,未作改写;所述案例细节(用户名片组件、任务看板、Spring Boot 后端、安全加固、电商订单系统)均出自书中第 4 至 8 章。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: