
玩转即梦和Sora:镜头词它写对了,后半本却在抒情
一、先说清这本书的地形
四部分,十二章。第一部分(第 1 到第 6 章)讲即梦:注册与界面、构图光影色彩的基础、肖像案例(古风汉服照、潮流街拍)、书籍内页插画的四步法、电商与海报类的应用。第二部分(第 7 到第 10 章)讲 Sora 2:注册与界面、提示词的七要素结构、六个镜头动词、分镜与四位导演的风格拆解、三种视频形态的制作流程、剪映与 Suno 的后期、角色一致性、特效场景、以及让 ChatGPT 拆脚本。第三部分只有第 11 章,讲职业化与变现。第四部分只有第 12 章,讲未来。
作者是两个产业背景的人。乔剑是北京大学计算机专业硕士,长期为工业和信息化部、国家数据局提供技术与政策研究支撑,参与过《面向人工智能的数据标注合规指南》这类标准的制定,牵头写过《中国人工智能白皮书2026》。苏小文也是北大硕士,在 Google、腾讯、字节跳动、美团、滴滴做过 AI 产品研发与智能系统设计。这个履历决定了这本书的长处和短处:他们懂流程、懂合规、懂生意怎么谈,但不太像一个天天守在监视器后面的人那样懂画面。
前言的自我定位是"既讲艺术与美感,又讲技术与生意"。这个话说得挺准,也恰好划出了这本书的强弱线——"技术与生意"他做到了,"艺术与美感"主要是转述别人的。全书讲构图、光影、色彩的那一章,概念都对,例子都是别人的片子,读起来像一份写得不错的观影笔记,不像一个拍过东西的人在讲经验。
有个细节值得单独提一句:书末的作者简介只给了乔剑和苏小文两段,第三作者刘源没有介绍。一页简介而已,但它像一个温度计,预告了后面那些编校层面的问题——整页重复、图注写错名字、把做代码编辑器的公司列进影像生成平台。
二、第 11 章:全书唯一能直接换成钱的一章
如果这本书只卖一章,我买第 11 章。它跟前面十章完全不是一种写法:前面是"点击这里,再点击那里",这一章全是条款、边界和数字。它不像一个 AI 领域的作者写的,更像一个被甲方坑过几轮的人写的。
先说最见功力的那一步:筛客户。作者说,客户拿着作品集找上门来的时候,第一件事不是"接",而是"筛",先做一个三分钟的资格评估——目标用途(投放、上新、活动、私域)、时间节点(是不是急单)、预算级别、素材条件(有没有提供脚本、品牌资产、肖像授权)、风格偏好是否与你擅长的方向匹配。评估通过再往下走,不盲目消耗产能。这一句"第一步不是接,而是筛",是整章的地基。绝大多数刚接单的人死在不筛上:什么活都接,接到一个预算三百块要改十版的,然后把时间全赔进去。
筛完之后的动作是一页纸的"项目理解":复述对方的目标与限制,列出你建议的创作路线,说明可交付的形式与时间框,最后给两个选项——标准版和进阶版。作者对这两个选项的解释很实在:标准版满足刚需、走性价比,进阶版强化品牌感、走溢价,客户在对比中更容易做决定,也更愿意把预算抬到进阶版。这是销售动作,不是创作动作,很多技术出身的人一辈子学不会这一下。
报价那一段是全章最硬的部分。作者建议用"基础费+变更费+授权费"的三段式,明确反对一口价买断一切。基础费覆盖策划、提示词工程、生成与剪辑一轮成片;变更费对应超出约定轮次或大改方向,并且要有清晰的触发条件;授权费与用途挂钩——平台、地域、时长、是否独占。如果客户一定要买断,也要限定范围与年限,设置续费梯度。计价方式给了三种:按成品(单支短片、单套主视觉、单系列海报)、按里程碑(脚本锁定 30%、画面锁定 40%、最终交付 30%)、按价值(整案报价,不与时长张数绑定)。
合同那一节,我逐条看下来,几乎没有一句是废的。知识产权要拆开写:默认版权归乙方,甲方在约定范围内使用;提示词、参数、工作流脚本通常作为乙方的"方法论资产",不随成片转让,但可以提供"可复现记录"供质检与二次制作。修改条款要写清含两轮细改、不含方向性大改,大改的触发条件列了五种(更换脚本、重设风格、新增镜头超过 30%、更换配乐、重录全配音),每轮修改要求 48 小时内集中反馈,逾期视为默认通过。付款写 30/40/30 或 50/50,并配一条撤单条款:客户单方中止,已完成里程碑的费用不退;若已进入制作期,收取不低于项目额 30% 的"停工与占档补偿"。
我认为这一段里最值钱的是"占档"这两个字。它把一件从来没人明说的事写成了条款:创作者真正被消耗的不是那几小时劳动,是那段时间里被锁死、不能接别的活的机会成本。一份合同里出现这两个字,说明起草的人真的因为撤单吃过亏。
交付那一段也有洞察。作者把交付拆成四层:视觉成果、复现凭证、合规凭证、使用说明。复现凭证要写核心提示词、关键参数、模型版本、生成时间;合规凭证要整理音乐、音效、字体、第三方素材的授权截图;使用说明是一页"运营建议",告诉客户内容在哪些平台什么时候发、标题和封面怎么选、要不要切条。然后有一句话,我原样抄下来:「很多甲方缺的不是成片,而是成片之后该怎么用——这页说明,常常决定复购率。」
这句话把"接单"这件事的性质变了。它不是在卖文件,是在卖"你能替我想完后面三步"。一个卖文件的人永远被压价,一个能想到复购的人才有议价权。
短板也在这一章,而且很明显:所有数字都没有来源。第 11.4 节给了三层定价——基础服务 500 到 2000 元、品牌服务 3000 到 10000 元、长期合作 1 万到 3 万一个月;又给了一个结构化定价的例子,总价 6500 元,拆成创意策划 1000 到 3000、提示词工程 1500、主体生成 2000、调色剪辑 1500、交付包 500。这些数字精确到五百,可书里没有一个字说明它们从哪来——是访谈来的、自己项目里的、还是估的?哪个城市?哪一年?什么类型的客户?一个读者拿着这组数字去报价,很可能发现市场根本不认。数字本身不算错,但一本"完全手册"给出价格却不给价格的语境,等于把最需要判断的部分留给了读者。
三、15 秒的天花板,逼出了一套工程解法
第 10.3 节是我认为全书最有"工程味"的一节,也是它唯一正面承认工具缺陷的地方。
问题是明摆着的:Sora 2 单条视频的上限是 15 秒。想拍一条 5 分钟的短片,就得拆成 20 段,然后把 20 段拼起来。而拼接的难点不在技术,在一致性——同一个主角在不同段落里的服装、发型、表情要统一;前一段的环境、光线、时间要和下一段连上;景别、角度、运动方式要呼应;音乐、光线、动作的变化要符合剧情。任何一项没控住,成片就是一堆碎片。
作者给的解法不是"多试几次",而是在 ChatGPT 里造一个专门干这件事的自定义智能体。五步:起名、写描述、写核心指令、设开场白、上传知识库。核心指令那五条是可以直接抄的:每段视频长度不超过 15 秒但整体能连贯播放;保持人物、动物、物体、服饰、光线、镜头语言前后一致;每段输出五个部分(场景标题与时间编号、中文提示词、镜头脚本含角度景别运动、人物与场景一致性控制、上下段衔接说明);输出中文、视觉导向、具体可执行;用户给主题时先出全片结构大纲再分段生成。
书里跑了一个例子:一个孤独的工程师在未来城市醒来,发现全世界的电力都停止了,科幻写实风,类似《流浪地球》,总时长 5 分钟。智能体先出总体架构,再逐段出脚本。给出的前两段是这样的——场景 1「黎明断电」00:00 到 00:15,未来城市高空公寓的卧室,黎明的蓝光透过窗帘,巨型霓虹灯逐渐熄灭,年轻工程师从床上惊醒,镜头捕捉他眼中反射的城市剪影;一致性要求写的是"主角穿灰蓝色睡衣、短发、肤色偏冷白,背景保持同样的窗景";衔接说明写"下一段镜头衔接主角起身走向门口,光线由蓝色变为红色应急灯"。场景 2「寂静走廊」00:15 到 00:30,漆黑的金属走廊,红色应急灯间歇闪烁,手机照亮前方,空气里浮着灰尘,远处传来电流的微响;景别中景跟拍背影,角度低机位仰拍,光线红光交替。
我要说清楚这一节的价值在哪:它把"提示词"升级成了"提示词链",把"一致性"从一种玄学变成文档里的一个字段。这两个转变,比全书任何一句"让每个人都成为自己的导演"都值钱。因为前者可以执行,后者只能鼓掌。
但它同样缺了最关键的一步:书里没有给这个智能体实际跑完 20 段的结果。读者看到的是两段写得很漂亮的脚本,看不到第 20 段是不是还跟第 1 段是同一个人,看不到 20 段拼起来有没有跳帧,看不到这条 5 分钟的片子到底成没成。这不是苛求——既然方法是"先拆后拼",那么验证就必须落在"拼起来之后"。给方法不给结果,读者拿到的仍然是"应该能行",而不是"我试过,行"。
四、第 7、8 章:它把电影语言翻成了能写进提示词的词
这两章是这本书的骨架,也是它最像"手册"的部分。
第 7 章给的提示词结构是七要素:主体、动作、场景、镜头语言、光线与风格、音效与对话、技术参数。作者说这个结构综合了 OpenAI 那份官方的 Sora 2 Prompting Guide 和几家影像生成平台的实践。有一点值得肯定:书里放的图 7-19 是那份指南在 GitHub 上的原始页面截图(Markdown 视图),不是二手转述的总结。一本工具书肯把出处截出来,说明至少这一段是查过的。
七要素里讲得最实的是"技术参数"这一层。作者直接上了一张焦距对照表:14 到 24 毫米超广角,视野极广、透视夸张、近大远小,用在需要强烈空间感和动态冲击的地方;35 毫米广角;50 毫米标准镜头,视角接近人眼,画面自然;85 毫米中长焦,背景轻微压缩,主体突出;200 毫米长焦。表里除了参数,还有一栏"示例描述",给的是一句能直接粘进提示词的中文,比如"85 毫米镜头特写,浅景深对焦在少女的眼神中"。这一栏是整张表的价值所在——它把摄影术语翻译成了提示词。
紧接着给了一组对照实验,用同一个场景"草地上的少女,远处有远山":写"镜头 50mm,浅景深,背景虚化",背景就是糊的;写"镜头 50mm,深景深,远处山体清晰可见",背景就是清楚的。这种"改一个词,看一个变化"的写法,才是手册该有的样子。
第 8 章讲六个镜头动词,每个都配了情绪解释:推镜是情绪的靠近,拉镜是空间的释放,摇镜是视线的流动,移镜是真实的穿行感,跟拍是让 AI 追随主角,空镜是让场景呼吸。这些解释不算深刻,但够用。
真正有价值的是散在里面的几条边界,这几条明显是从调试里长出来的,不是从教科书里抄的:
Sora 2 的生成模型会根据动词判断镜头方向——若只写"画面慢慢变远",可能被理解为时间推移;用"镜头拉远"则更清晰、可控。
这是我全书唯一想抄进自己笔记的一句。它的形状是"我踩过这个坑",不是"应该这样做"。同类的话还有两处:摇镜不能跨越过多元素,否则画面会混乱,建议控制在同一空间内,用来传递"观察者视角"的流动感;镜头词的语义位置很重要,应放在动作描述之后、风格描述之前,如果作为场景开头,用"镜头从……开始"最容易被识别。这三条加起来,是这本书真正的技术含量。
讲节奏的那一节也对。作者说短句代表停顿,逗号代表过渡,句号代表节拍落点;同一段内容,写成"镜头缓缓推近,女孩抬头,阳光洒在她的脸上,她微微一笑",AI 会把每个动作当成一个镜头节点依次呈现,而写成"镜头推近女孩,她抬头微笑,阳光照着她的脸",几个动作会挤在同一时刻发生,节奏就没了。这个观察是准的——语言的分句结构确实会被模型当成时间结构来读。
还有一条贯穿全书的方法论内核,作者反复讲,讲透了:抽象的词要换成能被镜头拍到的细节。表 7-1 举的错误示例是"她的笑容像风一样温柔,像梦一样遥远",评语是"过于抽象,AI 难以理解画面结构"。后面又给了一组正反对照:原始写法"一个年轻人走在街上,感觉很孤独",优化写法是"夜晚的街头,灯光稀疏。年轻人穿着黑外套,独自走在空旷的人行道上。镜头从背后缓缓跟随,脚步声在空巷中回响,空气中弥漫着轻雾"——孤独被拆成了空巷、灯光、脚步声、轻雾四样能被拍下来的东西。这一段是全书的方法论内核,值得单独记下来。
五、它的短板
我把短板分四类说,都有具体的落点。
第一类:第四部分整章抒情,零可执行信息。第 12 章四节,加起来三十多页,讲的是"火的使用让人从动物变为聚居的物种""文字的发明让人从个体变成历史的叙述者""印刷术让思想突破阶级的围墙""互联网让信息流动打破权威的控制",然后一路推到"AI 不是工具,而是文明的新语言""不是机器,而是人类想象力的器官""是我们心灵的延长线"。这些句子读着顺,气也足,但一本名叫"完全手册"的书,最后三十页没有一个操作、没有一个参数、没有一个案例。它更像一篇发在公众号上的行业檄文,被硬塞进了一本工具书的结尾。作者在这一章还替读者预设了反驳——相机诞生时画家说"这不是艺术",电影问世时剧作家说"机械的幻觉",Photoshop 普及时摄影师说"摧毁了真实"——这个类比本身没错,但它属于评论,不属于手册。
第二类:整页重复,至少六处。我逐页读下来,同一段文字连着印两遍的地方,能点出六处:图 7-40 之后那三段"通过优化,我们完成了三个层面的升级";"拆解分析"那段光影与情绪的拆解;Suno 免费版与付费版那两段;"ChatGPT 是导演、Sora 是摄影机"那四个工具的排比;"人类第一次不再孤独"那两段;以及最后那段"AI 是一面镜子,它映照出人类的伟大与渺小"。这不像识别误差——我每一页是单独处理的,重复的两页一字不差,连标点位置都一样。这说明排版阶段把同一个文本框放了两遍,而三审三校没有一个人看出来。对一本 12 章的书来说,六处整页重复意味着差不多十几页纸是白印的。
第三类:生成效果图不标提示词。全书上百处"生成效果如图 X-X 所示",我没有找到一张图下面给出这张图完整的提示词和参数。读者看到的永远是:正文里一句示例 → 一张图。中间缺的那一段——这张图到底是不是这句提示词生成的、有没有加词、改了什么参数——恰恰是读者最想知道的。这是所有 AI 工具书的通病,但这本书的图量最大,问题也最刺眼。第 9.2 节讲四位导演风格,宫崎骏、新海诚、诺兰、张艺谋,每个都给了"风格关键词"和"实践方法",然后十一张"效果如图",一张都没标提示词。方法讲得再对,读者也复现不出来。
第四类:数字没有语境。见第二节末尾。报价、月费、结构化定价,全都精确到五百,全都没有来源与适用条件。这一类我不算它错,只算它没法验。
六、几处说岔了、印错了的地方
按严重程度排。
一、Cursor 被列成了"影像生成平台"。第 7 章说这个七要素结构来自"OpenAI 官方 Sora 2 Prompting Guide 以及多家影像生成平台(Skywork、Cursor、Runway 等)的实践总结"。Cursor 是写代码的编辑器,跟影像生成没有任何关系。这里大概是把可灵认错了,或者是把一份行业清单整段搬过来没核。一句话的错误,但它出现在全书方法论的总纲上,性质比较重。
二、《庐山高》与《访山高》。第 2 章正文写"AI 复原的明代画家沈周的《庐山高》",紧挨着的图注印成"AI 复原的沈周《访山高》"。沈周确有《庐山高图》,传世名作,图注是错的。同一幅画,隔一行两个名字,读者会以为自己看花了眼。
三、Sora 1 与 Sora 2 那两段话打结了。第 7 章讲"逐镜拆分"时说,Sora 2 能直接生成包含多个画面、多个运镜的视频,但转场和镜头视角可能不满意,"Sora 1 可以实现更精细的镜头定义",接着让人去点左下角三个点里的"Switch to old Sora";下一段又说"旧版 Sora 的调节功能更多,但是其视频生成效果一般"。两句话分开看都对,连起来读,读者得自己把结论拼出来:老版能调的多,但效果差,所以别退回去。这个结论是全节的落脚点,却被写成了两句互不照应的话——第一句甚至读起来像是在推荐退回老版。
四、"排版预览"用 PPT 演示。第 5 章讲书籍内页插画的四步法,前三步是生成、调整、导出,第四步叫"导出作品与排版预览",配的图是在幻灯片软件里模拟书籍章节页的截图。一个号称能做到出版级的案例,最后一步用办公软件收尾,这个链条是断的。读者学到的是"生成一张图然后贴进 PPT",不是"做一页书"。
五、作者简介漏了第三作者。书末只给了乔剑、苏小文两段介绍,第三作者刘源没有。同页之后就是"全书完"。
七、我会怎么用这本书
前三部分当字典,用到再翻。第 1 到第 6 章的即梦部分,注册、抠图、扩图、海报、书籍插画,是查表性质的。界面半年一变,别背,遇到具体任务的时候翻到对应小节最有效。
第 7、8 章读两遍。第一遍记七要素和六个镜头动词,第二遍只挑三条边界记:动词决定镜头方向(写"镜头拉远"而不是"画面变远")、摇镜不能跨太多元素、镜头词放在动作描述之后风格描述之前。这三条是全书真正从调试里长出来的东西,其余都是它们的组合。
第 10.3 节抄成模板。那五条核心指令,直接复制到自己的 ChatGPT 里就能跑,是这个价位下最实用的一段。用的时候记得补一件事:跑完 20 段之后,把成片看一遍,看人物在第 18 段是不是还是第 1 段那个人。书里没做这个验证,你得自己做。
第 11 章当模板改,不是读。报价三段式、里程碑 30/40/30、大改的五种触发条件、48 小时反馈、撤单 30% 的占档补偿、交付四层——这六项抄下来改成自己的 SOW,能省掉第一次接单时最容易踩的坑。这一章值回书价。
9.2 的四位导演可以跳。方法本身没错——把原片截一帧扔给视觉模型,让它描述光线方向、饱和度、明暗层次、镜头角度,再据此反推提示词——但整节十一张"效果如图"没有一张标提示词,学不到可复现的东西。想学这四种风格,直接去看原片,看二十遍比看这一节有用。
第 12 章跳过。
适合谁:想快速上手即梦和 Sora、需要一条从注册到出片的完整路径的人;已经接了商单但不会写合同、不会报价、被改稿改到崩溃的人(第 11 章就是给你的);需要一套"多段一致性"工作流、正在做超过 15 秒片子的人。
不适合谁:想学电影语言的人,第 8 章只是一张词表,真正的景别和节奏感在片场和剪辑台上;想知道这些效果到底怎么调出来的人,图不标提示词,等于没给答案;以及所有指望工具书能跟上界面版本的人——这个领域没有这样的书。
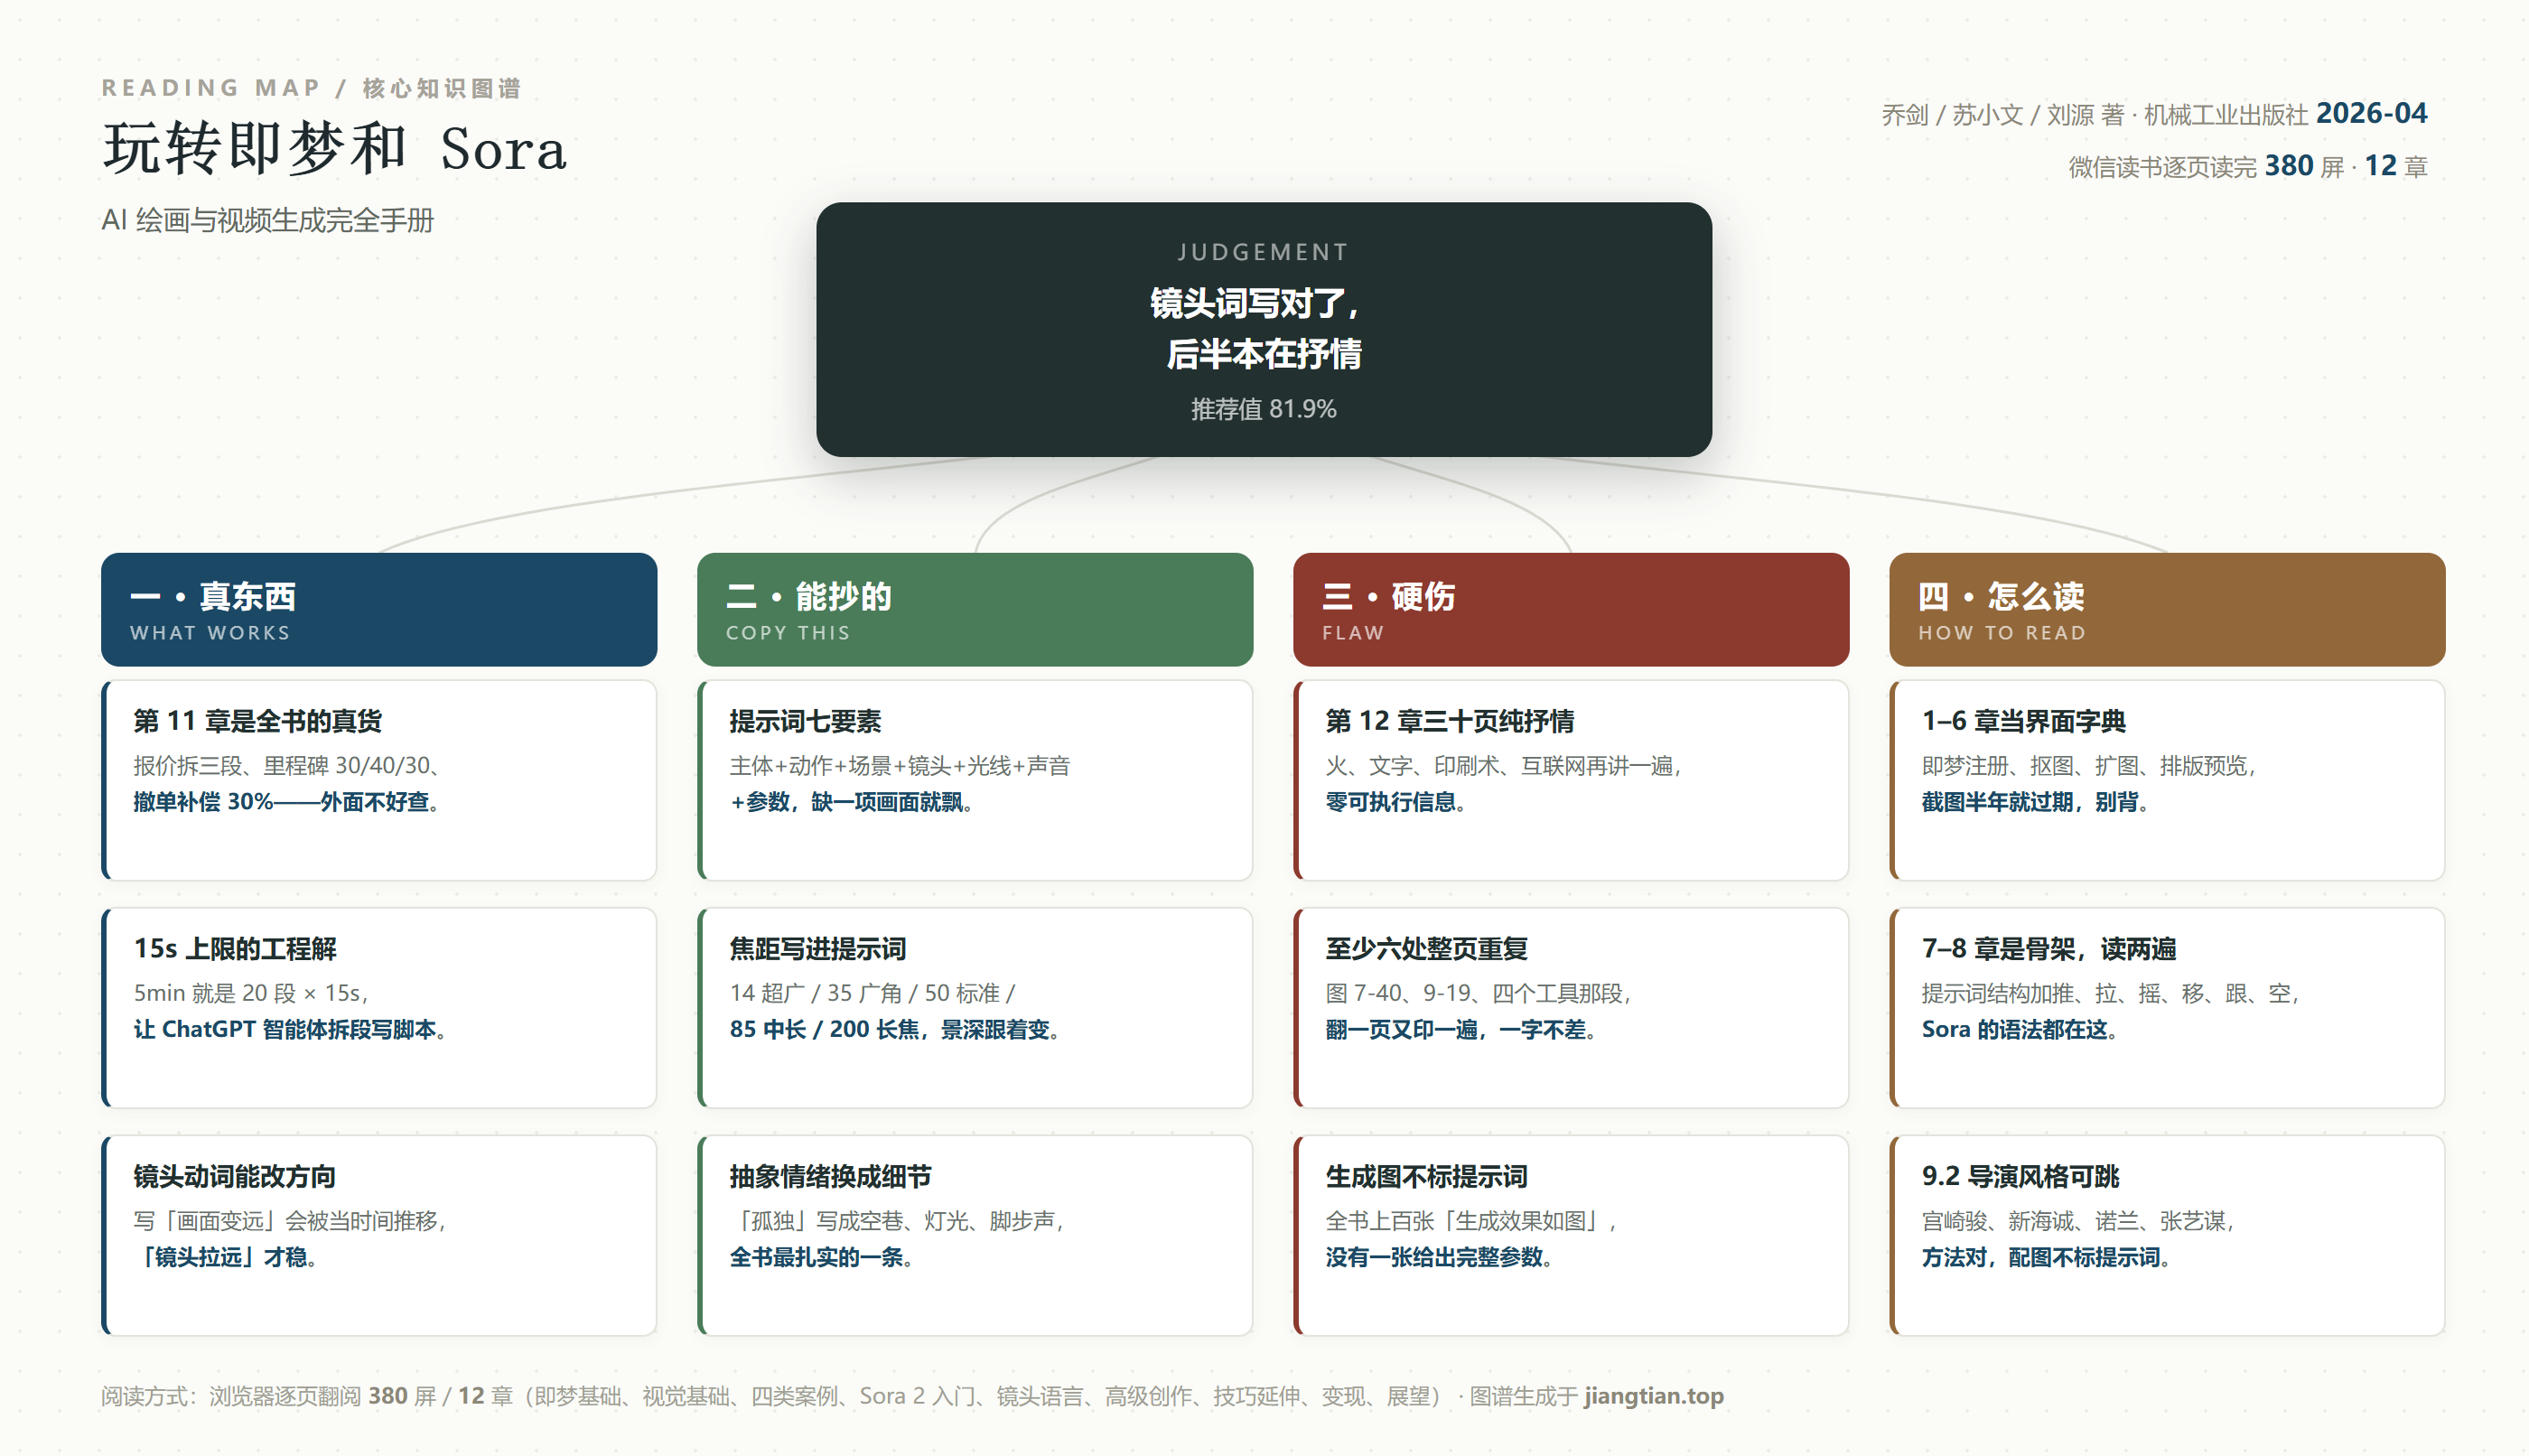
最后说一句自己的判断。这本书最像"真书"的地方,是合同里"停工与占档补偿"那六个字,和交付说明里那句"很多甲方缺的不是成片,而是成片之后该怎么用"——能写出这两句的人,是真的靠这个吃过饭。最不像"真书"的地方,是最后三十页和那六处整页重复——那不是写作者的问题,是编校的问题,但它让一本定价不低的工具书,有了明显的凑数痕迹。
它把镜头该怎么说写清楚了,却在最该被验证的地方——那上百张"效果如图"——闭了口。
阅读记录 · 乔剑、苏小文、刘源著《玩转即梦和Sora:AI绘画与视频生成完全手册》,机械工业出版社,2026 年 4 月第 1 版,ISBN 9787111807698。全书 12 章,我从版权页读到末页"全书完",书末显示微信读书推荐值 81.9%。文中引文、参数、条款与提示词均照录原书。因原书为图片版,OCR 存在个别字符误差(例如把"剪映"认成"草映""前映"、把"推镜"认成"推镑"),凡引用处均已对照上下文校正,未改写原意。第五节所述整页重复,重复段落为逐字一致,我据此判断为印刷重复而非识别误差;若读者手中的版本无此问题,以纸质版为准。第六节关于 Cursor 的那一句、关于《庐山高》图注的那一句,均可在原书对应页面直接核对。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: