
ComfyUI工作流:它把节点接对了,却把 SDXL 说成了文本模型
一、先看它的地形
九章,按用途能分成三层。第 1、2 章是入场:装整合包、配模型、装 Manager 和汉化插件、认节点。第 3 到第 6 章是方法:常用工作流(文生图、图生图、LoRA、局部重绘、三种高清放大、SDXL 标准工作流)、ControlNet 的八类预处理器、提示词写法、底模与 LoRA 的关系。第 8、9 章是扩展与实战:SD 放大、AnimateDiff、Impact Pack、Efficiency、IPAdapter、ReActor 换脸、艺术字、模特换装、流体文字、真人转手办。
作者身份交代得很清楚。版权页上写着宿丹华负责其中 15 万字,其余由贾亦男负责。作者简介里,宿丹华是哈尔滨理工大学艺术学院数字媒体艺术系副教授,主讲广告设计与创意课程;贾亦男是哈尔滨师范大学传媒学院数字媒体艺术系副主任、副教授、硕士生导师。两个人的背景都是设计教学,不是算法工程。这一点很重要——它决定了这本书的视角:从"我怎么把这个效果做出来"出发,而不是从"这个模型内部发生了什么"出发。
前言里有一段话,我认为是全书的自我定位,也是它的免责声明:
特别提示:在编写本书时,参考并使用了当时最新的 AI 工具界面截图及功能作为实例进行编写。然而,由于从书籍的编撰、审阅到最终出版,存在一定的周期,在这个过程中,AI 工具可能会进行版本更新或功能迭代,因此实际的用户界面及部分功能可能与书中所示有所不同。
紧接着还有一句:关注公众号,回复本书第 146 页最后一个字,可以获得配套的 43 节在线视频课程和两个收录数百篇 AI 文章的在线知识库。
这两句话放在一起,基本就把这本书的性质说完了:书是索引和骨架,视频是血肉。作者自己知道截图会过期,所以给了一个"以书为纲、以视频为详"的兜底方案。这个安排很诚实,但也暴露了工具书在当下的结构性困境——界面半年一变,纸书追不上,于是文字退化成截图的说明,教学的责任被推给了视频。
我读完之后的一个总体判断是:这本书的知识密度是"头重脚轻"的。前面六章加起来,真正的信息量不及第 7 章一章。原因不复杂:界面操作没有因果,只有顺序,而顺序是可以穷举的;训练模型有因果,参数改了会发生什么、为什么,这才是需要被解释的东西。作者在不需要解释的地方写得很详细,在需要解释的地方——除了第 7 章——基本只给了结论。
二、唯一一章讲"为什么"的,是第 7 章
第 7 章讲训练 LoRA,从准备软件环境到选出最合适的那一个,六个步骤走完。这一章的写法跟前面六章明显不同:前面是"点击这里,然后点击那里",这里是"这个值调高会怎样,调低会怎样,为什么"。
举一个具体的例子。讲训练轮数与重复次数时,作者给了一个算式:在 LoRA-scripts 里,素材文件夹必须以"数字_项目名"的方式命名,这个数字是重复次数;假设文件夹前面写的是 20,max_train_epochs 设成 15,素材 20 张,那么训练时模型要处理的样本量是 20×15×20=6000。他原话说"SD 将要对 6000 张图片进行学习"。
这个说法的单位是错的——不是"6000 张图片",是 6000 次样本(steps),同一张图被反复喂了 300 遍。但机制他讲对了:重复次数×轮数×图数,三者的乘积决定训练的总步数。一个读者只要记住这个乘法关系,就知道为什么"素材少就要提高重复次数"、"重复太多会过拟合"。这是全书少有的、能在换一个场景之后还用得上的知识。
学习率那一节也讲得实在。unet_lr 默认 1e-4,text_encoder_lr 默认 1e-5,两个值差一个量级,作者解释了原因:U-Net 的学习难度更高,文本编码器更容易学坏。他把两种失败形态也说清楚了——unet 学习率过低,生成的图跟素材不像;训练过度,图像固化、质量下降。text_encoder 学习率过低,提示词对画面的影响力变弱;训练过度,同样固化,失去"天马行空"的空间。这两句话对应的是 LoRA 训练里最常见的两个坑:学不像、学太死。很多教程只会告诉你"用默认值",不会告诉你默认值调错了会往哪个方向坏。
优化器给了两个:AdamW8bit 和 Lion。前者"在不影响模型精度的情况下大幅减少存储和计算资源",后者"由 Google Brain 发表,各方面表现优于 AdamW,同时占用显存更小"。这里作者没有多做解释,但至少点了名,读者知道除了默认的那个还有另一个选项。
数据标注这一段,是我认为全书最见功力、也最容易被略过的地方。流程是:用 WD14 tagger 自动打标,阈值设 0.4(意思是只保留置信度超过 40% 的标签),然后打开 BooruDatasetTagManager 逐张核对——打开"翻译标签"看中文,把明显错的删掉,比如 twitter username、watch 这种跟画面无关的词,缺的补上,比如给一个吊坠补上 wing。全部核完按 Ctrl+S 保存。
为什么要人工过一遍?作者没明说,但道理很清楚:自动打标器是按通用图像训练的,它会把水印认成 signature、把画面里的推文框认成 twitter username。这些脏标签如果留在训练集里,模型就会把"水印"和"这张图"绑定起来,你以后生成的每一张图都会带着类似水印的东西。这一步没有捷径,只能一张一张看。作者把这个"没有捷径"的步骤老老实实写出来了,还配了图,这比讲十个节点都有用。
素材处理的规矩也给得细:图片长宽都处理成 64 的倍数,尺寸不要高于 1024,文件名必须是英文或数字,去背景要确保"周边杂色"清干净,物体边缘不能有明显锯齿。这几条是训练失败最常见的原因,尤其是边缘锯齿和背景杂色——它们会变成模型学到的"特征",让生成的图永远带一圈毛边。作者在这里用的是"确保""尽量保证"这种经验口吻,不是"必须",我觉得这个分寸是对的,因为他确实拿不出严格的标准。
还有一个细节值得记一笔。他讲怎么从训练出来的 15 个模型里挑一个:先看 Loss 值,"此数值在 0.8 左右时得到的模型效果比较好",所以图上第 9 个和第 11 个模型大概率更好。这个方法快捷但不精准,他自己也承认,于是补了第二个方法——用 XYZ 图表法,把 15 个模型×11 个权重组合成 150 组,一次跑出来,生成一张 326MB 的对比大图,放大看哪一格最好。
问题就出在这里。这个"XYZ 图表法",是 WebUI 的功能,不是 ComfyUI 的。作者的原话是"在'脚本'下拉列表选择'XpWzplot'选项"——ComfyUI 的界面上根本没有一个叫"脚本"的下拉列表。要到第 8 章讲 Efficiency 扩展时,他才回到 ComfyUI 里做 XY 图表,并特意说明"与 WebUI 的 XYZ 图表脚本不同,ComfyUI 中是 XY 图表脚本,也就是控制 2 个参数"。
这就不是笔误了。这是把一个 WebUI 教程的段落,整段搬进了一本 ComfyUI 的书,而且没有做转换。更奇怪的是,同一章稍后讲"安装底模及 LoRA 模型"时,路径写的是 D:\Stable Diffusion\sd-webui-aki-v4.4\models\Stable-diffusion,操作是"打开 Stable Diffusion WebUI 页面,单击 Stable Diffusion 模型下拉列表框右边的刷新按钮"。一本书名里写着 ComfyUI 的书,教读者去 WebUI 里刷新模型列表。
我能理解作者为什么这么写:他有多年 WebUI 使用经验,很多操作在两边是共通的,写顺手了。但读者买这本书,恰恰是因为不会用 ComfyUI。一个不会用 ComfyUI 的人,照着这一节去找"脚本下拉列表",会找很久,然后怀疑自己装错了版本。
三、能直接抄走的三样东西
抛开这些,书里有三样东西我认为是真手艺,换个工具也成立。
第一样是 Canny 的双阈值原理。第 4 章讲 Canny 预处理器时,作者没有停在"低阈值控制线条复杂程度"这种废话上,而是把算法讲了一遍:一般的边缘检测用一个阈值滤掉小梯度,Canny 用双阈值——高于高阈值的点强制保留为强边缘;低于高阈值但高于低阈值的点标为弱边缘;低于低阈值的点直接消除;弱边缘点如果和高阈值点连在一起,也保留下来。所以把两个阈值都拉到 255,你得到的是画面里最主要、最明显的轮廓;都拉到 1,你得到几乎所有边缘,包括噪声。阈值设得过低,生成的线稿太碎,出图会出现"分割零碎的斑块";设得过高,控制力不够。
这段话的价值在于它给了你一个判断依据。你看到线稿太碎,知道是阈值低了;你看到控制不住姿态,知道是阈值高了。而不是像很多教程那样,让你"多试几次"。这也解释了为什么书里所有案例的 Canny 阈值都落在 100 到 200 之间——这不是玄学,是算法决定的合理区间。
第二样是提示词的注释语法。第 5 章讲提示词权重时,提到一个很实用的问题:当提示词里同时有"银发蓝眼"和"黄色西装"时,模型经常把包也染成黄色,因为颜色词会串到别的主体上去。解法是用注释把每个主体隔开,格式是"主体\(注释1,注释2\)"。书里给的例子是:
1 girl \(silver hair,blue eyes,\(yellow business suit:1.4\)\),slim body,\(walking\),1 black handbag,street background……
不加注释时,包变成了黄色;加了注释之后,包保持黑色。这个技巧在别的教程里很少见,但它是稳定的:它利用了 CLIP 的分词边界,让颜色词只作用在括号内的主体上。同一节里还有一条更基础但更容易错的规矩:提到 Embedding 时,`embedding:` 的 e 必须小写,写成 `Embedding:` 就是无效的。这种一个字母的坑,只有真踩过的人才会写进去。
第三样是"参数基线"这个概念。把全书几十个案例的参数摊开看,会发现作者几乎每次都用同一套:步数 25、CFG 7、采样器 dpmpp_2m、调度器 karras。图生图和高清修复会把降噪降到 0.6 或 0.8,SDXL 会把尺寸提到 1024。这套数字从第 3 章一直用到第 9 章,没有变过。
这既是这本书的局限,也是它无意中给出的最有用的东西。局限在于:作者从不解释为什么是 25 步不是 30 步,为什么 dpmpp_2m 比 euler 好——他只在第 8 章做 XY 图表时顺便说了一句"euler、dpmpp_sde 和 dpmpp_2m 在 10 步以后出图效果都非常不错,euler 和 dpmpp_2m 比较相似,lcm 在任何步数下都不好"。有用在于:一套稳定的基线,比一堆"你可以试试"更有价值。新手最怕的不是参数不好,是不知道从哪儿开始。有了这套基线,你至少能先跑出一张能看的图,再去动其中一个变量。
顺便说,那个 XY 图表的结论是有信息量的:lcm 在这个底模上完全不行。lcm 是"少步数快速出图"的方案,理论上 4 到 8 步就能出图,但它对底模有要求,配错了就是一团糊。作者用一张 4×4 的对比图把这件事证伪了,这比任何文字描述都直接。
四、它的短板
现在说这本书最需要被指出的部分。我把短板分成三类:事实错、载体错、生产事故。三类性质完全不同,需要分开算账。
第一类,事实错。第 6 章开头介绍 SDXL 时,原话是:
SDXL 模型,是一种基于深度学习的文本生成模型,旨在解决大规模文本生成任务中的计算效率和内存消耗问题。通过引入一系列优化技术,如梯度检查点(Gradient Checkpointing)和文本编码器训练(Text Encoder Training),SDXL 能够在有限的计算资源下高效生成高质量文本。
这一段从头到尾都是错的,而且错得很彻底。SDXL 是图像生成模型,是 Stable Diffusion 的 XL 版本,输出的是图片,不是文本;它解决的问题是"在更大分辨率、更复杂构图上生成图像",不是"文本生成任务的计算效率"。梯度检查点确实用在了 SDXL 的训练里,但那是一种用计算换显存的技术,跟"生成文本"没有关系。
这段话的来历我大概能猜到:它是从某个介绍"大规模模型训练优化"的段落里剪过来的,把主语换成了 SDXL。这类错误最危险的地方不是它错,而是它错得很像对的——句式专业、术语密集、读起来像那么回事。一个刚入门的读者读到这里,会把"SDXL 是文本生成模型"记进脑子里,然后在这里建立一整套错误的理解,后面所有关于 SDXL 的段落都会被他读歪。
同一章还有一句,我也要标出来:"SD1.5 的提示词只能使用单词组成,使用句子生成反而效果不好。"这句话在经验层面有一定的真实性——SD1.5 的 CLIP 确实更吃 tag 式的短词——但把它写成"只能",就成了硬规则。真实情况是:句子也能用,只是长句里各个词的权重会被稀释,你需要用括号和数字把重点提回来。作者自己在第 5 章就演示了怎么用权重解决这个问题,到第 6 章又说"只能",前后是打架的。
第二类,载体错。前面已经说过两处:XYZ 图表法用的是 WebUI 的脚本菜单,装模型给的是 WebUI 的目录路径。这两处不是孤例,我把它们归成同一个问题——这本书的第 6 章后半段,是从一份 WebUI 教材里搬过来的,搬运时没有做载体转换。
为什么我能这么判断?因为同段落里的操作细节全是 WebUI 的:下拉列表叫"Stable Diffusion 模型",刷新按钮在"下拉列表框右边",LoRA 在"LoRA 选项卡"里刷新。ComfyUI 的模型列表在节点内部,刷新方式是重启或者点右上角的刷新,跟这个描述对不上。一个真正在 ComfyUI 里做过这些操作的人,不会这么写。
这类错的杀伤力比事实错小,但更让人烦躁。事实错你可以查证,载体错你只能一遍遍试,试到你怀疑自己的软件装坏了。而这本书面向的恰恰是"第一次装 ComfyUI"的人。
第三类,生产事故。这一类跟知识无关,跟编校有关。我读的时候做了标记,至少有五处整页内容重复:讲三种高清放大时,"模型高清放大"那段定义连着出现两次,一字不差;讲 Lineart 预处理器时,四种预处理器的介绍连着出现两次,连标点都一样;讲 Tile 放大时,最后的结论段和配图连着出现两次;讲 Portrait Master 的介绍、讲真人转手办的提示词设置,也都各重复了一次。
还有一处更典型的复制粘贴残留。第 4 章讲 Inpaint 的工作流搭建,最后一步写的是"这样 OpenPose 的工作流就搭建完成了"——上一节讲的是 OpenPose,编辑到这里忘记改了。同一章里还有一处,讲 Tile 的案例时写"在正向提示词框中输入对精装修的描述",而这一段的正向提示词是"一个女孩、樱花、看镜头",跟精装修没有任何关系——"对精装修的描述"这六个字,是从前面 MLSD 毛坯房案例那里粘过来的。
这些都是很便宜就能抓到的错。整页重复,只要责编把两页并排看一眼就能发现;OpenPose 写成 Inpaint,只要通读一遍就能发现。它们出现在一本 2026 年 1 月出版、定价不低的专业书里,说明编校环节的投入跟这本书的篇幅不匹配。
第四类,我认为最值得说的短板,是"正确但无用"。这一类不算错,甚至不能算缺点,但它是这本书最大的机会成本。
举 ControlNet 那一章。八类预处理器:Canny、SoftEdge、Scribble、Lineart、MLSD、Depth、OpenPose、Inpaint、Tile,每一类都走了完全相同的四步——新建预处理器节点、新建 ControlNet 应用节点、新建 ControlNet 加载器并选模型、把"条件"串接在 CLIP 文本编码器和 K 采样器之间。除了预处理器名字和模型文件名不同,其余一字不差。每一类都配了同一个案例结构:上传素材、选底模、写提示词、设参数(25 步、CFG 7、dpmpp_2m、karras)、点队列、出图。
这套模板对"照着做"是友好的。但它回避了一个读者真正会问的问题:我什么时候该用 Canny,什么时候该用 Lineart?
书里其实散落着答案:Canny 提取的是"硬边缘",线条粗细统一、像电脑画的;Lineart 有笔触痕迹,粗细过渡更像手绘;Scribble 线条粗、精度低,适合"只要大致轮廓、细节让模型自由发挥";MLSD 只保留直线,适合建筑、室内、路桥;Depth 给前后景关系;OpenPose 给人体骨架;Tile 用来在放大时锁住结构、补细节。这些描述都写对了,但它们分散在八个小节的开头各一段,作者从来没有把它们并排放在一张表里,也没有说过"如果你要做 X,选 Y"。
于是读者读完这一章,得到的是八份互不相干的说明,而不是一个选择框架。这就是"正确但无用"——每一句都对,合起来不构成判断力。
同样的结构性问题还有:全书几十个案例,没有一个是失败的。每一张出图都是"效果非常好""效果相当不错""比之前更加自然了"。唯一承认失败的地方是第 8 章 IPAdapter 换脸,作者写了一句"换脸的效果还可以但是出现坏图的概率较大,需多次抽卡",以及在流体文字那节写"每次生成的图像效果可能不会很完美,需要多次抽卡"。这两句话是全书写得最诚实的两句,可惜只有两句。
一本教人做图的书,如果只展示成功案例,读者学到的其实是"这件事能成",而不是"这件事会怎么败、败了怎么救"。而 AI 绘画的真实日常,是十张里挑一张。
五、几处参数上的含混
除了上面四类,还有几处参数解释我认为是含混的,需要单独说。
权重的括号语法。第 5 章说:给单词加大括号"{}",增加 1.05 倍权重;加小括号"()",增加 1.1 倍;加双括号"(())",权重提升为 1.21 倍,最多可以叠三个双括号,到 1.331 倍;加中括号"[]",降低 0.9,同样最多三个;或者直接用冒号加数字,(fractal art:1.6)。
问题是,这套语法是两套东西拼起来的。大括号 1.05 是 NovelAI 的语法;小括号 1.1、中括号 0.9 是 WebUI 的语法;冒号加数字是通用的精确写法。在 ComfyUI 里,最稳的其实只有最后一种——(word:1.2),因为它不依赖解析器的默认步长。作者把三种混在一起讲,读者会以为它们完全等价,实际上在同一个提示词里混用不同体系,结果是不确定的。
更麻烦的是"最多可以叠加三个双括号"这句。这是个经验观察(1.1³≈1.331),不是规则。真实情况是你可以叠更多,只是超过 1.5 之后画面会开始变形,作者自己在后面也说了"权重提升到 1.6 时,将导致图像完全发生变化"。既然知道会变,前面就不该写"最多三个"这种封顶的说法。
Loss 0.8。第 7 章说训练时"此数值在 0.8 左右时得到的模型效果比较好"。这句话单独看没问题,但它是从"某一次训练的经验"里提炼出来的,作者没有说明它依赖底模、数据集、分辨率、batch size。换一个数据集,Loss 0.8 可能意味着严重欠拟合,也可能已经过拟合。Loss 是一个相对指标,看趋势比看绝对值可靠——作者其实也说了"只要是一直在下降,就说明训练的素材及参数是对的",这句才是真正的判据。0.8 这个数字,读者当参考就好,别当门槛。
素材数量。第 7 章前面说"训练具象类 LoRA 要收集的图片建议 35 张左右",讲珠宝案例时又说"使用 Midjourney 生成了近 200 张珠宝图像,并从中选择了 100 张",到算 20×15×20 时,素材数变成了 20 张。三个数字,三种口径。我能理解这是"建议值/实际收集/实际使用"的区别,但书里没有把这层说清楚,读者很容易困惑:到底要准备多少张?
我的理解是:35 张是下限(够模型学到特征),100 张是舒适区(够覆盖多样性),20 张是快速验证(先跑通流程)。这个梯度其实很有用,可惜作者没有明说。
六、77.8% 这个分数在说什么
书末显示推荐值 77.8%,23 人点评。这个样本量很小,说明不了太多,但 77.8% 在微信读书的技术书里属于中等——比"神作"低,比"凑数"高。它对应的读者感受大概是:能用,但有明显的坑。
我觉得这个分数是公道的,甚至略偏高。公道的部分在于:这本书确实把 ComfyUI 这张复杂的界面拆解清楚了,一个完全没接触过的人,照着第 1 到第 3 章能装起来、能跑出第一张图,这个价值是实的。第 7 章的训练流程,市面上讲得这么细的中文书不多。
略偏高的部分在于:它有硬错,而且硬错出现在"基础概念"这一层。一本工具书可以在细节上过时,可以在案例上平庸,但不能把核心概念定义反。SDXL 是图像模型还是文本模型,这不是版本问题,是常识问题。读者花六十多块钱买一本书,买的就是"不用自己分辨哪句对哪句错"。
还有一个隐性问题:这本书的时间戳。版权页写的是 2026 年 1 月出版,但书里所有截图都是 2023 年底到 2024 年中的界面——秋叶整合包 v1.3、SDXL base 1.0、InsightFace 0.7.3、Python 3.10.11、ReActor 还是需要手动装 whl 的版本。也就是说,从截图到成书,中间隔了将近两年。而这两年正是 ComfyUI 变化最大的两年:现在的前端已经换了新界面,节点管理的交互改过,很多扩展已经内置。作者在前言里承认了这一点,但承认不等于解决——读者拿到的仍然是一本"两年前的界面说明书"。
这也是我为什么建议把它当"原理书"而不是"操作书"读。界面的部分会死,原理的部分不会。
七、我会怎么用这本书
三章当字典,用到再翻。第 1 章(装软件)、第 2 章(节点逐个介绍)、第 4 章(ControlNet 八类预处理器)。这三章是查表性质的,顺着读会累,遇到具体问题时翻到对应小节最有效。特别是第 4 章,当你不知道某个预处理器是干什么的,翻它的开头那两段,比看官方文档快。
一章细读两遍。第 7 章。第一遍照着流程走,把 LoRA-scripts、打标软件、文件夹命名规则跑通;第二遍只看参数解释那几页,把 unet_lr、text_encoder_lr、network_dim、save_every_n_epochs 这四个参数的作用和失效方向记住。这四个参数是 LoRA 训练的全部变量,其余都是它们的组合。
一章只看案例思路。第 9 章。ReActor 换脸、艺术字、模特换装、流体文字、真人转手办,这五个案例的价值不在操作步骤(步骤会过时),在于它们告诉你"ComfyUI 能干什么"。模特换装那个案例是 IPAdapter + FaceID 双模型接入,流体文字是先在 PS 里做一张黑白素材图再交给 ControlNet 控制——这两个思路比具体参数值钱。
两处直接跳过。第 5 章的权重视重那几页(语法混用,容易学歪,记住 (word:1.2) 一种就够了),第 6 章的 SDXL 介绍(概念是错的,去看官方文档或者别的书)。
一个提醒。书里所有的路径、版本号、扩展名都按 2026 年初的环境写的,你现在照着装,大概率会遇到"找不到这个文件""这个按钮没了"。遇到这种情况不用怀疑自己,是书老了。真正不会过时的只有三类:提示词的写法、训练参数的因果、以及每种 ControlNet 提取的是什么信息。把注意力放在这三类上,这本书的折损率会低很多。
适合谁:完全没用过 ComfyUI、需要一个从装到出图的完整路径的人;想搞明白 LoRA 到底怎么训、不想只看别人结论的人;做设计、需要快速知道"哪些效果 ComfyUI 能做"的人。
不适合谁:想学扩散模型原理的人,这本书只有一层皮;已经在用 ComfyUI 的人,前面六章对你没有增量;以及所有指望一本书能跟上界面版本的人——这个领域没有这样的书。
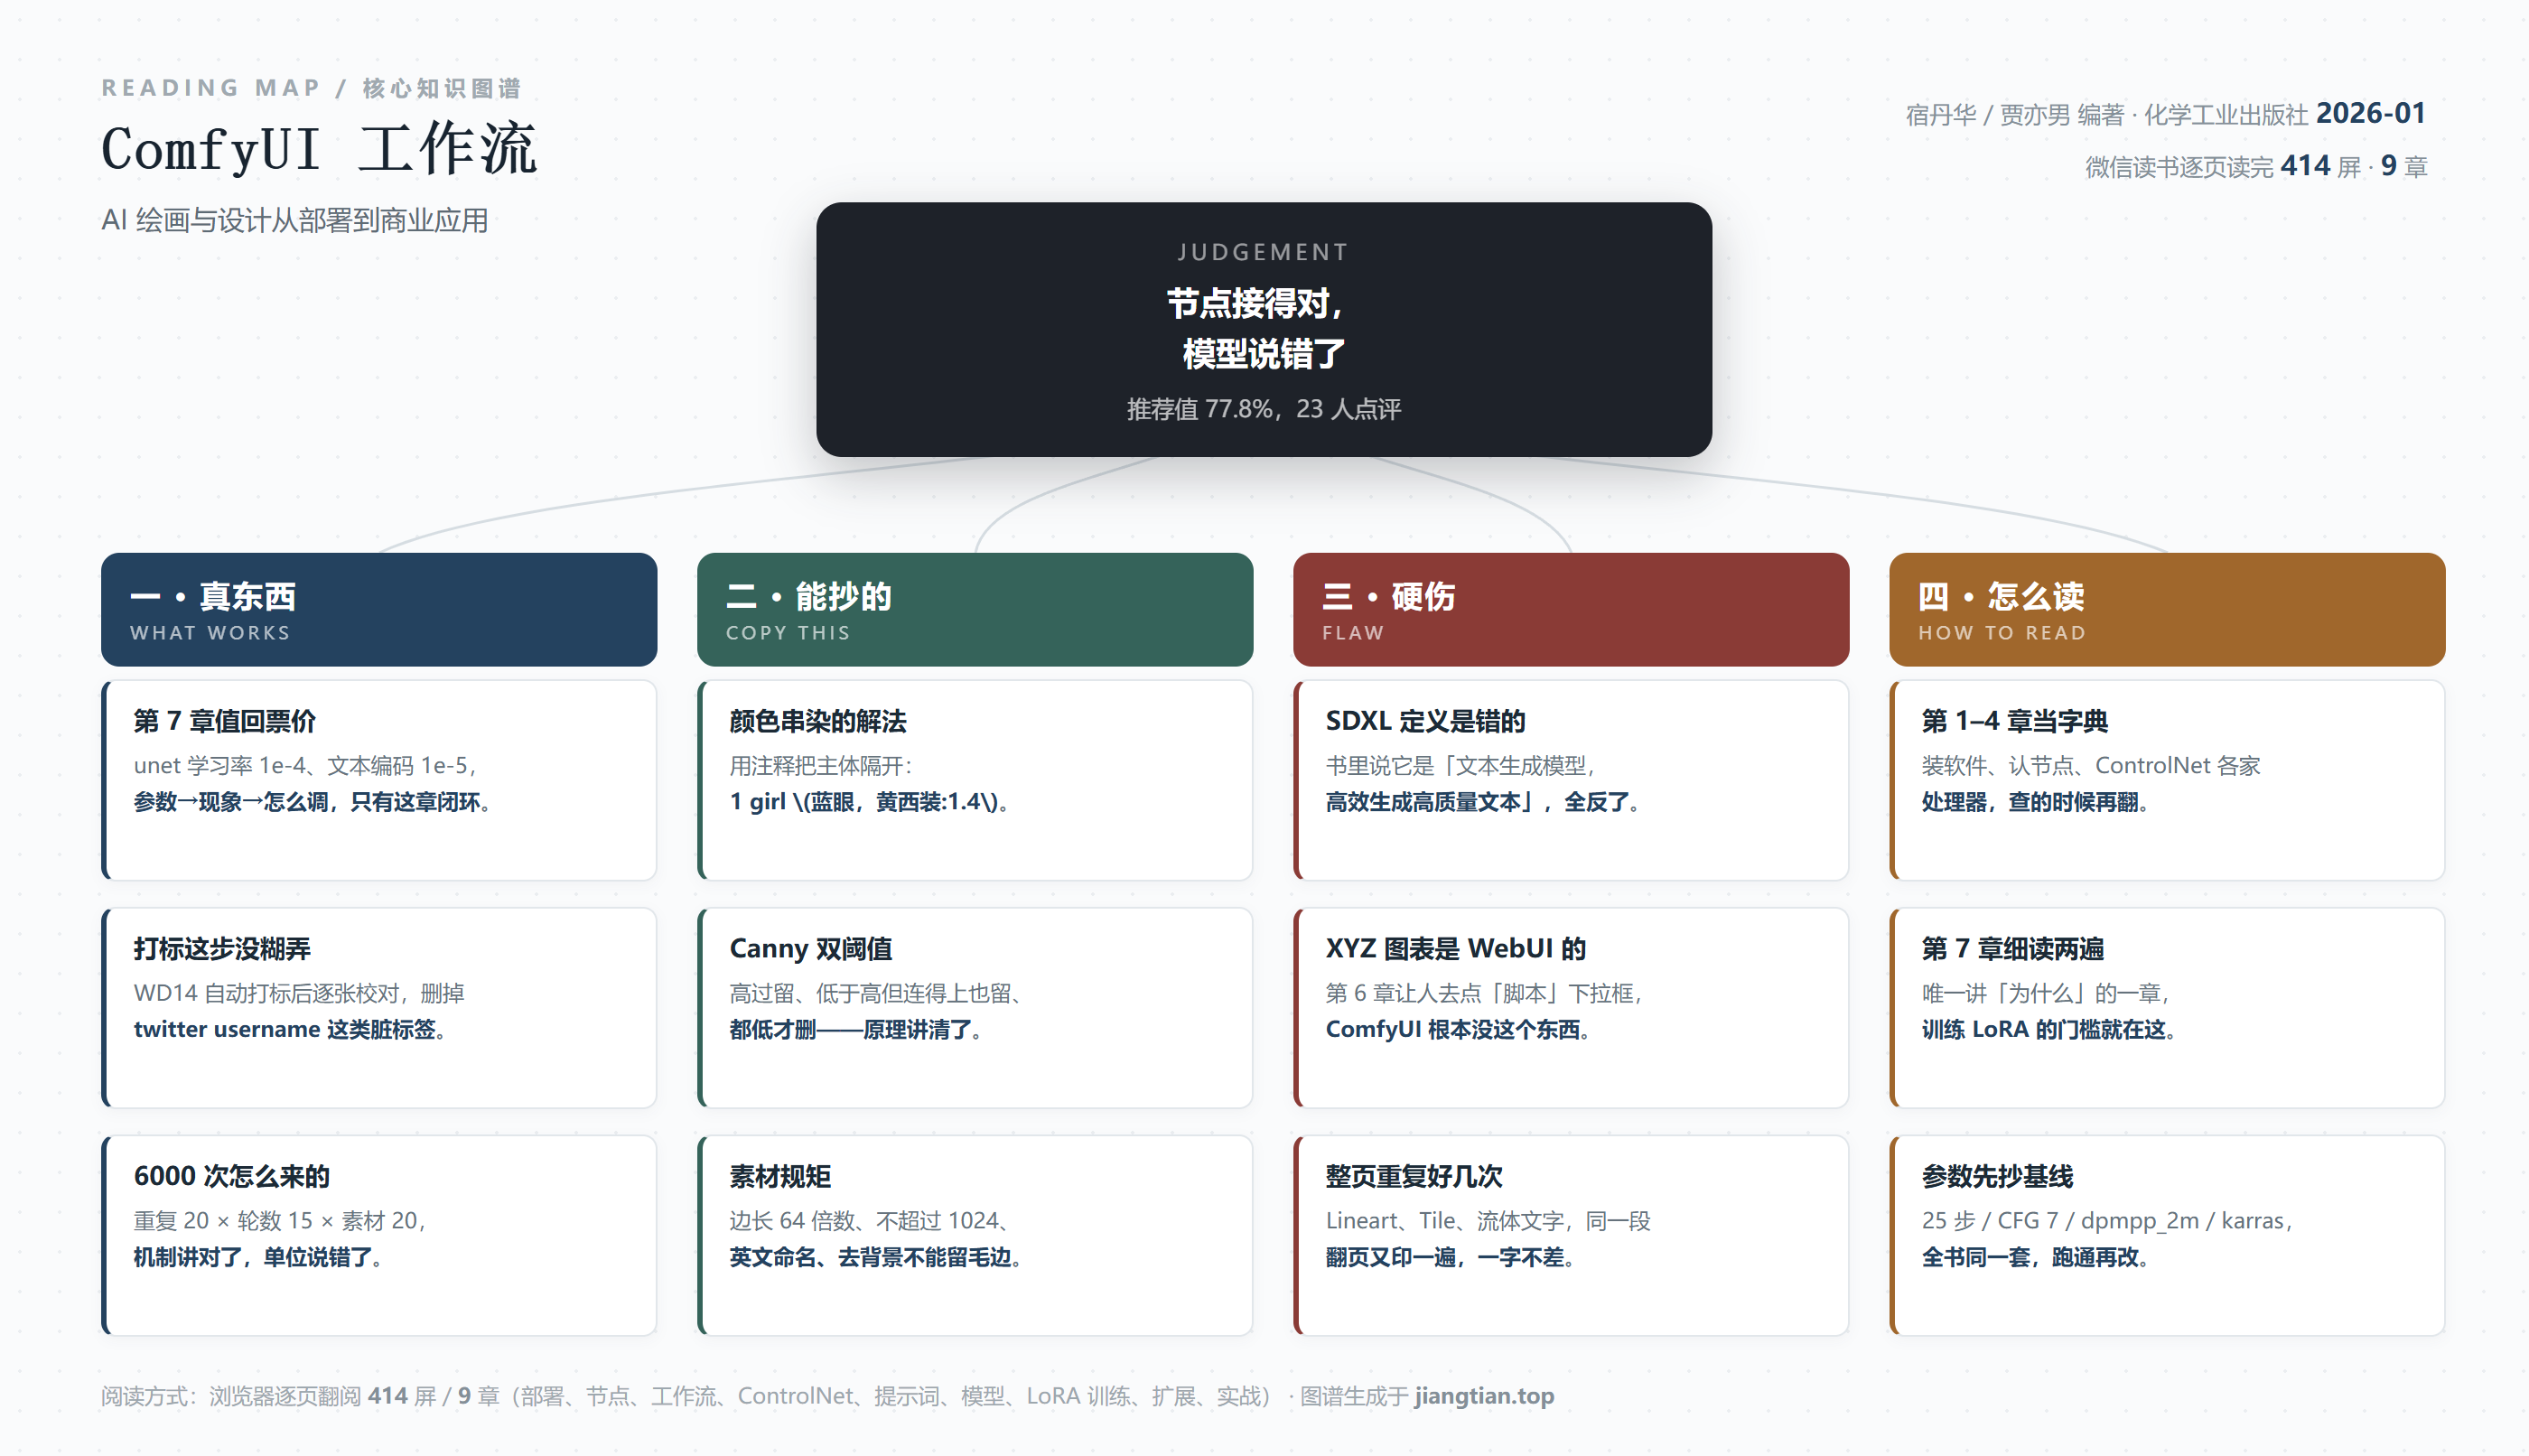
最后说一句我自己的判断。这本书最像"真书"的地方,是第 7 章那句"这些 TXT 文件记录的是机器对图片的解读"——它把数据标注这件事的本质说清楚了:不是你在教模型,是你在校对机器对世界的误读。能写出这句话的人,是真做过训练的。最不像"真书"的地方,是第 6 章把 SDXL 定义成文本生成模型——那句话不像一个做过训练的人写的,更像一个在赶字数的人从别处剪过来的。
它把 ComfyUI 的每一根线都接对了,却在最该说清楚的那个模型上,说了一句完全相反的话。
阅读记录 · 宿丹华、贾亦男编著《ComfyUI工作流:AI绘画与设计从部署到商业应用》,化学工业出版社,2026 年 1 月第 1 版,ISBN 9787122466532。全书 9 章,我从版权页读到末页"全书完",书末显示微信读书推荐值 77.8%、23 人点评。文中引文、参数、路径与提示词均照录原书;因原书为图片版,OCR 存在个别字符误差(例如把"替代"认成"蔡代"、把"阈值"认成"阔值"),凡引用处均已对照上下文校正,未改写原意。第四节所述整页重复,我读到的是电子版,无法完全排除阅读器渲染因素,故仅陈述"同一段读了两遍"这一阅读事实,不据此推断责任在哪一方。关于 SDXL 的那段定义,我按原文照录,未做删改,读者可自行核对 Stability AI 发布的 SDXL 论文与模型说明。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: