
零基础造应用,真的只差一句话吗?
一、先看它的地形
10 章,按用途能分成三层。前三章是入场:第 1 章讲 AI 把开发者的角色从“写代码的”变成“下指令的”,第 2 章手把手装 Cursor,第 3 章讲怎么跟它说话。中间六章是案例:第 4 章带孩子做游戏,第 5 章做教学工具,第 6 章做店面视觉,第 7 章做图表,第 8 章部署上云,第 9 章做网站和小程序顺带讲副业。第 10 章单独一层,讲 MCP 和智能体。
作者的定位写得很直白,前言里那句是全书的总纲:一个清晰的创意 + 精准的需求描述 = AI 为你生成可运行的应用程序。书里 30 来个案例,全是围绕这个等式展开的,每个案例的骨架也高度统一——建个文件夹、写一段提示词、发送、等一分钟、点“Accept all”、双击打开看效果、不满意再说一句。
这个骨架有它的好处:读者不会迷路。坏处也一样明显:它把“开发”这件事里所有难看的部分都省略了。整本书里没有一次单元测试,没有一次版本管理,没有一次错误处理的设计,也没有一次性能或成本的核算。它教的是“怎么让东西跑起来”,不是“怎么让东西靠得住”。
书里有些具体数字倒是记得很实,可以作为时间坐标:Cursor 版本 0.48.8,新账号默认 14 天 Pro,Premium 模型每月 150 次快速请求,gpt-4o-mini 和 cursor-small 不限量,Pro 订阅 20 美元一个月、500 次。主力模型是 claude-3.7-sonnet,配 Agent 模式。这些数字能让你一眼看出这本书写于 2025 年上半年——那年 3 月 Claude 3.7 刚出,7 月 Cursor 就换了收费模型,后面又改过几轮。所以书里关于“额度”和“价格”的部分,只能当历史看。
二、全书写得最好的一段,是一次失败
5.2 节的“AI 数字迷宫”,是整本书里唯一一处让我坐直了的地方。因为它是唯一一处作者承认自己没一次做成的。
任务是做一个闯关答题的迷宫游戏,每过一关答一道 1 到 10 的加减乘除。第一版发出去,Cursor 很快交付,作者一运行发现:闯关界面加载出来了,但数学题根本没出现,界面上一句引导也没有。他把这个问题截图发回去,Cursor 花了三分钟修好,题出来了,判断对错也对。
然后第二次翻车:“可是我们高兴得太早了!系统居然会‘无限循环’!明明我们答完最后一题后,系统就该计算总分了,它却一直自动给出新题目!”
他把问题甩回去,Cursor 又改了一版。改完之后他自己去检查代码,发现“程序中的问题还没有解决”。到这一步,他做了一件全书其他地方很少做的事——打开浏览器按 F12,去看控制台。
看完他就明白了:
“破案”了!程序中的语法没问题,问题是我们和 Cursor 对“关口”这个词的理解不一样。我们说的“关口”是指连续做特定数量的数学题,Cursor 却把它当成了游戏里无限循环的副本,所以,程序不停地给出新的数学题!
最后的解法不是改代码,是改说法:他把控制台的输出截成图,在对话框里按 Ctrl+V 贴进去,再加一句话——“不需要有多个关卡,闯一个关卡就可以”。这一版才真的对了。
这段为什么值钱?因为它把“AI 编程为什么会失败”这件事讲到了根上。不是因为模型不会写循环,也不是因为它不懂 JavaScript——它写的代码语法完全正确、跑得通、逻辑自洽。失败的原因是:**你心里有一个业务词(“关口”),你以为它只有一个意思,而模型按另一个同样合理的意思实现了它。**代码没错,理解错了。而修这种错的办法不在代码里,在说法里:把产生歧义的那句人话,换成一句没有歧义的人话,再附上能让对方看到现实的证据(控制台截图)。
全书 30 个案例,只有这一段有失败、有排查、有工具、有结论。其余 29 个都是“发送、接受、成功”,顺利得像演示视频。我不怀疑它们真跑通了,但一个案例只给你看结果的时候,你学到的是“这件事能成”,而不是“这件事卡在哪、卡住怎么办”。后者才是读者真正会遇上的。
还有一处小证据,作者大概没注意。10.6 节讲自己写 MCP Server 时,提示词让模型查深圳天气,返回的是“目前深圳的天气数据暂不可用”——因为他写的假数据里只有北京、上海、广州三个城市。这张失败截图他留着了,还专门解释了一句“这是有意为之”。这个保留反而是全章最有力的地方:它证明工具是真的被调用了。如果模型在编,深圳的天气它张口就来。
三、第 8 章值回票价
如果这本书只能读一章,读第 8 章。它是全书唯一一处把“从一台电脑到全世界能访问”这条路走完整的地方。
整条链路是这样的:在 Sealos 的 DevBox 上建一个 Vue 项目(1 核 CPU、2G 内存,勾上“开启公网访问”,平台自动给一个测试域名);本地 Cursor 装两个扩展(Devbox 和 Remote - SSH),从云端把那台机器连到本地窗口里;此后本地改代码云端实时同步;在终端敲 npm run dev 起服务;回平台确认访问地址,浏览器能打开就算通了。
发版那一步有个坑,作者写出来了:项目自带的启动脚本 entrypoint.sh 里写的是 npm run start,但 Vue 项目只有 dev 这个脚本,得手动把 start 改成 dev 再保存,否则上线之后打不开。这种细节是只有真做过的人才会写的——它不属于任何官方文档的“标准流程”,属于踩过一次才知道的地方。
然后填版本号、点发版、点上线、选 CPU 和内存、部署,最后拿到一个公网地址。收尾那节叫“及时释放资源,降低成本”,教你把应用删掉,因为云服务按资源计费,停用不删除照样收钱。
这一章还有一个我很欣赏的地方:它把成本说清楚了。Sealos 送 5 元试用金,“足以让你完成本章实验,这意味着你无须额外付费即可上手实践”,同时补了一句“平台提供的是收费服务,测试结束后未释放资源仍可能计费”。给读者一个免费的甜头,同时把账单的边界画出来——这个分寸,全书只有这一处做到了。
一点小遗憾:这一章的五子棋是用 Vue 重写的,跟第 4 章那个纯 HTML 的五子棋不是同一个东西,作者没有解释为什么要重做一遍。你要是顺着读下来,会有一种“前面那盘棋白下了”的感觉。
四、硬伤:第 7 章的“数据分析”,结论是先想好的
第 7 章的标题很响:“AI 智能数据分析:让图表说话”。读完我的感觉是:图表确实说话了,说的是作者事先让它说的话。
先看数据。7.1.1 给了一张 2024 年空调月度销售额表,从 1 月的 8200 万一路到 11 月的 42800 万;7.2 给了三年净利润 8.5 / 10.2 / 12.8 亿,行业平均 7.2 / 8.5 / 9.8 亿,竞品 A 是 9.1 / 11.3 / 13.5 亿。这些数字漂亮得有点过分——每条曲线都平滑上升,每个对比都恰到好处,一年不多一年不少,一个出处都没有。作为教学样例,编数据完全合理,但书里没有一句话说明“以下数据为示例,非真实经营数据”。
更要紧的是提示词本身。7.1.1 那份提示词里,作者是这样写的:
2 月低谷:红色警戒波纹(标注“春节战略收缩”)。6 月突破:金色爆发光效(标注“618 首战告捷”)。11 月峰值:立体爆炸图标(标注“双十一 4.28 亿”)。
看到这儿就明白了:不是让 AI 从数据里看出 2 月是低谷、6 月有突破、11 月是峰值,而是先告诉它“2 月是低谷,画个红色波纹,写上春节战略收缩”。结论是作者给的,AI 负责把它画出来,再顺手加点粒子流和爆炸图标。这一章里 AI 的角色不是分析师,是美工。
技术上讲,这一章教的东西是对的、也有用:怎么把数据表写进提示词、数据量大的时候怎么用 @ 引一个 CSV 文件、怎么用 pt 控制字号、怎么用十六进制色值锁死配色、怎么要求先出草稿再渲染成品。这些手法我照着试过,确实能出图,也确实好看。
但牌子和货不对。“数据分析”这四个字的意思是:数据在前,结论在后,结论要能被数据推翻。这一章做的是反过来的事——结论在前,让图去配它。这两件事长得像,用处完全不同:前者能帮你发现问题,后者只能帮你把已经想好的话说得更有说服力。书里没提这个区别,读者照抄一遍,学到的就是“先想好结论再让 AI 画”。这个习惯一旦养成,比不会做图危险得多。
五、硬伤:第 3 章承诺避坑,只有一页半
第 3 章的标题叫“开发新思维:与 AI 协作的正确方式”,开篇第一句就把话说满了:
这一章没有空洞的理论,只有可复用的行动指南。读完本章,你不仅会在 AI 编程的道路上少走很多弯路,更会对自己的学习充满自信。
然后这一章只有一节。内容是四步:第一步开启对话,第二步等 Cursor 给出方案,第三步“像批改作业那样告诉它哪里需要改进”,第四步“重复第一步到第三步”。
就这些。10 章 450 页的篇幅里,这一章正文不到两页,是全书最短的一章,而它恰恰是唯一一章讲“方法”的。
对比一下第 9 章。光“微信小程序注册及备案”这一个流程,作者写了二十多页:先去网易注册一个邮箱(截图四步),再去公众平台注册账号(截图十步),然后填主体信息、扫码验证、选服务类目、填备案信息、人脸识别、下载打印承诺书拍照上传、等审核,最后还有一节讲微信认证(可选的,要付费)。
一本书愿意花二十多页教你去 mp.weixin.qq.com 点按钮,却只花两页讲“怎么跟 AI 协作”——这个取舍本身就把作者的重心暴露了:他更相信步骤,不太相信方法。步骤是确定的、可截图的、不会错的;方法是模糊的、要悟的、可能被质疑的。写前者安全,写后者难。
我不否认那些备案步骤有用,很多人就是卡在那儿。但当一本书的目录向你承诺“正确方式”,翻开来只给你四步、其中两步还是重复,这个落差比任何技术错误都更伤读者的信任。
六、真正的规律,藏在提示词的长度里
这本书没总结出来、但我认为最值钱的一条规律,是把各章提示词的长度排在一起看。
第 4 章,让孩子给游戏加三把泡泡枪,提示词是六个字加一个句号:“我希望游戏中同时出现 3 把泡泡枪。”不到一分钟出结果。
第 6 章,做一张餐厅菜单,提示词八百多字:尺寸 600×900 像素,背景 #f9f9f5,主题色 #4D7942,两个并排的圆形餐盘每个直径 220 像素,左边放烤地瓜右边放大薯条,主食系列和小吃系列各有一个绿色标题栏,菜品名称和价格之间用点线连接,字体统一用微软雅黑或思源黑体……
第 7 章,一张折线图,提示词里连“X 轴中文标签倾斜 30 度防重叠”“Y 轴范围 0 到 50000、间隔 5000”“双轴特效:添加动态粒子流沿折线移动”都写进去了。
差了三十倍。这个差别不是作者心情好坏,是任务性质不同:**能用“有没有”验收的,一句话就够;只能用“像不像”验收的,必须把参数写死。**
泡泡枪那个需求,验收标准是二值的——屏幕上有没有三把枪?有就是成了,没有就是没成,AI 自己也能判断。而一张菜单好不好看,是连续判断,没有客观边界:你说“好看一点”,它每一次给你的“好看”都不一样,改十轮也收敛不了。唯一能让它稳定的办法,是把你的审美拆成它能执行的参数——色值、像素、字号、圆角、间距。参数一给,就变成了“有没有”的问题:色值对不对?224 像素对不对?
这条规律,书里各章都在示范,但作者从头到尾没点破。他只是在第 4 章说“就这么简单”,在第 6 章甩出八百字,然后各自往下走。读者如果自己没看出来,会得出一个错的结论:设计类的活儿比游戏难。其实不是难,是验收标准不同——游戏是“跑不跑得动”,设计是“像不像那个东西”。
4.6 节其实摸到了这条规律的边。那一节的标题叫“为什么不讲提示词工程”,作者把全书用的方法收成了一个三段式:
“你是一位资深的游戏开发者”(角色),“请采用纯前端技术开发一款泡泡枪游戏”(任务),“目前的要求很简单,只需要实现只要一按开关泡泡枪就可以发出好多泡泡这个效果即可,不用添加其他的效果”(验收标准)。
这三段里,真正起作用的其实是第三段——那句“不用添加其他的效果”。它把 AI 的发挥空间锁死了,所以出来的东西一次就对。可惜作者只用这一句话解释了三段式,没有把它推到底:当验收标准本身说不清的时候(比如“好看”),锁空间的工具就不是一句话,而是几百个参数。这一步没走完,第 4 章和第 6 章的差距就成了一个谜。
七、66.7% 是怎么来的
微信读书给这本书的推荐值是 66.7%。我上一篇读的那本同类书是 83.1%,差 16 个百分点。这个差距不是偶然的,我在读的过程中至少记下三件事。
第一件,整页重复太多。我数了十几处:第 7 章开头那段“当我们将空调销售的数字绘成一条灵动的曲线”连着重了两页;第 8 章“Sealos 提供统一开发环境”那段重了两页;第 10 章“2025 年 4 月,腾讯云升级其大模型知识引擎”那段重了两页;书末“全书完”附近连着三页几乎是同一屏。我没法断定这是排版贴重还是电子版的渲染问题——理论上两种都可能。但读者体验是确定的:同一段话,你读了两遍。
第二件,截图压过了文字。第 9 章那二十多页备案流程,基本是“第一步点这里(图 9-36)”“第二步填这里(图 9-37)”。这种内容在纸质书上还能当操作手册摊在键盘边上翻,在电子书里就成了一串看不清的深色截图,翻十页学不到一个概念。
第三件,每节的开头太像。“以下是我们给 Cursor 发送的信息(提示词)”——这句话在第 6、7、9 章里出现了几十次,读到后面我已经能背下来了。结构统一本来是优点,统一到这种程度就变成了疲劳:你知道接下来会看到一段提示词、一张截图、一句“效果如图 X-X 所示”,信息量越来越低。
不过也得说句公道话:66.7% 里有一部分是预期错位,不全是书的问题。书名是“零基础开发智能体应用”,很多人冲着“智能体”三个字买的,结果前九章都在做小游戏、菜单、海报和小程序,MCP 和智能体要到第 10 章才登场——而且一登场就是 Spring Boot、Maven、IntelliJ IDEA。作者自己在 10.6 节开头就写了:“本节将指导开发者完成 MCP 生态的深度整合,要求开发者具备 SpringBoot+Maven+IntelliJ IDEA 开发基础。”
也就是说,一本叫“零基础”的书,最后一章要求你会 Java 后端。这个断裂读者是能感觉到的,只是说不出具体在哪一页断的——大概就在第 10 章那个 pom.xml 出现的时候。
八、那这本书该怎么读
三处细读。5.2 节,看一次真实的失败是怎么被救回来的,这一节的含金量超过前面四章的总和。第 8 章,看一条从本地到公网的完整链路,顺便记住“停用不删除照样计费”这句。10.1 到 10.3,把 MCP 是什么、Host/Client/Server 三件套、mcp.json 两种接法搞清楚——这段是全书最不会过时的部分,因为配置格式到现在还是这两套。
两处当素材库。第 6 章和第 7 章的提示词可以直接抄:做海报、做菜单、做名片、做折线图和雷达图,把里面的店名、菜品、数据换成自己的就能用。第 7 章那几个图表的提示词写得尤其细,色值、字号、坐标轴、输出尺寸全都齐了,这是它的真正价值——但记住,抄提示词可以,别抄它的思路,那是先有结论再画图的思路。
一处快翻一处跳过。第 2 章(装软件)和第 9.4 节(小程序备案)当工具书,需要的时候回来查,不用顺着读。第 3 章可以直接跳过,它想说的东西,1.2.2 那一小节已经说完了——结构化沟通:先说“场景+角色+痛点”,再定技术限制,最后明确不能干什么。
一个提醒。Cursor 迭代极快,书里的界面、额度、价格都已经不是现在的样子了,照着点很可能找不到按钮。真正稳的东西只有两类:一是提示词怎么写(这部分不变),二是协议和配置(MCP 的 SSE 和 npx 两种接法、Spring AI 的 @Tool 注解,这部分半年内不会变)。把注意力放在后两类上,这本书的折损率会低很多。
适合谁:完全没写过代码、想亲眼看看“AI 到底能把我带到哪一步”的人;需要给客户做一个小页面、还得让它能被访问到的人;想搞明白 MCP 到底是什么、怎么在 Cursor 里配起来的人——这三类人,第 8 章和第 10 章能把你喂饱。
不适合谁:想学软件工程的人,这本书里没有测试、没有版本控制、没有错误处理、没有性能;想认真做数据分析的人,第 7 章会把你带偏;以及所有被“零基础”吸引、读到第 10 章才发现要会 Java 的人。
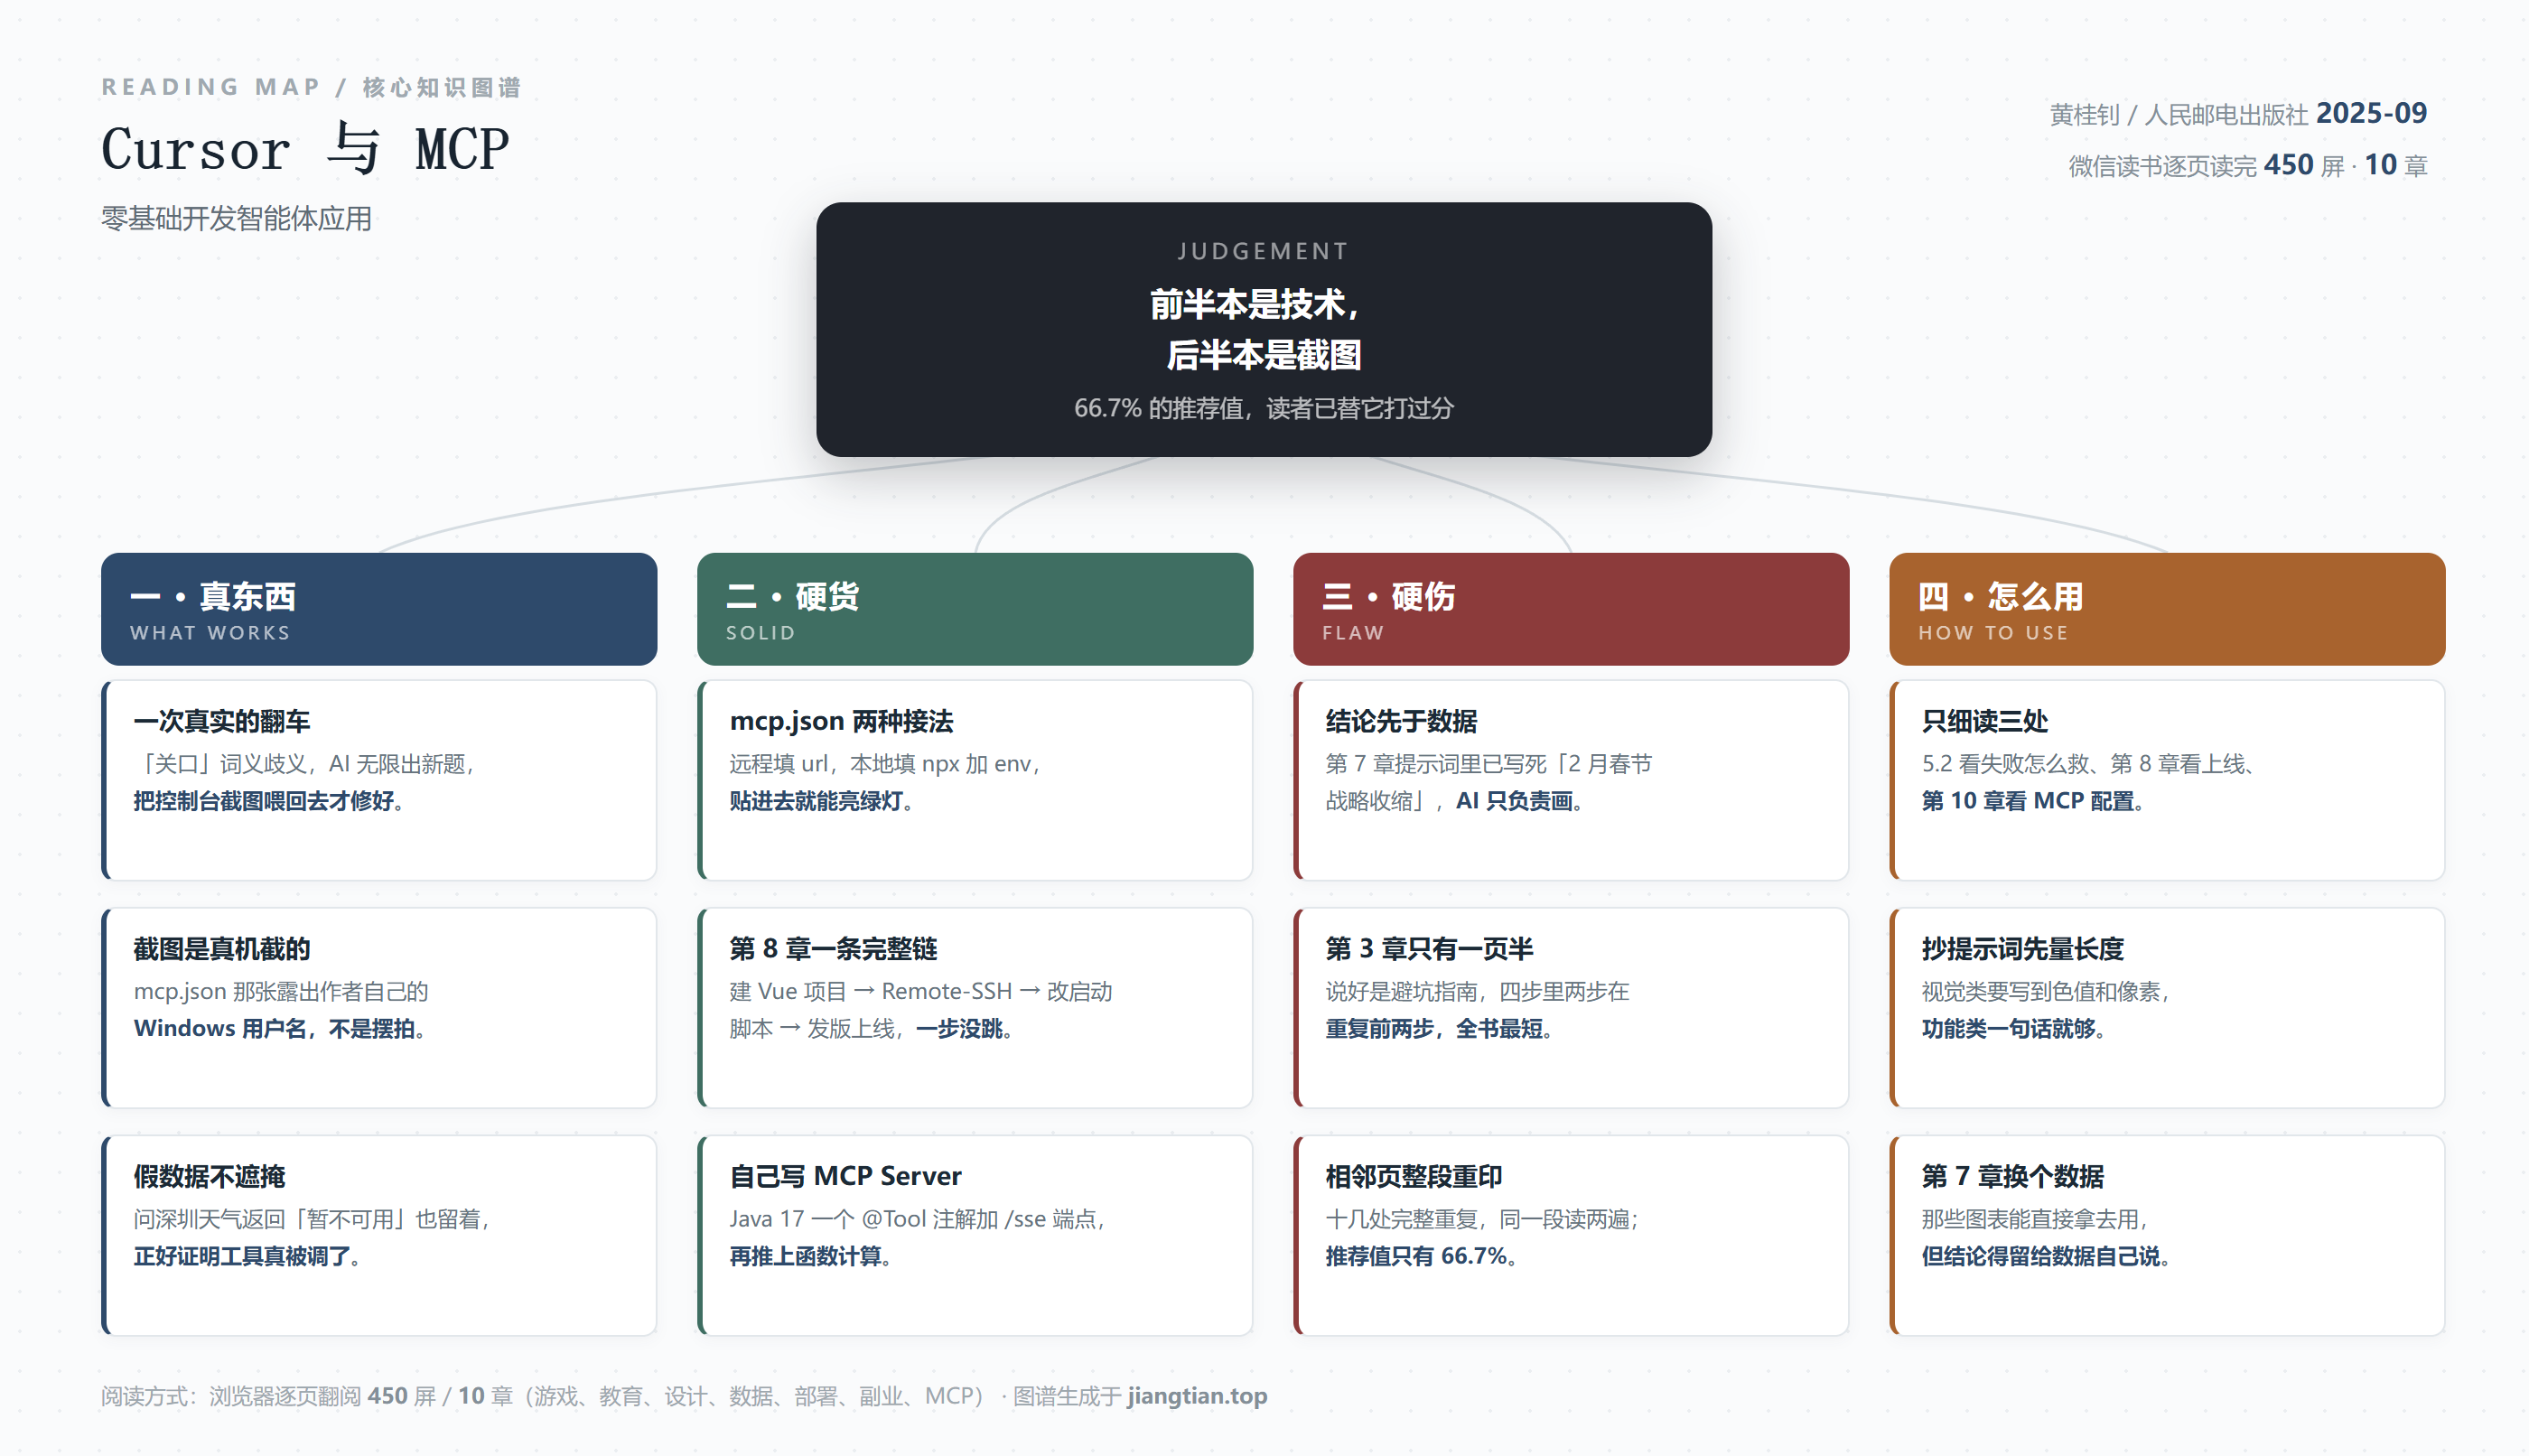
最后说一句我自己的判断。这本书最像“真书”的地方,是 5.2 节那句“问题是我们和 Cursor 对‘关口’这个词的理解不一样”——这句话不是从别人的教程里抄来的,是从一次调试里长出来的,它有一个普通教程给不了的东西:它承认了人和机器会互相误解,而且误解的根源在人这边,不在机器那边。最不像“真书”的地方,是第 7 章那份连结论都写进提示词的数据分析——它把 AI 当成了一个很听话的绘图员,然后管这叫“让图表说话”。
它确实能让你在一天之内做出一个能上线的小东西,只是这本书把“做出来”和“做好”之间的那段路,用截图填满了。
阅读记录 · 黄桂钊《Cursor与MCP快速入门:零基础开发智能体应用》,人民邮电出版社,2025 年 9 月第 1 版,ISBN 9787115676030。全书 10 章,我在微信读书网页版逐屏翻阅 450 屏,从版权页读至末页“全书完”,书末显示推荐值 66.7%。文中引文、提示词、版本号与配置片段均照录原书,作者截图中的 Windows 用户路径与个人邮箱已隐去。因原书为图片版,OCR 存在个别字符误差(例如把“替代”认成“蔡代”、把“千问”认成“干问”),凡引用处均已对照上下文校正,未改写原意。第七节所述整页重复,我读到的是电子版,无法完全排除阅读器渲染因素,故仅陈述“同一段读了两遍”这一阅读事实,未据此推断责任在哪一方。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: