
AI绘画实战技巧保姆级教程:说好的案例,全书一张图都没给
一、先说清楚它是个什么东西
把体量摊开来看,很多判断就不需要争论了。八章,每章两到五页,全书两万字出头。第一章讲 AI 绘画是什么、会不会取代画家;第二章讲市面上有哪些工具;第三章讲怎么写提示词;第四章又讲怎么写提示词;第五章讲出图出问题时怎么修;第六章讲生成完怎么用 Photoshop 和 Procreate 二次加工;第七章讲版权和伦理;第八章讲未来会怎样。
这个目录结构本身没问题,问题在于每一章的实际密度。第一章五页里,讲“AI 怎么学会画画”用了两段纯比喻——“就像教小朋友画画一样,我们需要先让 AI‘看’足够多的优秀作品”“想象一下,AI 的大脑里有一个巨大的调色盘和无数支虚拟画笔”。这些话不假,但它们是给完全没接触过 AI 的人做科普用的,放进一本自称“保姆级教程”的书里,占了全书近七分之一的篇幅,就有点奢侈了。
更值得注意的是它的出版形态。版权页上写的是“品牌方:北京明天远航文化传播有限公司”“本书由北京明天远航文化传播有限公司授权微信读书进行制作与发行”,没有出版社、没有 ISBN、没有责任编辑、没有版次印次。这不是挑刺,这解释了一件事:它没有经过传统出版流程里那道“三审三校”,也没有一个编辑会拍着桌子问作者“你前言说所有案例都反复测试过,案例呢?”
所以我在读它的时候,调整了期待。它不是那种“一章一个项目、跟着做能出图”的教程,它是一份经验总结。按经验总结的标准衡量,它有货;按“保姆级教程”这四个字衡量,它欠得很多。这个差别,就是下面所有的分歧的来源。
二、开场那句承诺,全书没有兑现
前言里有一段话,我原样抄下来:
“特别要说明的是,书中所有案例都经过精心挑选和反复测试,确保读者能够复现效果。”
读完这句再往下翻,你会一直在等那些“案例”。等到第八章结束,一个都没有。全书出现的“案例”,全部是假设句——“比如输入‘一只戴着眼镜的猫’,AI 就会开始它的魔法表演”“比如你说‘画一个穿着毛衣的鳄鱼在咖啡馆用笔记本电脑’,它会忠实地呈现每个细节”。
这些句子的问题不在于它不生动,而在于它是不可验证的。读者永远不知道那只戴眼镜的猫最后被生成成了什么样:眼镜是不是真的跑到耳朵上了?半透明的幽灵状态到底是什么效果?作者说“第一次生成的结果可能出乎意料——也许猫的眼镜会出现在耳朵上”,用了“也许”。一个真的反复测试过的人,不会用“也许”。
我说得再直白一点:一本讲 AI 绘画的书,最重要的一张图就是你输入这段提示词、它生成出来长什么样。这个“输入—输出”的对照,是这类书存在的全部理由。没有它,读者拿到的是一堆正确但空转的建议,比如“要具体”“要有光影”“要注意构图”——每一句都对,每一句都没法用。
这不是排版失误,是取舍。全书没有任何插图,一张都没有。一本 2025 年出版、讲视觉生成的书,选择了纯文字。你很难说这是无意为之,因为一旦插入图片,那些“也许”“就像”“想象一下”的段落,立刻会被自己的配图打脸。
还有一层更隐蔽的代价。没有图,这本书就没法被“验证”,只能被“认同”。你读它的时候一直在点头——对,要具体,对,要写光影,对,要注意构图——但你合上书之后,手上什么也没多出来。真正的教程会留给你一串可以照着敲的东西:这几行提示词、这个参数、这张前后对比图、这次失败的原因。它一样都没留。所以它的阅读体验格外顺滑,顺滑到有点可疑:一本让你全程点头的书,通常什么都没教会你。
三、第 5 章:一份能用的故障清单
说完坏话,说好的。第 5 章是全书唯一让我做了笔记的地方,因为它提供了一份可以被使用的清单,而不是可以被欣赏的散文。
它列了十二类常见问题,每一类给一个“往提示词里加什么”的方向。我按自己的理解重新组织一下:
一是人体崩坏。六根手指、扭曲的四肢。它的解法是往提示词里加“解剖学正确的人体结构”“自然比例的手指”,手部单独描述——“五指分明的手掌,清晰的指关节和指甲”。这个思路是对的:不要指望模型自己知道手有几根指头,要把它当成分部件来写。
二是面部畸变。它给了一条我觉得很实用的建议:与其要完全的正侧面,不如要“四分之三侧脸”。理由是正侧面只有一只眼睛、一条鼻梁线,模型没有足够的信息来判断对称性,所以容易画歪;四分之三侧脸保留了双眼和鼻梁的完整结构,稳定性高得多。这条是真经验,不是从别处抄来的常识。
三是细节模糊。它的解法是分级描述:“前景的树叶要看到清晰叶脉,中景的建筑展现砖墙纹理,远景保持适当虚化”。把景深写进提示词,等于告诉模型哪里该花算力。
四是元素融合。人和椅子长在一起、树穿过墙。解法是“清晰的物体轮廓”“独立的实体存在感”,再不行就分步生成——先生成背景,再单独加前景。
五是风格偏差。要水墨得到水彩,要赛博朋克得到蒸汽朋克。它的解法是别用笼统的风格名,改用具体的技法名——“北宋院体花鸟的工笔技法”比“中国画”准,“1980 年代经典赛博朋克的霓虹美学”比“赛博朋克”准。这一条我认为是全书最有价值的一句方法论。
后面还有色彩失控、构图失衡、同质化(每棵树长得一样)、材质误解(丝绸像塑料)、透视混乱、主题偏离、分辨率不足。同质化那条给的解法是“每棵树都有独特形态”,或者把场景分区描述,逼模型做差异化处理。材质误解那条给的是“重磅真丝的垂坠感和柔和光泽”“风化铜器的氧化锈迹与抛光对比”——不写材质名,写材质的视觉特征。
这份清单的价值在于它可以当排查表用。你出了一张不满意的图,从这十二类里找到对应的一条,按它给的方向改词,一次改一个变量。这比“多试几次”有用得多。
但它也暴露了这本书的方法论上限:所有的解法都归结为“往提示词里加形容词”。没有一条讲到换模型、调采样器、改 CFG、上 ControlNet、用局部重绘蒙版。全书唯一提到参数的地方是“在 Stable Diffusion 中提高 cfg_scale 值增强提示词服从度”,一句话,连 cfg 高了会画面发焦、色彩过饱和这个副作用都没说。也就是说,它教的是“怎么说话”,没教“怎么调机器”。对 Midjourney 这类纯提示词工具够用,对 Stable Diffusion 这类要调参的工具,远远不够。
四、第 6 章:全书唯一动过手的地方
如果说第 5 章是“知道哪里会错”,第 6 章就是“错了之后怎么救”。这一章是我判断“作者真的画过画”的唯一依据,因为里面全是后期流程里的行话,而且用得都对。
它给的流程是这样的:拿到一张 AI 图,先别急着改,导入 Photoshop 新建几个调整图层,用红色标构图问题、蓝色标需要重绘的部分、绿色标可以保留的优秀元素。这一步叫“先诊断再动手”,很多新手是反过来的——上来就调色,调完发现构图本来就是歪的。
然后是构图调整。Procreate 里用变形工具挪元素,挪出来的空白用克隆图章补;更聪明的做法是先用低透明度笔刷画出理想构图框架,再按框架调整 AI 生成的内容。这个顺序很重要:不是让内容决定构图,是让构图约束内容。
色彩重塑那段给的是梯度映射统一色调、色彩平衡分别调高光/中间调/阴影、局部用快速选择加色相-饱和度、新建蒙版保护不想动的地方。这些是标准的修图流程,写得不深,但没有错。
细节精修那段有一个数字我记得很清楚:“建议放大到 300% 以上进行精细刻画,这样在正常观看时会有惊人的真实感。”这是长期修图的人才会有的直觉——细节不是给眼睛看的,是给“整体感觉”服务的,你在 300% 下画的东西,缩回 100% 时变成了质感。
氛围强化那段更具体:加深减淡工具拉明暗对比,柔光图层加光效,新建盖印图层用低流量笔刷沿光线方向画光晕,再高斯模糊做出辉光。阴天场景加一个蓝色调的色彩查找图层,再降饱和度。这几步是可以直接照做的操作序列,不是形容词。
后面还有几条是我认为整本书最“手艺人”的部分:
一是画面统一性。AI 拼出来的不同元素像来自不同世界,解法是给所有元素加上同等程度的环境光遮蔽,再在最顶上新建一个调整图层轻微着色、降低不透明度。这一招是合成师的基本功,用在这里非常对症。
二是签名。它说别打文字水印,把签名融进画面——建筑上的刻痕、衣物上的花纹。这既是著作权保护,又不破坏画面。
三是心理距离。改完放一段时间再看;把画面左右翻转,构图失衡立刻暴露;缩到缩略图大小看整体还成不成立;有条件打印出来看,因为屏幕和印刷差得远。这三招不是 AI 时代的新知识,是绘画课上的老办法,但用在这里恰好补上了 AI 创作者最缺的一环——判断力。
四是输出规范。网络展示转 sRGB 加锐化,印刷转 CMYK 并考虑油墨覆盖率,做成动作预设一键跑,永远保留含图层的原始文件,只导出副本。
这一章我给了很高的评价,但也要说清楚它的边界:它讲的全是“修”,没讲“造”。整章没有一个字讨论“这张图该不该这么构图”“这个颜色对不对”,它默认你已经有了审美判断,只缺操作步骤。而这恰恰是 AI 绘画新手最缺的东西——不是不知道怎么拉曲线,是不知道往哪拉。
五、第 3 章和第 4 章,是同一套话讲了两遍
这是全书结构上最明显的问题。第三章叫“与 AI 对话的艺术”(讲提示词基础),第四章叫“掌握 AI 绘画的艺术语言”(讲提示词进阶)。两章加起来将近十页,实际讲的是同一件事:把一句话拆成几层,一层一层往上加。
第三章管这个叫“渐进式描述”,举的例子是:
“一个女孩”→“一个扎着马尾辫的亚洲女孩”→“一个扎着马尾辫的亚洲女孩在图书馆看书”→“一个扎着马尾辫的亚洲女孩在古老的图书馆看书,阳光从彩色玻璃窗照进来”
第四章管这个叫“构建有效提示词的黄金法则”,举的例子是“一个穿着复古连衣裙的少女”比“一个人”明确得多,然后拆成主体、环境、风格、材质、光影、构图六件套。
同一条方法,两个名字,两套例子,中间没有任何递进。真正的进阶内容——权重语法、负面提示、分层细化——被塞在第四章末尾,每样两句话。而权重语法那两句话是有问题的,下面单独说。
我认为这不是作者偷懒,是这本书的原始形态决定的。两万字拆八章,每章两千多字,写不出真正的递进关系,只能把同一个点换一种说法再说一遍,好让每章看起来都有自己的主题。读者读第三章觉得“有道理”,读第四章觉得“又说了一遍”,这不是读者的错觉。
更能说明问题的是两章的收尾方式:第三章末尾讲“耐心与实验精神”,第四章末尾讲“培养个人艺术声音”,听起来是两个话题,落到纸面上是同一句劝告——你要多练、要多记、要形成自己的语汇。这类话放在任何一本讲创作的书里都不算错,但它不构成“章”,它只构成“一句结尾”。当一本书用八次结尾的容量去承载三章的内容时,重复就不是偶然,是结构撑不住。
六、六件套讲对了,参数却含糊
抛开重复不谈,第四章那套“六件套”本身是对的,而且比大多数同类书讲得清楚:主体(画什么)、环境(时间地点季节天气)、风格(流派或技法)、材质(视觉特征而非名词)、光影(类型、强度、方向)、构图(视角、景别、焦点)。它甚至给出了一个我认为很好的判断标准——
“用‘后印象派风格,强调笔触质感和鲜艳色彩’就比简单的‘梵高风格’更准确。”
这句话背后的道理是:模型不认识“梵高”这个名字背后的全部约定,但它认识“笔触质感”“鲜艳色彩”这些可被视觉化的描述。名字是给人用的,描述是给模型用的。理解了这一层,写提示词的思路就通了。
但一到需要精确的地方,这本书就开始含糊。它说:
“大多数 AI 工具使用‘(元素: 权重数值)’的语法,比如‘(水晶城堡: 1.5)’表示强调城堡的水晶质感。”
这句话是错的,而且错得会让人白折腾。Midjourney 根本不用这个语法,它用双冒号加数字(主体::2),括号在 Midjourney 里几乎不起作用;DALL·E 3 走的是自然语言,压根没有权重语法;只有 Stable Diffusion 系(Automatic1111、ComfyUI)才是圆括号加冒号加数字。三家的写法互不通用,书里一句“大多数 AI 工具”带过,一个刚上手的人照着写,在 Midjourney 里必然没反应,然后他会怀疑自己写错了提示词——其实是他信错了书。
参数部分更薄。全书只提到两个:用“--ar 16:9”指定宽屏比例,用“--chaos 50”调整 AI 的自由度。这两个都是 Midjourney 的参数,书里没说,也没解释 chaos 高了会怎样、stylize 是干什么的、--no 怎么排除元素、--seed 为什么重要。至于 Stable Diffusion 的采样器、步数、CFG、LoRA、ControlNet,一个字没有。
这就是“保姆级”三个字最尴尬的地方。真正的保姆会告诉你:这个动作在这个软件里是这个键,在另一个软件里不是。而这本书在唯一需要精确的地方,选择了模糊。
它倒是有两句经验之谈,我认为是真的:一是“建立你的提示词库”,记下哪些说法有效——“哑光质感”比“不反光”更能让模型理解;二是“有时候用非母语描述反而能获得更好效果,比如用意大利语描述文艺复兴风格”。第二句有点意思,背后是训练数据里语料配比的问题,英文和欧洲语言的标注密度更高。作者没有解释原因,但这句话本身是从实践中长出来的。
七、版权一章,绕开了所有具体的东西
第七章讲法律和伦理,态度是诚恳的:“AI 只是工具,重要的是你怎么使用它”“如果这个图是人画的可能会侵权,那么 AI 生成的同样可能有问题”。后面这句我给满分,它是普通人判断风险最省事的准绳。
但作为一本 2025 年 5 月出版的书,这一章的信息量低到不正常。它说:
“目前法律对于 AI 生成作品的版权归属还没有完全明确的规定……不同国家有不同的看法,有些地方认为完全由 AI 生成的作品没有版权,有些地方则认为可以有一定程度的保护。”
“有些地方”是哪里?哪一个法条?哪一个判例?作者一个都没给。而这件事在 2025 年根本不是“说不清”的状态:美国版权局早在 2023 年 3 月就发布了登记指南,明确纯 AI 生成的内容不受版权保护,人类实质性贡献的部分可以受保护;同年“Zarya of the Dawn”那件漫画的登记被部分撤销,理由就是图像由 Midjourney 生成、缺乏人类作者身份;2025 年 1 月又出了第二部分报告,专门讨论“创造性投入”的边界。这些是可查的、公开的、直接影响商业使用的材料,书里一句都没有。
结果是这一章变成了一串“要小心”“要注意”“最好别”的提醒。它告诉你有风险,不告诉你在哪儿、有多大、怎么躲。对一本要卖给人用的书来说,这等于把最硬的那部分工作留给了读者。
唯一有价值的一条是合同建议:接单的设计师应该在合同里写明是否允许使用 AI 辅助、生成内容占多大比例、版权怎么算,甚至可以反过来禁止客户拿自己交付的作品去训练模型。这条是真懂行的人才会想到的,可惜只有一句。
八、它的短板
把话说到底,这本书的短板是四个,而且互相咬合。
第一,也是最硬的:它承诺了案例,一个都没给。一本讲图像生成的书,全书零插图。所有“案例”都是“比如”“也许”“想象一下”。这让它从“教程”降级为“随笔”。读者买不到可复现的东西,只能买到可点头的观点。
第二,工具章节是过期的名录。第二章介绍 Midjourney、Stable Diffusion、DALL·E、Adobe Firefly、Leonardo.AI、Wombo Dream,这是 2022 到 2023 年的名单。2025 年 5 月出书,即梦、可灵、豆包、通义万相这些国内主流的名字一个没提,只写了一句“国内也有一些优秀的中文 AI 绘画平台,更适合不熟悉英语的用户起步”——既然知道,为什么不点名?更矛盾的是,作者自己在同一章里写“上个月还做不到的功能,这个月可能就更新了”,明知会过期,还是按静态名录写完了整章。
第三,结构上是两万字撑八章。第三章和第四章讲同一件事;第一章和第八章基本是同一类散文,一个讲“AI 来了”,一个讲“AI 要去哪”。真正有信息密度的内容集中在两章,占比不到三分之一。
第四,也是最容易被忽略的:它没有审美。这本书教的全是“怎么让模型听懂”,没有一句在教“什么样的图是好图”。它讲构图法则,但只是让你把“三分法构图”写进提示词;它讲光影,但只是让你把“丁达尔效应”写进提示词。至于一张照片为什么要用侧光、一幅插画为什么留白、什么叫做“过曝得刚好”,全书不碰。而 AI 绘画这件事,技术门槛正在以月为单位下降,审美门槛一动不动。这本书补的是正在消失的那一半。
那它该怎么用?我的建议很具体:只读第 5 章和第 6 章,其余六章整段跳过。第 5 章当故障排查表,出图不对就按十二类逐条对;第 6 章当后期流程单,从诊断、构图、色彩、精修、统一、输出,照着走一遍,你会得到一套属于自己的工作流。至于工具选择、提示词语法、版权边界、未来趋势,去官方文档、去平台自己的帮助页、去看版权局的公开文件,都比这两万字可靠。
还有一条:这本书 5 分钟能读完,那你就用 5 分钟读完它,然后花 5 个小时去生成两百张图。它提供的是方向感,不是手艺。方向感值一点钱,手艺得自己练。
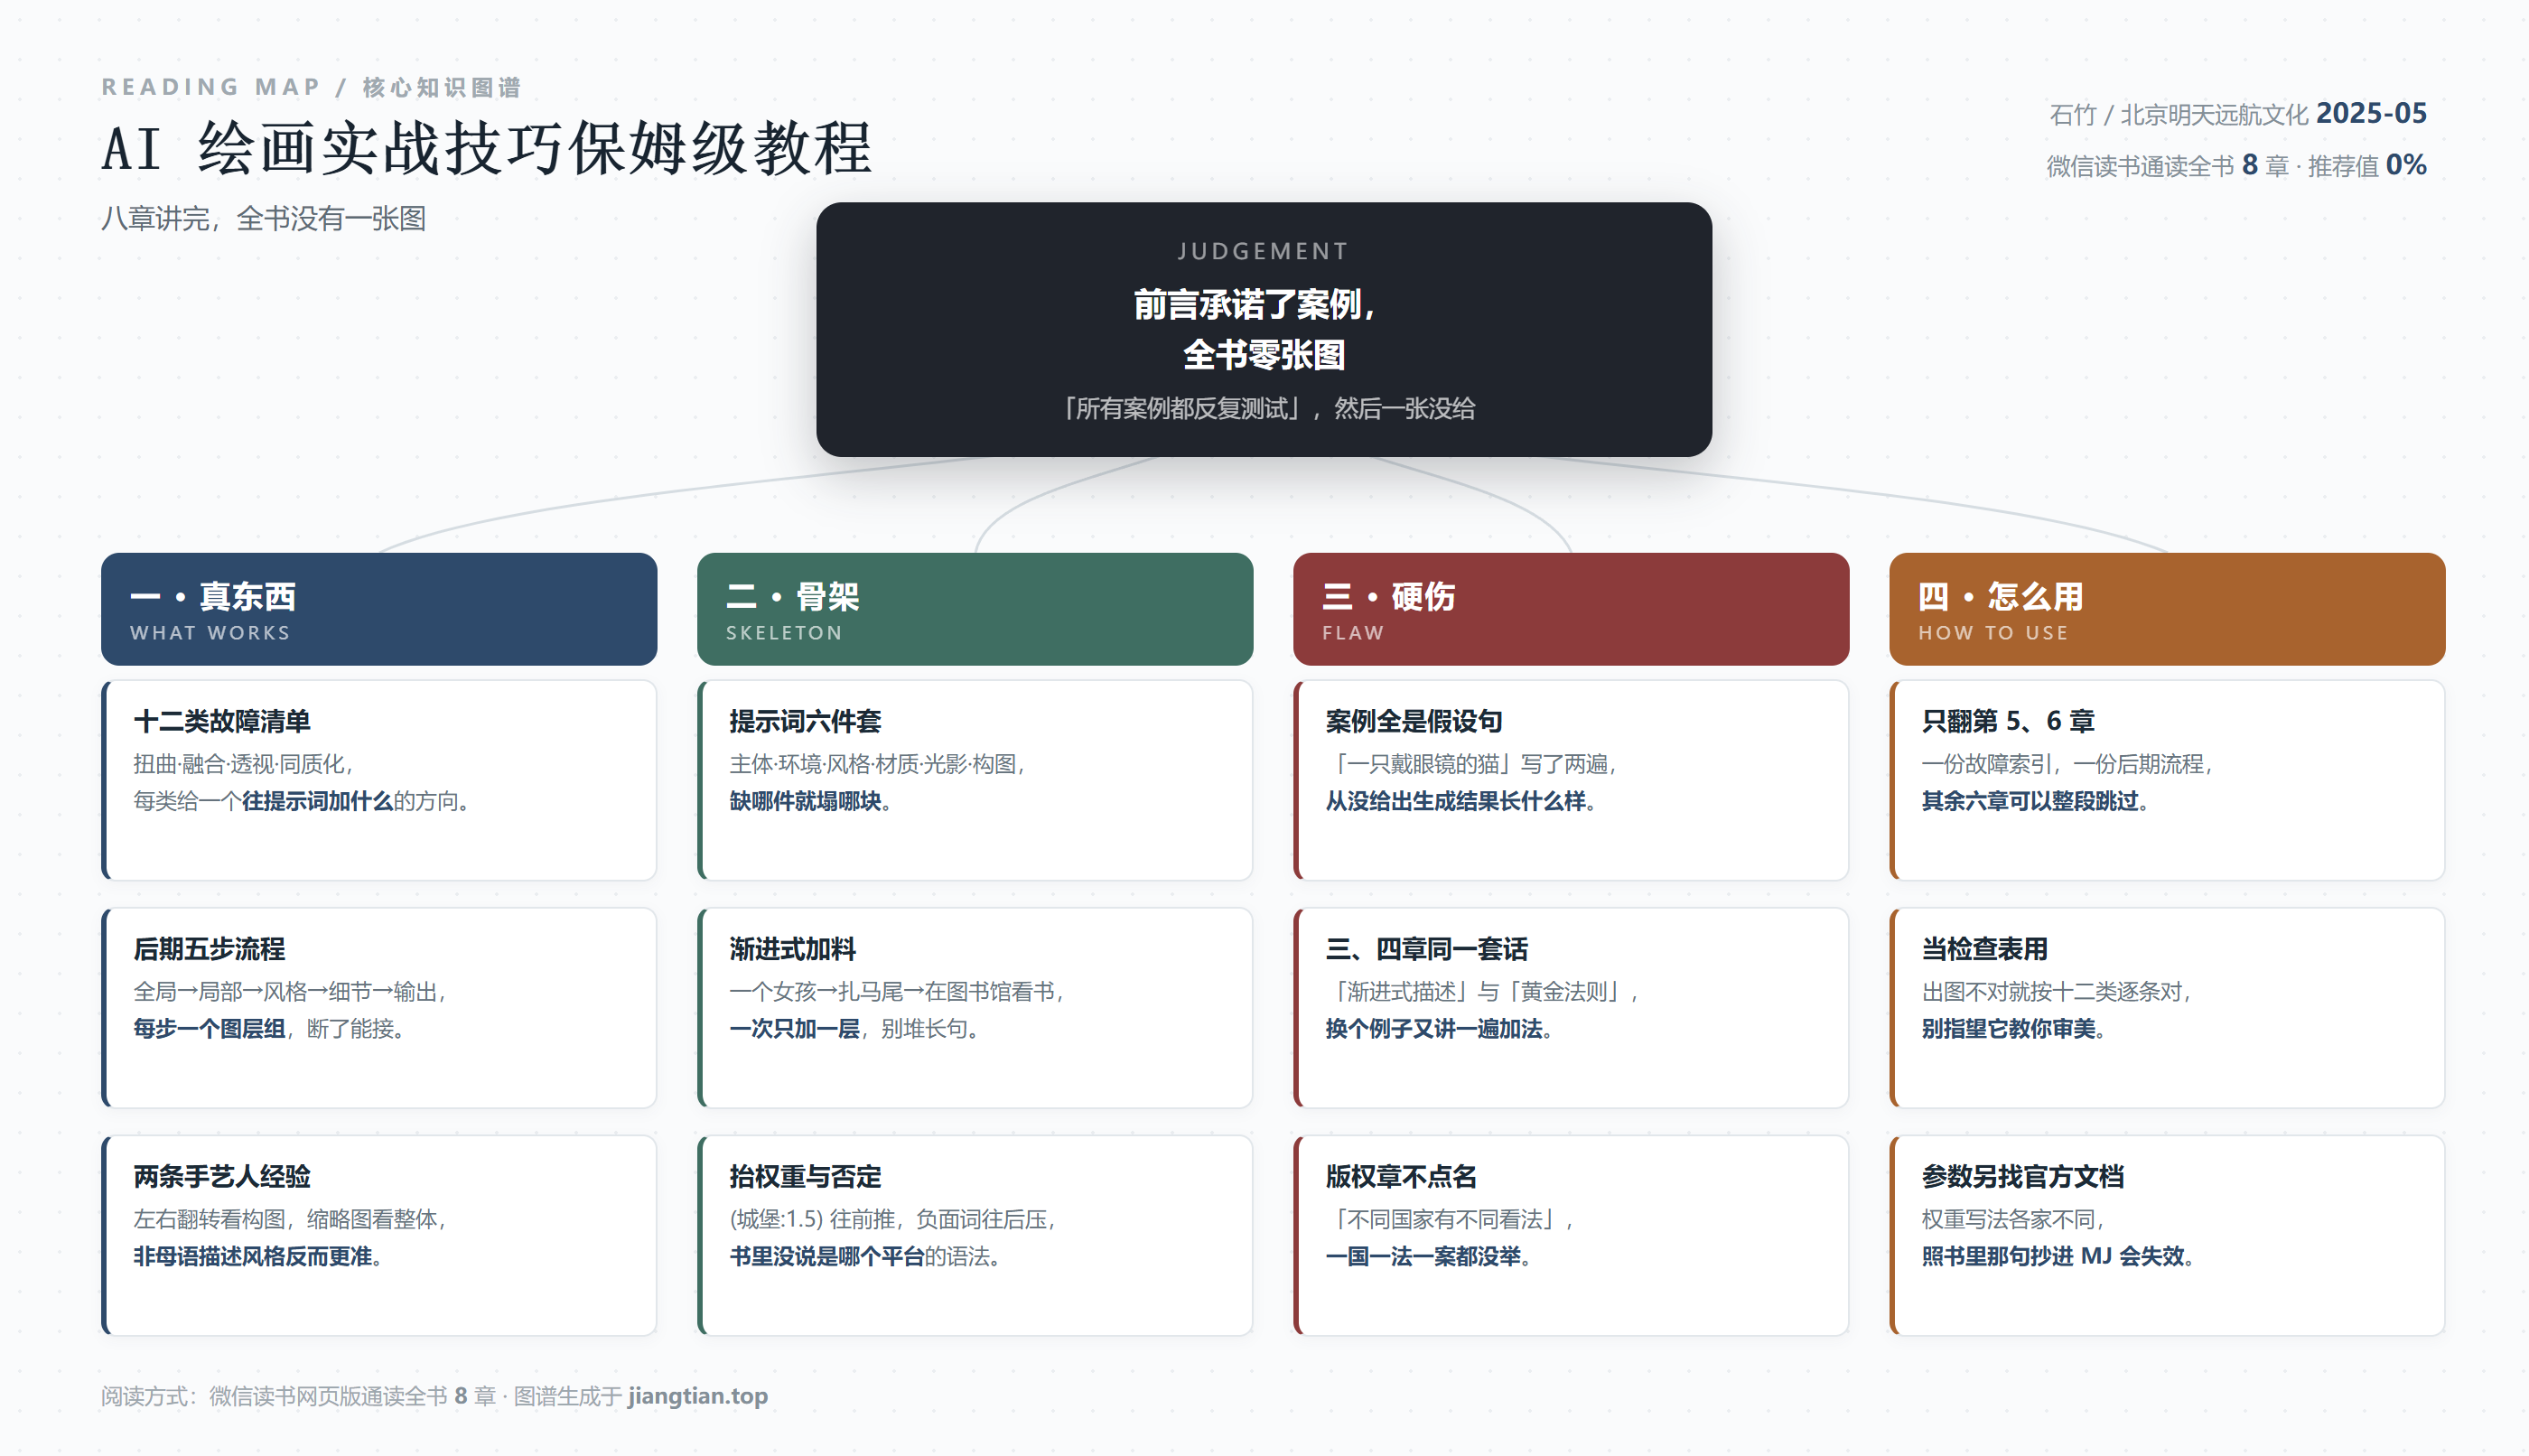
它把“保姆级”三个字写在了封面上,然后把保姆该干的活——给你看一眼成品——全省了。
阅读记录 · 石竹《AI 绘画实战技巧保姆级教程》,北京明天远航文化传播有限公司 2025 年 5 月授权微信读书制作发行(版权页无出版社、无 ISBN)。全书 8 章,我在微信读书网页版从版权页读到书末“已读完”,书末显示微信读书推荐值 0%。文中引文均照录原书,涉及 OCR 识别误差的字句已对照上下文校正,未改写原意;因原书为纯文字排版、无插图,本文所有关于“没有配图”的判断均基于全书逐页通读,不涉及图片丢失的可能。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: