
《人工智能通识课》:真正把话说破的只有十来页,但那十来页值回书价
一、它怎么搭的:一条直线,从硅片讲到提示词
五章的顺序没有任何意外。第 1 章讲 AI 是什么、怎么来的、各国怎么抢、六大关键技术(机器学习、知识图谱、自然语言处理、人机交互、计算机视觉、生物特征识别)分别是什么;第 2 章把 AI 摊到十二个行业里;第 3 章讲机器学习,监督、无监督、强化,再往前推到神经网络和深度学习;第 4 章讲大模型,从概念、分类、产品讲到原理、硬件、成本、挑战,最后落到「世界模型」;第 5 章直接上工具,教你怎么用 DeepSeek 作诗、用 Kimi 做 PPT、用即梦抠图。
这条线的好处是它真的「通」。一个完全没接触过的人,从第一页读到第三百多页,中间不需要补任何前置知识。它甚至肯花整整一节讲信息化基础设施:我国 4G 基站超 711 万个、占全球 60% 以上,5G 基站超 425 万个、用户普及率约 60%,算力总规模 280 EFLOPS,8 个国家算力枢纽节点,北斗三代全球组网,特高压输电网络规模世界第一。这些内容在很多 AI 书里是没有的,因为不够「酷」。但作者知道,没有电和网,模型跑不起来。
它也肯花一整节讲各国战略:美国靠科研实力和产业生态,欧盟把伦理问题上升到「捍卫欧洲价值观」的层面——2019 年《可信赖人工智能伦理准则》立了七项核心标准,2024 年《人工智能法案》正式实施,成了全球首个 AI 风险分级监管体系;2025 年又启动 Invest AI 计划,打算动员 2000 亿欧元建 AI 超级工厂。中国这边则是「培养专业人才」「注重应用场景」,L4 级无人驾驶巴士在雄安跑了 2.2 万公里。把这些摆在一起读,比读十篇「中美 AI 差距」的爽文有用。
坏处也在同一条线上:它太顺了,顺到没有棱角。
第 2 章是最典型的例子。十二个领域——制造、家居、物流、金融、医疗、安防、交通、零售、农业、环保、教育、娱乐——每一节都长这样:
(1)智能装备。……其核心能力是自感知、自决策、自执行、自适应。主要应用包括:①预测性维护。这是 AI 在装备上的经典应用。……②自适应加工与质量控制。……③自主机器人。……
你读完制造,能背出家居的结构;读完家居,能预测物流的小标题。这不是作者偷懒,这是教材体例的必然——它要可教、可考、可出题,就得整齐。但整齐的代价是信息密度被摊薄了。同样三百页,如果砍掉八个领域、把剩下四个写到骨头里,这本书会重得多。
二、它最值钱的三页,全在讲「坑」
这是我要重点说的部分。全书三百多页,我认为真正能让人「哦」一声的地方只有三处,全在第 5 章,而且全在讲同一件事:你以为它在做 A,其实它在做 B。
第一处,温度参数。
它没有一上来给定义,它给了一个填空题:
假设大模型必须完成句子「一只狗正在__」。下一个词元具有以下概率:玩(0.5)、睡(0.25)、吃(0.15)、驾(0.05)、飞(0.05)。
然后它说:低温(0.2)时模型更专注、确定性更高,选概率最高的「玩」;中温(1.0)时按概率选,在创造力和专注度之间保持平衡;高温(2.0)时模型更愿意冒险,更可能选「驾」和「飞」。
我看到这里才真的明白温度是什么。它不是「创造力旋钮」这种糊弄人的比喻,它是在一个真实的概率分布上挪动采样点。「一只狗正在驾」这句话,就是高温的产物。这个例子比任何一段定义都结实。
而且它接着给了四个能直接抄走的提示词:
请以温度参数 0.7 生成一段科幻故事开头,要求 200 字左右。
用温度参数 0.5 生成一份简洁的会议纪要,需包含时间地点和决议项。
直接给出答案:北京到上海的直线距离是多少?(温度参数 0.3)
以温度参数 1.2 创作三句关于夏天的诗句,每句需包含「蝉鸣」意象。
最后给了一条可执行的经验:写小说、散文、诗歌可以把温度调高,写论文、公文、新闻稿或做数学推理要调低。这句话我抄下来了,因为它能直接改我的工作方式。
第二处,上下文窗口。
它用了一个我没想到的例子:
如果你把一个包含 20 万字的大型文档上传给 DeepSeek(支持 64K 词元上下文窗口),让它帮你总结 1000 字的摘要,那么由于该模型的对话窗口最多只能够容纳 64000 个词元,20 万字文档的内容会被自动截断,超出部分会被「丢掉」,只保留窗口内能够容纳的部分。也就是说,该模型会使用「残缺不全」的文档来生成 1000 字摘要,这显然不是我们想要的结果。
这段话救的是真金白银的错。我见过太多人把几十页的合同、上百页的研报直接丢进去,然后拿着摘要去开会。做摘要的模型不知道自己在读残卷,它不会告诉你「我只看到了前三分之一」,它会给出一个语气完整、结构完整、自信完整的摘要。这就是「坑」的定义:不是它做错了,是它做对了你没让它做的事。
第三处,多轮对话。这是全书我最想给它鼓掌的一段。
它先算了一笔账:豆包第一轮输入「请你介绍一下厦门大学」,切成「请/你/介绍/一下/厦门/大学」六个词元,假设输出 2000 个词元,窗口里一共 2006 个。第二轮你补一句「不够详细,请你继续补充介绍」,八个词元。然后它问:豆包必须记住第一轮,它是怎么做到的?
实际上,豆包大模型本身并不具备记忆能力,它记不住第一轮对话的内容,而是豆包这个网页端应用把第一轮对话的输入和输出(共 2006 个词元)「打包」,和第二轮对话的提示词(8 个词元)合并在一起,然后把这 2014 个词元一起提交给豆包。
这一段把很多人对 AI 最深的误解拆了:你以为你在跟一个「记得你」的东西聊天,其实每次都是网页把全部聊天记录重新交上去一遍。它没有记忆,是应用在替它记。
顺着这个逻辑,后面那些现象全通了。为什么长对话到后来它会忘掉开头?因为超过窗口被截断了。为什么换个窗口它就完全不认识你?因为新窗口没打包旧记录。为什么聊得越久越费钱?因为每次都要重发全部历史。它甚至把这条推到了省钱上:别在一个窗口里反复问,问完一件就开新窗口,避免词元累加计费。
我的判断:这三处之所以值钱,是因为它们都是「认知纠正」,不是「知识补充」。教科书通常给你定义,这三处给你的是事故现场;而人对事故的记忆,永远比对定义牢固。如果这本书只印第 5 章这三节,卖同样的价钱,我不会觉得亏。
三、第 3 章其实写得最好,只是没人翻到
如果只读第 2 章,你会以为这是一本罗列应用的书;读到第 3 章,你会改主意。
这一章把机器学习按「有没有标签」分成四类:监督、无监督、半监督、强化。多数科普只讲前三类里的两类,它把半监督单独列出来了,理由说得很实:
在有监督学习中,每个样本都有了明确的标签或输出值……然而,在实际应用中,带有标签的数据往往很难获取或成本高昂,无标签的数据则相对容易获取。
这句话点到了产业的真实现状:标注才是最贵的那一环。模型、算力都能买,人工标一遍数据买不到。
它还专门用一张表区分聚类和分类,因为这两个词太容易混:分类是「从已经分组的数据中去学习,把新数据放到已经分好的组里去」,聚类是「把数据分成多个组,探索各个组的数据是否有关联」。一句话:分类是先有答案再排队,聚类是先排队再看像不像。
但这一章真正的骨头,是「传统机器学习算法并未过时」那一节。它在讲完深度学习之后,回头说了一句很多书不敢说的话:
深度学习的兴起确实在很多领域带来了革命性突破,但传统机器学习算法并未过时,在大量场景中仍扮演着不可替代的角色。两者的关系并非替代,而是互补。
然后它给了四条理由,每条都带着具体场景:小数据场景下,小型医院的疾病预测样本只有数千个,用逻辑回归或随机森林比深度学习更可靠;低计算成本场景下,工业传感器每秒要处理上百条数据,用 KNN 或朴素贝叶斯能实现毫秒级响应,边缘设备算力有限更像这样;强解释性场景下,银行信贷评分大多用逻辑回归,因为每个特征的权重可以直接解释成「对违约风险的影响程度」,符合监管要求,医疗筛查用决策树可以清楚展示「哪些症状组合会导致高风险」;结构化数据场景下,电商的用户复购预测用梯度提升决策树,比深度学习更稳。
最后它给了一个我觉得挺妙的类比:深度学习像手术刀,适合精细手术,但日常切割仍离不开普通刀具。
我的判断:这一节的分寸感,是这本书最像「教材」而不是「热点读物」的地方。2023 年之后出的 AI 书,为了赶热度,多半把传统机器学习写成了一段前史;这本书把它写成了工具箱里还插着的那把刀。肯在一本讲大模型的书里说「大模型不是万能的」,需要的不是勇气,是底气。
不过这里也有一处小别扭。它前面刚把机器学习按「有没有标签」分成四类,后面又说「深度学习既不属于单纯的监督学习,也不属于单纯的无监督学习,而是一种可以适配多种学习范式的模型框架」。这句本身没错,但它等于把刚才那个分类维度自己拆了——一个是学习范式,一个是模型家族,两个层级的东西被摆在同一个列表的上下文里,中间没有一句说明。学生读到这儿是容易卡住的:那深度学习到底算第几类?
四、它真正的原创,是一个四格表
第 1 章有一节叫「人工智能思维」,里面给了一个 AI 四象限——按「我会不会」和「AI 会不会」切四块:
第一象限,我会 + AI 会:提效。文案润色、数据查询、翻译。提示词策略是简洁直接,限定格式和字数。
第二象限,我不会 + AI 会:提问。学新领域、做技术方案调研。策略是分层拆解、要求举例和场景化。
第三象限,我不会 + AI 不会:共创。突破性产品设计、前沿研究。策略是提跨界假设、多角度发散再收敛。
第四象限,我会 + AI 不会:训练。定制化报告、业务决策支持。策略是先投喂你的私有知识再提需求——书里给的例子是把客户谈判记录传上去,让它总结三条你的独家话术。
能力矩阵不是新东西,管理咨询用了几十年。但把它对准「提示词该怎么写」,是我第一次见。它回答了一个真问题:为什么同一个提示词,有人用出神效,有人用出一堆废话。答案不在提示词技巧库里,在「你和它各会什么」这个坐标上。同一句话落在不同象限,效果差十倍。
这一节也解释了这本书为什么值得翻——它的价值不在「讲全了」,在「有几处别人没这么讲」。
五、「涌现」这个词,它前后给了两种调子
这是我要扣分的地方,也是我认为读者必须自己动手补的地方。
第 4 章开头,它这样定义大模型和小模型的区别:
当模型的训练数据和参数不断扩大,直到达到一定临界规模后,其表现出了一些未被预测的、更复杂的能力和特性——能够从原始训练数据中自动学习并发现新的、更高层次的特征和模式,这种能力被称为「涌现能力」。具备涌现能力的机器学习模型就被视为独立意义上的大模型,这就是大模型和小模型最本质的区别。
同一章「大模型的特点」第(2)条又写了一遍:涌现能力是「大模型最显著的特征」,「当训练数据与模型规模突破临界值时,会涌现出小模型不具备的深层复杂能力,可模拟类人类思维解决复杂问题」。
然后翻到这一章最后,它引了另一种说法:
所谓模型的「涌现」行为,其实就是各种模式的组合,模型越大,找到的模式越多,组合出的模式也越多。归根结底,一切都是模式。
接着引杨立昆:「AGI 遥遥无期,大模型只不过是基于概率分布的统计模型。它们无法判断什么是对、什么是错,只能通过启发式方法来判断什么可能是对的、什么可能是错的……人类的推理远比统计模型复杂得多。我们每次都错了。」
同一个词,前面是「最本质的区别」「模拟类人类思维」,后面是「就是模式的组合」「一切都是模式」。这两段之间没有任何过渡,没有一句「但另一派认为」,也没有告诉学生该信哪个。
我不想把这说成错误,因为两段各自都对。涌现作为「能力描述」是成立的:规模上去之后,确实出现了小模型没有的表现,这是可观测的。涌现作为「机制解释」是不成立的:没有证据说明它因此产生了新的推理方式,它只是把更多模式组合起来。混淆的源头,是一个词同时装了两件事。
但一本教材的责任,恰恰是把这种混淆拆开。它没有拆。它把最需要辨析的概念,在前后两处给了两种调子,中间交给读者自己接。我接了,我的接法是:以后看到「涌现」两个字,先问一句——你说的是表现,还是机理?
六、它把宏观落到了你的钱包上
第 4 章有一节讲硬件,讲着讲着讲到了存储涨价,这一段我读了两遍。
它说,单台 AI 服务器对 DRAM 的需求是传统服务器的 8 到 10 倍,对 NAND 闪存是 3 倍;美国「星际之门」计划每月约消耗 90 万片 HBM 晶圆;全球三大存储巨头把超过 90% 的产能转向 HBM 和高端 DRAM,挤占通用存储产能,库存降到安全线以下。结果是:2026 年第一季度 DRAM 合约价环比涨 80% 到 90%,HBM4 芯片报价 700 美元一颗,NAND 闪存合约价预计季增 55% 到 60%。机构预测 2026 年 DRAM 均价同比涨 58%,景气度延续到 2027。
然后它把这条链子接到了柜台上:联想、戴尔、惠普已经发了调价函,涨幅普遍 500 到 1500 元;小米、vivo 同存储配置的新机型涨 300 到 500 元;部分机型开始降存储配置来控制成本。
这一段的写法,是我认为全书最「通识」的地方。多数 AI 书停在参数和榜单,这本书肯多走一步:从一块 HBM 晶圆的产能,走到你明年换电脑要多掏多少钱。
同一章还有一段更狠的,讲「词元出海」:OpenRouter 的数据显示,平台前十大模型的词元消耗里中国模型占 61%,前三名都来自中国;词元没有形体、不过海关、不缴关税,甚至不在任何现行的贸易统计口径里——中国出口了大量算力和电力服务,在官方商品贸易数据上却几乎是隐形的。作者给了一句总结:词元成了电力的衍生品,词元出海本质是电力出海。
第 1 章还有一节专门讲「电力—算力—国力」,把麦肯锡 2024 年的研究、「中国新能源七子」(通威、协鑫、隆基、天合、新特、晶澳、晶科)、特高压、38.9 亿千瓦装机摆在一起——截至 2025 年底,太阳能装机约 12.0 亿千瓦同比增长 35.49%,风电约 6.4 亿千瓦增长 22.9%。它的结论是:电力已成为国家 AI 战略竞争的「胜负手」。
你可以不同意这个结论,但你得承认,它把「AI」这个飘在天上的词,拽回到了地面:电、芯片、内存、变压器。这些东西涨价,你的手机就涨价。
七、它的短板
这一节我写得具体一点,因为笼统地说「太浅」没有意义。
第一,模板化的代价。前面说过,第 2 章十二个领域共用一套骨架。骨架的好处是可教,坏处是把它当书读会很闷。而真正有信息量的,反而是那些塞在正文边上的小栏目——「AI 在身边」「拓展阅读」。比如无人机外墙收纳柜试点、珠海湾每户配专属露台停机坪、配送效率提升 60%、特斯拉 Cybercab 下线、FSD 累计行驶 80 亿英里、科大讯飞双屏翻译机支持 18 种语言离线翻译。这些具体的东西全在栏目里,正文一句没有。一本书最好的材料被放在边角,这是编排上的失手。
第二,数据的时间口径混着来。第 4 章引斯坦福《2024 年人工智能指数报告》:2023 年美国发布 61 个知名 AI 大模型,欧盟 21 个,中国 15 个,「美国是顶级 AI 大模型的主要发源地」。紧接着下一段又说,中国已研发出 DeepSeek V3、Qwen 3.5、GLM-5 等全球顶尖开源模型。两个叙述摆在一起,中间没有一句「上面那组是 2023 年的存量口径」。学生会怎么读?会读成「中国只有 15 个」。教材给数字,得连口径一起给。
第三,一个没公布的参数被写成了事实。书里说 GPT-4 的参数规模是 GPT-3 的十倍以上,「达到约 1.8 万亿个」。GPT-4 的参数量 OpenAI 从未官方公布过,1.8 万亿是外界推测值。写成陈述句,等于替 OpenAI 肯定了它没说过的话。
第四,一个没有定义的份额。「GPT-5.2……市场份额约 68%」。按 API 调用量?按收入?按用户数?三个口径能差出几倍。没有口径的百分比,读者既无法判断,也无法反驳。
第五,近一百页点击教程会过期。第 5 章从案例 1 到案例 14,几乎全是「步骤 1 登录……步骤 2 输入……步骤 3 点击……步骤 4 下载」。案例 3 教用 Kimi 做 PPT,连「点击对话框中的 Agent 按钮,再点击 PPT 按钮」都写了。这类内容的问题是折旧极快:界面一改版,这一页就是错的。而通识课的核心指标本该是「五年后你还记得什么」,不是「下周你能不能上手」。全书三百多页,第 5 章占了近一百页,其中真正的概念只有十来页,剩下全是点击。这个比例,我认为是失衡的。
第六,代价和失败被压缩成了两页。全书讲 AI 能干什么讲得非常足,讲「它干错了什么、谁承担代价」只有第 4 章末尾一节「大模型的挑战」,七条,每条一段,约两页。更值得注意的是一个细节:欧盟对 Meta 招聘算法歧视案罚款 5500 万欧元这件事,书里把它放在「欧盟 AI 战略」里,作为政策成绩来讲;它没有出现在「公平性和偏见」那一节里,作为问题来讲。同一个事实放进哪个抽屉,决定了读者学到的是「欧洲管得严」还是「算法会歧视人」。
第七,少了一节最该有的课。它讲了幻觉,而且讲得很好——用厦大官网做对比:官网是「基于事实的模型」,每次访问返回同样的内容;大模型是「基于概率的模型」,服务器上并不保存那份简介,它是临时「拼装」出来的,所以答案是一个字一个字蹦出来的。这个对比极漂亮,一下就把「为什么它会一本正经地胡说」讲清了。但它停在这儿了。它没有往前走一步,把这套认识变成可操作的核验流程:什么该查、去哪儿查、查到什么程度算查过。对一本通识教材来说,这可能是最该有而没有的一节。
还有个小地方,我不算它扣分,但挺有意思:讲机器人控制那节,它写「波士顿动力公司和宇树科技的算法(虽然不完全是强化学习)让机器人完成了复杂的后空翻动作」。括号里那句自我修正很诚实,但也说明这个例子是被体例需要的,不是被事实需要的。
八、一句话
这本书像一个把整座图书馆的目录背下来的人。你问它任何一本书在哪儿,它立刻能指给你;你问它「哪本值得读」,它会翻到目录第十二页,给你念第十二条。
它的价值在第 5 章那十来页——那里它不只报目录,它告诉你书架会塌。
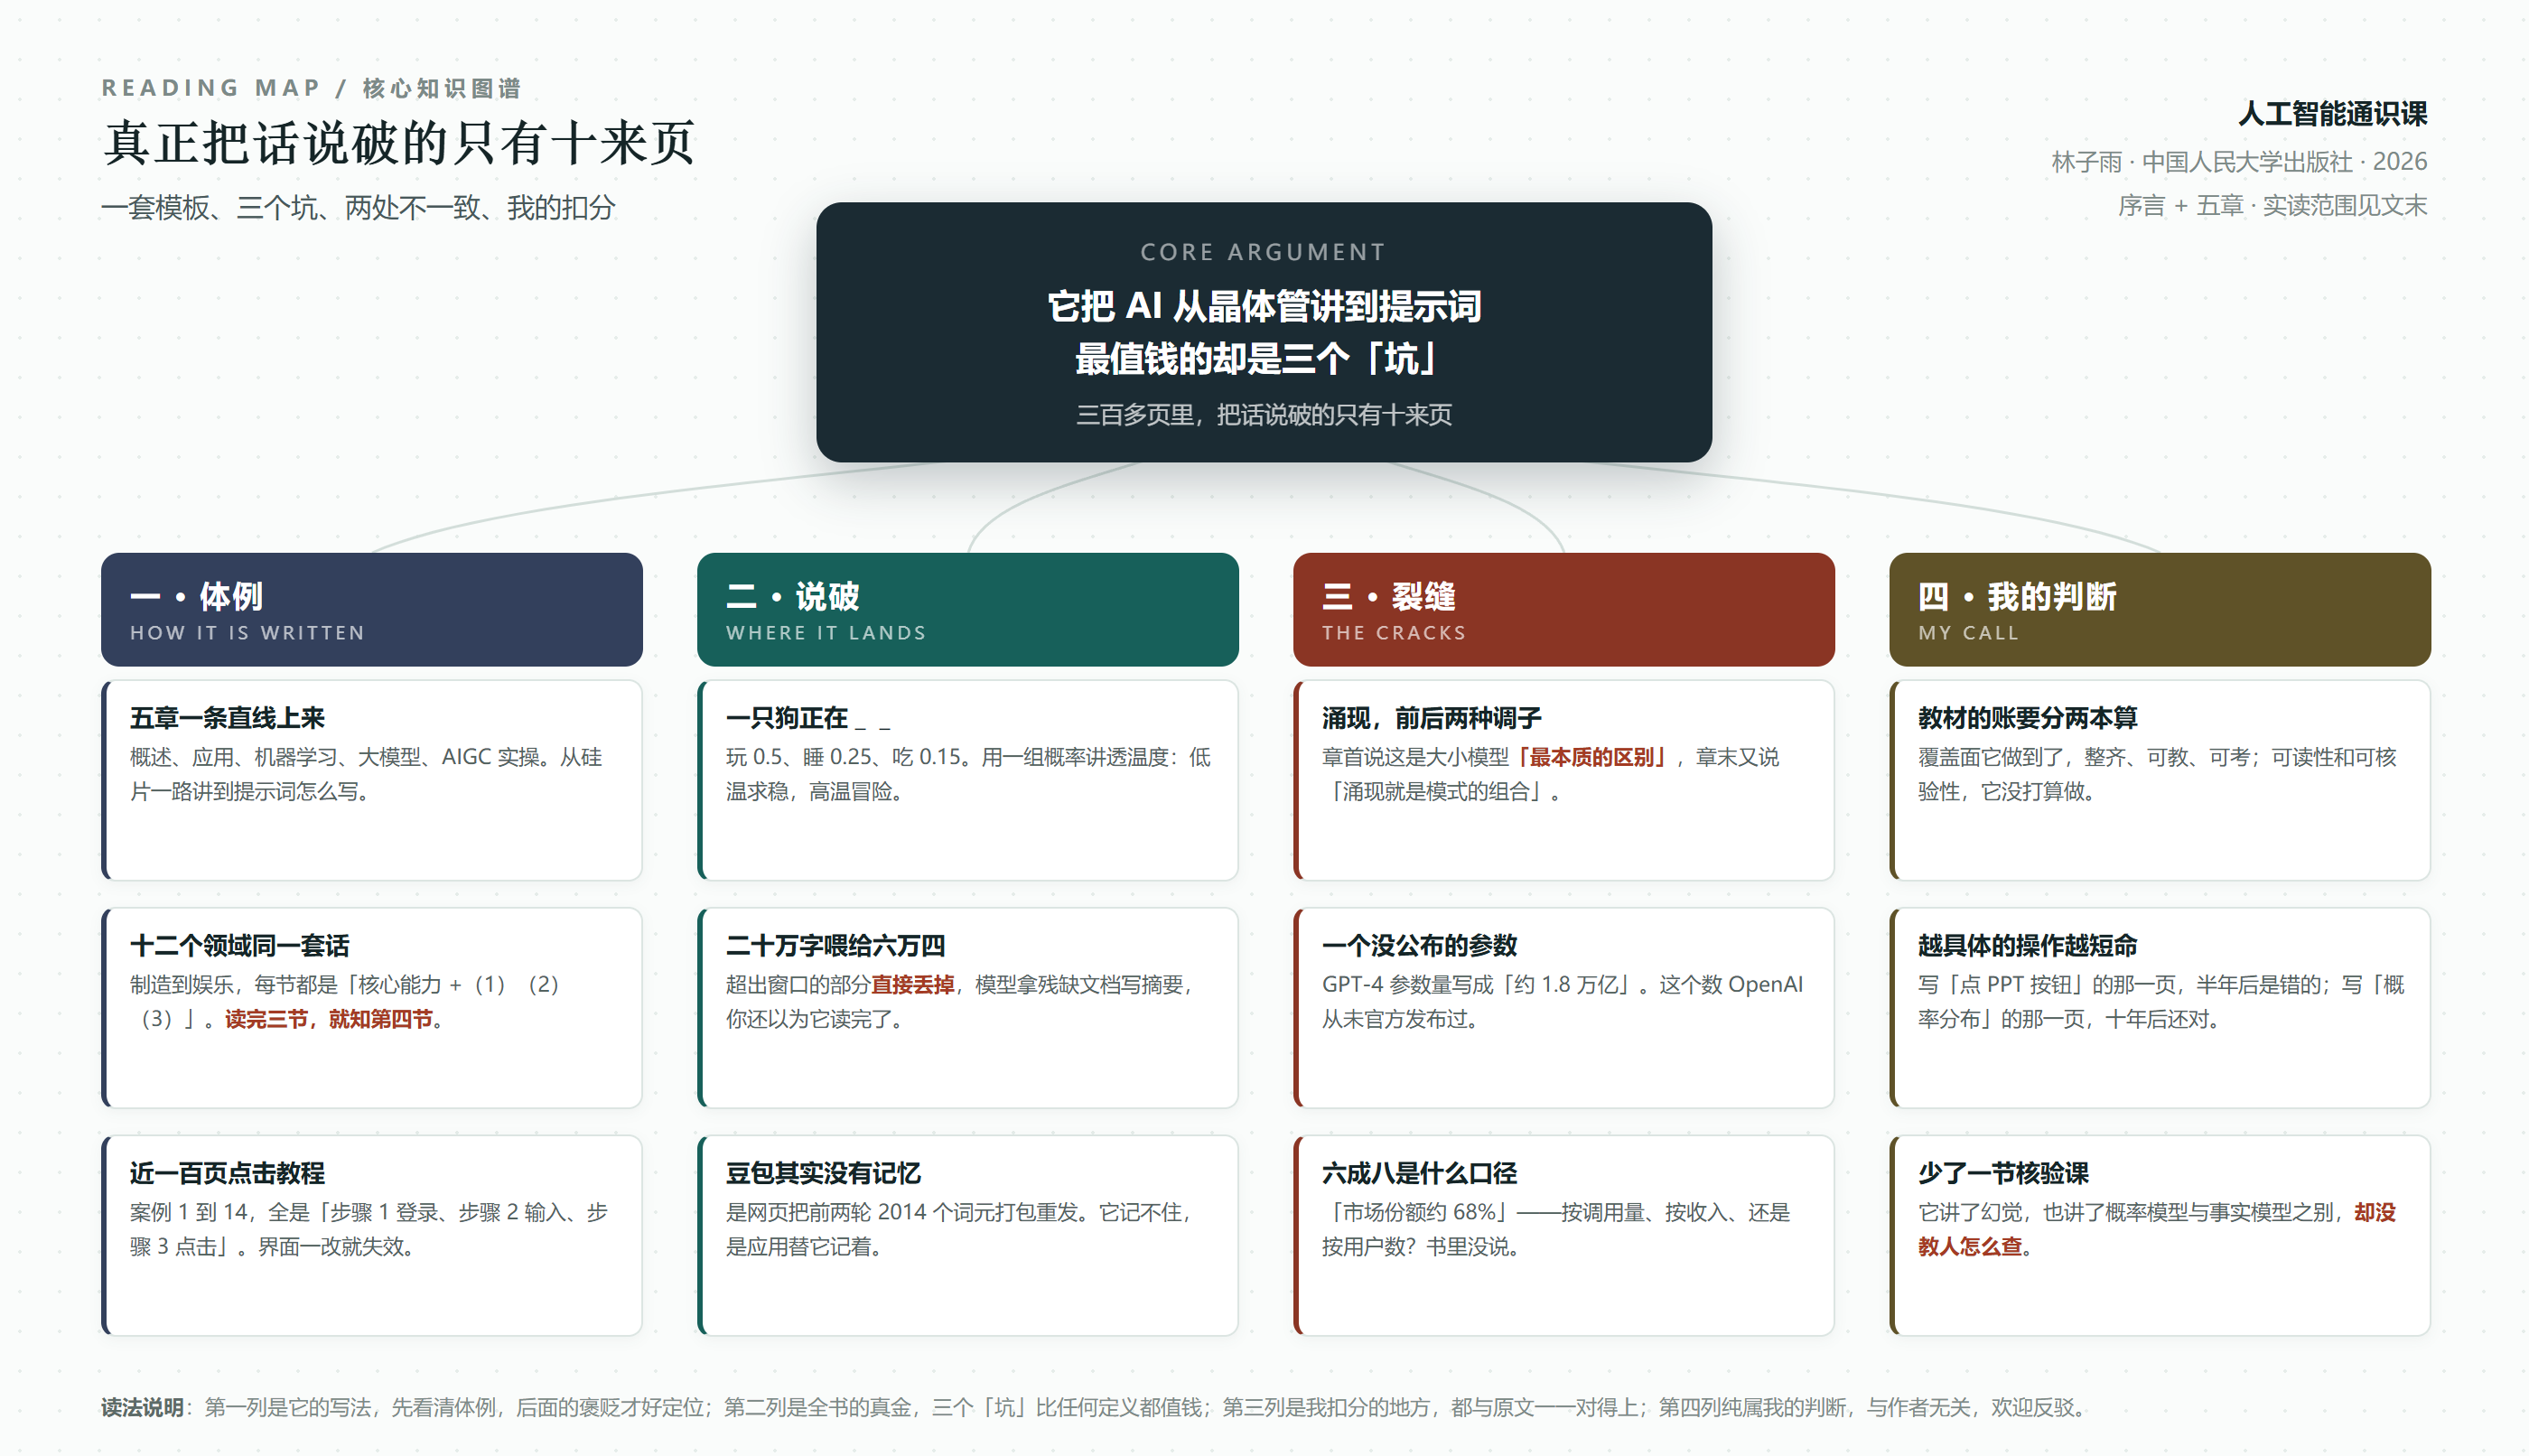
实读范围:版权页、前言、第 1 章至第 5 章,读到第 5 章「AI 智能办公」一节末的拓展练习页(该页页脚仍标「下一章」)。第 6 章及以后未读到,故本篇不对全书结构作完整评价,也不臆测后文内容。本篇所引原话均照录正文、章节已核;凡属我的推断(如「涌现作为表现成立、作为机理不成立」),文中已标明是我的解释而非作者观点。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: