
如何让AI写作更有「人味」:它认出了AI味,却把套话当成了人味
一、它先把「AI 味」变成了能指认的东西
大多数人抱怨 AI 写的东西「一眼假」,但说不清假在哪。这本书的本事在于,它把这个「说不清」拆开了。
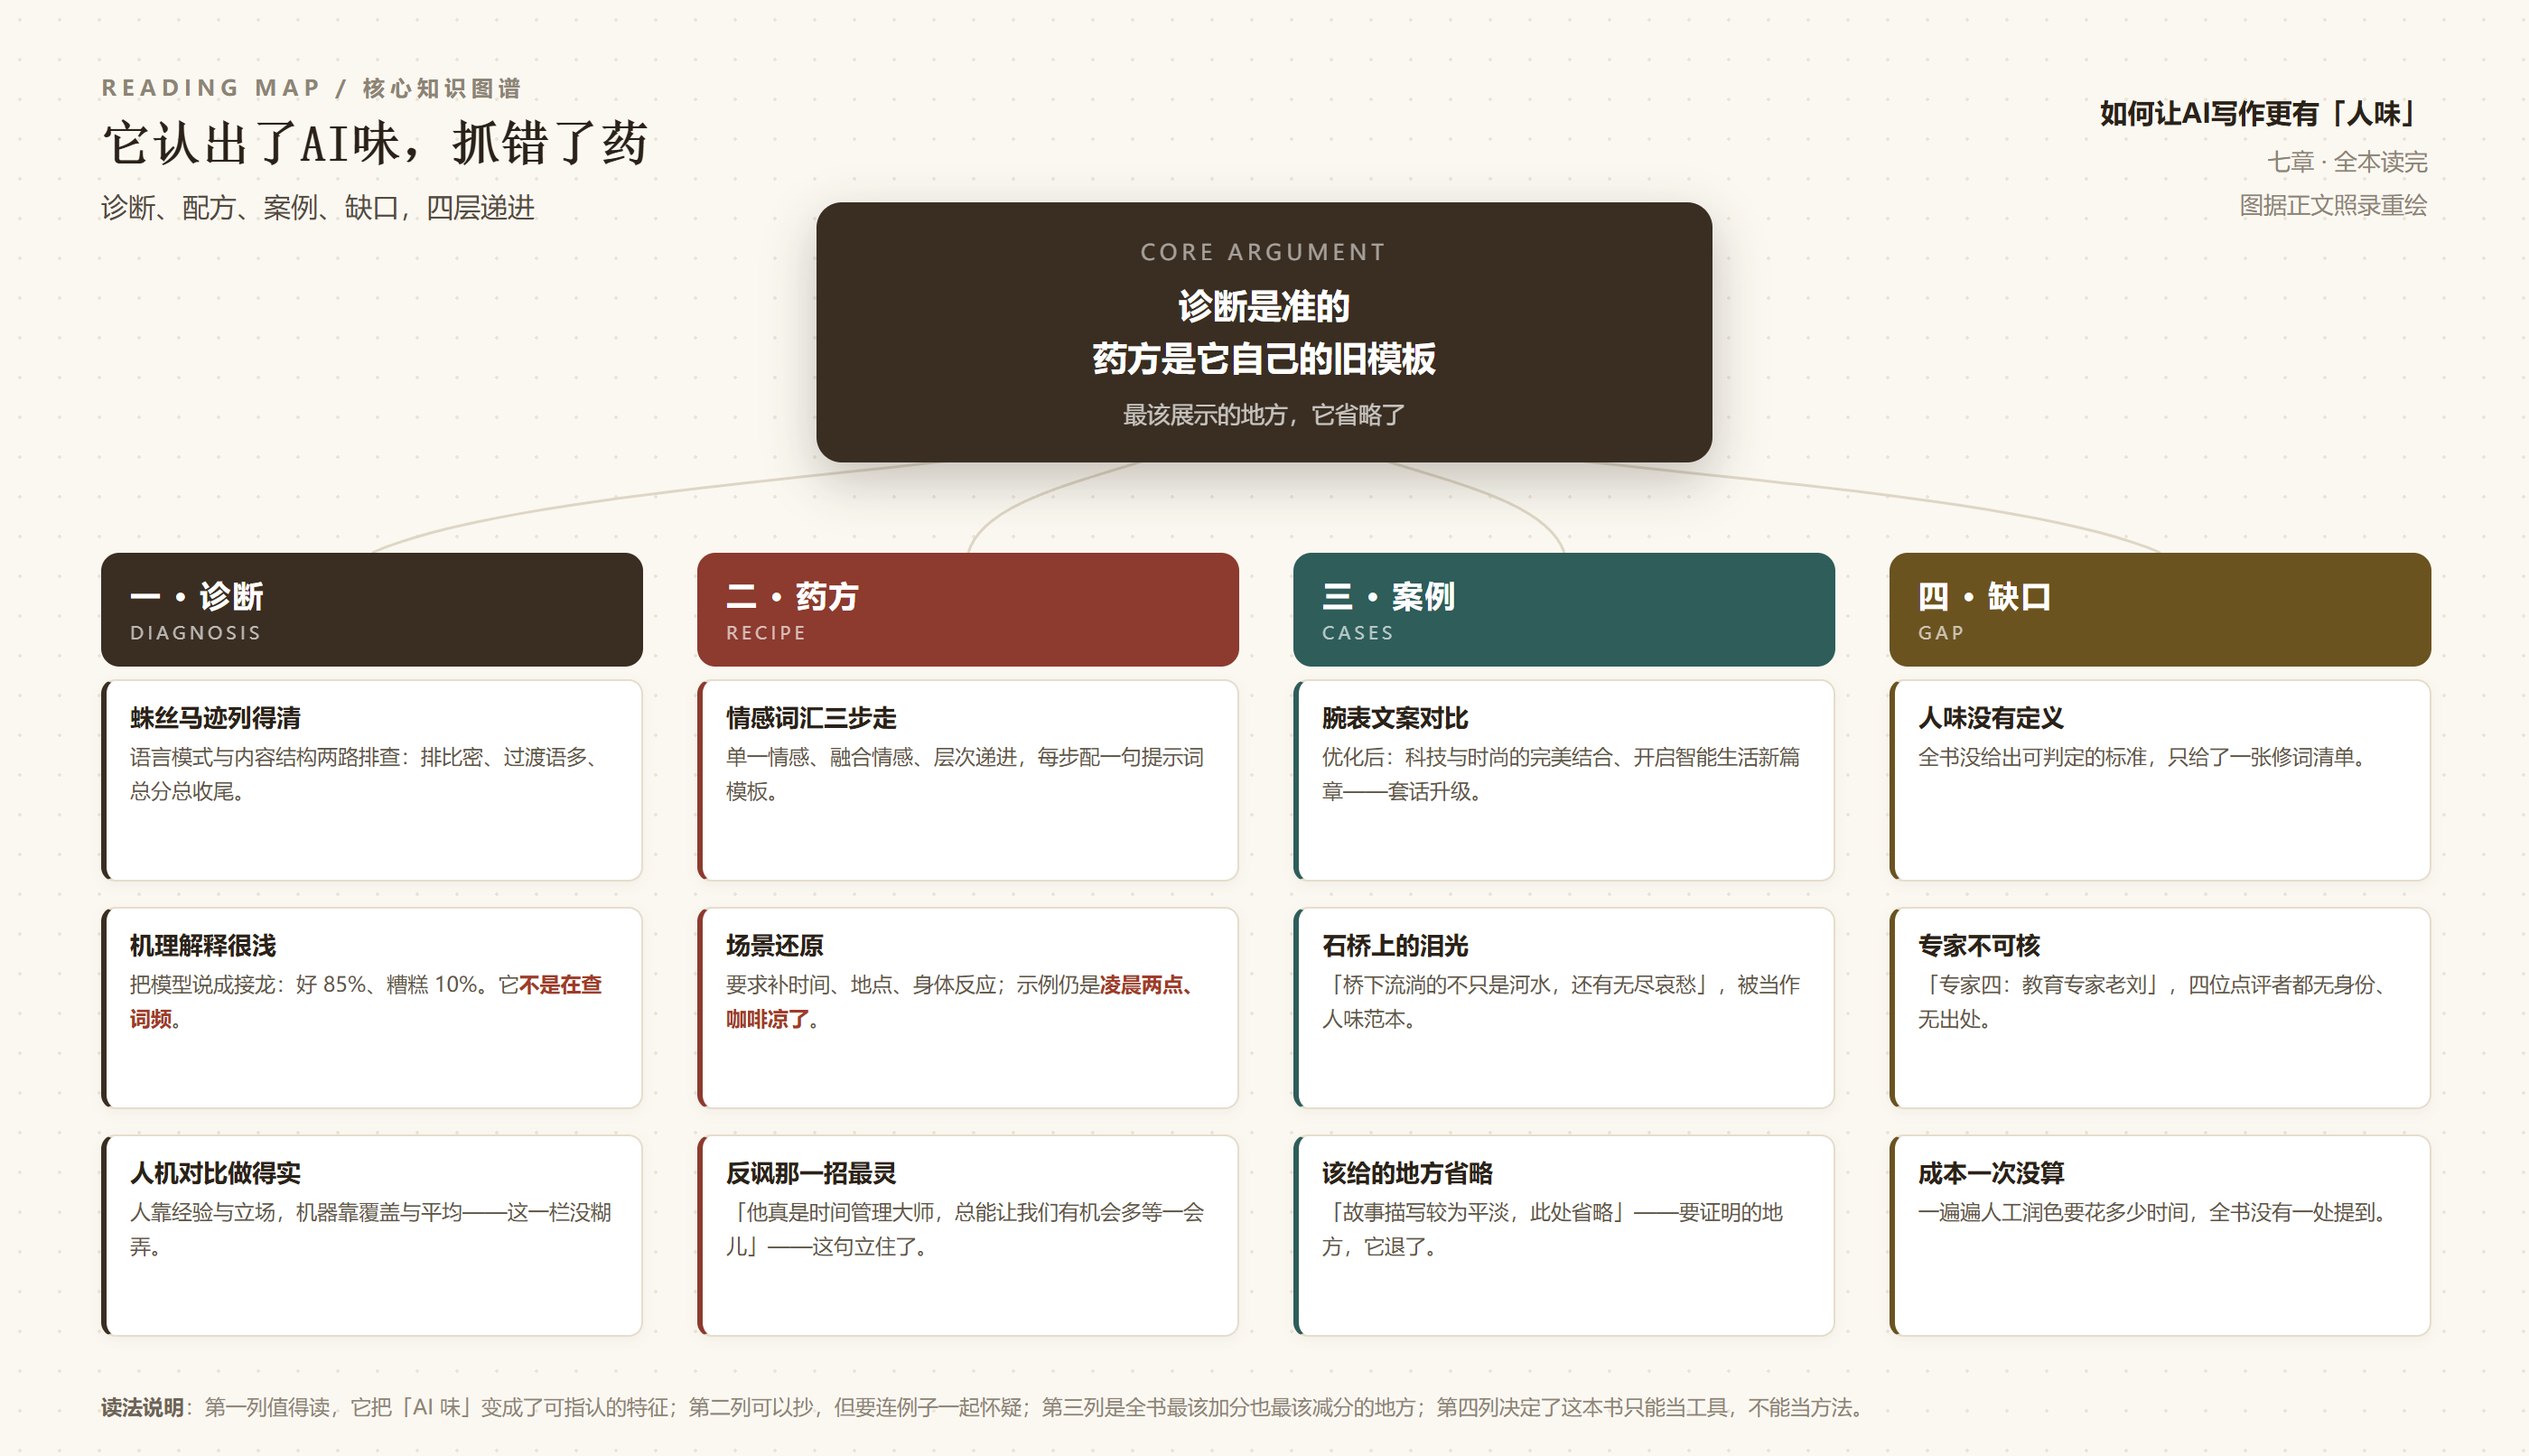
它分两路排查。一路是语言模式:排比句密度高,三句一组的对仗特别多,形容词、副词成串地叠,过渡语用到泛滥——「首先」「其次」「最后」「综上所述」几乎每段都要来一个。另一路是内容结构:开头一定先给个总纲,中间一定是并列的几条,结尾一定要升华一下。
这一段写得不算深,但很准。你拿任何一篇 AI 稿去对,这几条基本都能对上号。更难得的是,它没有停在「因为它没有感情」这种废话上,而是落在了可检查的层面:数一数你的排比句,数一数你的过渡语,你就知道自己这篇有几分像机器。
它还给了一张人机对照:人写作靠经验、靠立场、靠对具体处境的把握;机器靠覆盖、靠平均、靠语料里最常见的搭配。这个对照不新鲜,但它引出一个重要结论——「AI 味」的本质不是文笔差,是太平均。平均意味着每一句都落在最安全的位置上,所以读起来处处正确、处处无趣。
它对「创造力」的分析是全章最好的:模型的「创新」始终圈在训练数据的范围里。它可以模仿莎士比亚的风格写出押韵的诗句,但要造出一种打破传统的诗体,做不到。这个判断我认,而且比「AI 没有灵魂」有力得多——「模仿风格」和「发明风格」是两件不同量级的事:前者是在既有分布里采样,后者是改变分布本身。这条线它画出来了,虽然它后面开的药方并没有真正越过这条线。
问题出在它对机制的解释上。它把生成说成文字接龙:你说「今天天气真是」,它接「好」的概率是 85%,接「奇怪」是 2%。这个比喻讲给小学生听可以,但它是错的——模型不是在词表里查下一个词的概率,而是在一个高维表示空间里连续地预测。这也正是它为什么能一口气写出连贯的长段、又为什么会在细节上编造。理解错了机制,后面所有「怎么治」都会治在症状上。
二、它识别了套话,然后开出同一副套话
书里讲修辞那一节,先给了一条警告,原话是:避免陈词滥调,AI 有时会给出一些老套的比喻,比如「快得像风一样」。
翻过一页,它教拟人。给的范本是这个:
这座古老的钟楼静静地伫立着,仿佛一位饱经风霜的老人,默默注视着城市的变迁。
「仿佛一位饱经风霜的老人」——这就是它刚点名的那个病。它不是在举例说明什么叫陈词滥调,它是在把这个句子当作教学目标摆出来。我在这两页上停了很久,因为这里是全书最干净的一次自我暴露:它在上面一行识别了病灶,下面一行就开出了同一味药。
同一节里还有个更小的例子。它让 AI 描述一款手机速度快,「优化」的路径是:「这款新手机的速度非常快」→「就像闪电一样快」→「快得像子弹出膛」。两级优化,从一个人人都会的比喻,换到另一个。它自己刚说过「快得像风一样」是陈词滥调,但它没意识到「快得像闪电」「快得像子弹」属于同一批库存。
第二章讲情感色彩,它给了三级示范:单一情感、融合情感、情感层次递进。第一步的例子是「她感到悲伤」,第三步是:
她站在古老的石桥上,眼中闪烁着泪光,仿佛那桥下流淌的不仅是河水,还有她心中的无尽哀愁。
我得说句不客气的:这句比「她感到悲伤」更糟。
「古老的石桥」「闪烁着泪光」「桥下流淌的不只是河水,还有哀愁」——这三个零件,任何一个写过两年网络小说的人都见过上千次。它不是人味,它是另一种模板,而且是更低一级的那种:抒情模板。它的问题不是不具体,是具体的假——石桥是道具,泪光是符号,河水是比喻的载体,三样东西拼在一起,读者看不到一个人,只看到一句合格的抒情句。
最能说明问题的是「语言美化技巧」那一节。它讲排比,给的范例是:
他聪明,闪耀着智慧的光芒;他勤奋,闪耀着努力的光芒;他有创造力,闪耀着创新的光芒。
三个「闪耀着……光芒」。而它在第一章把「三句一组的对仗」列为 AI 味的第一条特征。一本教人去掉 AI 味的书,在教人写排比的段落里,给出了一个标准 AI 排比句,并称之为美化。
这种失手不是偶然。第七章「优化效果对比」给了九个案例,我数了一下它们的结尾:智能手表是「立即佩戴,开启智能生活新篇章」,健康饮食是「用美味与营养打造健康生活」,团队合作是「共同谱写公司的辉煌篇章」,编程课是「让代码为你开启无限可能」。四个不同行业、四个不同文体,四个「开启」「谱写」。这不是人味,这是同一个收尾模板换了四次名词。
所以我在这一章得到的结论是:它批判的是「平均」,它给出的解药还是「平均」,只不过换成了一个更抒情的平均值。它把「人味」理解成了「文艺腔」——以为把话说得软一点、加点「仿佛」、加个比喻、末尾升一下华,就像人了。恰恰相反,这三样是机器最擅长的三样。
三、最严重的一处:给一场车祸编出家属和眼泪
第七章讲新闻写作,开头就把标准立住了:「新闻写作最重要的是时效性和准确性。」然后它给了一个对比:报道一场火灾,AI 会说「造成 3 人死亡」,而人类记者会写「3 个家庭失去了至亲」。
这个对比是对的,而且很好:数字是统计,人是处境。到这儿为止,这一节是全书最有说服力的地方。
紧接着它给了「一个真实案例」:某省级新闻网站在使用 AI 辅助写作时,遵循了以下优化步骤。
标题:AI 生成的是《某地发生交通事故致 2 死 3 伤》,人工优化成《雨夜车祸牵动全城:他们用生命守护了更多人》。
导语:AI 生成的是「昨日 23 时许,某路段发生交通事故」,人工优化成「深夜的急诊室外,老张握着妻子的手……就在两小时前,一场意外改变了这个普通家庭的命运」。
我读到这里停了很久,因为这两处改动都有问题,而且不是文笔问题。
第一处,2 死 3 伤的车祸,被改写成「他们用生命守护了更多人」。这句话把死者定性成了英雄,而事故原因、责任归属一概还没查。新闻标题的功能是告知发生了什么,不是替事故赋予意义。把一个未经调查的车祸写成「用生命守护」,这不是人味,这是替事故定性,而且是一种最省力的定性——因为它好听。
第二处更麻烦。老张、妻子、急诊室、两小时前——这些细节是从哪儿来的?书里一个字没交代。它的语境是「AI 辅助写作的优化示范」,所以合理的读法是:这些细节是 AI 或者写作者添上去的。那么它示范的就是给一条新闻添加未经核实的现场。如果这些细节是真的,那它更应该说明来源——因为整本书所有的示范都是虚构的,读者无从分辨这一处是采访来的,还是编的。
而它前面刚说「时效性和准确性」,后面自己又列了「常见误区提醒:避免过度煽情;警惕虚假信息;注意用词准确性」。四条它写下了,然后在自己最得意的案例里同时踩了两条。
这是我认为全书最需要打叉的地方。因为它不只是文笔差,它把「给新闻加细节」变成了一套可复制的动作:找一个普通人、给一个称呼、加一个时间点、写一滴眼泪。这套动作在文案里叫「场景化」,在新闻里叫编造。这本书从头到尾没有区分这两件事,它只有一种「优化」,就是把干的话说湿。
四、它自己的数字,一个都没核实
第六章「逻辑优化技巧」里有一节叫「避免逻辑漏洞」,写着:可能遇到的问题——AI 可能会生成不存在的数据;解决方法——核实内容,自己检查 AI 提供的数据。
另一节「案例分析与实证支持」又写了一遍:AI 可能编造案例或数据;解决方法——对 AI 提供的信息进行验证,必要时手动更正。
话说得很清楚。然后我们来看它自己全书用了哪些数字:
新闻那一节,某媒体采用优化后的 AI 辅助写作,「阅读量提升了 1439%,评论互动量增加了 89%」。自媒体那一节,某时尚博主用上 AI 工具后「创作效率提升了 300%」。教育那一节,某在线教育平台「课程内容制作效率提升 300%、学生满意度提升 40%、教师备课时间减少 50%、学习资料的个性化程度提升 80%」。行政那一节,某政府部门引入 AI 办公系统后「文档处理效率提升了 60%」。第五章讲论证要「用数据说话」,举的例子是「研究表明,远程办公可以提高员工 13% 的生产力」。
五组数字,五个来源,全部写作「某媒体」「某博主」「某平台」「某政府部门」「研究表明」。没有一个名字,没有一个出处,没有一个可以查的口径。「个性化程度提升 80%」——这个指标连怎么计量都说不清。
而 1439% 这个数字本身就值得停一下:阅读量涨了十四倍。要么是原文写错了(可能是 143%),要么是这个案例根本没发生过。一本教人「核实 AI 给的数据」的书,拿一个连量级都不对的数字当效果证明,而且没有一处标注来源——这不是疏忽,这是它自己在第六章立下的规矩,在第七章一条都没执行。
更要紧的是:这些数字是全书唯一的「效果证据」。它要用这些数字证明「优化后更好」,而数字本身不可查,那「更好」就没有证据,只剩主张。全书九十多节,「优化后确实更好」这件事,从头到尾没有一个可验证的样本。
五、在最需要证据的地方,它反复写「此处省略」
全书有一个固定的演示格式,很老实:给初始提示词,贴 AI 生成,指出问题,给优化提示词,再贴优化后的生成。理论上,这个格式能让人亲眼看见改进。
但真到要证明的地方,它退了。
第四章讲悬念,初始提示词是「写一个有多个悬念的故事」,AI 生成那一栏写的是:
(故事描写较为平淡,此处省略。)
然后给优化提示词,要求在高潮部分集中设置悬念点、缓段减少悬念。优化后的那一栏写的是:
优化后的 AI 生成(非原文,简单概述):故事初期,主角发现了神秘信件,开启了寻找宝藏的旅程……
两次都省了。于是这一节的核心证据——改进之后到底长什么样——一个字都没有。
这不是孤例,而是一套稳定的做法。同一章讲多线叙事,生成栏写「(平淡地描写了几位主要人物在不同时间段的生活。此处省略具体生成内容。)」;讲环境与氛围,写「(描述了一个漆黑的夜晚,主角在紧张逃跑的场景。此处省略具体生成内容。)」;讲对比与反转,写「(描写了某角色在危险时勇敢面对敌人的场景。此处省略具体生成内容。)」。第六章讲重点突出,两处示范分别是「(内容平淡,此处省略)」和「(加入了『番茄工作法』的介绍,但仍然浅显,此处省略)」。
你注意一下这些省略出现的位置:悬念、转折、多线叙事、重点突出。全是全书最难的几块。而它给全文的地方是什么?一百多字的腕表文案、三行客服回复、两个人在讨论怎么改提示词的对话。这些它给得很大方,因为它们安全。
我不认为这是篇幅问题。一本书的立论是「我能把 AI 的文字改出人味」,唯一能证明的办法就是把改前改后完整摆出来,让读者自己判断。它在最需要摆出来的地方收手了六次,这六次合起来就是一个答案:它自己也知道摆出来是什么样。
顺带说一个更小的例子。第三章讲对话形式,它给了一段示范对话,用来展示怎么把生硬的对话改自然。原文是这样的:「我写的文章总感觉有点生硬,怎么用 AI 来改进呢?」「你可以试试调整提示词,让 AI 生成更口语化的内容。」「比如说?」「在提示词中加上『请用轻松幽默的语言』,效果会更好。」「明白了,我这就试试!」
改进之后,也只是把「有点生硬」换成「读起来像机器人写的」,把答案换成「可以加『用第一人称』『加入个人经历』」。两个人形喇叭在互相念提示词,从头到尾没有一个人有脾气、有犹豫、有一句多余的话。一节专门讲对话怎么写得像人的内容,自己的对话是全书最不像人的部分。
六、名为「人工干预」,实为「提示词纪律」
第六章的标题是「人工干预手册:AI 文本精修指南」。看标题,我以为终于要讲人怎么动手改稿了:怎么删、怎么砍、怎么把自己的东西塞进去。
翻开来,七节是:结构重组方法、逻辑优化技巧、重点突出手法、人工润色要点、语言美化技巧、情感调节的方法、细节完善策略。
再看细目。「重点突出」那一节的结论是「明确提示词,强调重点」,示范是:不够明确的提示词「请写一篇关于时间管理的文章」,明确的提示词「请写一篇关于时间管理的文章,重点讨论如何利用早晨的黄金时间提高效率」。
这不是人工干预,这是把提示词写得更细。整章读完,我找不到一处讲「你自己动手改这段文字时该怎么做」——没有讲删掉第一段会怎样,没有讲把三千字砍到八百字会损失什么,没有讲什么时候该放弃 AI 的整段重写。它所谓的人工干预,仍然发生在对话框里,而不是在稿纸上。
这个错位很要命。因为人味这件事,绝大多数时候不是加出来的,是删出来的。AI 的稿子之所以平,往往是因为它把每一条都写全了,把读者该自己想的那部分也替人想了。真正的修饰工作是把这些「替你想了」的部分砍掉,留出缺口。而删,是这本书几乎没讲的动作。
不过我得公道地说:它确实给了一套能用的东西,只是不在「人味」这一层,在「提示词纪律」这一层。
比如它教人先列大纲再让 AI 填,而不是一句「写篇关于环保的文章」就等结果;教人逐段生成,「一次只让 AI 生成一段内容,确保每段都符合要求」;教人要求 AI 先列出反对意见再逐条反驳(「请列出有人认为环保不重要的 3 个理由,并进行反驳」);教人把数据源写进提示词(「请引用世界卫生组织的数据」)。第五章「观点论证方法」给了七种论证:数据、举例、逻辑推理、权威背书、对比、比喻、预设反驳。第四章「情节推进」也给了七条:因果链条、制造冲突、设置目标、细节描写、节奏控制、伏笔铺垫、巧用留白。
这些是可执行、可检验的。它们解决的是「怎么让 AI 的输出更符合你的意图」,而不是「怎么让文字更像人」。这两件事被这本书混成了一件事,所以书名才叫「人味」——因为「人味」比「提示词纪律」好卖。
而真正该给的那把尺子,它一次都没给:写完这段,问自己一句,这句话换个人还能不能用。能用,就是模板;不能用,才是你的。凌晨两点的凉咖啡、古老的石桥、饱经风霜的老人,换任何一个作者、任何一个城市,一个字都不用改——所以它们是模板。而「我爸把那块上海牌手表擦了三遍才戴上,说这样显新」,换不了人,所以它是人味。这个判据,全书没有。
七、它的短板
第一,「人味」从头到尾没有定义。它用了几十个例子说明什么是人味,但没有给出一个可以判定的标准。于是只能退回「多加细节、多加情感、多加口语」这种加法思维,而加法恰恰是 AI 最擅长的事——你让它多加,它就加得更多、更满、更平。
第二,例子的抽样是偏的。短例(文案、客服、对话)给全文,长例(故事、悬念、结构)六处「此处省略」。这等于把最容易达标的样本摆出来,把真正难的部分藏起来。读者学到的是一堆局部修补技巧,不是一个完整的改写流程。
第三,结构本身就是它批判的那个病。七章、九十多个小节,每一节都是同一个模板:先给一个生活化的比喻解释概念(像做菜、像盖房、像穿衣),再讲怎么改提示词,再给「初始提示词—AI 生成—优化提示词—优化后生成」四段式,再列常见问题,再给解决方法,最后来一句引号里的金句收尾。九十多节,九十多次「总—分—总」。它说 AI 味来自「开头总纲、中间几条、结尾升华」,而它自己就是九十个这样的段落排在一起。这个讽刺它大概没意识到。
第四,对模型的理解停在比喻层面。「文字接龙」「85% 概率」这个解释,会让读者以为 AI 出错是因为「选错了词」,于是所有补救都集中在措辞上。但模型编造数字、编造案例,不是措辞问题,是它没有「不知道」这个状态。这一层不讲,后面所有「核实」都只是提醒,不是方法。
第五,不谈成本。它的方法本质是「生成—发现问题—改提示词—再生成」的循环。这个循环要跑几轮?每轮多久?一个人一天能处理多少字?全书一次没算。而不算成本的方法论,在实践中往往直接夭折——因为大部分人试到第三轮就烦了,然后把第一版发出去。
第六,没有失败样本。它只展示「优化后」,不展示「优化失败」。而写作者最需要的恰恰是后者:为什么我加了细节反而更假了,为什么我加了口语反而更油了,为什么我把「3 人死亡」改成「3 个家庭失去了至亲」之后,稿子通过了但家属不接受。
第七,结论只有一个,重复了五遍。「AI 是助手,不是替代者」这句话,前言说一遍,第一章说一遍,第六章说一遍,第七章让四位专家各说一遍,后记再说一遍。那四位专家——资深媒体人老王、畅销书作家小李、互联网技术专家老张、教育专家老刘——没有单位、没有职务、没有出处,四段话的意思完全一致。后记又用「照相机没有取代画家」「咖啡师调不出那杯风味」两个比喻,把同一句结论讲第六遍。一本讲怎么写得不像机器的书,用六遍同样的收尾结束自己。
八、一句话
这本书的正确用法,是把它当一本「AI 味识别手册」,而不是「人味生成手册」。
前半本它干得不错:排比、过渡语、总分总、平均化,这几条能让你一眼认出机器稿。后半本它给的药方,你要连着例子一起怀疑——凡是它标着「优化后」的地方,都拿那把尺子量一下:这句话换个人还能不能用。能用,就还是模板。
后记里它写了一句我认为全书最诚实的话:「AI 再强大,也无法真正理解人性的温度。它可以模仿语言,但无法体会生活的酸甜苦辣;它能分析数据,却难以感受人心的跳动。」
这句话是对的。但它说完之后,没有举任何一个例子——而前面四百页里,每一个「有人味」的范本,都是它自己或者 AI 写出来的。它其实已经知道答案了:人味不在技巧层,技巧只能教你写得更顺、更全、更符合预期,唯独教不了你「选择说什么」。这句话和前面九十多节是矛盾的,而这个矛盾,它没有面对。
「人味」不是形容词加得多,是你敢写那件只有你知道、别人替不了的事。这件事没法用提示词外包,也没法在对话框里完成。它只能发生在你关掉 AI 之后。
本篇所引例句均照录书中原文,判断由我自己下;凡书里标注「此处省略」「简单概述」的生成结果,我一并说明它省略了。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: