
AI漫剧创作一本通:工序是老的,工具是新的
《AI漫剧创作一本通》,西羊石、秋叶著,人民邮电出版社 2026 年 4 月版,ISBN 9787115694522。
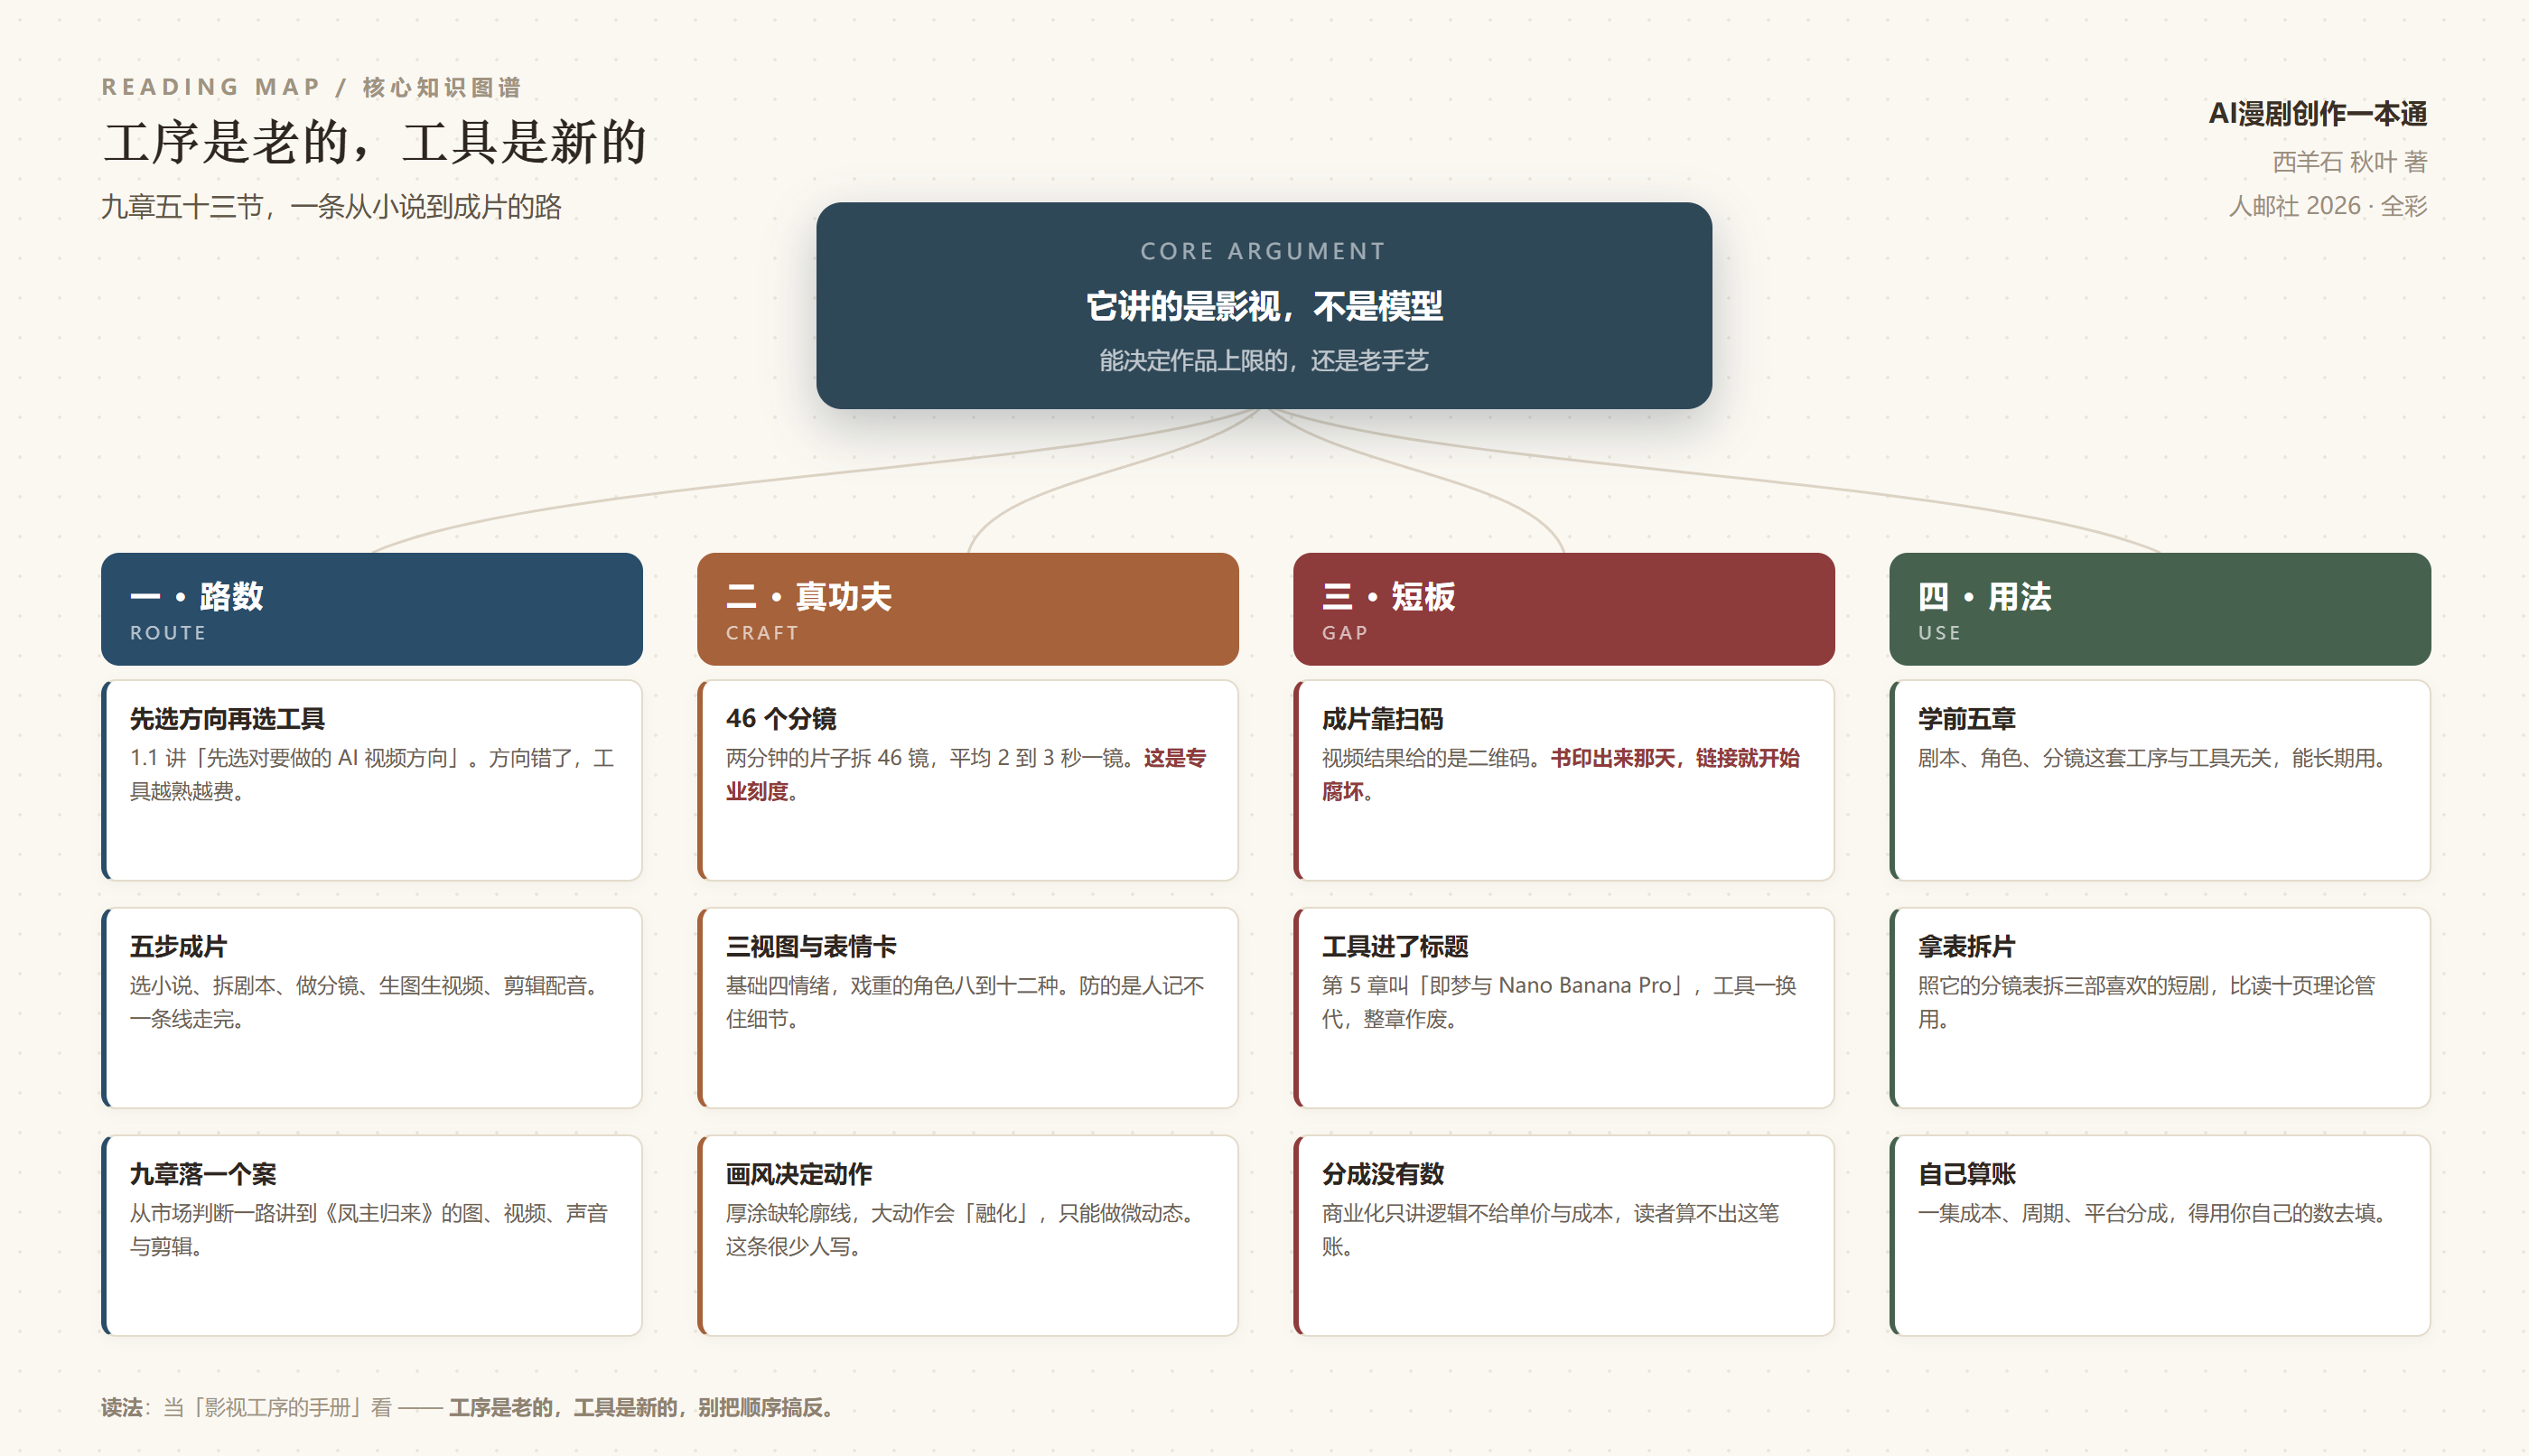
先说结论:这是我这几个月读过的 AI 内容创作类书里,最不像「快销书」的一本。它当然也有快销书的痕迹——群里学员的好评截图、满篇「必须」「一定要」的培训腔、一半篇幅绑在两个具体工具上——但它的骨架是影视工序,不是工具说明书。而工序这种东西,是不随模型换代作废的。
全书九章五十三节。第一章讲市场判断,第二章拆剧本,第三章做角色与场景,第四章讲分镜与视觉语言,第五章是分镜实战,第六章图生视频,第七章声音,第八章把前七章的方法落到一部完整的片子上(《凤主归来》),第九章讲行业走向与商业化。
这个结构有个明显的好处:它不是「功能—操作」式的排列,是「工序—产物」式的排列。每一章的产出物都很明确——大纲、剧本、分镜脚本、角色三视图、资产库、镜头片段、音轨、成片。你读一章,手上就多一件东西。这一点,比很多把「AI 能做什么」罗列一遍的书要强得多。
一、它兑现了前言里那个不太好兑现的承诺
前言里有一段话,说得很有底气,也把自己架住了:
这不是一本围绕某一款工具或某一平台展开的说明书,也不是一本追逐短期流量红利的快销书,而是一本系统性的AI漫剧创作全流程指南。书中所呈现的方法,很多来源于传统影视与动画行业中已经被长期验证的工作方式,只是被重新拆解、重组,并适配到了AI漫剧,乃至未来AI真人短剧的生产流程中。
接下来这句才是关键:「角色如何建立,场景如何服务叙事,分镜如何影响节奏,剪辑、配音与音乐如何共同决定观看体验——这些基础问题,恰恰是AI时代最容易被忽略,却最能决定作品上限的部分。」
我读完之后的判断是:「工序取自影视」这半句,它兑现了;「不围绕某一款工具」这半句,它只兑现了一半。具体怎么打折,我留到第六节说。先说它兑现的那部分——因为那部分真的值得记下来。
二、两分钟四十六个分镜:这个数字说明了这本书的底色
第 1.3 节讲从内容到成片的路径,中间有一张表,标题叫「设计思路」。表里四行:总时长约 120 秒(2 分钟)、分镜数 46 个(符合快节奏要求,平均 2—3 秒/镜)、视觉风格「新中式美学+轻科幻+温暖治愈系」、叙事节奏「前 30 秒神秘世界观铺垫—中段温情故事展开—后段情感升华收尾」。
这张表只有四行,但它是整本书可信度的来源。因为它给的是刻度,不是形容词。
业余的人做 AI 视频,通常是一段提示词跑出一个五秒镜头,好看就留着,凑够一分钟就发。专业的人不这么干:先定总时长,再按时长反推镜头数,再按镜头数分配叙事节奏——前三十秒干什么、中段干什么、结尾干什么。四十六个镜头,两分钟,平均每个镜头两秒半。这个密度意味着什么?意味着你不能指望任何一个镜头靠「漂亮」撑住观众,你只能靠镜头之间的接续。节奏是算出来的,不是剪出来的。
同节还有一段话,把分镜在 AI 语境下的特殊性讲清楚了:「在AI漫剧中,分镜并不追求复杂的镜头调度,而是更注重信息表达的清晰度和情绪传递的准确性。镜头语言越明确,后续图像生成和视频制作的稳定性就越高。」
这句话的分量在于后半句。传统分镜是为拍摄服务的,导演和摄影师能理解模糊的意图;AI 不行。你写「一个略显落寞的背影」,模型给你的是一个背影,落寞不落寞它不管;你写「中景,人物背对镜头站在窗前,肩膀略塌,头部低垂五度」,它才可能给你想要的东西。所以在 AI 这里,分镜的清晰度直接等于成片的稳定性——这是一个真正的「AI 时代的新约束」,而不是把老话复述一遍。
它也顺手把责任划清了:「AI大模型可以辅助将文字描述转换为更标准化的分镜脚本,但其前提依然是创作者已对画面所需传达的内容形成清晰构思。」这句翻译过来就是:模型能帮你把想法写成表格,但想法得你自己有。
第二章的三节标题连起来读,其实是一条收敛链:2.2「定故事大纲,先给故事一条不会跑偏的主线」,2.3「拆剧本,把故事变成可拍的文本」,2.4「将剧本拆解成分镜脚本」。
注意 2.2 里那个定语——「不会跑偏的主线」。大纲的功能不是把故事写好看,是防止你在四十几个镜头里迷路。一部两分钟的片子,四十六个镜头,如果没有一条钉死的主线,你会在第十几个镜头的时候开始想「这里加个反转挺好玩」,然后片子就散了。大纲在这里的作用,接近于工程里的需求文档:它约束的不是创作,是创作的边界。
2.3 的「可拍的文本」也是同一个道理。小说和心理描写是给读者的,剧本和分镜是给执行者的。一个「他心里一沉」在小说里是好句子,在分镜表里根本没法落笔——你得把它翻译成「眼神下移、手指收紧、背景音抽掉」。改编的本质不是删减,是翻译。这本书把「翻译」这个动作拆成了两步:先把小说变成剧本(去掉不可拍的部分),再把剧本变成分镜(补上可拍的部分)。
三、3.4 那两页,是全书最值钱的地方
我评判一本工具书有个土办法:翻它敢不敢放失败的图。绝大多数书只放成功案例,因为失败案例会削弱「照做就能成」的承诺。这本书在 3.4 节放了两页失败图,还分了类。
第一类是比例问题。图 3-7 是一组「存在比例问题的生成案例」,画面里角色的腿部、脚部明显失调。它给的解法不是「多试几次」,是三条具体的约束:
一是强制写明全身状态与基础姿势,例如输入「全身站立,正面或微侧身,四肢自然舒展,避免坐姿或躺姿」;二是对画面元素做「减法」式的负向约束,明确告诉 AI「画面中只出现一位角色,无其他人影、动物或复杂道具干扰」;三是对必须出现的道具,描述为稳定收敛的静止状态,因为「AI很难处理复杂的动态持握」,所以写成「右手自然垂下,握着一把收鞘长剑,剑尖朝下,无夸张摆姿」。
这三条的价值在于它们的层次:一条管姿态,一条管干扰,一条管道具状态。它不是「提示词大全」式的堆砌,是按出错原因分派的处方。
第二类是信息过载,这一段我认为是全书最锋利的一页:「许多创作者误以为提示词越长,生成的画面就越精致。事实恰恰相反,当一条提示词中堆砌了十几种装饰元素、五六种不同材质时,AI会将这些权重分散,导致画面重点模糊,最终生成难以辨认的『繁杂纹理堆砌』。」
这句话值得单独拎出来,因为它正面顶撞了目前最流行的那套做法——去社区抄一长串标签,masterpiece、best quality、ultra detailed、intricate details、8k、cinematic lighting,一路堆上去。堆的结果不是精致,是均匀:每个元素都被提到了,每个元素都不重要,画面变成一堆平均用力的细节。而好画面恰恰是不平均的——有主、有次、有虚、有实。
一个作者能在书里承认「提示词越长越糟」,说明他真的跑过很多次,而不是只在文档里读过参数。
四、画风不是审美问题,是动作预算问题
4.2 节讲画风选择,这一节的写法我认为是全书的范本:它不讲「哪种风格好看」,它讲这种风格能承载多大的动作。
比如厚涂风,书里说得很直接:「在使用此类风格进行视频生成时,不适合安排剧烈的动作场景。因为其缺乏明确的轮廓线,大幅度的运动会导致画面『融化』。」然后给出替代方案:「正确的动态化策略是做『微动态』,如烛火摇曳、尘埃浮动、角色呼吸时胸腔的起伏、水面波光等。利用光线的缓慢流动来暗示时间的流逝,用氛围感这种高级手段来维持观众的沉浸感。」
「融化」这个词用得极准。任何跑过图生视频的人都见过那种画面:人物一动,脸开始糊,衣服边缘开始流淌,最后整张图像被水泡过。原因是模型在缺少明确边界约束时,会把运动理解成像素的位移,而不是物体的位移。厚涂没有硬边线,模型就没有可以「抓住」的轮廓,一动就散。
而它给的应对,不是「换个模型」,是「换个动作设计」——把剧烈动作换成微动态,用光的流动来代替事件的推进。这是一个创作者视角的解法,不是工程师视角的解法。工程师会说等模型变强;创作者会说,我现在就要交片,那我改剧本。
同节讲皮克斯风格,也是这个路子。它把这种风格的核心逻辑概括成「真实的材质,夸张的造型」,然后拆成四条:艺术化的真实感(不追求物理照片级真实,而是真实基础上的艺术化夸张)、亲和感与卡通感、精湛的灯光与全局光照、标志性的瞳孔(巨大明亮的卡通瞳孔,是传递情感的关键)。
这四条拆得对不对,见仁见智;但拆的方向是对的——它在告诉你,这种风格是由哪几个可控要素构成的,你调哪几个参数能靠近它。这比「输入 pixar style」有用得多,因为后者只会给你一个大概的味道,前者能让你在味道不对时知道拧哪个螺丝。
五、三视图与表情卡,防的是人不是模型
3.5 节讲三视图,这一节有一个很反直觉的论证。
一般人以为做三视图是为了「教会模型这个角色长什么样」。这本书说的是另一件事:「分镜数量增加会导致记忆负荷过载。创作者难以仅凭记忆维护所有视觉元素的一致性。发际线高度、衣角长度、腰线位置、配饰朝向等细节,在单张画面中或许不明显,但在连续播放的视频流中会被显著放大。」
也就是说,三视图首先防的是人自己记不住。四十六个镜头,每个镜头里角色的发际线高一点低一点、衣角长一寸短一寸,你在单张图上根本看不出来,但连着放的时候,观众的眼睛会察觉「这个人好像换了」——说不清哪里不对,就是不连贯。
它还往前推了一步:角色形象基本稳定后,要尽早做标准化的三视图;资源允许的话,同步做表情卡。「基础情绪至少应包含平静、愤怒、惊讶、悲伤4种。对于戏份较重的角色或关键配角,这一标准应扩展至8种甚至12种以上。」然后给了一句可直接用的提示词:「为此人物生成表情卡,包含至少8种不同情绪。」
图 3-10 是生成结果:八个格子,开心、伤心、生气、吃惊、疑惑、疲劳、大笑、紧张,同一个角色,同一套画风,情绪区分得很清楚。
这一段的方法论意义,比它的操作价值更大。它说明了一件事:AI 创作里的「一致性」问题,一半是模型问题,一半是资产管理问题。模型那边你控制不了,但你可以在自己这边建一套资产(三视图、表情卡、场景图、道具图),让每一次生成都有参照物。这套做法在游戏美术里叫「设定集」,在动画里叫「角色表」,几十年的老规矩,搬到 AI 这里一样管用。
第五章第三节把这个思路推到了「库」的层面,标题就叫「AI漫剧资产库的建立」。这一步是业余和专业最明显的分水岭。业余的做法是一个镜头一个镜头地生,每个镜头都是一次新的抽卡;专业的做法是先攒一套资产——主角三视图、表情卡、常穿的衣服、常用的场景、反复出现的道具——每次生成时把资产作为参考图带进去,让模型在一套既定形象里工作。
这两种做法的差别,在第三个镜头之后就开始显现。前者到第一集结尾,主角的脸已经换过五张;后者到第十集,还能认出是同一个人。而且资产库有一个复利效应:你攒得越多,后面每一集的开机成本越低——这不是省钱,是省脑子。人的注意力是最稀缺的资源,把它花在「这个人的脸该什么样」上,就没法花在「这场戏该怎么演」上。
六、但它一半篇幅还是绑在两个工具上
现在说那个打折扣的承诺。前言说「不是围绕某一款工具或某一平台展开的说明书」,而第 5 章的标题是「分镜设计实战:即梦与 Nano Banana Pro」,6.1 节是「AI漫剧视频生成工具」,正文里工具名出现的密度不低。
我不认为这是欺骗。工序要落地,总得落到具体工具上,否则就成了空谈。问题在于比例和写法:当工具名进了章标题,这一章的生命周期就被工具绑定了。即梦的界面换一版、Nano Banana Pro 的模型升级一次,第五章的一部分操作步骤就要作废。而第二章到第四章(剧本、角色、分镜)不会,因为那部分讲的是工序。
这本书其实有能力处理得更好。它在讲工具时,有几处是「按能力讲」而不是「按按钮讲」的:比如 5.1 叫「即梦的模型选择逻辑与风格比例」,注意是「逻辑」,不是「操作」;5.3 叫「AI漫剧资产库的建立」,这是工序语言。如果全书都按这个口径写——先说这一步要解决什么问题、需要工具具备什么能力,再说某个工具怎么实现——那它的保质期会翻倍。
可惜的是,视频类教程还有一个绕不过去的物理限制:书是静态的,它教的是动态的。所以成片只能用二维码给。6.2 节讲图生视频,正文里写「Vidu AI生成的视频如图6-13所示。具体的生成结果可扫码查看」,然后是一张二维码,下面一张六秒、1080p 的截图。
这个处理在纸书里几乎是唯一解,但它有个代价:书印出来的那天,链接就开始腐坏。平台改域名、视频被下架、账号迁移,二维码就变成一块黑白方块。而这本书最想让你看见的恰恰是动态效果——运镜、呼吸、光影流动,全都动不了。这不是作者的错,是媒介的错。但读者该知道:这本书的静态部分(工序、分镜、约束)是耐用的,动态部分(成片)是易腐的。
七、商业化那一章,只有逻辑没有账
第九章讲行业走向,9.4 节讲商业化。这一节的态度我很欣赏,因为它不卖梦。
它开头就说:「AI漫剧真正进入商业化阶段,其标志并非『能不能做出来』,而是『是否具备可持续价值』。」然后是一段对行情的直白描述:「在2025年下半年至2026年年初这一阶段,行业最显著的变化,并非来自某一款工具的技术突破,而是一整套内容生产与分发逻辑被迅速验证、放大,并在极短时间内进入高度竞争状态。供给快速涌入、价格持续下探、平台规则频繁调整,几乎所有参与者都会在某个节点面临同一个现实问题:如果仅依靠制作费与接单模式,这条路是否还能长期走下去?」
「供给快速涌入、价格持续下探」——这十个字,比整章「AI 让创作平权」的漂亮话有用得多。所有教人做内容的书都该说这句话,但很少有人愿意说,因为说了会打击购买欲。
接着它把商业逻辑讲清楚了:在传统影视里,作品完成就意味着价值阶段性兑现;而在漫剧赛道,「作品本身只是进入平台体系的『入场券』,真正产生商业价值的,是内容是否能够被持续纳入平台的流量循环」。然后提到完播率、停留时长、互动率、转化表现这一整套筛选机制。
这段判断是对的,而且是内行话。但它到此为止了——没有单价,没有成本,没有周期。一集多长、做一集要几个人几天、平台分账怎么算、接单报价什么区间、一个账号做到什么量级能养活一个人,全书没有一个数字。读者读完这一章,会明白「这不是一门靠制作费长期吃饭的生意」,但仍然不知道自己该不该进去、进去要投多少。
我理解这个难处:这类数字变动太快,写死了容易错。但「不给数」和「给区间并注明时间」是两件事。前者让读者无从决策,后者至少给了参照。
八、它的短板
第一,工具的比重压过了承诺。前言说不是说明书,但第五章整章、第六章大半都建立在两个具体产品上,而且工具名进了标题。这些章节的保质期,取决于那两个产品多久改一次版。
第二,唯一的完整案例,掩盖了失败的九十九次。第八章用整章拆《凤主归来》,从图片、视频到声音剪辑,这是好事——它证明方法能跑通一次。但一个案例也意味着读者只看到一条成功路径:你不知道这部片子中间返工过几次、哪个镜头试了二十遍、哪段音乐换了三版。3.4 节是全书唯一展示失败的地方,那两页的价值因此格外高。
第三,用群聊截图当效果证明。前言里贴了特训营的群聊截图,红框标出「是的,能出来东西,还是有点成就感的」「没上课之前,连流程都不知道,更别说技术细节」。这类材料在任何一本课程衍生书里都能见到,它的功能是建立信任,不是提供证据——学员说「有成就感」,不能证明方法有效,只能证明课程让人满意。放在前言里无伤大雅,但它不该被当成论据。
第四,改编的授权问题被跳过了。2.1 节讲「爆款AI漫剧,从选择合适的小说开始」,谈的是什么样的文本适合改编——有没有强冲突、有没有视觉化的场景、人物关系清不清楚。这些都是专业判断,但它没谈另一件更硬的事:改编别人的小说,授权怎么拿。漫剧这个行当里,素材来源的合法性是第一条红线,而书里对这条线的处理,基本是空白。
第五,语气是课堂语气,不是书面语气。「必须」「一定要」「千万不要」这类词密度很高,章节结尾还有「小结」。对刚从训练营出来的读者,这是熟悉的腔调;对只想安静读一本书的人,这种语气会让人觉得被推着走,而且有些断言缺少推导——它告诉你「必须尽早做三视图」,理由在上一段,但类似的地方并不总是给理由。
第六,对「AI 味」的处理不够。书里反复强调一致性、稳定性、可控性,这些都是工程指标。但漫剧是给人看的,观众对「AI 味」的容忍度在快速下降:画面太干净、光影太均匀、人物表情太标准,都会让人出戏。怎么在一套高度可控的流程里,故意留一点不完美,让它看起来像「人做的」,这件事书里没有讨论。而这可能是 2026 年之后这个行业真正的分水岭。
最后说它值不值得读。值得,而且我认为它的价值会随时间上升而不是下降——因为工具那部分会烂掉,工序那部分不会。
具体怎么读:第二、三、四章当教材精读,那是剧本、角色、分镜的老手艺,配着它的表格自己动手拆三部喜欢的短剧,收获最大;第五、六章当参考查阅,用到哪个工具翻哪一节,别指望它教你判断;第八章当范本看,看一部片子从文字走到成片,中间要过多少道手;第九章当行情读,但记住它只给了方向,没给数字。
回到它自己那句话:能决定作品上限的,是角色如何建立、场景如何服务叙事、分镜如何影响节奏、声音与画面如何共同决定观看体验。这四件事,1910 年代的动画师在琢磨,2026 年的 AI 创作者还在琢磨。工具换了一百轮,这四件事一次都没换过。这本书最大的价值,就是它没有假装这四件事可以被一键生成。
书名:AI漫剧创作一本通
作者:西羊石 秋叶
出版:人民邮电出版社 · 2026 年 4 月 · ISBN 9787115694522
读法:全书九章五十三节通读,含版权信息、前言
说明:文中引语、章节结构、分镜数据与参数写法均摘自原书;关于「工具比重压过承诺」「单案例掩盖返工」「缺授权与 AI 味讨论」的判断,是我读后所加,原书未作此论
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: