
Stable Diffusion-ComfyUI AI绘画工作流解析:它教你把线连对,没教你把图选对
《Stable Diffusion-ComfyUI AI绘画工作流解析》,王岩、赵馨璐著,清华大学出版社 2024 年 9 月版,ISBN 9787302671923。
内容简介里写得很老实:「本书从零开始,详尽系统地讲解从本地部署ComfyUI、下载安装自定义节点,到搭建各种工作流程的全过程。」注意「全过程」这三个字——它没说这本书教你怎么画得好,它说的是教你怎么把流程搭起来。
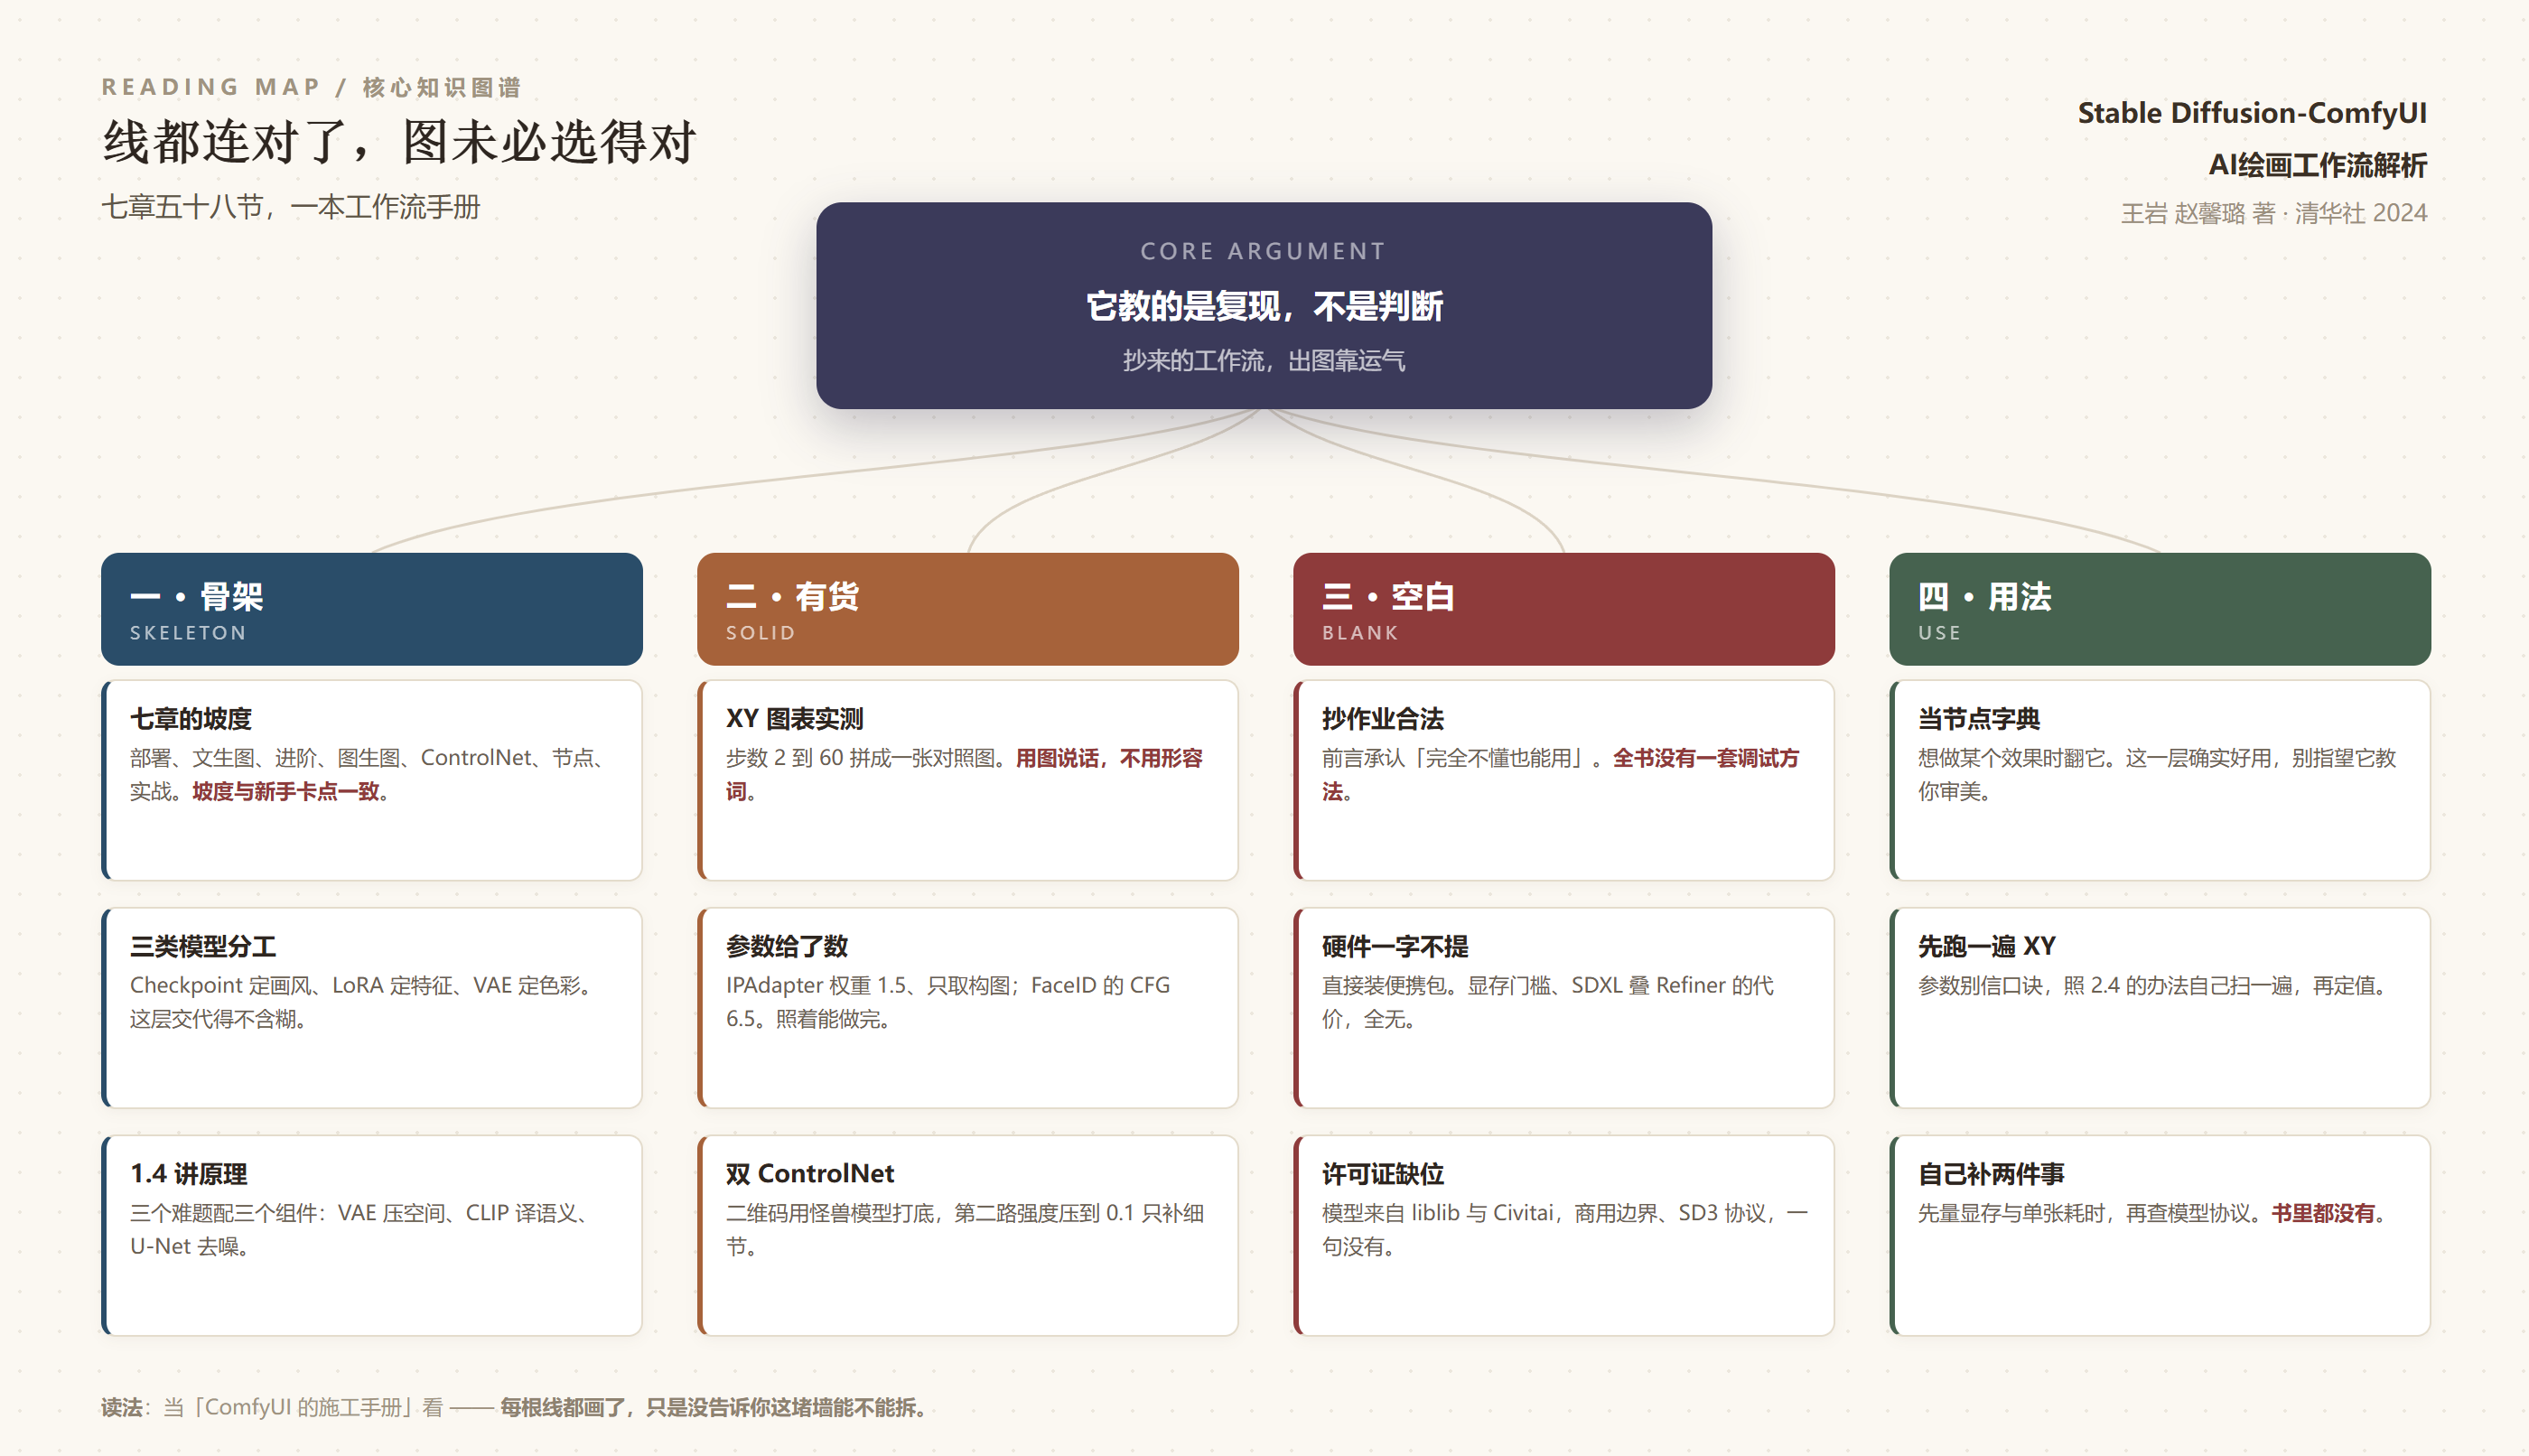
我读完之后的判断是:这句话它兑现了,而且兑现在水准之上;但「工作流」这三个字被它用窄了。工作流在 ComfyUI 里本来是一张可以被观察、被拆解、被归因的图,这本书却主要把它当成一张可以被复制的图。前者是工程,后者是手艺活的口口相传。
先把骨架摆出来:七章,五十八节。第一章装环境、认界面、讲原理;第二章从零搭一个文生图;第三章往上叠高清修复、面部修复、SDXL 加 Refiner、SD3;第四章转图生图、局部重绘、超分;第五章 ControlNet,姿势、细节、深度、一致性;第六章是一堆「最强」「最逼真」的自定义节点;第七章是七个实战——艺术二维码、手部修复、商务证件照、3D 转绘、换材质、电商海报。
这个坡度是对的。新手真正卡住的地方,不是不会调 CFG,而是装不上、跑不出第一张图、不知道为什么会弹「Prompt outputs failed validation」。这本书从报错截图开始讲,这一点比很多同类书清醒。
一、它教的是「复现」,而 ComfyUI 真正的价值在「归因」
前言的最后一段,把这本书的立场交代得非常清楚。它先说 ComfyUI 的可靠复现功能:「只需拖入工作流文件或一张生成的图片,就能还原所有节点体系和设置参数。这个功能不仅可以大幅提高工作效率、轻松复现生成结果,还意味着我们可以通过『抄作业』的方式调用别人创建的工作流。」
然后是最关键的一句:
网络上有数以万计的工作流资源,这些资源既是最好的学习资料,也是最方便的成品仓库。即使完全不懂这些工作流是如何运作的,也不妨碍我们直接使用它们来完成自己的工作。
我不认为这句话是错的。它甚至是诚实的——绝大多数人用 ComfyUI 就是这么用的,拖一个工作流文件进来,改改提示词,出图。作者没有假装这是一门需要先学三个月理论的学问,这一点值得肯定。
但这句话划定了这本书的天花板。因为它把「不懂也能用」当成了终点,而不是起点。ComfyUI 相对 WebUI 最大的结构性优势,其实不是复现,而是可见:一次生成被拆成十几个节点,每个节点都有中间产物——潜变量、条件、遮罩、解码后的图。这意味着当出图不对时,你可以停下来看是哪一环坏了:是 CLIP 没读懂你的词,还是 ControlNet 的强度压过了提示词,还是 VAE 解码时色彩偏了。WebUI 把这些全藏在一个「Generate」按钮后面,ComfyUI 把它们摊在画布上。
这本书几乎没用这个优势。它教你怎么把线连对,没教你怎么在连对之后判断哪根线出了问题。全书五十八节,没有一节叫「出图不对时怎么查」。
还有一层,「抄作业」这件事本身是有前提的,书里没讲。ComfyUI 的工作流文件里存的是什么?是节点类型、连接关系、以及每个节点的参数值。它不存模型权重,也不存你装的自定义节点。也就是说,你把别人的工作流拖进来,只要缺一个 checkpoint、缺一个 LoRA、缺一个自定义节点包,那张图就还原不出来——而还原不出来的表现通常不是一句「缺少模型」,是某个节点上亮一个红框,或者跑出来的图糊成一团。这个坑每个新手都会掉一次,而它属于「复现」这个承诺的核心条款,书里一个字没提。
顺带说一句,这本书对 WebUI 的评价很清醒。1.1 节列它的优点:「WebUI采用了常规软件的界面布局和控件类型,虽然初看略显简陋,但胜在直观明了,而且符合大多数人的操作习惯」「WebUI的最大优点是操作起来比较简单」,再加上「成熟的开关生态」和大量学习资料,新手门槛低。然后它才说:等你用过 ComfyUI,回头再看 WebUI,就会深刻感受到 WebUI 的简洁。
这段话的诚实之处在于,它承认了 ComfyUI 的门槛更高。而一旦承认门槛更高,这本书的写法就该跟着调整——门槛高,意味着必须补结构、补原理、补排查路径,而不能只补连线步骤。这一层它没有完全跟上。
二、全书最硬的一节,是那个被当成过场的 1.4
第 1.4 节「理解 Stable Diffusion 的工作原理」只有两页多,位置在装完节点、还没开始画图的地方,很容易被读者翻过去。但这是我在这本书里读到的最扎实的部分。
它的讲法很聪明:先提三个问题,再给三个组件。三个问题是——「如何在家用级别的计算机中装下几十亿甚至上百亿张图片」;「图片由大量像素点组成,每个像素又有红绿蓝三个分量,如果逐个像素进行计算,仅一张 512×512 像素的图片就需要计算 78 万次,这样庞大的算力资源从何而来」;「如何让程序理解文字,并生成符合语义描述的画面内容」。
然后是三个答案。第一个是自动编码器,编码器把图片压进潜空间,「经过 40 倍的压缩后,图片的体积变得非常小,从而解决存储问题」,解码器再把潜变量还原成图。第二个是 CLIP 文本编码器,书里写它「从互联网上抓取了 4 亿张图片以及描述图片内容的文本,分别提取文本和图像的特征后进行对比学习。文本和图像特征匹配的作为正样本,不匹配的作为负样本」。
这两段的分量,在于它们都对,而且没有为了通俗而说错。很多同类书会把 CLIP 说成「一个翻译器,把中文翻成机器能懂的话」,那是错的——CLIP 不是翻译,它建的是一个共享的语义空间,文本和图像被投到同一个坐标系里,距离近就代表语义近。这本书说的是「对比学习、正负样本」,这是准确的说法。
图 1-27 那张可视化也做对了:从左到右是「像素空间」「(正向扩散)」「潜空间」,图片一格比一格糊、一格比一格小。这一张图解释了为什么光算 78 万次还不够、还得先压缩——因为压缩之后算的不是像素,是特征。
批评也在这里。这一节之后,全书再没有回到原理。而后面所有的「为什么」其实都藏在这一节里:为什么 SDXL 默认要 1024 而不是 512(潜空间分辨率的整数倍约束)、为什么 Refiner 只在最后几步接手(它处理的是高频细节,而高频是在去噪后段才出现的)、为什么 SD3 要三个文本编码器而不是一个(T5 管长句语义,CLIP 管风格与美学,分工不同)。这些内容书里都出现了,但都是以「你照这样连」的方式出现的,不是以「因为这样所以这样」的方式。
一本四百八十页的书,把原理压成两页,然后花四百七十页讲连线——这是取舍,不是失误。但取舍有代价:读者只能在「照做」这一层活动,往上那一层永远进不去。
三、2.4 那两页,教的是「怎么打自己的脸」
全书唯一一处教方法论的地方,是 2.4 节讲 K 采样器参数时的那个用法:XY 图表。
做法是这样的——在「手动输入」节点的下拉菜单里选 Steps,在文本框里输入要测试的采样步数,「步数之间用分号隔开」,然后按 Ctrl+Enter 运行,脚本会按照输入的步数分别生成图片,最后把所有图片拼到一起。书上给的对照图是 2、4、6、8、10、20、30、40、50、60 十个步数排成两行:2 步是一团模糊的色块,6 步开始有五官,10 步能看清发丝,20 步之后差别变得很小,40 步往上几乎是重复。
这个方法的正式名字叫控制变量,本身不新鲜。但把它写进一本 AI 绘画书里,并且真的配了十张对照图,这件事是有分量的——它等于在告诉读者:参数没有正确答案,只有你自己扫出来的答案。这句话比任何「步数建议 20 到 30」的口诀都值钱。
可惜它停在了方法这一层。它没告诉你这个测试的成本——十张图就是十倍时间,如果你的机器一张要四十秒,这一轮就是七分钟;它也没告诉你该看什么:结构对不对、细节够不够、手指有没有崩、色彩有没有偏;更没有给一个「扫到多少算够」的经验值。方法给了,判据没给。
这个缺口贯穿全书。2.1 节讲提示词权重时也一样:它说「每个词组的默认权重值为 1,书写与顺序越靠前的提示词权重值越高」,然后示范把「masterpiece,bestquality,reality」的权重设成 1.2,得出「第二张图片中的细节开始增加,照明的层次感也有所改善」。这是一个可复现的操作,但「细节增加」到什么程度算改善、「照明层次感」是怎么看出来的,仍然留在读者眼睛里。
更明显的断裂在第五章和第七章。这两章里,ControlNet 的强度全是直接给的定值:二维码第二路 0.1、tile 修复 0.60、3D 转绘 0.60。这些数字当然是对的,但它们是作者那台机器、那套图、那个风格下的最优解。换一张图、换一个模型,0.60 可能就太重了——ControlNet 强度一高,生成结果会被参考图锁死,出图就是描红。这个「太重会怎样、太轻会怎样」的区间,本来是 XY 图表最擅长的事,结果全书只在 2.4 用过一次。
方法只在第二章出现,后面六章全退回「照我给的数填」。这不是作者不懂,更像是赶进度:扫参数要跑图、要花时间,而给一个定值只要一行字。
四、凡是给了具体数字的地方,是真的可以照抄
这本书最可信的部分,是那些把参数写到小数点的地方。我挑几处记下来,因为它们确实是能直接用的工程经验。
6.2 节讲风格迁移,用 IPAdapter 只取构图:在「应用IPAdapter(高级)」节点里把权重设为 1.5,「嵌入组缩放」选 K+V,「权重类型」选 composition,然后书里给了一句解释——「IPAdapter将只传输参考图上的构图信息,其他内容完全由提示词和大模型控制」。这句解释是对的,也是这套参数组合存在的理由。
6.3 节讲换脸,用的是 IPAdapter FaceID:Checkpoint 接 IPAdapterFaceID 加载器,再接应用节点,最后进 K 采样器;选一个 SDXL 大模型,CFG 设为 6.5,「输入组缩放」选 V only。它还补了一句实操经验——换成卡通风格的大模型,同样可以很好地还原参考图上的人脸特征。
6.4 节讲直接生成透明图层,用 LayerDiffusion:K 采样器出来接 VAE 解码,再接 LayerDiffusion 解码(RGBA),最后保存图像。参数是步数 12、CFG 2.0、dpmpp_2m、karras。更难得的是它主动标了限制:「LayerDiffusion目前只能使用SDXL大模型,生成图像的尺寸必须设置成1024×1024像素。」
7.1 节的艺术二维码,是我认为全书设计得最巧的一个流程:先用 QR Code Generator 节点生成二维码(size 1024、qr_version 1、error_correction Q、box_size 10、border 4),接一路 ControlNet,模型选 control_v1p_sd15_qrcode_monster;然后复制一个「ControlNet应用」节点,把两个节点的「条件」端口串起来,把第二个的强度压到 0.1。两路 ControlNet 串接、第二路只用极低强度补细节——这个手法在别处很少见有人写清楚。
7.2 节的手部修复是同一思路:Tile 平铺预处理器,迭代次数 1,分辨率 512,ControlNet 用 control_v11f1e_sd15_tile,强度 0.60,步数 20、CFG 8.0。7.4 节的 3D 转绘则给了一套更细的数:潜变量按系数缩放、缩放方法 nearest-exact、系数 2.00,ControlNet 换成 TTPLANET 的 tile 模型,强度 0.60,最后一段采样步数压到 10、CFG 1.0、euler_ancestral、降噪 0.70。
这些数字的共同点是:它们不是从文档里抄的默认值,而是试出来的。降噪 0.70、CFG 1.0 这种组合,只有真的跑过几十遍才会定下来。这部分内容,是这本书区别于攒稿书的地方。
五、但它从头到尾默许你「抄作业」
2.2 节讲「用中文输入提示词」,给了三种方式。第一种是在 ComfyUI 里装翻译节点;第二种是打开提示词网站,比如 promlib.com,「该网站已经把常用的提示词分类放置到不同的标签中,我们可以按照质量画风+主体描述+环境构图的三段式结构,依次单击预览图,选择所需的提示词,最后单击右下角的『复制提示词』按钮」;第三种是去 liblib 这类模型站,直接抄别人作品下面的提示词。
三种里有一种是「让机器理解中文」,两种是「去别人那里拿英文」。这个比例很说明问题:所谓中文输入,本质上还是绕道——你要么让一个翻译模型替你翻(翻完还得自己校对),要么直接拿别人验证过的英文串。
抄本身不是问题。问题是抄完之后没有退路。当一张图不对时,你需要判断的是:模型选错了吗?提示词里哪个词在捣乱?采样器不适合这个风格吗?ControlNet 的强度压过提示词了吗?VAE 让颜色发灰了吗?这是五个不同方向的排查,而 ComfyUI 恰好能让你一个一个关掉去试——把 ControlNet 旁路、把 VAE 换回默认、把 CFG 拉到 3 看还糊不糊。这套动作,才是「工作流」这三个字真正的意思。
这本书有五十八节,教了上百种连线方式,却没有一页是「故障—原因」对照表。而这恰恰是工作流手册最该有的附录:不是告诉你正确怎么连,而是告诉你错了会怎样、从哪一节开始查。
还有一件事值得说。当「抄提示词」成为标准动作,结果就是同一批词被反复使用:masterpiece、best quality、8k、ultra detailed,这套词在 liblib 和 Civitai 上被抄了几十万次,于是几十万张图的色调、光比、皮肤质感开始趋同。这不是审美问题,是采样问题——当所有人都把模型推向同一个高分区,模型的输出分布就窄了。书里教了怎么抄,没提抄的代价。
六、它一次都没问,你这台机器顶不顶得住
1.2 节「部署和运行ComfyUI」直接从便携包开始:解压、双击、等命令行加载完、自动打开网页。然后进入界面介绍——右侧设置面板可以最小化,Settings 里 Color palette 能改配色,Link Render Mode 能改连线样式,Grid.Size 调网格大小,空格键拖动画布。
这些都是真的,也都该讲。但整整一节,没有出现过「显存」两个字。
这件事的别扭之处在于,1.4 节自己提出了那个问题:「如何在家用级别的计算机中装下几十亿甚至上百亿张图片」。它给的答案是算法层面的——潜空间压缩 40 倍。但读者真正撞上的墙是硬件层面的:我的 8G 显存能不能跑 SDXL?跑 SDXL 加 Refiner 会不会爆?SD3 的 medium 模型 4GB,还要另外加载 clip_g、clip_l、t5xxl 三个文本编码器,这三个文件加起来又是几个 GB——它们同时驻留显存,8G 够吗?
3.8 节讲 SD3 的那一页,其实把这件事说了一半:它告诉你「如果下载的是4GB的sd3_medium模型,还需要把 text encoders 中的三个文件放入 ComfyUI\models\clip 文件夹中」,还列了文件名——clip_g.safetensors、clip_l.safetensors、t5xxl_fp8_e4m3fn.safetensors。这三个名字摆在这里,懂行的人立刻知道显存压力在哪;不懂行的人只会照着放,然后看着进度条卡在 0%。
一本从零开始的书,把「装不下」这个问题在原理层面回答了,却在操作层面绕过去了。这是它最实质的一个缺口,因为它是读者第一天就会遇到的、最容易劝退的那堵墙。
七、它也没提许可证,而它教的活儿全是商用场景
模型从哪来?书里写得很直白:「登录一个模型下载网站,这里以 https://www.liblib.art 为例。」然后在 2.2 节,又出现了 promlib.com。这两个站都是国内常用的模型与提示词社区,模型大多由用户上传,各自带不同的授权条款。
而这本书教的东西,全部指向商业交付:7.3 商务证件照、7.6 电商商品海报、7.5 任意转换对象的材质、7.1 艺术二维码(书里的例子是给百度做的)、7.4 一键转绘 3D 形象。
全书四百八十页,没有一句话讨论「这个模型能不能商用」。没有提 Civitai 上每个模型都标着 permission 字段,没提 SD3 有自己的 Stability AI Community License(年收入超过一百万美元要另买商业授权),也没提 LoRA 的训练者常常在说明里写「禁止商用」。
更重的地方在 6.3 节。换脸那一节,从加载器到 CFG 6.5 到「换成卡通风格大模型也能还原面部特征」,技术讲得干净利落,十几页里没有一句关于肖像权、授权、同意的提醒。7.3 节的商务证件照同理——证件照是有明确规范甚至法律属性的东西,用生成模型做出来,边界在哪,书里一个字没有。
其实这件事不难补。哪怕只加一页:「每个模型的文件名旁边,记一下来源链接和许可类型;工作流文件里加一行备注,写清这张图用了哪些模型;交稿前确认三件事——模型能不能商用、肖像有没有授权、内容要不要标注为生成。」三行字,能救很多人。它没写。
我不认为作者不知道。更可能的解释是:这类书默认读者是设计师、美工、电商运营,默认他们在「做图」而不是「做合规」。但一本 2024 年 9 月出版的书,深度合成标识义务、生成内容合规都已经落地,这个空白就不再是体例问题,而是取向问题——它把工具的能力讲满了,把工具的边界讲没了。
八、它的短板
第一,版本脆弱性没有任何防御。书里的路径写成 ComfyUI\models\checkpoints、ComfyUI\models\clip,节点名写成「应用IPAdapter(高级)」「三CLIP加载器」「LayerDiffusion解码(RGBA)」——这些全是中文界面的显示文案。ComfyUI 前端迭代很快,一个节点的译名改一个字,读者按书里的名字在搜索框里就找不到。书里没有版本号,没有 commit,工作流文件也没提校验方式。一本工具书的半衰期,往往就死在这里。
第二,标题的确定性超过了正文的确定性。7.2 叫「完美手部修复工作流」,正文却写着「只要手部变形不是特别严重,就能一次性得到完美的修复效果」——条件在前,绝对在后。6.3 叫「最逼真的换脸效果」,而换脸效果的瓶颈根本不在这一节的参数上,在参考图质量和模型对脸型的先验上。这种标题在营销上有效,在工程上会误导:读者会以为照着做完就该得到书里那张图,得不到就以为自己哪步错了,然后开始瞎调参数。
第三,没有失败案例,一张都没有。全书四百八十张截图,全是成功的结果。没有「这里我试了五次」「这个模型和这个采样器不兼容,出来全是噪点」「这个节点更新后参数位置变了」。而这些恰恰是实操里百分之八十时间花在的地方。一本教人搭流程的书,只展示终点,不展示岔路,读者就只能把岔路当成自己笨。
第四,图文比例失衡到影响阅读。很多页面是「一张界面截图 + 一段『如图X所示』」。截图确实必要——节点图不用图讲不清。但当连续十页都是「连接 A 到 B,如图 3-41 所示」「再连接 C,如图 3-42 所示」,文字就退化成了图的索引,读者其实是在看图猜流程。真正该用文字补的那部分——为什么这样接、不这样接会怎样——被省掉了。
第五,缺一条从工作流回到审美的线。整本书解决的是「怎么把图生成出来」,从没处理「哪张图该留」。而 AI 绘画真正的成本不在生成,在筛选:一次出四张,四十次出一百六十张,你得在一百六十张里挑一张。这个动作需要判断力,判断力来自看过的图和想清楚的目的。书里没教,也没说自己不教。
第六,中文输入这条线是虚的。2.2 号称教「用中文输入提示词」,实际给的三条路,两条是去英文社区抄,一条是装翻译节点。翻译这条路,书里也没讲清楚损耗在哪——CLIP 是在英文语料上训练的,中文经翻译再进 CLIP,等于隔了一层;而 SD3 换用 T5 之后对长句的解析能力变强,翻译损耗的表现又不一样。这些差异,一本 2024 年的书本该讲到。
最后说回它值不值得读。值得,但要把预期放对位置:把它当字典,不要当教材。你想实现某个具体效果——只取构图、换个脸、抠个透明底、做个能扫的二维码——翻到对应那一节,参数是现成的、能跑的,这一层它做得比大多数同类书扎实。但你想知道为什么这么连、错了怎么查、做完能不能商用,它一句都没答。
ComfyUI 让人第一眼想放弃、用一阵子离不开——前言这句自嘲说得很准。这本书也一样:它确实能把你从「装不上」带到「出得来图」,然后它就停在那里,把从「出得来」到「出得对」的那段路,留给你自己走。
书名:Stable Diffusion-ComfyUI AI绘画工作流解析
作者:王岩 赵馨璐
出版:清华大学出版社 · 2024 年 9 月 · ISBN 9787302671923
读法:全书七章五十八节通读,含版权信息、内容简介、前言
说明:文中引语、节点名、参数值与章节结构均摘自原书;关于「教复现而非教归因」「缺硬件门槛」「缺许可证与伦理边界」的判断,是我读后所加,原书未作此论
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: