
PyTorch计算机视觉实战:它教你把模型跑通,没教你把模型跑对
《PyTorch计算机视觉实战:目标检测、图像处理与大模型(原书第2版)》,[印] V·基肖尔·阿耶德瓦拉、[印] 耶什万斯·雷迪著,机械工业出版社 2025 年 12 月版。英文原版是 Packt 2024 年的《Modern Computer Vision with PyTorch, Second Edition》。
这本书很厚,四部分十八章。第一章从一个人工神经元讲起,第十八章把模型塞进一个服务里。中间这一段路,它走得很稳:感知机、反向传播、PyTorch 张量、超参数、卷积、迁移学习、目标检测、图像分割、自编码器、GAN、强化学习、注意力、CLIP、稳定扩散、部署。
读完之后我想了很久该给它一个什么判断。技术上是干净的,态度上是认真的,每一章末尾还有小结和习题,这在同类书里已经算罕见了。但它有一个贯穿全局的选择,我不认同:它把「跑通」当成了终点。
这本书的每一个例子,最后一行代码都是画一张图,或者打印一条 loss 曲线。图画出来了,loss 降下去了,这一节就结束了。至于这个模型在别人的数据上会不会崩、推理一次要多少毫秒、换个光照条件还认不认得,全书基本不问。
这个选择不能算错。它让这本书变成了一本极好的入门书——你能在这里第一次看见计算机视觉的全貌,而且每一块都能亲手跑起来。但如果有人抱着「学完能干活」的期待买它,会失望。下面我把这个判断拆开讲。
一、它到底摊开了多大一片
先给它的野心记一笔。四部分,十八章,我按目录过一遍。
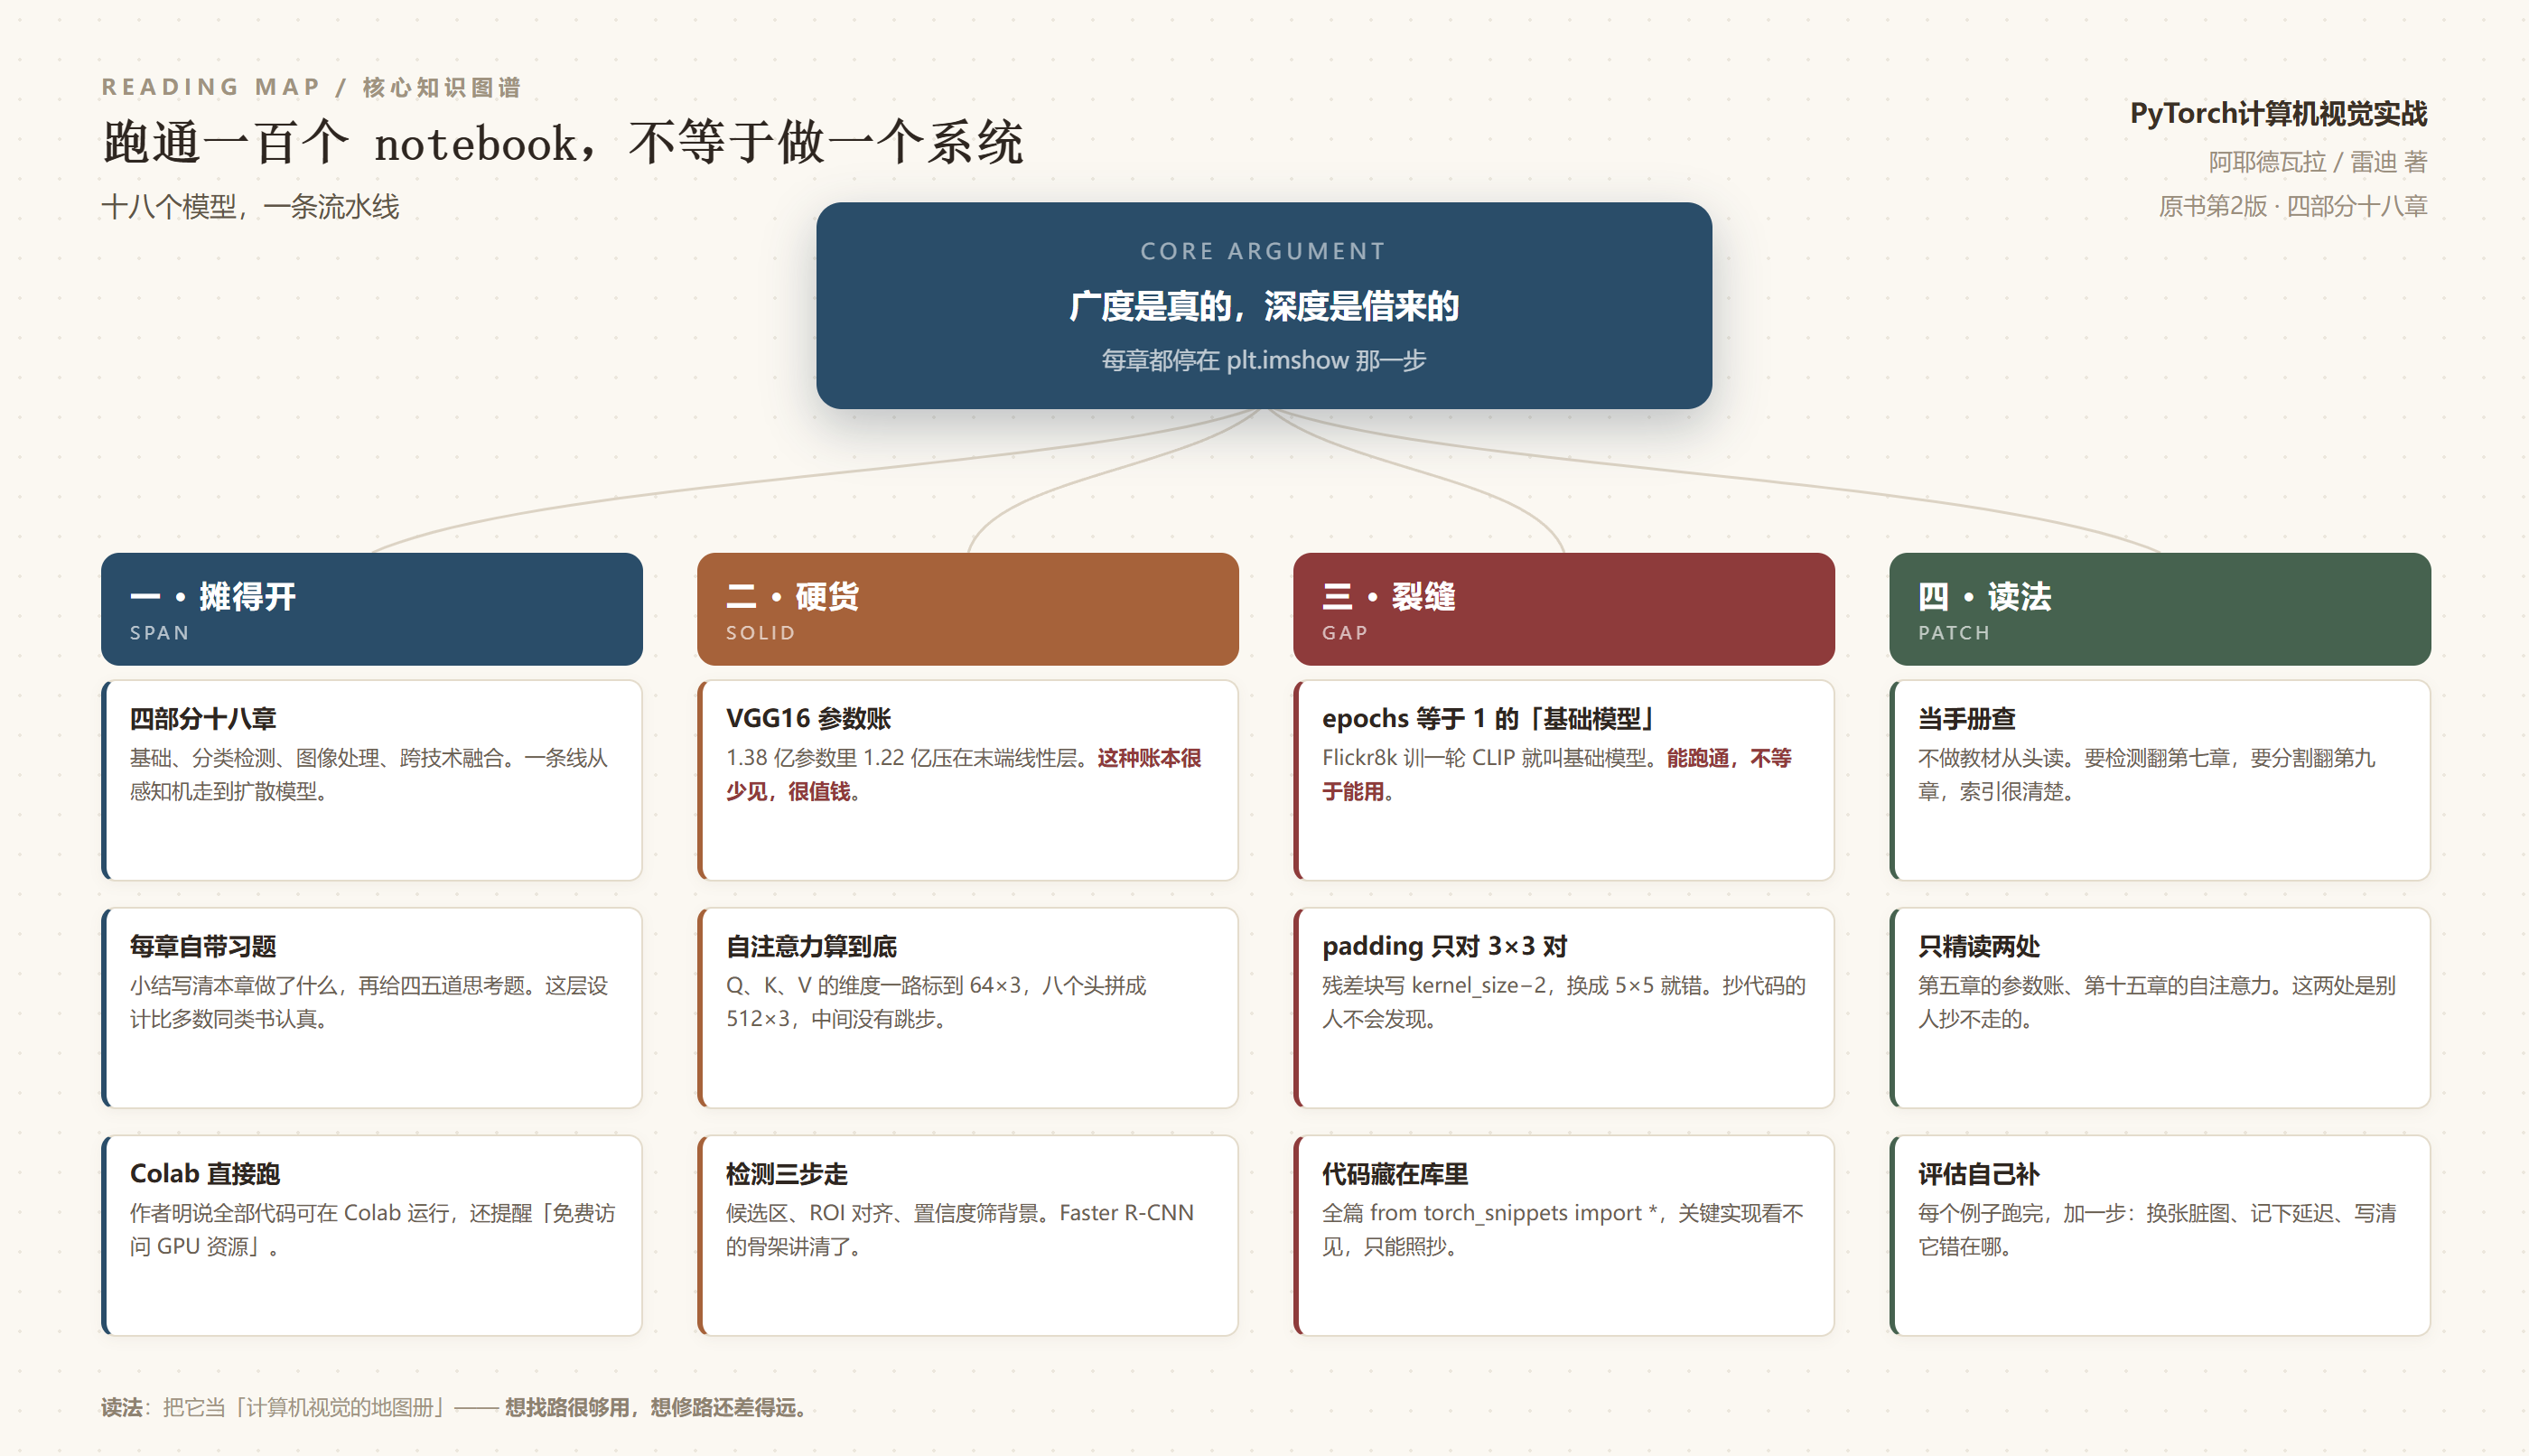
第一部分讲基础。第一章人工神经网络,从一个单神经元、九个权重讲起,讲清前向传播和反向传播怎么把误差分回去;第二章 PyTorch,张量的创建、运算、变形、GPU 搬运,用一个极小的数据集把「定义类、定义损失、定义优化器、写训练循环」这套流程走一遍;第三章拿超参数开刀,学习率、批大小、隐藏层节点数,一个个试给你看它们怎么影响精度。
第二部分讲分类与检测。第四章卷积神经网络导论,讲清为什么全连接层处理不了图像;第五章迁移学习,用 VGG16 做图像分类;第六章是分类的实际应用;第七章物体检测基础,候选区域、ROI、非极大值抑制;第八章高级检测,Faster R-CNN 那一套;第九章图像分割;第十章检测与分割的应用。
第三部分讲生成。第十一章自编码器,第十二章 GAN,第十三章高级 GAN。
第四部分讲融合。第十四章把计算机视觉和强化学习接起来,第十五章把它和自然语言处理接起来,讲自注意力、讲图文匹配、讲图像描述生成;第十六章讲基础模型,直接上手训 CLIP;第十七章讲稳定扩散的图像修复;第十八章讲部署,把模型包成一个服务。
这个目录的价值在于「全」是真的全。市面上的 PyTorch 视觉书,多数写到检测就收尾了,扩散模型和部署要么另买一本,要么自己找博客。这本书把它们塞进同一本,而且用的是同一套代码风格、同一个数据读取范式。对初学者来说,这意味着你不用在五种不同的项目结构之间反复重新学怎么读代码。
但「全」也有代价。十八章摊在有限的篇幅里,每一章都只能是「够用」的深度。它不讲清楚为什么 VGG 之后大家转去 ResNet,不讲清楚 YOLO 那一系和两阶段检测的根本分歧在哪,不讲清楚扩散模型的反向过程为什么能收敛。它讲的是「这个东西怎么用」,不是「这个东西为什么长这样」。
所以我把它定性为地图册:这一行有哪些地方它标得很清楚,路径也画了,但每一处风景都没细看。
二、这本书有两处真功夫
说完整体印象,得说两处我认为别人抄不走的地方。这两处都不长,但都是硬功夫。
第一处是第五章对 VGG16 的参数拆账。它没有停在「VGG16 有一亿多参数,比较大」这种话上,它把账算给你看:
在这个网络中大约有1.38亿个参数,其中大约有1.22亿个参数来自网络末端的线性层(1.02亿个参数+1600万个参数+400万个参数)。网络结构包含13个卷积层或池化层,其中滤波器数量逐层增加,以及3个线性层。
这段话很短,但它回答了一个初学者最容易懵的问题:卷积网络不是号称「参数共享、比全连接省」吗,怎么 VGG16 还是一亿多参数?答案就在这个拆账里——省下来的是卷积层,钱全花在最后那三层全连接上了。1.02 亿加 1600 万加 400 万,占了总量的百分之八十八。这也顺带解释了为什么后来的网络都在砍最后的全连接层,改成全局平均池化。
一个数字拆开,整条网络演进史的逻辑就露出来了。这种写法比讲十页「模型越深越好」有用。
第二处是第十五章对自注意力的推导。这本书在这里罕见地没有跳步。它把 Q、K、V 三个矩阵的维度一路标到底:V_w 是 64×3,K_w 转置乘 Q_w 得 3×3,Softmax 之后乘回去得 64×3。然后说这一层用了八个头,八个 64×3 拼起来是 512×3。
接着,我们用连接层(图15.2中的步骤3)组合这个步骤中的8个输出,最终得到一个大小为512×3的张量。因为这层有8个头(即8个Q矩阵、K矩阵和V矩阵),所以这层也称为多头自注意力。
很多书讲注意力,画一张漂亮的三箭头图,写一行公式,然后就过去了。读者以为自己懂了,其实不知道维度是怎么对齐的、为什么要除以根号 d、八个头拼起来为什么是 512 而不是 8 个 64。这本书把维度标出来了,这一步很笨,但很有效。
它还有一句解释多头的话,我觉得比大多数教材说得直白:在搜索「马」这类物体时,查询会包含「搜索体积较大且通常呈棕色、黑色或白色等信息的一个物体」。也就是说,不同的头可以各自盯住一种特征——一个盯体积,一个盯毛色。这句话把「多头」从抽象名词还原成了一个具体的分工。
三、它把「跑通」拆到了骨头里
这本书的教学法非常统一,统一到你读三章就能预测下一页长什么样。
每一节都是编号列表。第一步做什么,第二步做什么,代码贴在每一步下面,代码里带中文注释,跑完告诉你输出是什么样。举个最典型的例子,训练一个模型这件事,它拆成了八步:
iii)定义训练周期数;iv)初始化列表,这些列表包含了一个训练周期内每个批处理对应的准确率和损失值;v)通过遍历 DataLoader 创建训练数据的批处理;vi)使用 train_batch 函数训练批处理,并在训练结束时将损失值作为 batch_loss 保存到批处理的顶部;vii)存储一个训练周期内所有批处理的平均损失值;viii)接下来,计算训练结束时所有批处理的预测准确率。
细到 for epoch in range(5): print(epoch) 这种空循环都要单独占一步。第一次看会觉得啰嗦,看多了会明白它的用意:它假设读者的 Python 水平只到「能看懂 for 循环」,所以任何一步都不省略。
配套的还有三件事,我认为是这本书真正体贴的地方。
一是环境。前言里直接把安装命令写成一行 conda install pytorch torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia,还告诉你验证方法就是 import torch 加 print(torch.__version__)。然后补一句:
本书所有代码都可以在谷歌Colab(https://colab.research.google.com/)上运行。谷歌Colab默认支持Python和PyTorch。我们强烈建议读者在Colab上执行所有代码 —— 包括免费访问GPU资源!
这句话的价值被低估了。计算机视觉书最大的劝退点不是数学,是「我没有显卡」。它一开头就把这个门槛拆了。
二是每章末尾的习题。题目不难,但问得很准。「在训练期间,为什么需要将整数输入转换为浮点数?」这种题目,你不真正跑过一遍、不真正被 dtype 报错卡过一次,是答不出来的。它逼你把「照抄」变成「理解」。
三是代码的组织方式。它不给你一个黑箱项目,它让你自己写 Dataset 类,自己实现 __len__ 和 __getitem__,自己决定要不要用 collate_fn。写一遍,你就知道 DataLoader 内部在干什么了。
这三件事加起来,让这本书在「教人跑通」这件事上确实做到了位。我甚至觉得,如果只允许推荐一本给完全零基础的人,它比很多号称「实战」的书靠谱。
四、可是「跑通」和「跑对」不是一回事
问题从这里开始。
因为这本书默认「代码没报错、图出来了、loss 降了」就是成功,所以它在一些关键地方留下了不致命的错。这些错不会让你跑不起来,只会让你在真实项目里跑出错误的结果——而且你发现不了。
举第一个例子。第五章讲残差块,它给的代码先算了一个填充量,然后拿它去初始化卷积层,代码注释里写着「我们将填充定义为卷积后的输出维度。如果将二者相加,那么输入的维度应该保持不变」。
那个填充量的写法是 kernel_size - 2。
这个式子在 kernel_size=3 的时候算出来是 1,对的,因为 3×3 卷积保持尺寸需要 padding 1。但你要是按自己的需要改成 5×5,它算出 3,而 5×5 卷积保持尺寸需要的是 2。这一步错了,残差相加时维度就对不上,代码会在把输入和卷积输出相加的那一行崩掉。
崩掉还好,至少你知道错了。更麻烦的是那些不崩的错。
第二个例子,第六章分类器里的卷积块:Dropout 放在卷积之前,BatchNorm 被注释掉了。然后书里加了一句提示,大意是「在使用批量归一化场景测试模型时,请取消注释上述代码中带有对应定义的那一行」。
这句话的意思是:默认代码里 BN 是关着的,想用请自己改源码。而 Dropout 放在卷积前,等于在输入通道上随机丢特征——对一个三通道的彩色图来说,丢掉一个通道就是丢掉一种颜色。这不是标准做法,标准做法是 conv 之后接 BN 再接激活,Dropout 通常放在全连接层或残差分支末端。
这类地方,书里没有任何说明。读者照着敲,跑出来的模型精度低一点,他会以为自己数据不行、调参不够、显卡太差。他不会想到是那一行的顺序。
第三个例子,数据读取。第四章处理图像增强,用的是 imgaug 这个库,然后用 glob 手写遍历文件夹,自己拼 Dataset。这套写法在 2019 年是主流,但它有两个问题:imgaug 这些年基本停更,新项目里更常见的是 torchvision 自带的新版变换或 albumentations;手写 glob 遍历则绕过了 ImageFolder,把「目录结构就是标签」这个约定丢掉了,读者换到真实数据集上还得重写一遍加载逻辑。
第四个例子,第七章做 Faster R-CNN 推理,前处理只做了一步:把像素值除以 255,缩到 0 到 1。而 torchvision 的预训练检测模型要的是按 ImageNet 均值方差归一化过的张量。这个差别在图上完全看不出来——框还是会画出来,只是位置和置信度会偏。书里没有提醒这一层。
还有一处更隐蔽的,第十章做人行检测,过滤标注的代码是在类别编号里查一个特定值,不是那个值就跳过。那个数字是写死的,对应那个特定数据集里「人」这个类别的编号。你换成自己的数据集,类别编号变了,这行代码会静默地把你的数据全过滤掉,然后告诉你「没有检测到目标」。
我知道会有人说:这些都是细节,读者自己应该懂。可这本书的定位就是「读者还不懂」,它一章一章地手把手教你写空循环,却又在有坑的地方沉默。教得越细,沉默的地方越危险——因为读者已经习惯了「照书敲就不会错」。
五、训一轮就叫「基础模型」的那一章
如果说前面那些是细节,那这一节说的是方向问题。
第十六章标题叫「计算机视觉中的基础模型」。这是全书最跟得上时代的一章,讲 CLIP——那个把图像和文字映射到同一个向量空间的模型。讲它的对比学习目标,讲它的零样本分类能力。这些都对。
然后它带你训一个。用 Flickr8k 数据集,八万张图配五句描述,写一个配置类,设置参数。关键在这里:配置里训练周期那一项,值被设成了 1。
一轮。
紧接着书里说,建议读者仔细阅读代码仓库里的完整配置类,深入理解各个参数——两个编码器的学习率、训练周期、后端模型名称、图像和文本嵌入、文本的最大序列长度、投影层的维度。然后补一句:「目前,我们只需指定正确的数据集路径并设置训练周期数。」
这段话把这本书的方法论暴露得很清楚:参数很多,但你不用懂,设个路径跑起来就行。
问题在于,CLIP 之所以是「基础模型」,靠的不是那个对比学习的损失函数——那个损失函数两页纸就能讲完——靠的是四亿个图文对。用八万对、训一轮,你能得到的是一个「形状正确」的 CLIP:代码能跑,loss 在降,模型存下来了,接口能调。但它的零样本能力几乎为零,因为零样本能力是从数据规模里长出来的,不是从结构里长出来的。
这不是吹毛求疵。这是全章的核心误解:它把「基础模型」讲成了一个架构,而基础模型的本质是规模。你可以用两百行代码复现 CLIP 的结构,但你复现不了它的训练。这个区别,恰恰是 2020 年以后整个 AI 行业最重要的一条分界线——一边是「会搭结构的人」,一边是「有算力和数据的人」,前者多如牛毛,后者屈指可数。
书里没有讲这条线。它让你训了一轮,看了 loss 曲线,然后翻页去讲稳定扩散。
我能猜到作者为什么这么写。教材要保证「读者能在自己的笔记本上跑完」,而真正的预训练需要几千块显卡跑几个月。妥协是必然的。但妥协有两种写法:一种是老老实实说「这一段我们只验证结构,它不可能具备真实能力,因为数据量差四个数量级」;另一种是把玩具说成模型,让读者带着错觉走。这本书选了后一种。这个选择不影响它作为入门书的价值,但会影响读者对「AI 能力从哪来」这件事的理解——而那恰恰是这一行最该建立的一个常识。
六、代码藏在一个辅助库里
还有一个结构性的问题,值得单独说。
这本书的代码几乎每一段开头都要从同一个辅助库里导入一切——那是作者自己维护的一个工具库,显示图片、读取文件、画多子图、生成报告,全在里面。用它写书很省事:一行就能显示图,不用占半页写绘图代码。
但对读者来说,这意味着关键实现被藏起来了。
比如第七章做检测推理,一行拿到候选区域,这个函数在库里面。读者看到的是「有候选区域了」,看不到的是选择性搜索怎么工作——而选择性搜索恰恰是两阶段检测的第一块基石。书里讲了原理,但原理和那一行代码之间是断的。
第十八章部署那章更明显。它让你写两个文件:一个装模型类和预测方法,一个起服务。书里说得很直白:某个文件夹「是空的,仅用来存放上传的文件」,并且「我们假设训练模型的权重」已经存在。然后开始讲预测方法里怎么做前处理、怎么后处理。
到这儿就结束了。一个能接收图片、返回预测的接口,这是「演示」,不是「生产」。生产要面对的是并发、是显存、是冷启动、是模型版本、是输入校验、是超时重试、是指标监控。这一串词,书里一个没有。
我理解这是篇幅所限。但既然章名叫「模型部署到生产环境」,读者就有理由期待它至少点出这些问题存在。
七、翻译留下的痕迹
最后说一件读起来不断被绊的事。
这本书的中文版读起来有两类痕迹。一类是术语的,一类是句子的。
术语上,第四章讲数据增强做平移,原文大意是「多次平移(滚动/滑动)图像,每次 1 个像素,从左向左平移 5 个像素到向右平移 5 个像素」。一个括号里塞了三个词解释同一个动作,说明译者拿不准该用哪个。后半句「从左向左平移 5 个像素到向右平移 5 个像素」更是语病,读三遍才猜出原意是「从向左 5 像素扫到向右 5 像素」。
分类名字上,Fashion-MNIST 的十个类直接给了「Trouser(裤子)」「Pullover(套头衫)」这种中英并列的写法。这本身没错,但在正文叙述里反复出现,读起来像在读词汇表。
句子上,有些地方保留了英文的语序和从句结构。比如第二章讲保存模型的注意事项:「torch.save(model)也会保存Python类。PyTorch/Python版本在加载期间发生变化时,就会产生问题。」第二句的主语和谓语被拆开了,中文读者得自己把「版本变化」和「产生问题」接起来。
这些都是小毛病,单独看都不影响理解。但它们密集出现的时候,会产生一种效果:你在读一本技术书,却不断被提醒「这是译作」。技术书最理想的状态是让你忘掉语言,只剩内容。这一本没做到。
八、它的短板
把前面散着说的话收一收,这本书的短板有四条,我按严重程度排。
第一条,也是最重要的一条:全书没有一章讲评估。四部分十八章,目录里没有「数据」这一章,也没有「评估」这一章。mAP、IoU、混淆矩阵、召回率与精确率的取舍、离线指标和线上指标的差距——这些做视觉项目真正决定成败的东西,散在各章里提一句就过去了。这导致一个后果:读者学完十八章,会训模型,不会判断模型好不好。
第二条,所有例子都是独立项目,没有一条贯穿的主线。第一章的数据集、第五章的 VGG16、第七章的检测、第十六章的 CLIP,彼此没有关系。真实的项目恰恰相反:数据要清洗、要版本化、要增量更新;模型要能回滚;线上出问题要能复现。这本书教的是十八座孤岛。
第三条,技术栈偏旧,且没有交代。imgaug、手写 glob 遍历、model.h5 这种 Keras 时代的命名习惯、还有那些 2019 年写成的代码结构。原版是 2024 年的第二版,但这些代码显然没有全面翻新。对一本 2025 年底出版的中文版来说,这是个硬伤——读者照着敲,会在装包这一步就撞墙。
第四条,也是最微妙的一条:它不告诉你什么时候不该用深度学习。整本书的隐含前提是「所有视觉问题都该用神经网络解」。可现实里,工业质检的很多缺陷检测用模板匹配加阈值就够了,跑得还快十倍;文档矫正用四个角点做透视变换,比训一个分割模型省事得多。一个只教你怎么上模型的作者,欠读者一句「这里可以不上」。
九、那到底该怎么用它
批评说完,得给个用法,否则不公平。
我的建议是把它当手册,不当教材。不要从第一章读到第十八章,那样读到第六章就没劲了。正确的用法是:你手上有一个具体任务,去目录里找最接近的那一章,跑通它,然后立刻离开这本书,去做三件它没教你的事。
第一件,换数据。别用它给的数据集,用你自己的十张图。这一步会立刻暴露所有前处理的坑——归一化、通道顺序、尺寸、标签编号。前面说的那些静默错误,全都会在这一步现形。
第二件,量延迟。跑通之后,测一次推理多少毫秒,在 CPU 上再测一次。你会突然理解为什么工业界那么在意模型大小,也会理解那一亿两千万参数的全连接层为什么必须砍掉。
第三件,写失败案例。挑二十张你的模型答错的图,一张张看,写出它为什么错——光照、遮挡、类别混淆、标注本身就错。这二十张图教给你的东西,比这本书十八章加起来多。
如果只让我推荐两章精读,我推荐第五章和第十五章。第五章那个参数拆账,是这本书唯一一次把「为什么」讲透的地方;第十五章那个维度推导,是唯一一次不跳步的地方。这两处的密度,明显高于其他章节。
剩下十六章,翻着看,当索引。
这本书像一张画得很细的地图:它让你知道这一行有哪些地方,也让你能走到每一个地方去。但它不教你怎么在那里盖房子——而盖房子,才是你买地图的原因。
阅读记录
书名:PyTorch计算机视觉实战:目标检测、图像处理与大模型(原书第2版)
作者:[印] V·基肖尔·阿耶德瓦拉、[印] 耶什万斯·雷迪
出版:机械工业出版社 · 2025 年 12 月 · ISBN 9787111794905
原版:Modern Computer Vision with PyTorch, Second Edition(Packt, 2024)
读法:全书四部分十八章通读,含版权信息、译者序、前言
说明:文中引语、代码片段、参数数字与章节结构均摘自原书;关于填充表达式只适用 3×3、Dropout 位置、归一化缺失、类别编号写死、CLIP 训练规模与「基础模型」本质的判断,是我读后所加,原书未作此论
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: