
Harness工程实战:给它定名的那一章,凭什么只有 19 屏?
微信读书《Harness 工程实战:从零开始驾驭 AI 软件工程》(张建飞 著)· 本次逐页翻阅 431 屏,从版权信息读到第 11 章末尾,4 部分 11 章全部覆盖,抓取标记为全书读完(end=last_page)。这本书抓取中途卡了四次,最后是靠断点续抓一屏一屏接上去的。
说明:这是一本给「Harness 工程」这个新词写教材的书。我这次只问一个问题:一个新范式,凭什么值得单独一本书,它自己又是怎么论证的。
431 屏,4 部分,11 章。
先给结论:这本书最值钱的部分,不是它给 Harness 下的定义,是第 5 章末尾那五条「启动条件」——那其实是一张「你还没资格上 Harness」的反向清单。
而它最尴尬的部分,是第 4 章。那一章叫「Harness 工程的缘起」,负责给整本书、给这个行业新词做理论定位,只给了 19 屏,全书所有正文章里最短的一章。一本为新范式命名的书,讲命名与缘起的那一章最薄,这件事本身就是一个判断。
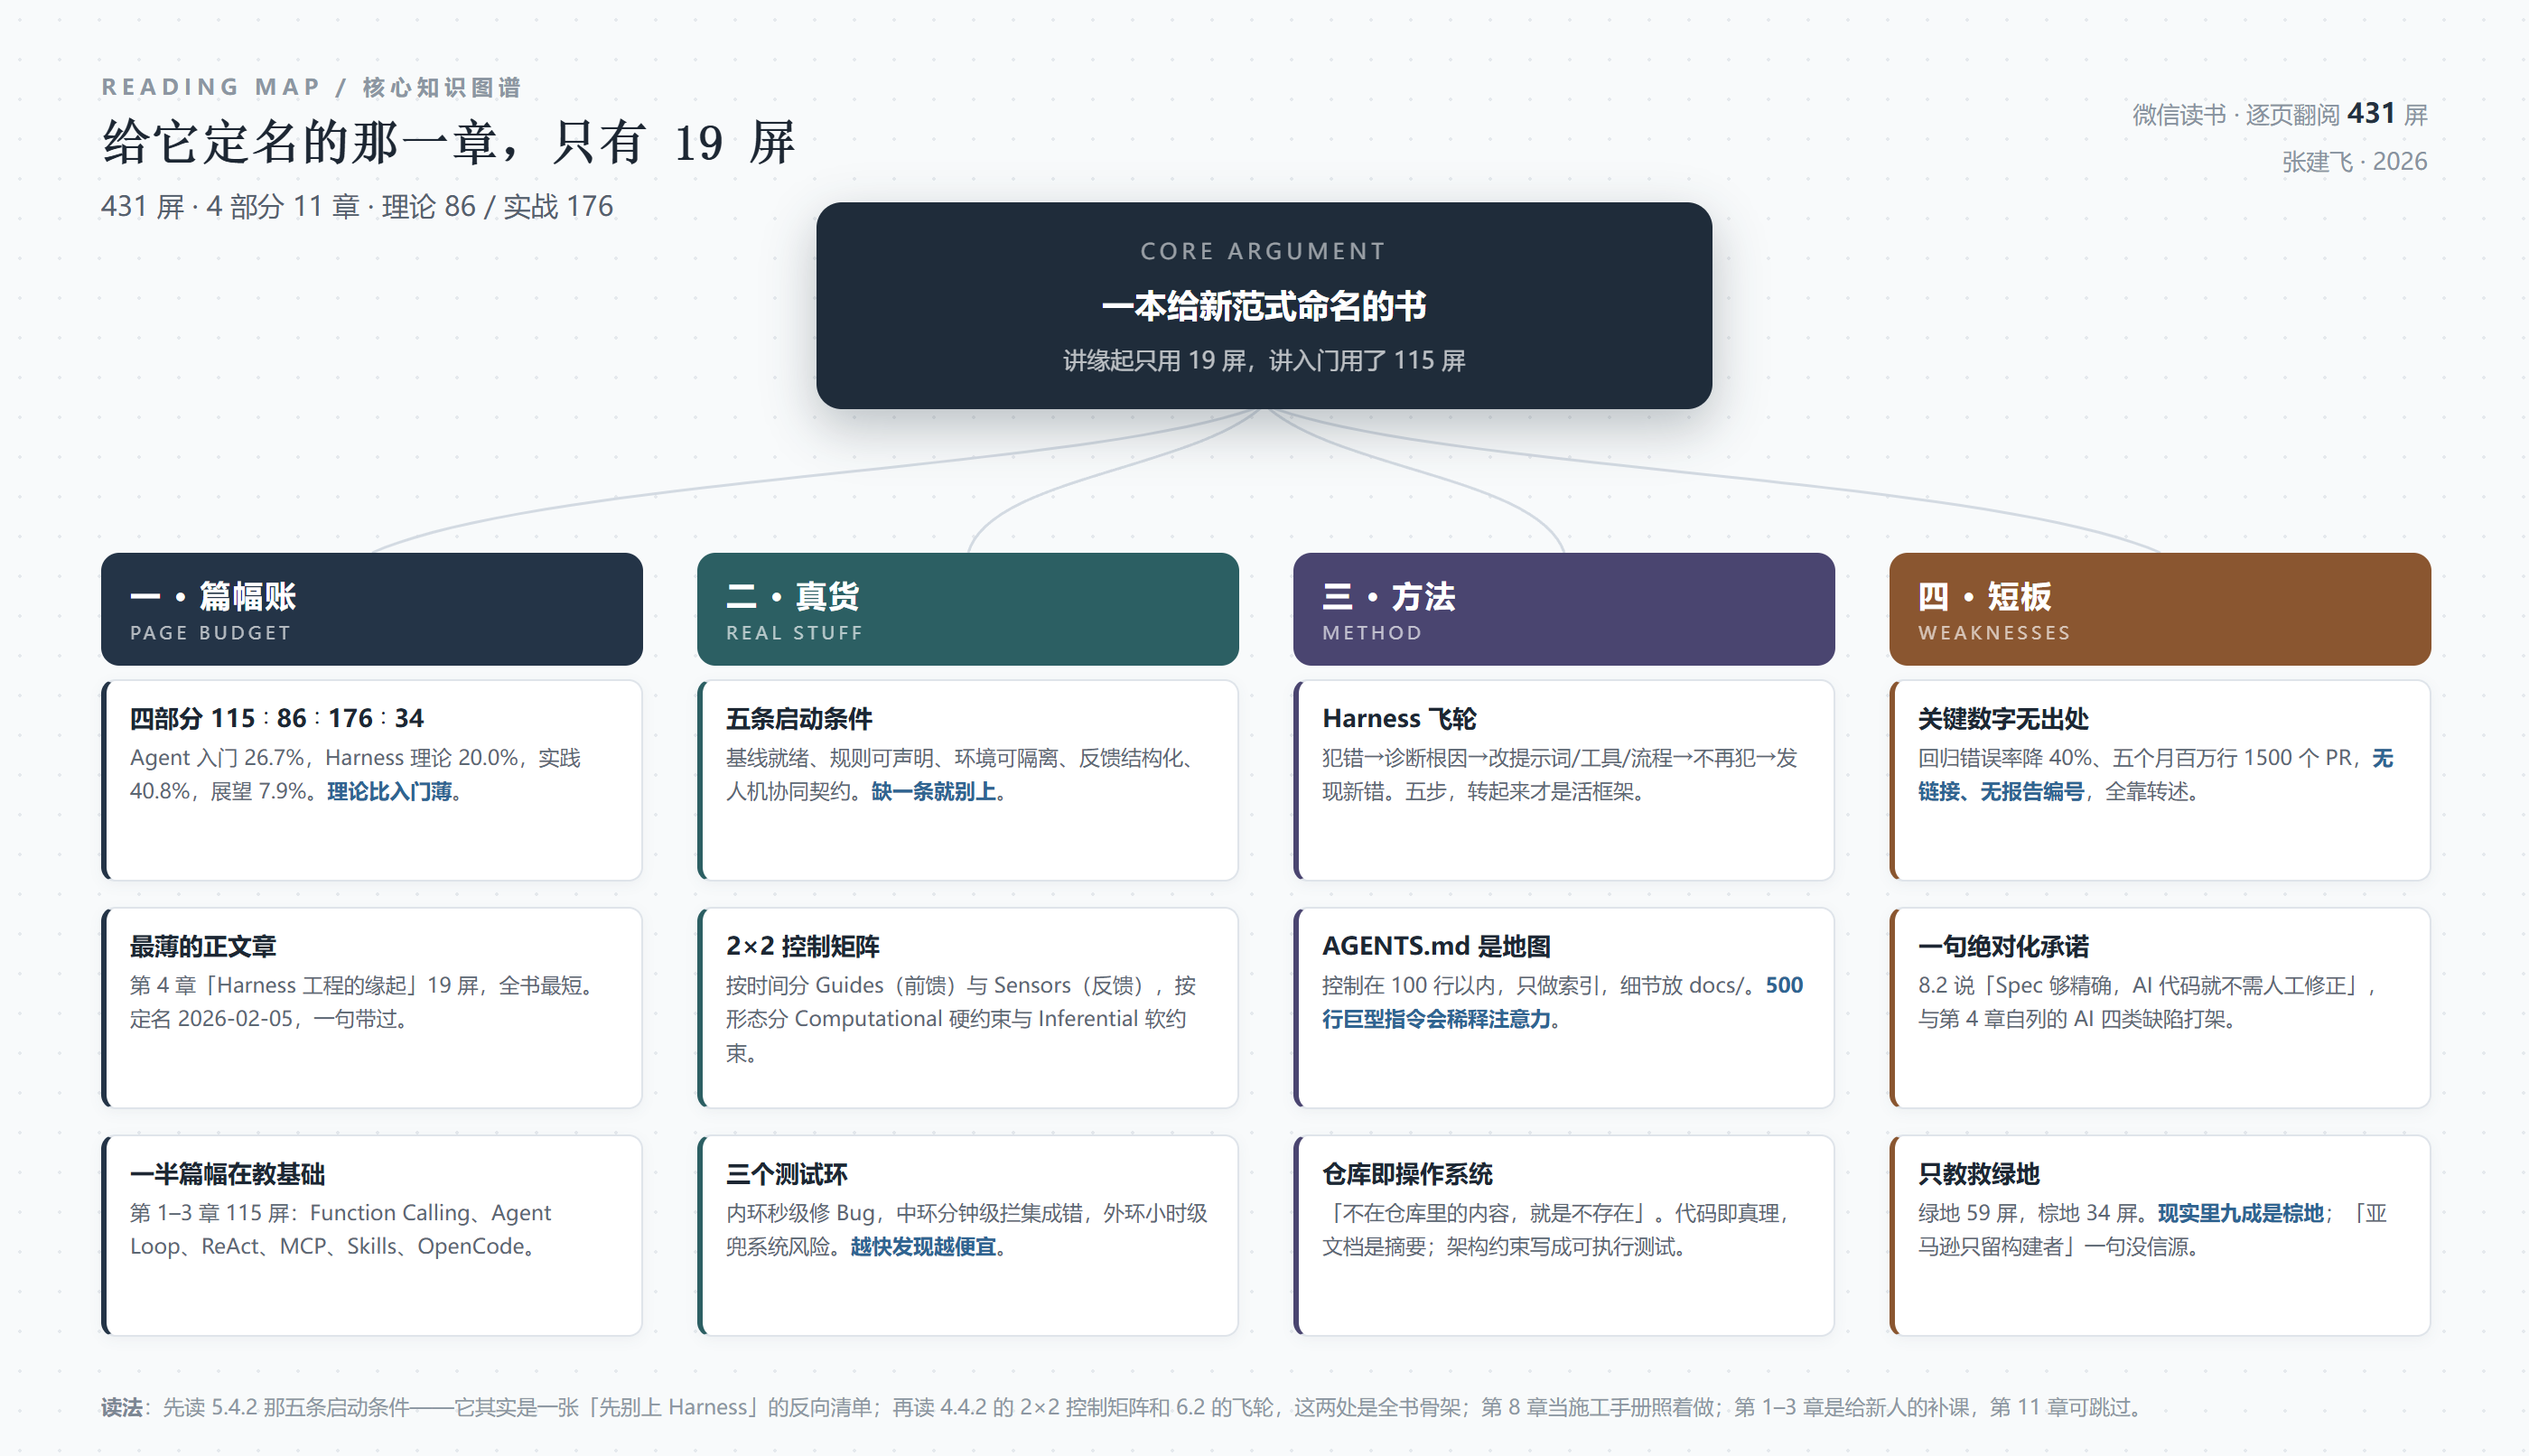
一、先把 431 屏的账摊开:理论比入门还薄
逐章统计,屏数如下:
文前 12 屏(版权信息、内容提要、推荐序、前言);第 1 章「Agent 的行动之源」38 屏;第 2 章「Agent 的武装力量」34 屏;第 3 章「Coding Agent:OpenCode 与自主编程实践」43 屏;第 4 章「Harness 工程的缘起」19 屏;第 5 章「Harness 工程的演进」29 屏;第 6 章「Harness 工程的方法论」38 屏;第 7 章「Harness 实践:经典微服务」32 屏;第 8 章「Harness 实践:全新绿地项目」59 屏;第 9 章「Harness 实践:遗留棕地项目」34 屏;第 10 章「Harness 实践:测试、环境与交付」51 屏;第 11 章「未来软件工程的展望与挑战」34 屏。此外四张部分扉页共 8 屏。
合计 431 屏,数对得上。四部分的分配是:
第一部分「Agent 基础认知」115 屏,26.7%;第二部分「Harness 工程理论」86 屏,20.0%;第三部分「Harness 工程实践」176 屏,40.8%;第四部分「未来展望与挑战」34 屏,7.9%。
这个分布里有三处值得说,而且三处指向同一个方向。
第一处:给一个新范式做理论的那一部分,比给新人做补课的那一部分还薄。理论 86 屏,入门 115 屏,差 29 屏。第 1 到 3 章讲的是 Function Calling、Agent Loop、ReAct、MCP、Skills、SubAgent、OpenCode 配置——这些是「2024 年就该会的东西」,任何一个跟过半年 AI 编程的人都读过五六遍。而第 4 到 6 章要回答的是「为什么 2026 年才出现 Harness 这个词」「它和 DevOps、平台工程、SRE 的边界在哪」——这才是这本书唯一有资格写、别人写不了的东西,只给了 86 屏。
第二处:第 4 章 19 屏,是全书最短的正文章,比第 11 章的展望还短 15 屏。一本讲未来的书,写未来给了 34 屏;一本讲一个概念怎么来的书,写来历给了 19 屏。这个比例说明作者的兴奋点在「怎么做」,不在「为什么是现在」。
第三处:实战 176 屏里,「绿地」给了 59 屏,是四个实战章里最厚的一章。绿地项目是从零开始,最好写、最好演、最容易出漂亮结果。而现实里九成的工程团队手上的活是棕地——第 9 章只给了 34 屏,比绿地少 25 屏。
把这三处放在一起,这本书的定位就清楚了:它是一本施工手册,不是一本范式论著。施工手册没什么不好,第 8 章那 59 屏确实是照着能做的;问题在封面和书名——「Harness 工程实战」里的「工程」两个字,会让读者以为第 4 章会讲清楚这个学科的骨架,结果它只讲了三个案例,讲完就走。
二、19 屏里塞了三家公司,这是全书的缩影
第 4 章虽然薄,信息密度却高得反常。它的结构是:一节讲命名,一节讲 OpenAI,一节讲 Anthropic,一节讲 Thoughtworks,一节小结。
4.1 讲「Harness」这个词的原意。它原本是马具、挽具——一套把马、驴等役畜连接到车辆或农具上的皮带与挂钩系统。作者由此展开两条隐喻:算力即马力,控制即价值。原话是「没有挽具的马力是负荷,有挽具的马力才是生产力」。这句话是全书最好的一句,比后面所有架构图都好用——因为它一句话解释了为什么模型越强,工程越重要,而不是越不重要。
4.1.1 讲定名:2026 年 2 月 5 日,Mitchell Hashimoto 正式为「控制 AI」这件事命名,把它作为一种独立工程范式提出。这一节只给了两屏,日期给得很干脆,原始出处没给。
4.2 讲 OpenAI。2026 年 2 月 11 日,OpenAI 发布工程实践报告《Harness Engineering: Leveraging Codex in an Agent-First World》,披露一支精英工程师团队在完全不进行传统编码的前提下,五个月从零做出一个生产级复杂产品,累计约 100 万行代码、提交近 1500 个 PR,代码全部由 AI 生成。作者紧接着补了一句要紧的话:「零手写」不等于「零人工介入」——工程师把精力投到「元开发」上:目录结构、依赖规范、通信协议这些「骨架」由人给,骨架定下来之后,业务功能、测试用例、CI/CD、可观测性全部由 Agent 自主生成。
4.3 讲 Anthropic,是这一章里最实的一段。它给了三角色协同:Planner(策划者)不碰代码,负责拆目标、评估技术路径、维护动态更新的 Tasks/Spec;Generator(生成者)在 Planner 划定的上下文沙箱里把指令变成代码;Evaluator(评价者)是完全独立的审计层,通常用与 Generator 不同的提示词策略,甚至不同的模型基座,唯一任务是「冷眼旁观」,找漏洞与违例。
作者引了一句很重的话:「让写代码的人检查代码,是极其危险的。」理由是当模型能力接近任务难度上限时,Generator 会产生「逻辑自洽」的幻觉——它自己看不出问题。所以 Evaluator 不关心代码规不规范,只验证产出是否符合 OpenSpec 定义的原始意图;一旦发现缺陷,立即阻断 PR,生成高质量错误报告回喂给 Generator,触发下一轮 ReAct。书里给的数据是:引入独立 Evaluator 后,长周期项目的回归错误率下降 40%。
4.4 讲 Thoughtworks,把这件事上升成控制论。它给了一个 2×2 控制矩阵:按时间分,是 Guides(前馈控制,行动发生前注入约束,「什么可以做」「必须怎么做」) 和 Sensors(反馈控制,行动发生后捕获结果,「做得对不对」);按形态分,是 Computational(硬约束,铁一般的物理规律,是 Harness 的底线) 和 Inferential(软约束,靠推理与判断)。作者说 2026 年 4 月 Harness 工程进入「体系化成型期」,并把 Harness 视为演进式架构(Evolutionary Architecture)在 AI 时代的终极形态。
4.4.3 里有一句我认为是全书的理论内核:「工程的意义不在于消灭不确定性,而在于控制熵增。」后半句更狠——「作为 Harness 工程师,我们的职责并非抹除 AI 模型天然的随机性,那是模型厂商的课题,而是构建一套能够容纳、引导并消化这种不确定性的工程系统。」
但这里就是我要提意见的地方。19 屏装下三家公司的实践,每家五到六屏,这个密度已经不是「理论建构」,是「文献综述」。真正的理论建构至少要回答三个问题:Harness 与平台工程(Platform Engineering)的边界在哪?与 DevOps 的流水线是什么关系?与 SRE 的错误预算是不是同一套东西?这三个问题书里一个字没提。它只是把三家公司的做法并列摆出来,然后说「这就是体系化」。并列不等于体系。
三、真正值钱的是第五章末尾那五条,它是一张「别上」的清单
全书我读得最慢的一节是 5.4.2,标题叫「Harness 的启动条件」。作者先问了一句:「Harness 听起来很有吸引力,但我的团队现在就能用上吗?」然后自答:「Harness 并非开箱即用的魔法。」接着给了五条:
第一,基线就绪。具体要求是具备基础 CI/CD 流水线、达到最低测试覆盖率、拥有统一的 Lint 规范。未达标就启用 Harness 的典型后果,作者写得很形象:「Agent 生成的代码无法自动运行,飞轮在第一步就卡住。」
第二,规则可声明化。团队规则必须转化为可执行的代码或策略,例如 OPA 策略、ESLint 规则、架构决策记录。「如果仍依赖口头约定或纯人工审查,拦截就无法自动化。」
第三,环境可隔离。需要支持秒级生成临时沙箱,具备依赖缓存、快照回滚与权限隔离能力。做不到的典型表现是「本地能跑,CI 挂掉」,或者 Agent 的执行副作用污染主干分支甚至生产配置。
第四,反馈可结构化。测试报告、静态分析结果、性能指标、代码审查意见,全部必须输出为机器可读的 JSON。作者的原话是「如果反馈停留在截图、口头描述或非结构化日志中,就无法路由至 Agent 或策略库」。
第五,人机协同契约。必须明确 AI 自主决策的边界,例如风险等级 ≤P3 的变更可由 Agent 自动合并,≥P2 的变更需要人工审批。
这五条为什么值钱?因为市面上的 AI 编程书都在论证「该上」——上 Agent、上工作流、上自动化。这本书反手给了一道门槛,而且门槛全部落在「你现有的工程能力」上:CI/CD、测试覆盖、Lint、OPA、Docker、结构化报告。翻译成一句话:Harness 不解决工程能力不足的问题,它放大工程能力。
这和它在前言里引的布鲁克斯是一致的。前言写:「大模型能大幅降低软件的偶然复杂度——查阅文档、修改语法错误、编写 CRUD 模板这些体力活,但它无法独自跨越软件的本质复杂度——核心业务逻辑、领域建模、边界划分,以及在利益冲突中进行战略权衡。」然后引《人月神话》的「没有银弹」:「AI 是一把好剑,但不是另一颗银弹。」
我要在这里补一句批评。五条里最狠的是第二条「规则可声明化」。绝大多数中小团队的规则形态是什么?是老员工脑子里的「这块别动」、是代码评审时的一句「我们一般不这么写」、是离职就带走的隐性知识。要把这些写进 OPA 和 ESLint,工作量不比写业务代码小。这一条实际上把大部分团队挡在了门外。但作者的语气还是「达标就能上」,没有写「达不到该怎么办」——是先去补 CI/CD,还是先在局部试 Harness 反过来逼自己补 CI/CD?这是全书最该展开的一段,只有两屏。
四、同心圆有一个漏洞:越外圈不等于越高级
第 5 章的主线是三段演进:Prompt 工程 → Context 工程 → Harness 工程。作者的图 5-1 画成三个同心圆,Prompt 在最里,Context 在中间,Harness 在最外。
他特意澄清了一句,我认为这句澄清很重要:「Harness 工程并非对 Prompt 工程和 Context 工程的替代,而是对它们的继承与发展。Prompt 工程用精准的指令告诉 Agent『要做什么』;Context 工程为 Agent 提供背景信息;而 Harness 工程则将二者纳入一套具备约束、反馈与自动化能力的『工程脚手架』。」
为什么需要升级?第 5 章给了一张表 5-1,列 Prompt 工程的固有三缺陷。第一个是状态缺失:上下文无法持久化,长任务易出现逻辑断裂或目标漂移,工程后果是「无法支持多轮代码重构、依赖升级、架构迁移等状态敏感任务」。第三个是语义漂移与不可预测性:「由于 LLM 的概率特性,即便使用完全相同的提示词,在不同的时间点或模型微调后,模型输出的架构方案也可能截然不同。这种非幂等性在金融、网络管理等严谨工程领域是无法容忍的重大隐患。」
「非幂等」这个词用得很准。提示词工程的本质是「每次重掷骰子」,而工程要的是「同样的输入给同样的输出」。这两件事的矛盾,才是 Harness 存在的真正理由,比任何架构图都硬。
但同心圆这个隐喻有漏洞。它暗示「越外圈越高级」,实际上三者是不同的成本结构。Prompt 是边际成本几乎为零的试错——改一句话,重跑一次,几分钟看到结果。Harness 是一次性投入加持续维护的固定成本——搭沙箱、写策略、接 CI、维护 AGENTS.md,起步几周,之后每个月都要有人管。对一个人或三个人的团队,最外圈不是「更高级」,是「养不起」。
作者其实在第 7 章承认了这件事。他讲了「三档投入」,从一个人的业余 API 调用,到两三人数周的开源方案,再到跨职能团队数月自建。承认了分层,却没回头改那张同心圆。读者记住的往往是图,不是文字。
五、飞轮、三要素、仓库即操作系统:这本书的工程内核
如果让我从这本书里只带三样东西走,我会带这三处,它们分散在第 5、6 章,彼此不挨着,但拼起来正好是一个可执行的定义。
第一样:6.2 的「Harness 飞轮」。图 6-1 画了五步闭环:1. Agent 犯错(产出不符合预期)→ 2. 人类诊断原因(分析根因是什么)→ 3. 改进 Harness(优化提示词/工具/流程)→ 4. 不再犯同样的错误 → 5. 发现新的错误。作者强调 Harness「不是一次性设计实现的完美系统,而是在持续迭代中生长出来的活框架」。
这个环最容易被忽略的是第 2 步和第 3 步之间的落差。发现错误人人会,诊断根因是手艺,把根因翻译成「改哪一层」才是真本事。同一个错误,可能是提示词没写清(改软约束)、可能是缺一个类型定义(改硬约束)、可能是测试没覆盖(改反馈环)、也可能是流程本身设计错了(改流程)。选错层,飞轮就空转——错误被「修」了,但下个月换个形式再来一次。
第二样:5.3.2 的「控制闭环三要素」。书里给的是:一、静态约束与契约层——通过强类型语言(Java/TypeScript)的接口定义和 JSON Schema,在编译层面强制 Agent 遵循契约;二、运行时沙箱——Agent 写的代码必须在受控的 Docker 容器或虚拟环境中即时运行,并允许 Agent 调用测试框架、静态分析工具和模拟器,从而感知代码在真实世界中的表现;三、负反馈自愈——作者称这是「Harness 的灵魂」:当产出偏离轨道,系统不只报错,还会自动产生「拉力」,包含「错误重塑」(把编译错误、Lint 警告、测试失败信息转化为人类可理解、模型可利用的反馈指令)和「自动重试与纠偏」(通过 ReAct 循环逼 Agent 从失败中学习)。
这三样里,我认为「错误重塑」是全书最被低估的一处。它讲的是同一件事的两个版本:给模型丢一个 300 行的堆栈,和给它一句「第 42 行调用的 findUser 返回了 null,因为测试里没插数据」,效果差一个数量级。把机器的报错翻译成模型的母语,这本身就是一种工程。
第三样:6.5 的「仓库是 Agent 的操作系统」。这一节的第一句话是全书的第二个金句:「从 Agent 的角度来看,不在仓库里的内容,就是不存在。」
论证很扎实:Agent 运行时无法访问任何不在其上下文范围内的内容。存在 Wiki 里的知识、散落在聊天记录里的约定、工程师脑海里的架构蓝图,只要没有被编码并提交到代码仓库,对 Agent 而言都是无效的。所以「若要有效驾驭 Agent,首先必须接受一个前提:仓库就是 Agent 的操作系统」。
接着给了三条具体做法:架构决策记录存为 Markdown 并纳入版本管理;模块间的层级约束用 ArchUnit 这类框架写成可执行的测试用例;命名规范配置为 Lint 规则。一句话总结:「知识必须跟着 Git 走——在 Agent 打开项目的那一刻,它就拿到了完整的『法律条文』,而不是靠零散的提示词来理解规则。」
紧挨着的 6.4.2 讲 AGENTS.md,结论反直觉:它不是一本面面俱到的手册,是一张指引方向的地图,内容应尽量控制在 100 行以内,只作为「索引」存在,具体设计放 docs/ 目录下按需加载。作者把这个悖论说得很清楚:「当一切都重要时,一切就都不重要了。AGENTS.md 篇幅过大会挤占上下文窗口,AI 的有效注意力会被稀释,真正关键的规则反而容易被忽略。」图 6-5 画的对比很直白:左边 500 行巨型指令,一个愁眉苦脸的人;右边约 100 行索引,一个竖大拇指的人,箭头指向 docs/ARCHITECTURE.md、docs/DEVELOPMENT.md、design-docs/。
把这三样拼起来,其实能得到一个比第 4 章清楚得多的定义:Harness 工程,就是把人的隐性规矩编译成机器可执行的约束,再把机器的输出翻译成模型能读懂的反馈,让这个循环自己转起来。可惜这个定义书里没有,它散在三节里,需要读者自己拼。
六、三种项目、三个测试环:实战部分的分工
第三部分 176 屏分四章,正好覆盖四类场景:微服务(32 屏)、绿地(59 屏)、棕地(34 屏)、测试与环境(51 屏)。
第 7 章「经典微服务」讲的是「AI 友好型」这件事:代码怎么写得让模型读得懂,架构怎么选才不跟 Agent 打架。它给了一个明确推荐——COLA 是 AI 友好型架构的首选。还讲了 Plan-Build 模式:先让 Agent 出一份计划,人审完再让它动手。这一章最实的是 7.4,拿一个叫 customer-center 的客户主数据中心做例子,7.4.2 讲「金融属性的类型化表达」,7.4.3 讲「账户冻结/解冻的分层实现」——从这两个小标题就能看出,作者挑的是那种「有真实复杂度、又不会涉密」的业务切面。
第 8 章「绿地项目」59 屏,是全书最像施工手册的一章。它给了完整剧本:8.2 先讲 SDD(规格驱动开发)与 OpenSpec——核心理念是「只要 Spec 足够精确,AI 生成的代码就不需要人工修正」,四阶段是探索、提案、实施、归档,规范要求把关键约束写成可验证的形式,比如「响应时间 < 200ms」「金额字段……」。然后 8.3 迭代零任务一搭框架,8.4 迭代零任务二「初步构建挽具」——用 OpenCode 的 /init 命令自动扫描项目结构生成 AGENTS.md。之后迭代一加 CRM 核心业务并用 Harness 修复问题,迭代二加客户小记验证飞轮,迭代三加客户标签并设代码质量闸门,迭代四做客户 360° 视图与外部系统集成。
第 9 章「棕地项目」只有 34 屏,分两节:9.2 局部重构,在完成新需求的同时偿还技术债;9.3 绞杀者重构,也就是「飞着飞机换引擎」。9.3 写得不错,先把绞杀榕的隐喻讲透——种子落在老树枝权上,气根向下生长、逐渐包裹老树,最后把老树绞死;然后对应到模式上:不换引擎,而是加一台引擎,让它慢慢接管动力,等旧引擎自然退场。
但这一章的问题也在这里。34 屏要回答「老系统怎么被 AI 改造」,等于什么都没回答。绞杀者模式是 2004 年 Martin Fowler 就写过的老办法,书里没有新增任何 AI 时代的做法——比如怎么让 Agent 读懂二十年的祖传代码、怎么给没有测试的老模块补上安全网、怎么判断哪一块先绞。这三个问题才是棕地改造的真难点,书里一个都没展开。而绿地那 59 屏,迭代零到迭代四写得干干净净,因为绿地没有历史包袱,剧本可以照着演。
第 10 章「测试、环境与交付」51 屏,是实战部分第二厚的。它提出一个我认为很有价值的重构:不要按「单元测试/集成测试/端到端测试」分类,要按变更触发的反馈环路分类。图 10-3 给三个递进的环:内环是秒级,让你在本地就把 Bug 修好;中环是分钟级,拦截集成阶段的错误;外环是小时级,兜住系统级风险。核心思想一句话:「越快发现问题,成本越低。」后面 10.3 到 10.6 就是把这三种环落地——内中环在 Harness 里实现,外环先做本地脚本自动化,再上容器化沙箱与声明式端到端基座,最后用 GitHub Actions 完善 CI/CD。
这一章的分量说明作者知道什么最贵:不是模型,是让模型敢改代码的那套安全网。可惜它排在第 10 章,很多读者翻不到那里。
七、它的短板
第一,关键数字全部没有出处。回归错误率下降 40%、五个月 100 万行代码、近 1500 个 PR、五个月——这些是全书最重要的论据,但没有一个给出链接、报告编号或页码。连 4.1.1 那个精确到日的定名时间(2026 年 2 月 5 日),也只给日期不给原始出处。一本讲工程严谨的书,论据却是「据说」,这个反差很难忽略。
第二,有一处明显的自我矛盾。8.2 说「只要 Spec 足够精确,AI 生成的代码就不需要人工修正」。但第 4 章那张表列了 AI 生成代码的四类缺陷:架构腐化(AI 生成的代码缺乏一致的设计约束,导致模块边界模糊、依赖关系混乱)、逻辑幻觉(凭空编造不存在的 API 或函数)、安全漏洞(缺乏安全约束,SQL 注入、权限绕过等漏洞泛滥)、可维护性差(代码风格不统一、测试覆盖率低)。
如果 Spec 精确就能免掉人工修正,这张表就不该存在。我的理解是:Spec 能消灭「逻辑幻觉」的一部分——因为它把意图写清楚了;但消灭不了「架构腐化」,那靠的是第 6 章的约束与第 10 章的质量闸门;更消灭不了「安全漏洞」,那靠的是硬约束与扫描。同一本书里两种口径,说明这两章可能不是同一个阶段写的,或者作者自己也在这两个立场之间摇摆。
第三,有一处没信源的「硅谷传闻」。第 11 章写:「目前,亚马逊正在探索组织架构的调整,计划取消传统的岗位设置,只保留一个岗位——构建者。」没有时间、没有部门范围、没有消息来源。这类话在书里出现一次,读者对全书其他转述的信任就会打一次折。
第四,只有一个案例。customer-center 这个项目贯穿第 7、8、9 三章,全部结论都从它身上长出来。它是个带金融属性的客户主数据中台,这个背景决定了它的问题是有边界的:字段多、约束严、审计要求高。那么内容型产品、算法型服务、嵌入式系统呢?书里没有第二个样本,也没有一个反例。这和《项目管理红宝书》是同一个毛病——一家公司的经验,写了一本书的结论。
第五,术语密度过高,全书没有一张术语表。Harness、Harness 套件、挽具、飞轮、Guides、Sensors、Computational、Inferential、内环、中环、外环、SDD、OpenSpec、Plan-Build、迭代零、元开发……粗数一下十五个以上,散在十一章里。第 4 章本该承担「统一术语」的职责,但它只有 19 屏,只顾得上讲三家公司。
八、一句话
这本书的价值不在「Harness 是什么」,在「上 Harness 之前你得先有什么」。它把 AI 编程从一个「模型能力问题」翻译成了一个「工程成熟度问题」——这个翻译是对的,也是它比同类书高一档的地方:别人在比谁的提示词更神,它在问你 CI 跑不跑得起来、规则写不写得进机器。
但它自己的论证方式,恰恰不符合它提倡的工程标准。转述代替引用,单一案例代替多个样本,愿景章比理论章厚一倍。所以读它要带两把尺子:量它那张五条的清单,那是真货;别信它那些没出处的百分比,那是话术。
至于要不要买——如果你手上的项目已经有像样的 CI、有一批能跑的测试、团队愿意把口头规矩写进配置文件,那第 5、6、10 章值这个价。如果这三样都没有,先别急着上 Harness,先把第 5 章末尾那五条抄下来,一条一条补。补到第四条「反馈可结构化」的时候,你会发现自己其实已经在做这件事了。
阅读记录:《Harness 工程实战:从零开始驾驭 AI 软件工程》,张建飞著,微信读书 431 屏,4 部分 11 章,2026-11-17 逐页读完(end=last_page)。文中屏数为逐页统计的实际值:第 1–3 章 38/34/43,第 4–6 章 19/29/38,第 7–10 章 32/59/34/51,第 11 章 34,文前 12 屏、四张部分扉页 8 屏,合计 431 屏,与总数核对一致。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: