
项目管理红宝书:五个版本做完,最值钱的是一句「越做越薄」
微信读书《项目管理红宝书:小红书 PMO Agentic 项目管理实战》(李斌、蒋中杨 等著)· 本次逐页翻阅 413 屏,从版权信息读到「写在最后」,8 章 151 节加两个附录全部覆盖,抓取标记为全书读完(end=last_page),耗时 334 秒。
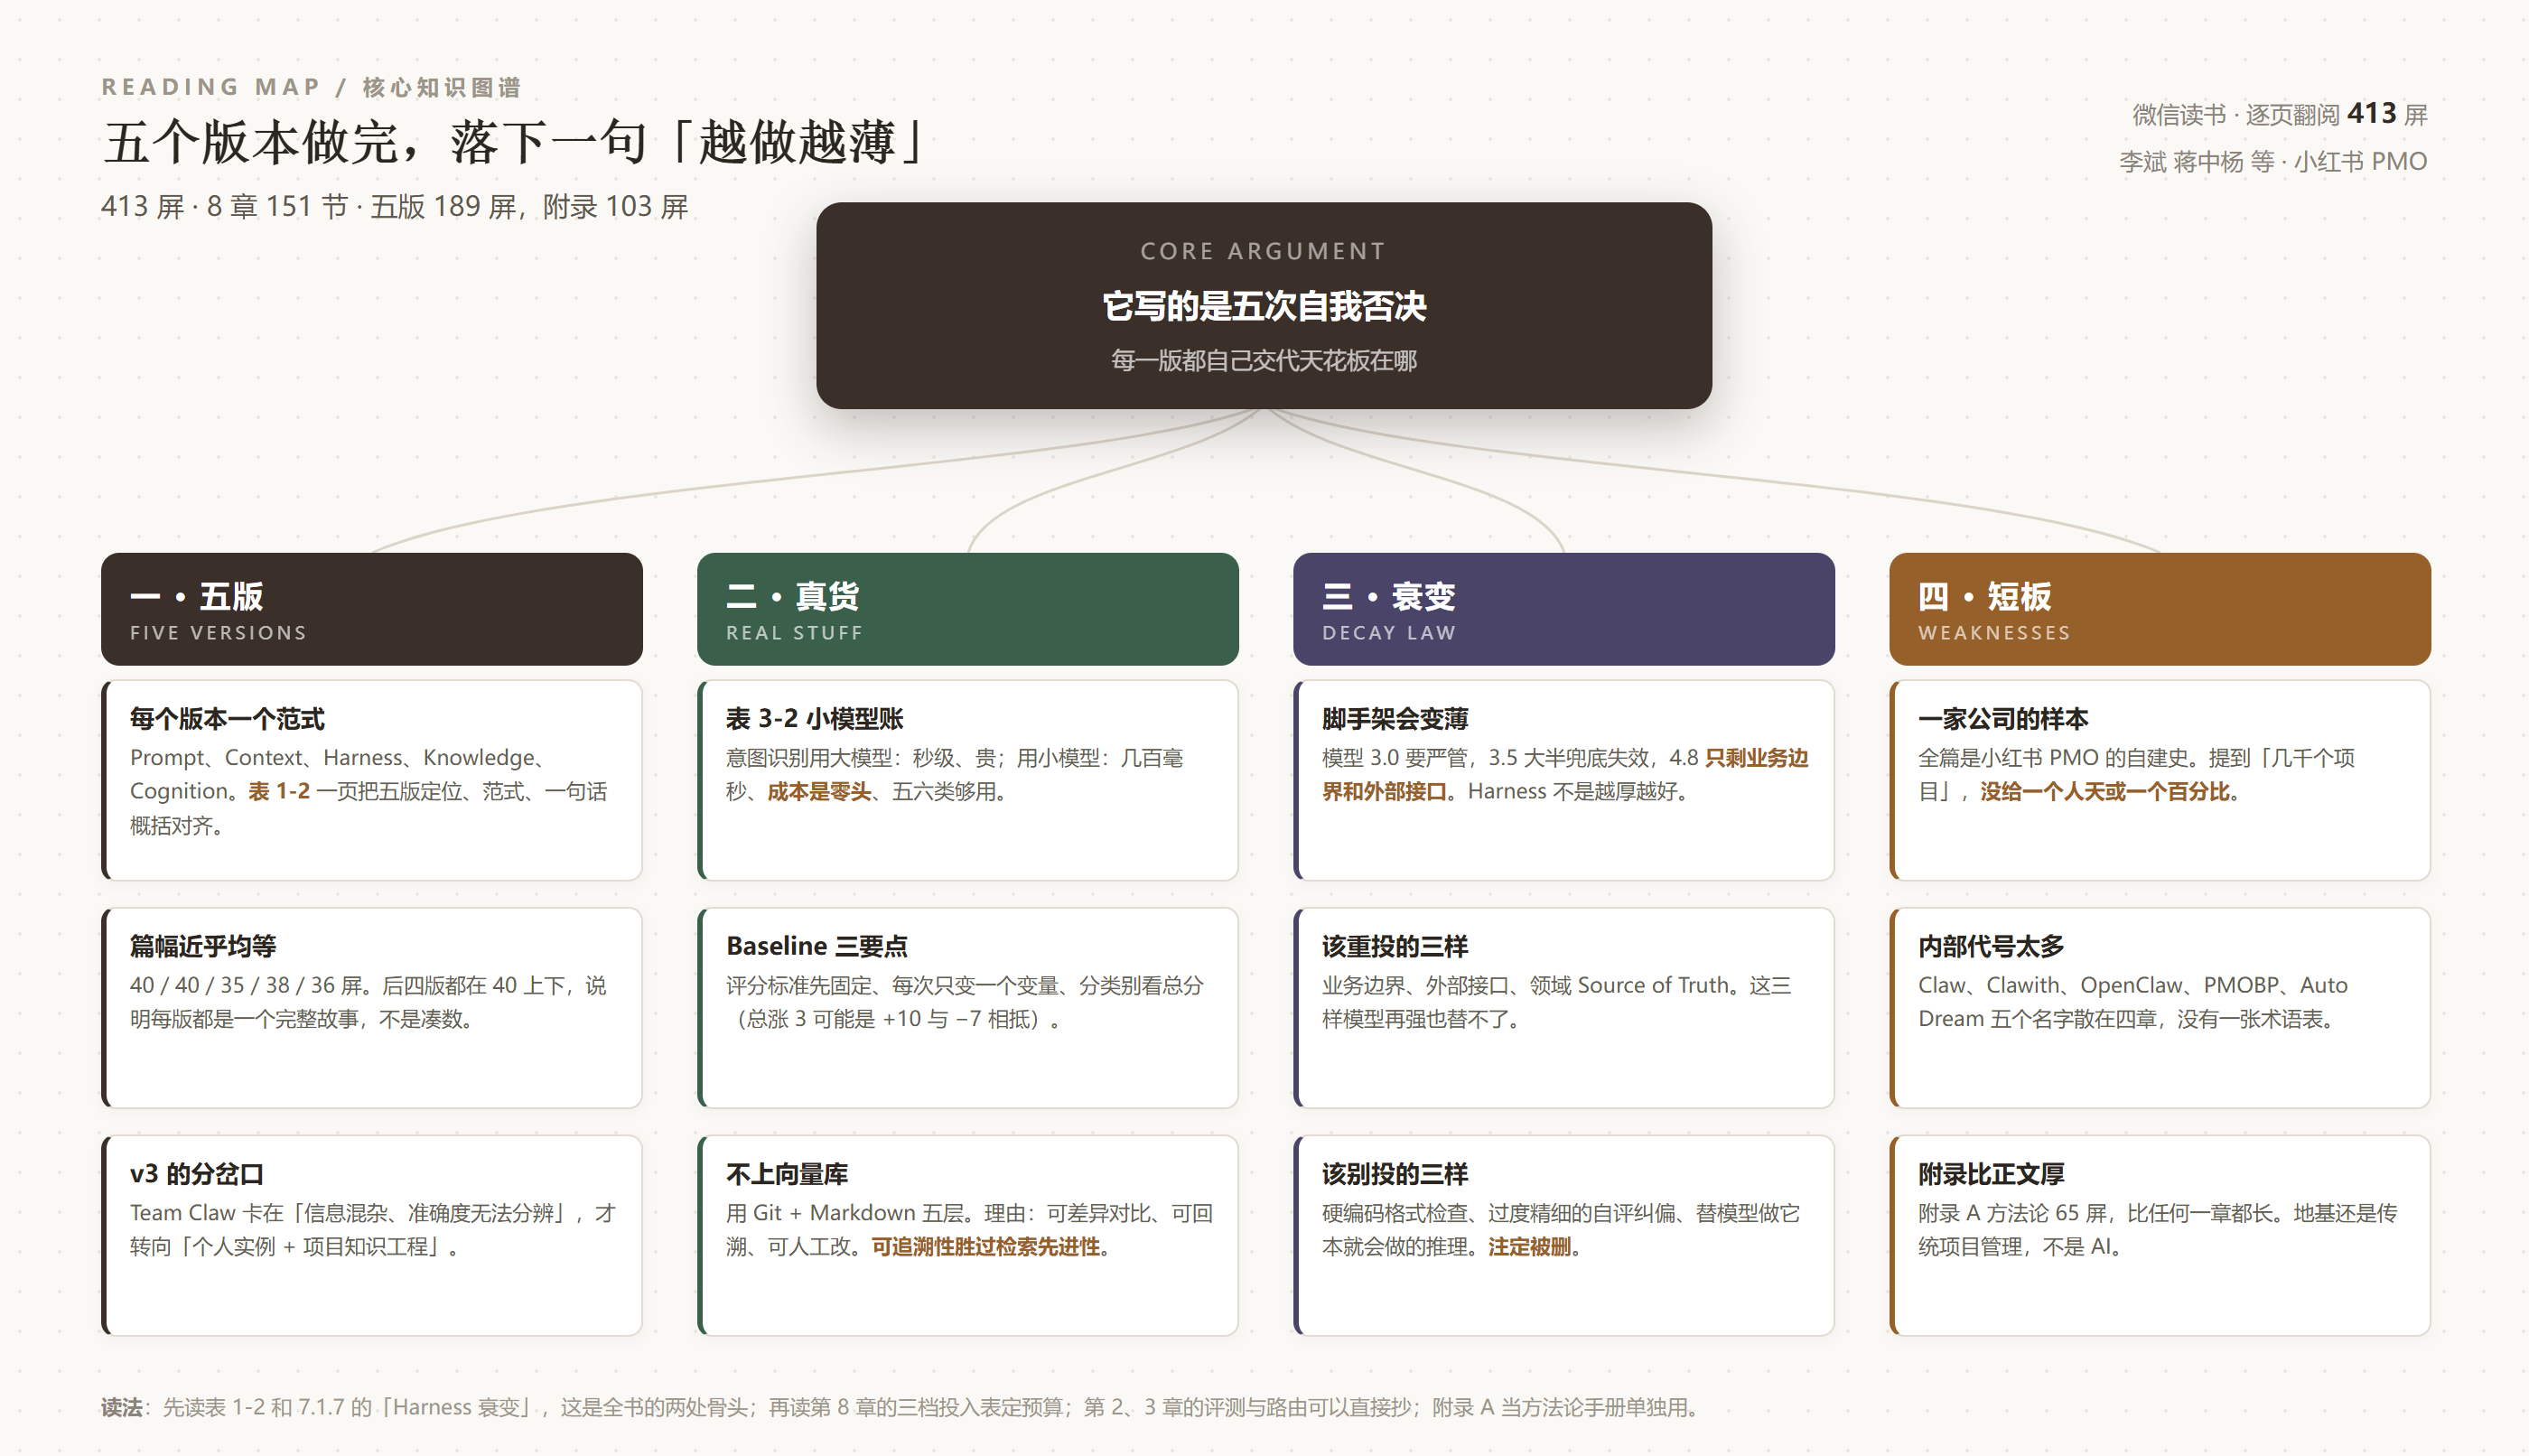
说明:这是小红书 PMO 团队写自己怎么做项目管理 Agent 的书,我这次只问一个问题:五个版本的迭代里,哪些是真教训,哪些只是版本号。
413 屏,8 章,151 节,外加附录 A 方法论 65 屏、附录 B 模板 38 屏。
先给结论:这本书真正的价值,不是它做出来的那个 Agent,是它在第 7 章承认的那件事——脚手架会随模型变强而变薄,你花在兜底上的功夫,有一半是注定要被删掉的。
这个判断出现在 7.1.7 节,标题叫「贯穿 6 条心得的底层定律:Harness 衰变」。一本讲自己怎么搭系统的书,最后告诉你「你搭的这东西会自己贬值」,这在我读过的工程书里是少见的。大部分书在讲「我做成了一件多难的事」,这本书在讲「我做的哪些事后来白做了」。
下面先把账摊开,再说它凭什么值得读,最后说它哪里不够。
一、413 屏的账:五版 189 屏,附录 103 屏
逐章统计,屏数如下:
文前 33 屏(版权信息、内容提要、序言、前言),占 8.0%;第 1 章「起点:AI 时代的项目管理」21 屏,占 5.1%;第 2 章「v1.0 把 AI 当成顾问(Prompt Engineering)」40 屏,占 9.7%;第 3 章「v2.0 让 Agent 帮你干活(Context Engineering)」40 屏,占 9.7%;第 4 章「v3.0 从个人分身到领域 Agent 探索(Harness Engineering)」35 屏,占 8.5%;第 5 章「v4.0 PMOBP:项目专属 BP(Knowledge Engineering)」38 屏,占 9.2%;第 6 章「v5.0 自进化的领域专家(Cognition Engineering)」36 屏,占 8.7%;第 7 章「心得与展望」25 屏,占 6.1%;第 8 章「给两类读者的落地路径」42 屏,占 10.2%;附录 A 项目管理方法论沉淀65 屏,占 15.7%;附录 B 可复用模板物料38 屏,占 9.2%。
合计 413 屏,数对得上。正文八章 277 屏,附录 103 屏,文前 33 屏。
这个分布里,有三处值得说。
第一处:五个版本的篇幅是 40、40、35、38、36,误差不超过 5 屏。五个版本合计 189 屏,占 45.8%。这个均等不是巧合,说明作者是按同一套模板写的每一版:这一版解决什么问题、架构长什么样、遇到什么瓶颈、小结。五版都写完整,没有哪一版被缩成一节。这种「一版一章」的写法,本身就是在说:这五次迭代不是五个功能,是五个不同的世界观。
第二处:附录 A 65 屏,比任何一章都厚。它讲的是干系人识别、项目启动会(KO)、会议体系、复盘、风险识别与升级——这些内容跟 AI 一点关系都没有,是传统项目管理的硬功夫。一本讲 Agent 的书,最厚的一块给了这些,说明作者很清楚:Agent 的上限由模型决定,下限由你懂不懂项目管理决定。
附录 A 不是凑数的。A.4.2「团队复盘心法——心情曲线」给了 7 屏,配一张图 A.3:横轴是时间,纵轴是心情,两条曲线分别代表项目里的小 A 和小 B,曲线上标了一个「断点」。它问的问题是「为什么绘制心情曲线可以帮助大家敞开心扉地沟通」。这种把「复盘会开不下去」归因到情绪而不是流程的视角,是做过很多次复盘的人才会有的。一个只懂技术的作者,写不出这一节。
第三处:文前 33 屏,比第 1 章 21 屏还多。序言、前言、推荐序加起来比开篇正文长,这在企业管理类书里常见,但对读者不友好——真正的第一课要翻到第 55 屏才开始。
第 8 章 42 屏是正文里最厚的一章,讲两条落地路径(个体、组织)和三档投入。表 8-10「三档投入 vs 三档产出」把投入分成三档:轻档(个人/小团队)是 1 人、业余时间、现成模型 API;中档(PMO 小组)是 2–3 人、数周、现成开源工具;重档(组织级平台)是跨职能团队、数月、自建平台 + 主数据。书里配了一句判断:「很多团队会卡在『要不要一步到位』上,其实不必。AI 项目管理的投入可以分档推进,每一档都有对应的、能交差的产出。」
这个安排也有意思:它把「你该怎么用」放在最后,而且给的篇幅比任何一个技术版本都多。技术书通常把落地放在附录,这本放在了正餐位置。
二、表 1-2:五个版本,五种工程范式
全书最该先看的一页,是第 1 章 1.3 节的表 1-2「5 次架构迭代全景」。它只有四列:版本、定位、工程范式、一句话概括。四列填完,五个版本的关系就清楚了。
v1.0,定位「AI 顾问:通用咨询」,工程范式 Prompt Engineering(提示词工程)+ RAG,一句话是「把 AI 当项目管理顾问,能稳定回答基础问题」。
v2.0,定位「Agent:帮人干活」,范式 Context Engineering + 规划执行,一句话是「多 Workflow Agent,走进 IM + 自建前端」。
v3.0,定位「OpenClaw:分身进群干活」,范式 Harness Engineering + 主数据平台,一句话是「个人分身进项目群干活」。
v4.0,定位「PMOBP:赋能项目组」,范式 Knowledge Engineering(知识工程)+ 角色感知,一句话是「给每个人配一个助理,也给『项目』配一个 BP」。
v5.0,定位「领域专家:懂行有人感」,范式 Cognition Engineering(认知工程)+ 自我迭代,一句话是「给 PMOBP 装上认知内核,从『知道事实』到『懂行、会判断、越用越聪明』」。
这张表好看在哪?它把「AI 在项目里扮演什么角色」这件事,拆成了五个清晰的台阶:顾问、执行者、分身、伙伴、专家。每一级都对应一种工程范式,而且这五种范式的名字——Prompt、Context、Harness、Knowledge、Cognition——恰好是这两年业界讨论 AI 应用时最常用的五个词,只是很少有人把它们排成一条线。
图 1-2 把这条线画成了阶梯:横轴是项目管理本身的演进,纵轴是 AI 介入项目管理的深度,五个方框从 v1.0 一级一级往上走。这张图的脚注写得挺克制——「横轴是项目管理本身的演进,纵轴是 AI 介入的深度,每一版都在往上迈一步」。它没有吹「颠覆」,只说「迈一步」。
我把这张表和另一件事对上看了:这五个版本不是按功能加的,是按「AI 承担的责任」加的。v1.0 只敢让它答问题,v2.0 让它动手,v3.0 让它进群当分身,v4.0 让它懂角色,v5.0 让它会判断。责任每加一层,工程上要补的东西就换一类——这解释了为什么每一版的范式名字都不一样。
三、每一版都自己写了「天花板在哪」
这本书最不像宣传材料的地方,是每一版结束时都有一节专门讲「这一版不行了」。这一点我特意逐章核对过。
第 2 章末尾是 2.5「顾问模式的天花板:会说,不会做」,下面跟一节 2.5.1「为什么说『Prompt + RAG + 知识库』到顶了」。
第 3 章末尾是 3.5「v2.0 的瓶颈:规范性与可扩展性的矛盾」。第 4 章在 4.3 节讲 Team Claw 的探索与困境,4.3.2 的标题直接叫「困境:信息混杂,准确度无法分辨」。
第 4 章还有一段我读了两遍。4.4 节「核心反思:前台服务员与后厨」,把 OpenClaw 比作前台服务员,把项目管理 Agent 比作后厨,然后说后厨才是「领域唯一事实来源」,由此得出转向:从「项目实例」改成「个人实例 + 项目知识工程」。这是一个架构级的自我否定——前面辛苦做的「每个项目一个实例」,被自己判定为错的方向。
第 4 章的 4.2.2 节还有一张我没想到会出现在这种书里的表。表 4-2「五维安全策略」列了 ISOLATION(用户隔离)、WHITELIST(白名单)、MONITOR、NOTICE、AUDIT 五个维度,每个维度配「能力」和「防护目标」两栏。第一个维度的写法是这样的:能力是「CreatedBy 自动绑定、不可伪造,所有 CRUD(增删改查操作)均做归属校验」,防护目标是「防止 A 的个人助理 Agent 被 B 操纵,或越权读取他人数据」。
这一段的分量在于它把「安全」从口号落到了一个字段上。「CreatedBy 自动绑定、不可伪造」是一句工程语言,不是一句管理语言——它意味着这个系统在设计时就假定「Agent 会被冒名」,而不是等出事之后再补。书里还写了一句很实在的话:安全部门的态度从「皱眉头」变成了认可这是「最好的管控方案」。一个内部系统能过安全部门的关,比拿一个创新奖难。
第 5 章、第 6 章同样有小结收口,第 5 章 5.6 之后接第 6 章的认知工程,逻辑是「知识工程解决了『知道』,没解决『判断』」。这条链子从头到尾是连贯的:会说 → 会做 → 会做但分不清谁的信息 → 知道事实但不会判断 → 会判断且越用越准。
为什么这一点值得单独说?因为大部分「我们做了个 Agent」的书,五个版本会写成五个功能模块(这版加了记忆、那版加了工具),读起来像产品更新日志。这本书的五个版本是五次撞墙,每一堵墙都有名字:会说不会做、规范性 vs 可扩展性、信息混杂、知识不等于判断。
我唯一想追问的是:这些「天花板」是当时就认识到的,还是事后总结出来的?书里没写时间线,也没写每一版各自活了多久。第 1 章说「这一年多时间里,我们进行了 5 个版本的项目管理 Agent 架构迭代」——一年多,五个版本,平均每个版本两个多月。这个节奏下,很多「反思」恐怕是边做边有的,事后串成了一条漂亮的路。但即便如此,愿意把失败的那几版写出来,已经比大多数同行诚实。
四、表 3-2:为什么意图识别要用小模型
第 3 章 3.1.2 节「意图识别用小模型:一笔成本账」,是全书工程含量最高的一节。它给了一张表 3-2「大小参数模型多维度对比」,四个维度:
单次延迟:用大参数模型做意图识别是「秒级,用户会感到卡顿」;用小参数模型是「几百毫秒,几乎无感」。单位推理成本:大模型「高昂(按大模型计费)」,小模型「约为前者的零头」。分类准确率:大模型「略高,但提升有限」,小模型「五六类场景下完全够用」。调用频次:两者都是「每条消息必过一次」。
这张表的价值不在结论(谁都知道小模型便宜),在于它把「该用哪个」变成了一道能算的题。关键是第四行——调用频次「每条消息必过一次」。意图识别不是一次请求调一次,是群里的每条消息都要过一遍。这一行把前两行的差距放大了几十倍:一个几百人的项目群,一天几千条消息,每条都过一次秒级的大模型调用,延迟叠加起来就是「这个机器人怎么老是慢半拍」。
紧接着 3.1.3 讲路由器的 5 路分发,表 3-3 把五条路列了出来:知识/进展问询(「X 项目到哪步了」「谁负责」)、需求/工作项(「查看 ×× 迭代/版本的需求」「状态流转」)、文档相关(「催更」「文档变更」「谁还没看」)、待办相关(「记个待办」「我的待办」「跟进」)、周报/汇总(「总结本周进展」「出周报」)。
书里有一句话我划了线:「路由器不做任何推理,它仅是一个查表过程——意图标识是什么,就走哪条路。」
这句话是懂行的人才会写的。做 Agent 的人最容易犯的错,是让主控模型「自己判断该干什么」,结果同一个问题今天走这条路、明天走那条路,评测集上分数忽高忽低,还找不到原因。把路由降级成查表,等于把不确定性关在一个小盒子里——盒子里是意图分类的准确率,盒子外全是确定性的流程。
这套设计有个代价,书里也承认了:五条路互斥,一条消息只落其中一条。那「帮我总结一下这个需求文档,然后拉个待办」这种跨路请求怎么办?书里没正面回答。这是我在第 3 章留下的一个疑问。
五、知识库不上向量库,用 Git + Markdown
第 5 章 5.2.3 节「L3 共享知识库:Git + Markdown 五层结构」,是全书最反潮流的一段。
书里的原话是:在知识库建设上,「我们没有一上来就引入向量库,而是选用 Git(代码版本管理工具)+ Markdown(一种轻量文本格式)来存储」。理由给得很实在:支持差异对比、可回溯历史、可人工修订和可代码化运维,且在几千个项目的规模下完全够用。
然后是一句我认同到想抄下来的判断:「Git 带来的最大好处是知识库的每一次变化都有变更提交记录,某条进度在什么时间、由哪次调度写入,都可查询追溯,这对一个信息中枢来说,可追溯性比检索技术的先进性重要得多。」
这句话值得展开。现在做企业知识库,默认动作是上向量数据库、上 embedding、上 RAG,做得热闹,但很少有人问:当 Agent 告诉你「这个项目延期到 12 月」时,你能查出这句话是哪来的吗?如果不能,这个知识库在项目管理场景里就是危险的——项目管理的核心是「谁在什么时候承诺了什么」,一个记不住出处的系统,等于一个记不清事的助理。
表 5-1 把五层结构列得很清楚。Methods/(项目管理方法论):项目启动会、周会、复盘和风险升级等标准做法,跨项目复用。SOP/(执行步骤):指引 Agent 如何工作的操作规范,例如「文档中识别待办的关键要素有哪些?」。Decision-trees/(决策树):聚焦实际的例子,下钻操作规范没有覆盖的灰色地带,例如「某条待办事项已明确延期,什么时候应该上升?」。Glossary/(术语规范):项目黑话、缩写、内部代号的统一口径,充当跨项目沟通的「对齐字典」。Projects/(项目档案):多项目隔离,一个项目一个目录,分别存放进度、风险、决策、成员。
这五层里,我最喜欢的是 Decision-trees。它承认了规范一定有覆盖不到的地方,而且专门给这些地方留了一层。SOP 告诉你「待办延期怎么办」,决策树告诉你「延期到什么程度该上升」——前一个是流程,后一个是判断。大部分知识库只有 SOP,没有决策树,结果 Agent 一遇到边界就卡住,或者乱来。
Glossary 那一层也聪明。项目里最消耗沟通成本的东西不是文档,是黑话:同一个「上线」在两个团队指两件不同的事。把黑话收进一个可版本管理的文件,比训练一个懂黑话的模型便宜得多。
顺带说一句 5.5 节「已落地的能力矩阵」,这一节我没看到量化收益,只有能力清单。这是我后面要说的短板之一。
六、Harness 衰变:全书最反共识的一条
如果这本书只让我带走一页,我带走 7.1.7 节。
书里先讲现象:「模型在飞速进步。今天我们为了『保下限』而做的硬编码检查、流程兜底和自评纠偏,下一代模型可能直接就覆盖了。」然后给了具体的时间线:某主流大模型 3.0 版本得配一套很严的 Harness 才敢上线;迭代至 3.5 版本,大部分硬编码兜底逻辑已不再需要;演进到 4.8 这一代,过去那些「替模型把关」的脚手架大半可以拆掉,留下的几乎只剩业务边界和外部接口。
结论是一句很重的话:「这意味着 Harness 不是越厚越好,它会随模型变强而自然变薄。如果一个团队把大量精力花在『帮模型兜底那些它下一版自己就会做对的事』上,等于在给一段注定要被删掉的代码做精装修。」
图 7-1 把这条定律画成一条斜线:横轴是模型能力,纵轴是 Harness 厚度,曲线一路往下,右端标注「剩下业务边界 + 外部接口」。
表 7-1「工程精力投放原则」是这条定律的操作版,分两栏。该重投入的(模型短期解不了):业务边界(什么是「项目」、怎么分级、虚拟交付团队怎么运作)、外部接口(主数据、IM 管道、需求系统对接)、领域 Source of Truth(组织记忆、权限治理、PMO 经验库)。该轻投甚至别投入的(下一版模型会吸收):硬编码的格式检查、流程兜底,过度精细的自评纠偏脚手架,替模型做它本就会做的推理。
这套划分为什么有用?因为它给了一个不看模型版本的判断标准:问自己一句「如果下一代模型变强了,这块代码还在不在」。答案在,就值得投;答案不在,就别投。
我要补充一句自己的看法:这条定律有个反面风险,书里没提。「等模型变强」是一句永远正确的话,但它可以被用来拖延一切工程投入。真实的组织里,一定会有人说「这个兜底别做了,下一版模型就好了」,然后模型半年没升级,事故出了一堆。衰变定律说的是「别给注定被删的代码做精装修」,不是「别装修」。业务边界、外部接口、Source of Truth 这三样,恰恰是最难做、最不容易被模型替掉的,也最容易被「等模型」这个借口无限期推迟。
另外,这条定律的适用范围要说清。它讲的是「Harness 层」——包在模型外面的那层工程。往里一层(模型能力)和往外一层(业务价值),衰变速度完全不同。把「Harness 会变薄」推成「什么都别做」,是对这条定律最常见的误读。
第 7 章另外五条心得,基本是这条定律的注脚。7.1.3 叫「模型探上限,工程保下限」,7.1.4 叫「主数据完整度扩充建设优先于使用场景的扩展」,7.1.5 叫「用 Git 做知识工程,比用 Wiki 更好」,7.1.6 叫「领域 Agent 的本质,是领域的 Source of Truth」,7.1.1 叫「先动起来比制定一个完美方案更重要」。六条心得里,没有一条是「我们的架构很先进」,全是「我们把什么放在了什么前面」。这个排序感,比任何一张架构图都更像经验。
七、它的短板
第一,样本只有一家公司,且没有任何量化收益。全书讲的是小红书 PMO 的自建史。书里提过「几千个项目的规模」,也提过安全部门从「皱眉头」到认可这是「最好的管控方案」,这些都是好信号。但读者最想知道的两个数——这个 Agent 让 PMO 少花了多少人天、项目平均延期率降了多少——一个都没有。第 5 章 5.5「已落地的能力矩阵」只有能力清单,没有效果表。这让「成功」变成了一个无法验证的断言。
第二,内部代号太多,没有术语表。Claw(第 4 章 4.1.2)、Clawith(4.3.1)、OpenClaw(4.4.1)、PMOBP(第 5 章)、Auto Dream(5.3),五个名字分散在四章里,而且彼此的关系需要读者自己拼:Claw 是能力层,Clawith 是底座,OpenClaw 是进群的那个分身,PMOBP 是项目专属 BP,Auto Dream 是让对话反哺知识库的机制。一本书里出现五个自有名词,却不在开头给一张对照表,是编辑上的失职。我读到第 5 章时不得不回头翻第 4 章确认 Claw 和 OpenClaw 是不是一个东西。
第三,附录比正文厚,暴露了这套东西的地基在哪。附录 A 65 屏讲干系人、KO 会、会议体系、复盘、风险升级,附录 B 38 屏给八套模板。这两块加起来 103 屏,占全书的 24.9%,比五个技术版本里任何一个都厚。这不是缺点,反而说明作者清醒;但它也说明:这本书的「AI 部分」,是长在传统项目管理方法论上的嫩枝。如果你不懂项目管理,直接跳到第 3 章学 Agent 架构,会看不懂它在解决什么问题。
第四,模板是提纲,不是文件。附录 B 的八套模板(立项/规划、启动会、大型项目 OKR 对齐、OKR 及交付物拆解、周会材料、风险登记册、复盘、大型项目运作机制),给的是层级标题加填写说明。比如立项模板里分了「情形一/二/三」:立项部分通过、但决策会对资源规划有异议,需要单独对资源二次说明;立项不通过、方案与资源均不通过,后续如要继续推动需重新做项目评审。然后才是「1. 项目背景」「2. 项目目标」「2.1 项目预期产出/高阶方案」。这些内容有用,但读者拿不到可直接填的表。书里也没给下载地址。
第五,目录有几处接不上。第 5 章的小节从 5.2 直接跳到 5.2.2,第 6 章从 6.3.1 跳到 6.3.3、从 6.5 跳到 6.5.2 再跳到 6.5.4。这些大概是二级小节没单列,不算错,但读的时候要靠正文自己把编号接上,体验不好。
第六,写给两类读者的第 8 章,其实只写了一类半。8.1 个体路径给了五步(先从单渠道跑通、安全可控先于功能、记忆管理要早做、先用 Skill 解决不行再上工具、遇到第一个失败 Case 就建立评测),加一份八条反模式自检清单,写得很实。8.2 组织路径给了六项前置准备(主数据底座、知识工程底座、安全治理、评测体系、Skill 库、角色感知),每项下面只有三五段。对一个真要推动组织变革的 PMO 负责人来说,这六项每一项都够写一章,这里只够列个清单。
八、一句话
这本书最值钱的不是那张五版架构图,是它用五个版本换回来的一句成本账:你为模型兜的底,一半会在它升级后变成负债;真正不会贬值的是业务边界、外部接口和领域的事实来源。它把「AI 项目管理」这件事从概念拉回到了 git 提交记录、Top-K 从 8 调到 3、以及「待办延期到什么时候该上升」这样的具体判断上——这比任何一句「AI 重塑项目管理」都有用。
阅读记录:《项目管理红宝书:小红书 PMO Agentic 项目管理实战》,李斌、蒋中杨等著,微信读书 413 屏,8 章 151 节加附录 A、B,2026-11-17 逐页读完(end=last_page,334 秒)。文中屏数为逐页统计的实际值:文前 33 屏,第 1 至 8 章依次 21/40/40/35/38/36/25/42 屏,附录 A 65 屏、附录 B 38 屏,合计 413 屏,与总数核对一致。表 1-2、3-2、5-1、7-1、8-10 的条目均按截图原文摘录,未作改写。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: