
大模型动力引擎:它先教你量体温,药只给了 24 屏
微信读书《大模型动力引擎——PyTorch 性能与显存优化手册》· 本次逐页翻阅 388 屏,从版权信息读到「结语」,10 章 162 节全部覆盖,抓取标记为全书读完(end=last_page),耗时 343 秒。
说明:这是一本工程手册,评价标准跟读理论书不一样。我只问三件事:它给的数字能不能复现、它给的方法能不能搬到别的机器、以及它有没有把「不灵的时候怎么办」写出来。
388 屏,10 章,162 节。平均每章 39 屏、每节 2.4 屏。
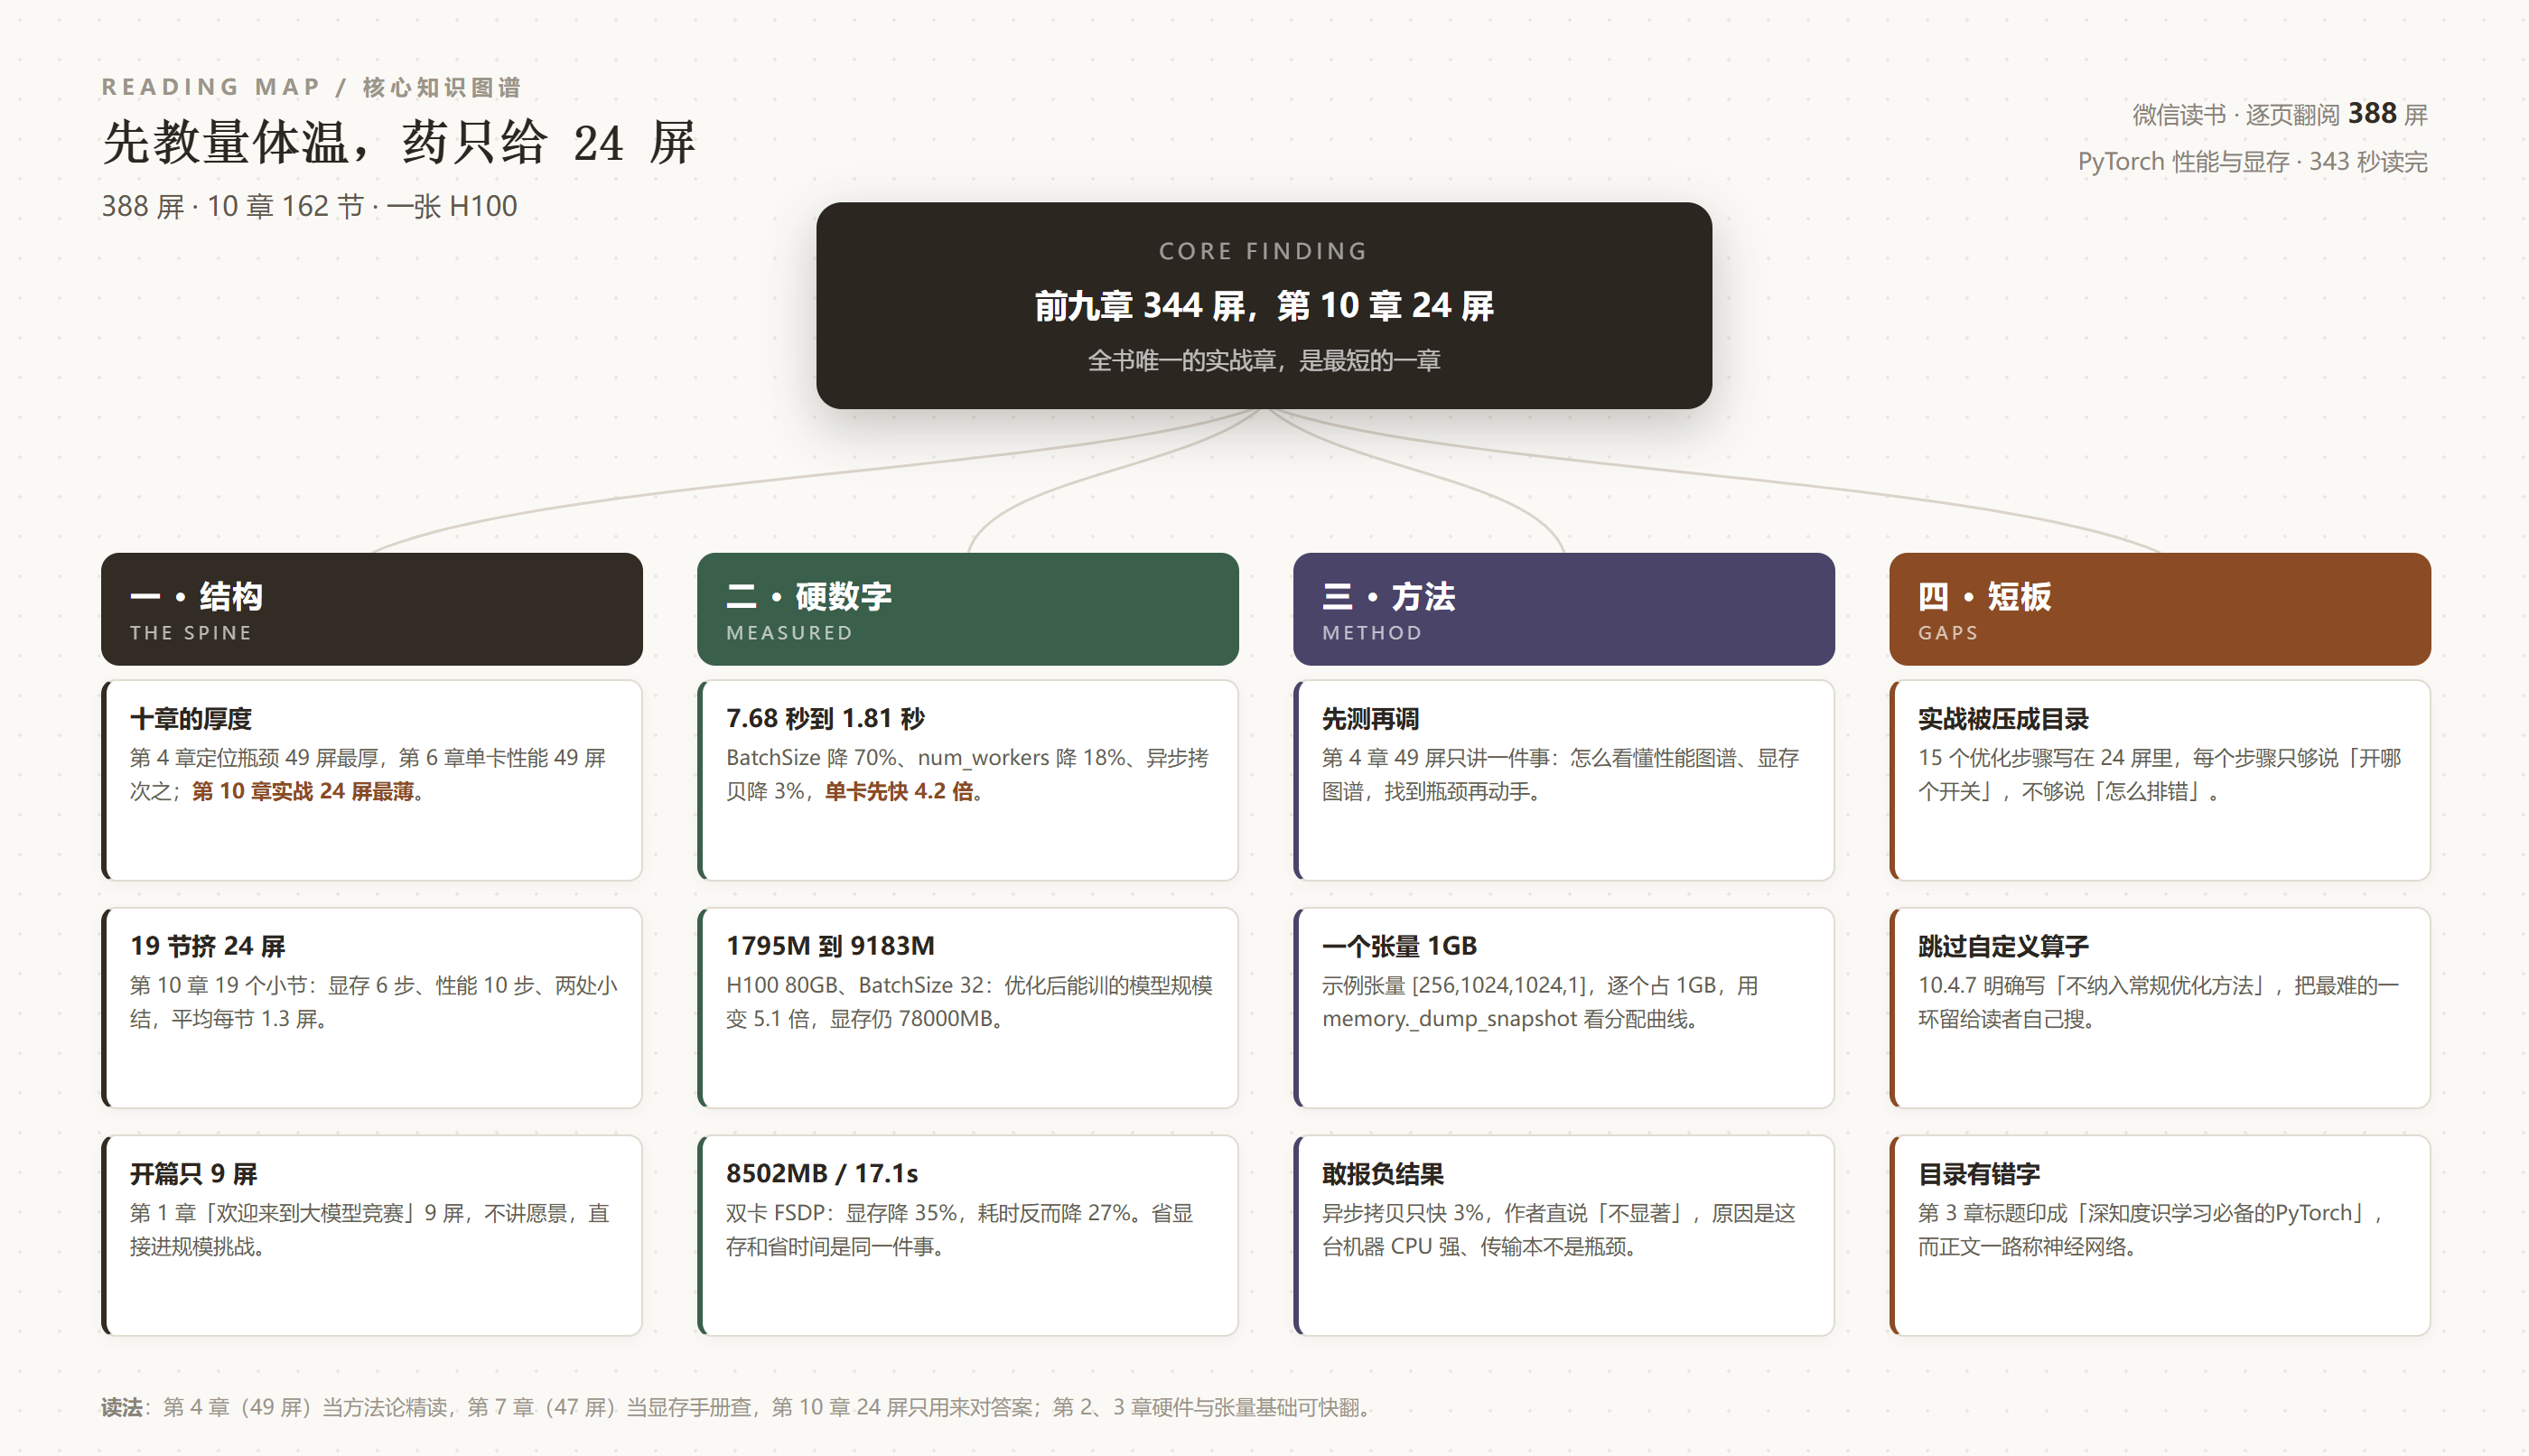
先给结论:这是一本罕见的「先教你测量、再教你优化」的书;但它把测量写成了 49 屏,把优化写成了 24 屏。
前九章加起来 344 屏,讲硬件、讲 PyTorch 内部、讲怎么看性能图谱、讲数据加载、讲单卡性能、讲单卡显存、讲分布式、讲混合精度与编译。第 10 章「GPT-2 优化全流程」——全书唯一的端到端实战——只有 24 屏。而这 24 屏里塞了 19 个小节:显存优化 6 步、性能优化 10 步、两处小结,还有一节明确说「这个我们跳过」。平均每个优化动作 1.3 屏。
我读完的第一反应是「虎头蛇尾」。但把第 4 章重读一遍之后,我改了判断:这不是偷懒,这是作者对「优化」这件事的真实理解——难的不是开关,是知道该开哪个。只是他没把这个理解贯彻到底:知道了该开哪个之后,还得知道开了不灵怎么办,而这一步他留白了。
一、先把账本摊开
逐页统计:文前 10 屏(2.6%);第 1 章「欢迎来到这场大模型竞赛」9 屏(2.3%);第 2 章「深度学习必备的硬件知识」35 屏(9.0%);第 3 章「深度学习必备的 PyTorch」44 屏(11.3%);第 4 章「定位性能瓶颈的工具和方法」49 屏(12.6%);第 5 章「数据加载和预处理专题」37 屏(9.5%);第 6 章「单卡性能优化专题」49 屏(12.6%);第 7 章「单卡显存优化专题」47 屏(12.1%);第 8 章「分布式训练专题」39 屏(10.1%);第 9 章「高级优化方法专题」36 屏(9.3%);第 10 章「GPT-2 优化全流程」24 屏(6.2%);结语 3 屏。
这个分布有两处值得说。
第一处:第 1 章只有 9 屏,这是全书最痛快的决定。一本讲大模型的书,开篇不讲参数量的历史、不讲 Transformer 的论文、不讲「AI 的第三次浪潮」,9 屏讲完「模型规模和数据规模各自带来什么挑战」,然后立刻进 GPU 的硬件结构。它默认读者已经知道大模型是什么,只想知道它为什么跑得慢。这个默认省掉了至少 50 屏废话,也筛掉了不该读这本书的人。
第二处:第 4 章 49 屏,是全书最厚的一章,而且它一个字都没教你怎么优化。整整一章只干一件事:怎么把「慢」这件事量出来。减少无关程序的干扰、控制 GPU 频率、控制 CPU 的性能状态与工作频率、精确计量 CPU 与 GPU 的运行时间、程序预热后多次运行取平均、用 PyTorch 的性能分析器看性能与显存、用 Nsight Systems 和 Nsight Compute 做专业分析、用 Py-Spy 和 strace 看 CPU 侧到底卡在哪。
把「测量」放在「优化」前面,而且是全书最厚的一章,这个排序本身就是一种立场。它等于在说:绝大多数性能问题,不是因为你不知道那些优化技巧,而是因为你不知道瓶颈在哪,所以把十个技巧全试了一遍,速度没变,代码烂了。
二、第 4 章那 49 屏,是这本书真正值钱的地方
我一直觉得,「性能优化」这个领域最缺的不是技巧,是方法论,而方法论的入口是「可重复的测量」。这本书在这一章里把这件事做到了少见的细。
先说可重复性。4.1.2 节讲怎么让 PyTorch 程序每次跑出一样的结果。它没有停在「设个 seed」,而是把三套随机源分别处理:PyTorch 的、NumPy 的、Python 的。原文解释了为什么这么麻烦——「这主要是因为 Python 生态系统中缺乏一个统一的随机数生成标准库。NumPy、PyTorch 和 TensorFlow 等库在处理随机数生成时,各自有不同的实现和优化方式,因此,没有一个统一的方法可以集中控制 Python 程序中所有库的随机数种子。」
然后它说了一句很实用的:torch.manual_seed() 固定了所有后继的随机数生成种子之后,连 Dropout 层的随机性也被固定了,「每次运行时,Dropout 层会在相同的位置丢弃神经元,这确保了结果的可重复性」。
这一段的价值在于它解释了「为什么麻烦」,而不是只给「怎么办」。你照着复制三行代码也能跑,但下次遇到 TensorFlow 或者某个第三方库自己的随机源,你还是不知道怎么下手。知道「Python 生态没有统一随机源」这个事实,你就知道这件事永远不可能一劳永逸,只能一处一处堵。
再说时间计量。4.2 节讲的是最容易被跳过、也最容易出错的部分:为什么要预热、为什么要多次运行取平均、为什么用 time.time() 量 GPU 程序的时间是错的(异步执行,函数返回了但核还没算完)、怎么精确计量 GPU 的运行时间。这些内容在博客里几乎找不到系统的讲法,因为写博客的人自己也常犯这个错。
然后是工具。4.3 节讲 PyTorch 自带的 profiler:怎么同时看性能和显存、怎么把结果可视化、怎么从图谱里定位瓶颈。4.4 节讲 Nsight Systems 与 Nsight Compute 的分工——一个看系统级的时间线(CPU 在干什么、GPU 在等什么),一个看单个核函数内部的效率。4.5 节讲 Py-Spy 和 strace,用来看 Python 侧的函数调用耗时和系统调用。
这套工具链是有层次的:先看全局时间线(哪有空洞),再看单核效率(空洞里的计算够不够满),最后看 Python 层(是谁在拖后腿)。知道这三层的区别,你才知道自己该打开哪个工具;不知道,就会拿着 Nsight Compute 去查一个其实是 DataLoader 卡住的问题,查一整天。
还有一个细节我很喜欢:4.1 节在讲工具之前,先讲「怎么让测量环境本身别捣乱」——减少无关程序的干扰、控制 GPU 频率、控制 CPU 的性能状态与工作频率。这几件事听起来像机房管理,其实是测量的前提。GPU 会因为温度升高自动降频,你在不同时间跑同一个脚本,能测出两个不同的数;CPU 的省电策略会让频率忽高忽低,你测出来的「优化收益」可能只是电网的抖动。不知道这些,你优化的不是代码,是运气。
三、硬件和 PyTorch 那 79 屏:把「为什么慢」写成可数的
第 2 章 35 屏讲硬件,第 3 章 44 屏讲 PyTorch 内部。这两章是全书的地基,也是最容易写成「计算机组成原理复习」的地方,作者躲开了这个坑。
它讲 GPU 的方式是先给对比:CPU 的局限性(核少、擅长复杂控制流)、GPU 的硬件结构(大量简单的计算单元)、GPU 的编程模型与硬件的对应关系(线程、线程块、网格分别映射到什么)、GPU 的关键性能指标、显存与内存之间的数据传输。然后 2.4 节讲分布式:单机多卡怎么通信、多机多卡怎么通信、分布式系统的数据存储怎么组织。
「显存与内存间的数据传输」这一节单独成篇,是有讲究的。因为后面第 6 章讲「减少 CPU 和 GPU 间的同步」、第 10 章讲「使用异步接口完成数据传输」,全都建立在这一节的理解上。它把一个物理事实(数据要通过 PCIe 搬过去)变成了后面所有优化的前提。读者如果跳过这节直接看第 10 章,会觉得那些 non_blocking=True 是玄学。
第 3 章 44 屏讲 PyTorch,讲得也很有针对性:张量的存储方式与视图(为什么 view 不复制数据、reshape 可能要复制)、算子的内存分配(为什么一个看起来很轻的操作会偷偷开一块新显存)、动态图机制、自动微分系统、异步执行机制。
这五件事,正好对应五类最常见的「莫名其妙的慢」和「莫名其妙的 OOM」。张量视图没搞清,就会在循环里不停复制大张量;算子内存分配没搞清,就会以为「我只加了一个数,怎么会多用 1GB」;异步执行没搞清,就会用 time.time() 量出一个漂亮但虚假的加速比。
而且第 3 章的目录标题里藏了一个错字:「03 深知度识学习必备的PyTorch」——「深度学习」四个字被印成了「深知度识学习」。这个错在全书目录里,正文里一路都是正常的「深度学习」。这是个排版事故,不影响阅读,但出现在一本讲工程的书的目录上,多少有点讽刺:一本教你「精准测量」的书,自己的目录没校对。
四、显存那 47 屏和性能那 49 屏:一堆能对得上的数
第 6 章「单卡性能优化」和第 7 章「单卡显存优化」是全书的主体,合计 96 屏。这两章的结构是一样的:先讲「免费的方法」,再讲「有代价的方法」。这个划分很诚实——优化从来不是白拿的,每一分显存或每一毫秒都是用别的东西换的。
第 7 章的显存分析部分给了一个我觉得很妙的演示:造两个形状为 [256, 1024, 1024, 1] 的张量,每个的显存占用正好是 1GB,然后用 torch.cuda.memory._dump_snapshot() 导出一份 vram_profile_example.pickle,上传到 PyTorch Memory Visualization 网站上看显存占用随时间的变化。原文说:「在这个工具中,通常主要关注 Active Memory Timeline 这一默认视图,它展示了显存的主要活动和占用情况……每一个单色条幅都代表一个新的张量的显存占用,条幅的起点和终点也自然对应着显存的分配和释放。」
「1GB 一个色条」这个设计很聪明。因为它把抽象的数字变成了看得见的方块:你一眼就能看出哪一步分配了两块、哪一步释放了一块、峰值出现在哪。这比看 torch.cuda.max_memory_allocated() 返回一个 12345MB 有用得多——后者只知道结论,前者能看到过程。
第 7.5 节讲「有代价的显存优化」,四条:跨批次梯度累加、即时重算前向张量(也就是 gradient checkpointing)、把 GPU 显存下放到 CPU 内存、降低优化器的显存占用。每条都标了代价,这一点我很认可——梯度累加换的是时间(多跑几次前向),重算换的也是时间(前向跑两遍),下放换的是带宽(CPU 内存更慢),优化器换的是收敛(8-bit 或 for-loop 模式会影响数值)。
第 6 章的性能优化同样是「免费的先来」:提高数据任务并行度、异步提交传输、让传输与计算重叠、增大 BatchSize、使用融合算子、减少 CPU-GPU 同步、避免张量创建开销、关掉不必要的梯度计算。然后才是有代价的:低精度拷贝、性能特化的优化器实现。
我最欣赏的是这两章里随处可见的「但是」。比如讲异步拷贝那一节,它给的结果是「平均时间下降到 1.81s,标准差为 0.01s。虽然有一定的优化效果,但是并不是特别显著,这主要是由于训练机器的 CPU 能力比较强,因此数据传输不太构成训练的主要瓶颈点」。
这句话比任何一个漂亮的加速比都珍贵。因为它告诉你:同一个技巧,在别人的机器上可能提升 30%,在你的机器上可能只有 3%,差别不在代码,在瓶颈的位置。一个作者愿意把「我做了这个优化,效果不明显」写进书里,说明他不是在卖技巧,是在教判断。
五、第 10 章那 24 屏:7.68 秒到 1.81 秒
现在说第 10 章。24 屏,是全书最短的一章,但它给了全书最完整的一条数字链。
先交代实验条件:GPT-2 模型,一张 H100 80GB,BatchSize 32。然后是一张流程图,把每一步的瓶颈和效果串起来:
这条链有两个地方值得停下来看。
第一,收益的分布是断崖式的。第一步 BatchSize 拿走 70% 的收益,第二步 num_workers 拿走 18%,第三步异步拷贝只剩 3%。也就是说,7.68s 到 1.81s 这 4.2 倍,绝大部分是前两步贡献的,而前两步都指向同一个原因:GPU 在等。等队列空、等数据来。真正「让计算变快」的优化(图优化、混合精度)还没登场。
这个分布是性能优化最真实的规律:绝大多数「模型训得慢」的问题,不是算得慢,是没喂饱。一个 GPU 空转着等数据,你把核函数优化到极致也没用。这本书用一条链把这件事讲清楚了,比讲一百个融合算子都有价值。
第二,它承认了第三步没用。1.87s 到 1.81s,3%,标准差 0.01s。作者明说「并不是特别显著」,原因是这台机器的 CPU 强,传输本来不是瓶颈。这种诚实让整条链的可信度大幅提升——如果他只报前两步,你会怀疑他藏了什么;他把不灵的那步也报出来,你就愿意相信前面的数字。
显存那条线同样给足了数。图 10-8 是一张整合图:用 for-loop 模式优化器后,显存 13108MB(-15%),耗时 23.5s(+2%)——注意那个 +2%,省显存是要拿时间换的,作者把代价直接标在箭头上。再加双卡 FSDP 后,显存 8502MB(-35%),耗时 17.1s(-27%)。
最后这一组数字是全书最反直觉的一处:省显存和省时间,在这里是同一件事。单卡时,FSDP 换来换去都是拆东墙补西墙;一上两张卡,显存降 35% 的同时时间也降 27%——因为瓶颈从「显存不够、只能用很小的 BatchSize」变成了「两张卡的算力一起上」。这提醒读者一件事:优化的顺序不是「先省显存再提速」,很多时候是「先加卡,两个问题一起解」。
然后是那个最漂亮的结论:在 H100 80GB、BatchSize 32 的条件下,优化前最大能训 1795M 参数的模型(显存 77388MB),优化后能训 9183M(显存 78000MB),规模变成 5.1 倍。原文还补了一句:「如果进一步降低 BatchSize 则还可以再次扩大模型规模。」
5.1 倍这个数字,是这本书的立论基础。它说明显存优化不是「抠门技巧」,而是「把不可能变成可能」——同一张卡,能训的模型大了五倍,这意味着很多团队不用买新卡就能继续做下去。一本书如果能给你一个这样的数,前面 344 屏的铺垫就不算白读。
六、它的短板
现在说问题。这本书的短板不像很多技术书那样「水」,它的问题恰恰在反面:它太克制了,克制到把最需要的部分压缩成了提纲。
短板一:实战章被压成了目录。第 10 章 24 屏、19 个小节,平均 1.3 屏。1.3 屏能干什么?能说「打开这个开关,耗时从 7.68s 降到 2.28s」,不能说「如果你的 BatchSize 加到 64 就 OOM 了,该退回哪一步」。而真实调优里,90% 的时间花在后者。这一章的每一节都像是给已经会的人看的备忘,不是给不会的人看的教程。如果作者愿意把这一章扩到 80 屏,把每一步的「失败情况 + 回退方案」写出来,这本书的价值会翻倍。
短板二:最难的一环明确跳过了。10.4.7 节「(可选)使用自定义算子」原文写:「不管是编写自定义算子,还是套用开源实现,其适配和调试过程通常比较烦琐。综合考虑下来,我们在示例中就不将自定义算子纳入常规优化方法之列了,欢迎有兴趣的读者朋友自行搜索对应领域的高性能算子实现。」
我理解这个取舍——CUDA 算子那套东西确实不适合塞进一本讲 PyTorch 的书。但我要指出的是:在真正的极限优化里,自定义算子往往是最后一公里的必经之路。FlashAttention 就是这么来的。这本书把它标成「可选」并跳过,等于承认了自己的天花板:它教你在框架内把性能榨到 80%,剩下 20% 它不教。
短板三:分布式只有 39 屏,而且是「双卡级」的分布式。第 8 章讲集合通信原语、数据并行、DDP 封装、FSDP、张量并行,内容是对的,但规模太小——第 10 章的 FSDP 示例只用了 2 张卡,多机多卡那节也只是「在两台机器上分别启动训练即可」。真实的分布式训练是 64 卡、128 卡,会遇到 2 卡根本遇不到的问题:网络拓扑、NCCL 超时、某张卡掉线导致整个作业挂掉、checkpoint 要写 30 分钟。这些书里一个字没有。这不是作者的错(他显然没有那种规模的机器),但读者必须知道:这本书的「分布式」和工业界的「分布式」,是同名不同物。
短板四:它不教「优化失败」。这是全书最系统性的一个缺口。每一个优化都写成了「开启后变快」,没有一处写「开启后变慢 / 报错 / 精度掉了」。而实际工作中,torch.compile 编译失败、混合精度导致 loss 变 NaN、FSDP 配置错了直接 hang 住,都是日常。一本 388 屏的手册,如果有一章叫「优化出问题了怎么办」,它就从「参考书」变成「救命书」。现在它只是参考书。
短板五:版本漂移的风险没交代。第 9 章的重头戏是 torch.compile(计算图提取、图优化、后端代码生成),这是 PyTorch 2.x 才有的能力,而且还在快速演进。书中给的具体行为、具体报错、具体的加速比,很可能在下一个版本就变。作者在别处很谨慎,唯独在这里没有加一句「以下结论基于哪个版本」的提醒。对一本手册来说,这是个隐患——三年后有人照着敲,跑不通会以为是自己的问题。
短板六:所有数字都长在同一台机器上。第 10 章的实验环境是 H100 80GB,第 6 章的异步拷贝那组数据也带着「这台机器 CPU 比较强」的前提。这没有错,但缺一张对照表:同样这套流程,在一张 4090 上跑,收益分布会变成什么样?在只有 32GB 内存的机器上,num_workers 还能开那么大吗?书的读者绝大多数没有 H100,他们最想知道的是「我这张卡能抄哪几步」。这个问题,书里没有答案,只能靠读者自己做第 4 章教的那套测量——从某种意义上说,这也算自洽,但对读者不够体贴。
还有一条不算短板但值得说:这本书的前言把边界写得很清楚。「本书不涉及模型架构的算法讲解」「本书通常不会介绍 PyTorch 等工具的 API 接口和参数设置细节」,还老实承认「AI 系统工程是个非常宽泛的交叉领域,无论是书籍的篇幅还是笔者的实际经验都有一定的局限性」。先把「我不讲什么」写在前面,后面跳过自定义算子就不算欺骗。这一点比很多书强——很多书是写完了不承认,它是开篇就承认。
七、谁该读,怎么读
如果你正在被「模型训不动」折磨:这本书是解药,但只解一半。它能帮你判断瓶颈在哪(第 4 章)、能帮你把显存压下去(第 7 章)、能告诉你哪些开关值得开(第 6 章)。它不能帮你处理「压到极限还差 20%」的情况——那部分得去看 FlashAttention、vLLM 的源码,或者读 Nsight Compute 的文档。
如果你是要做工程落地的算法工程师:强烈推荐,而且建议按第 4 → 7 → 6 → 10 的顺序读。先学会测量,再学显存(显存不足是最常见的硬墙),再学性能,最后看全流程当对答案。第 2、3 章当参考,遇到不懂的硬件或 PyTorch 行为再回去查。
如果你是学生或刚转行:这本书偏难,不建议当第一本。它默认你会写 PyTorch 训练循环、看得懂 profiler 的时间线、知道什么是集合通信。它是一本「第二本书」——你已经能跑通训练,但不知道为什么慢。那才是它的目标读者。
如果你只是想了解「大模型训练要多少卡」:读第 1 章 9 屏 + 第 10 章 24 屏就够了。33 屏,能拿到这本书最核心的两个判断:规模带来的挑战是什么、优化能换来多少空间(5.1 倍)。
给一个省时间的读法:第 4 章(49 屏)精读,这是方法论;第 7 章(47 屏)精读,这是最常撞的墙;第 6 章(49 屏)快读,因为很多招你已经知道;第 8、9 章(75 屏)按需读,不做分布式和编译可以先放着;第 10 章(24 屏)一定要读,但读的时候要意识到它是提纲,不是教程。这样 145 屏能拿到全书八成。
八、一句话收尾
这本书最好的地方,是它把「优化」从一堆技巧变成了一套测量流程——先量,再改,改完再量。它最遗憾的地方,是它只把这套流程走完了一次,而且走得很赶:24 屏、19 节、15 个开关,每个开关只够说一句「开了就快」。
但我不认为这是敷衍。相反,一本愿意用 49 屏教你「怎么量」、只用 24 屏教你「怎么改」的书,比一本用 300 屏列技巧、5 屏提一句「记得测试」的书,更懂工程。因为工程里真正稀缺的不是技巧,是判断;而判断只能来自测量。
所以我的结论是:把它当「诊断手册」,别当「药方大全」。它能让你知道病在哪,能给你几味常用的药,但它不会陪你熬到病好。剩下那段路,得你自己在 profiler 的时间线上爬。
书名:大模型动力引擎——PyTorch 性能与显存优化手册
本次阅读:微信读书逐页截图 388 屏,版权信息 + 作者简介 + 内容简介 + 前言 + 10 章 162 节 + 结语,从版权信息至「全书完」,耗时 343 秒,抓取标记
end=last_page。未读到:无。全书一次抓完,无会员卡遮挡、无章节缺失。
判断依据:章屏数按 pages.jsonl 逐页章节归属统计(01 章 9、02 章 35、03 章 44、04 章 49、05 章 37、06 章 49、07 章 47、08 章 39、09 章 36、10 章 24);引文与数字均来自截图原文,页码为本次截图编号(如 p0372 即第 372 张截图)。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: