
从零构建大模型:它把黑箱拆成了代码,可惜拆的是个小盒子
微信读书《从零构建大模型》(Sebastian Raschka 著,中文版)· 本次逐页翻阅 616 屏,从版权信息读到「看完了」,7 章 + 5 个附录全部覆盖,抓取标记为全书读完(end=last_page),耗时 807 秒。
说明:这是一本要你动手敲代码的技术书,不是那种翻完就能写读后感的书。所以我的判断只围绕三件事:它给的代码能不能跑出它说的数、它省的步骤是不是可以不省、以及它回避了什么。
616 屏,7 章,5 个附录。平均每章 61 屏。
先把最重要的一句话放前面:这本书是我今年读过的最诚实的一本 AI 技术书,而它最诚实的地方,恰恰是它承认自己不够大。
正文七章加起来 429 屏,五个附录 172 屏——附录占了全书的 27.9%。更刺眼的是单看最厚的那一本:附录 A「PyTorch 简介」64 屏,而第 1 章「理解大语言模型」只有 31 屏。讲工具的部分,比讲对象的部分厚一倍。
我一开始把这当成缺陷,读到第 4 章改了主意。
一、先把账本摊开:429 比 172
逐页统计,屏数分布是这样的:文前 13 屏(2.1%);第 1 章「理解大语言模型」31 屏(5.0%);第 2 章「处理文本数据」60 屏(9.7%);第 3 章「编码注意力机制」73 屏(11.9%);第 4 章「从头实现 GPT 模型进行文本生成」60 屏(9.7%);第 5 章「在无标签数据上进行预训练」67 屏(10.9%);第 6 章「针对分类的微调」60 屏(9.7%);第 7 章「通过微调遵循人类指令」78 屏(12.7%);附录 A「PyTorch 简介」64 屏(10.4%);附录 B「参考文献和延伸阅读」21 屏;附录 C「练习的解决方案」20 屏;附录 D「为训练循环添加更多细节和优化功能」14 屏;附录 E「使用 LoRA 进行参数高效微调」53 屏(8.6%)。
这个分布里有两处值得单独说。
第一处:第 1 章只有 31 屏,这是全书最正确的取舍。大多数中文 AI 书在第 1 章要花掉 80 到 120 屏讲「什么是人工智能」「三次浪潮」「图灵测试」,讲完读者还是不会写一行代码。这本书 31 屏就把 Transformer、编码器/解码器、GPT 与 BERT 的分野讲完,然后立刻进代码。原文那句「理解大语言模型的最佳方式是从零开始编写一个模型——你会发现这件事充满乐趣!」不是口号,是它对自己篇幅的分配原则。
第二处:附录 A 的 64 屏,比第 1 章还厚。这一开始让我不舒服:你卖的是「构建大模型」,为什么三分之一的书在教 PyTorch 的 torch.tensor?但把附录 A、C、D、E 合起来看(64+20+14+53=151 屏),逻辑就出来了——这四篇附录不是补充,是脚手架。附录 A 负责让不会 PyTorch 的人能起步,附录 C 给所有练习的标准答案,附录 D 补训练循环的工程细节(学习率预热、梯度裁剪那类),附录 E 把 LoRA 这个 2023 年之后最实用的微调手段单独拎出来讲 53 屏。
换句话说:这本书把「教材」和「手册」装订在了一起。正文是教材,按顺序读;附录是手册,卡住了去查。装订在一起的代价是厚度虚高,好处是你不需要第二本书。
还有一点设计我要单独肯定:七章每章末尾都有「小结」,而且每章都埋了练习,答案统一放附录 C。这个闭环在技术书里不常见——大多数书要么没练习,要么练习没答案,读者做完不知道自己对不对。它把「自我检查」做成了结构的一部分:你在第 3 章算完注意力权重,可以去附录 C 对答案;你在第 5 章调完温度,可以拿练习 5.1 问自己「在每种温度下,pizza 被采样的频率是多少」。
练习题的提问方式也很克制。它不问你「温度的作用是什么」(这种题背一遍定义就能答),它问你「在每种情况下,单词 pizza 被采样的频率是多少?你能想到一个更快、更准确的方法来确定 pizza 被采样的频率吗?」——第一问要你跑代码,第二问要你想办法。第二问才是真正值钱的那一问,因为它逼你从「会跑」走到「会测」。
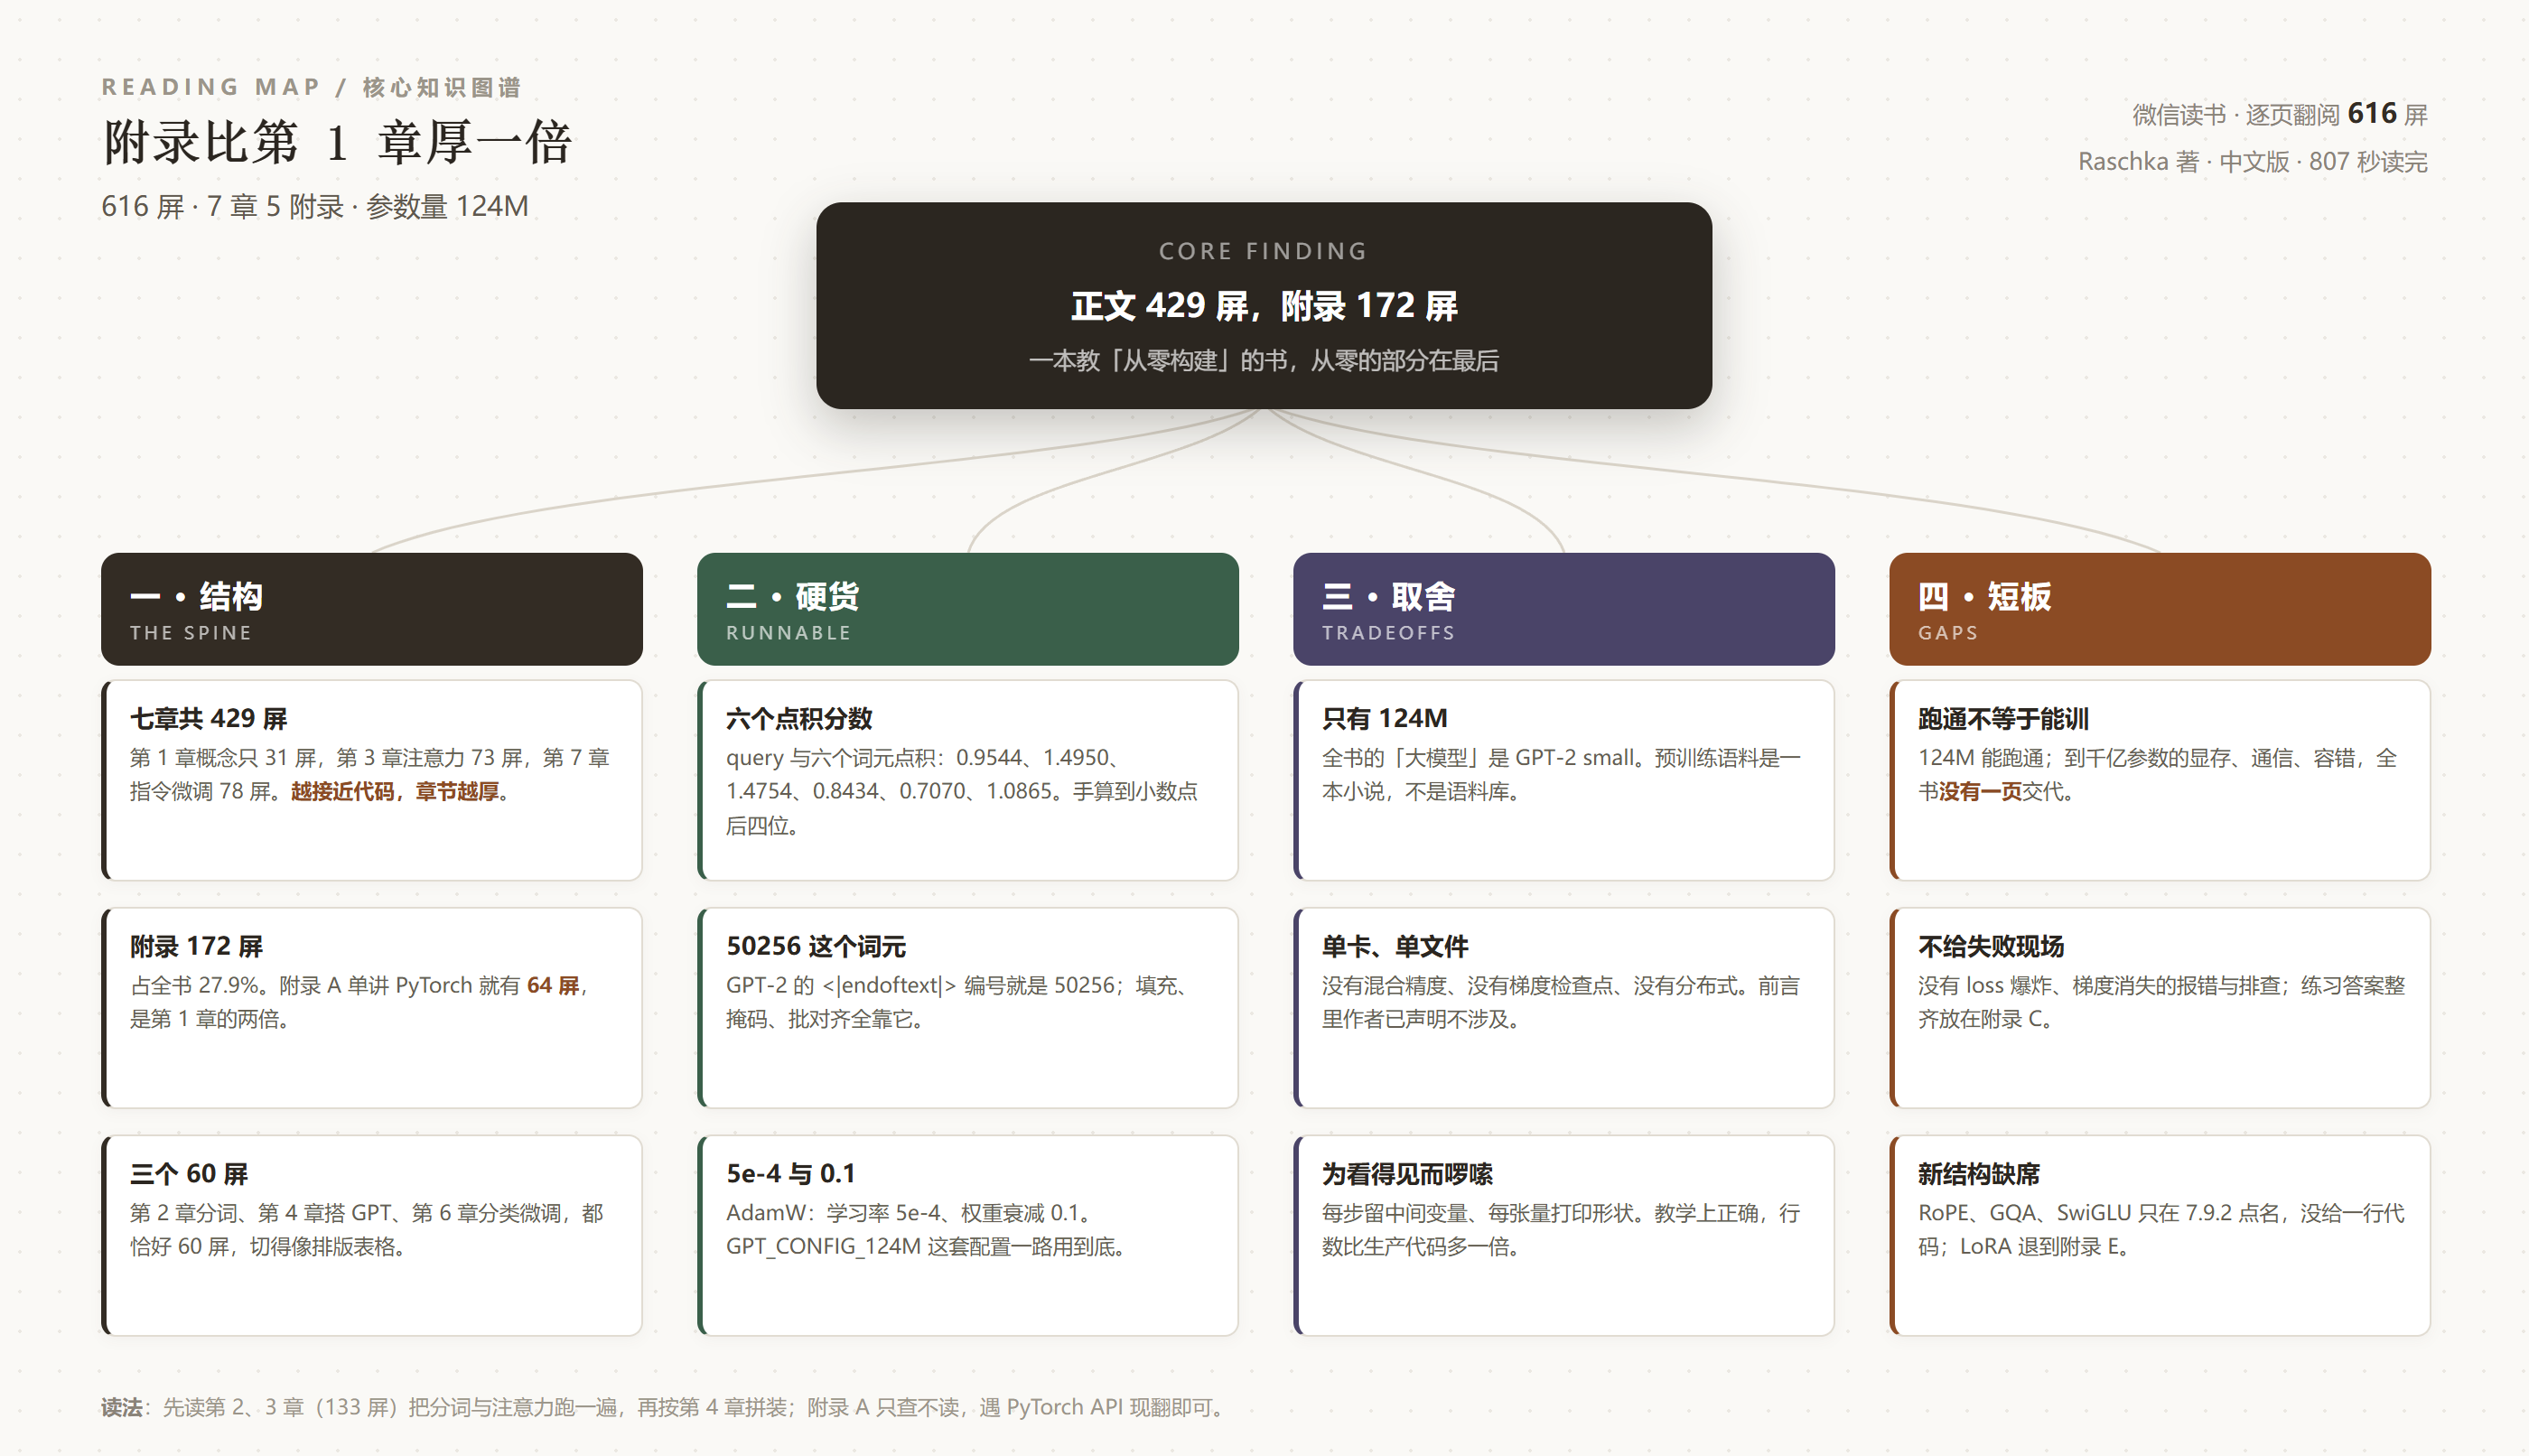
二、第 3 章那 73 屏,是全书最值钱的部分
第 3 章「编码注意力机制」73 屏,是七章里第二厚的。它也确实是全书最值得付钱的地方。
注意力机制被讲烂了。绝大多数材料给你一个公式:softmax(QKT/√dk)V,然后说「这就是注意力」。你会背,但你不懂为什么除以根号 d、为什么要有 Q/K/V 三个矩阵、为什么是点积不是别的。这本书的做法是:不算公式,先手算。
它把一句话切成六个词元,取第二个词元作 query,然后一个一个做点积,打印出结果:
六个分数,小数点后四位,明明白白摆在那里。这一行的价值在于它可被验证:你可以拿这六个数去核对自己算的到底对不对。技术书最稀缺的品质就是这个——不是把结论告诉你,是把中间过程摆到你能复核的精度。
紧接着它讲「理解点积」:点积本质上是两个向量逐元素相乘再求和。然后它给了两种写法——一种用 for 循环手写 res += inputs[0][idx] * query[idx],一种直接 torch.dot(inputs[0], query),让读者看见两者等价。这是很笨的教学法,也是最有效的教学法。因为「等价」这件事,说出来是一句话,跑出来才是一个认知。
第 4 章讲层归一化时又来了一次。它没有停在「LayerNorm 沿着特征维归一化」,而是用 dim 参数把张量的形状问题摊开:一个二维矩阵,dim=1 和 dim=-1 是等效的,因为 -1 指最后一个维度;到了三维张量 [batch_size, num_tokens, embedding_size] 还能继续用 dim=-1,这样就避免了从 dim=1 改写成 dim=2 的麻烦。配图里给了具体数字:两行输入,按列求均值得到 0.13 和 0.21,按行求均值得到 0.21、0.29、0.00、0.37、0.16、0.00。
我特别喜欢它在这里的「不优雅」。它本可以写一句「用 dim=-1 更通用」就过去,但它选择把 0.13 和 0.21 这种数字印在图上。排版上这很难看,教学上这是唯一能让人记住的方式——你记住的不是「-1 是最后一维」,你记住的是「那一列平均下来是 0.13」。
三、从第 4 章到第 5 章:一个模型的一生
第 4 章 60 屏,把 GPT 拼装起来:层归一化、GELU 前馈、快捷连接、Transformer 块、最后的生成循环。第 5 章 67 屏,让它学会说话。
第 4.7 节讲文本生成,给的是一个逐词元滚动的过程:第一轮输入「Hello, I am」,采样出一个词;第二轮把它拼回输入,再采样。到第 6 次迭代,模型生成了完整的一句「Hello, I am a model ready to help.」
这句话听起来平淡,但它是这本书的一个分水岭。在这之前你写的所有代码——分词、嵌入、注意力、层归一化——都是零件;在这之后它们同时转动,输出了一句人话。任何一个自己敲过这 400 行代码的人,看到这句话时的感受,和调用 openai.chat.completions.create() 看到回复时的感受,是两种完全不同的东西。这本书卖的就是这个差别。
然后是第 5 章最硬的一段:训练。它没有回避过拟合这件事,而且给的是自己的数:
原文写:「损失在第二轮后开始发散。这种发散以及验证集损失远大于训练集损失的事实表明模型对训练数据过拟合。」它还教了一个自查办法:去看生成的文本片段,比如《The Verdict》里那句「quite insensible to the irony」——如果模型是在逐字复述原文,那就是记住了,不是学会了。
这一段的诚实程度超出我的预期。一本教学书完全可以只展示 loss 一路下降的漂亮曲线,反正读者不会追问验证集。它选择把「第 2 轮就发散」这个不体面的结果印出来,并且给出了一个不依赖任何工具的诊断方法:你去读生成的句子,看它是在写还是在背。
第 5.3 节讲解码策略,用的也是同一套笨办法——不解释概念,直接给概率。温度设为 1 时,forward 这个词元大约有 60% 的概率被选中;温度 0.1 时几乎 100% 选中概率最高的那个,行为接近 argmax;温度 5 时分布被抹平,生成的文本里大约有 4% 的概率出现「every effort moves you pizza」这种句子。
「4% 的概率出现 pizza」这句话,比十页关于「温度控制随机性」的解释都有用。因为你立刻明白:温度不是「创造性旋钮」,它是「胡说八道概率旋钮」。调到 5,你不是更有创意,你是每 25 个词就有一个离谱。
第 5.4 节讲权重的保存与加载,也是同样的路数:先给 torch.save 存 model_state_dict 和 optimizer_state_dict 两样东西,再给 torch.load 配 load_state_dict 恢复,然后顺手给一个练习——在新的 Python 会话里存完权重、加载模型与优化器,用 train_model_simple 再训一轮。这段代码从头到尾只用了十几行,但它教的是工程上最容易翻车的一件事:只存模型不存优化器,续训时学习率动量和 Adam 的二阶矩全丢,等于白训。这个坑很多人在真项目里踩过,书里只用一句「保存模型和优化器的状态」就带过了,读快了会漏。
四、第 6、7 章:从「会判断」到「会听话」
第 6 章 60 屏,讲分类微调:给模型加一个分类头,把垃圾短信和非垃圾短信分开。第 7 章 78 屏,讲指令微调:让模型学会按指令回答,而不是接着往下写。
第 6 章里有个细节我要单独提:数据加载器怎么处理长短不一的短信。它给了两个方案并明确说了取舍——「将所有消息截断到数据集中最短消息的长度或批次长度」,或者「将所有消息填充到数据集中最长消息的长度或批次长度」。原文写:「第一种方案计算开销更少,但如果较短的消息远小于平均长度或最长消息,那么可能会导致信息丢失,从而降低模型性能。因此,我们选择第二种方案,这样可以保留所有消息的完整内容。」
然后它落到一个具体的技术细节:填充用什么?答案是 GPT-2 的 <|endoftext|>,编号 50256。而且它提醒:比起把字符串 "<|endoftext|>" 拼到文本上,不如直接把对应的词元 ID 加到编码后的消息里。
50256 这个数字,是这本书的一个缩影。它不重要,考试不会考,但它是一个真实工程里必须知道的东西:填充词元选错,注意力掩码就会把填充当成内容,模型学着学着就学歪了。书中给的是可执行的具体值,不是「选择一个合适的填充词元」这种正确但没用的话。
第 6 章的微调配置也全部公开:AdamW,学习率 5e-5,权重衰减 0.1,5 个 epoch。而且它给了一个非常实用的时间参照——「在 M3 MacBook Air 笔记本电脑上训练大约需要 6 分钟,而在 V100 或 A100 GPU 上训练不到半分钟即可完成」。
这半句话,是全书对我最有用的信息之一。因为它同时回答了两个问题:我需要什么硬件(一台笔记本就够),以及这个规模离真正的训练有多远(两个数量级的差距)。训练日志也摆出来了:第 1 轮第 0 步,训练损失 2.153、验证损失 2.392;第 50 步,0.617 和 0.637。这是能对得上的数。
第 7 章 78 屏是七章里最厚的。指令微调的数据要组织成「指令—输入—输出」三段式,然后打包成批次、加掩码(只对回答部分算损失,不对指令部分算)。这些是实操里最容易写错的地方,它写得很细。
第 6.8 节「使用大语言模型作为垃圾消息分类器」还有一段我很喜欢的收尾:模型训完之后,拿两条从没见过的短信去试。一条是「You are a winner you have been specially selected to receive $1000 cash or a $2000 award.」,模型判成垃圾消息;另一条是「Hey, just wanted to check if we're still on for dinner tonight? Let me know!」,模型判成非垃圾消息。两条都对了,然后才 torch.save(model.state_dict(), "review_classifier.pth"),把权重存成文件。
这个顺序值得说一句:先验证,再落盘。看起来是常识,但很多教程是反过来的——训完直接存,因为「反正也测不出什么」。这本书坚持在保存之前给你看两条真实文本的判定结果,等于强迫读者建立「模型行为可见」的习惯。这是教材的品格问题,不是技术问题。
而 7.8 节「评估微调后的大语言模型」是我完全没料到的一手:它用一个更强的模型来当裁判。给出的例子是,让模型回答「The car is as fast as lightning.」的改写版本,模型答「The car is as fast as a bullet.」,然后由 GPT-4 打分:
as fast as 结构正确,扣分只因为「bullet」不如「lightning」有画面感。
用大模型评大模型,这件事在学术上一直有争议(存在位置偏见、长度偏好、自我偏好)。但这本书的处理方式我觉得是对的:它没有说这是「评估方法」,它只是把它当作一个「当你的模型还很弱、又没有人工标注时,一个勉强能用的信号」。这个分寸感,比很多论文都清醒。
第 7 章最后三节的标题,我倒是想请你看一眼:7.9「结论」下面挂的是 7.9.1「下一步」和 7.9.2「跟上领域的最新进展」。一本讲技术的书,在结尾处把「你接下来该干什么」和「这个领域还在动」两件事写进目录,这是一种自知。它没有假装 2023 年的这套架构是终点,而是明说:你学完这个,得自己去追。
这个自知也解释了前面那条短板。它知道 RoPE、GQA 这些新结构该讲,但讲了就要重写第 3、4 章的代码,整本书的结构会散架;所以它选择把新东西压缩成一句「去看最新的论文」,把篇幅留给能跑通的经典实现。这是一个作者在「完整」和「可执行」之间做的取舍,我认这个取舍,但不能假装它不存在。
五、它的短板
前面夸得够多了,这一节说问题。这本书的短板很集中,而且都源于同一个决定:为了让你在一台笔记本上跑通,它把规模压到了极限。这个决定本身是对的,但它带来四个后果,书中没有充分交代。
短板一:书名叫「大模型」,全书最大的模型是 124M。GPT-2 small,1.24 亿参数。GPT-3 是 1750 亿,差了 1400 倍。这个差距不是「数量级不同」这么轻描淡写——它是「完全不同的一类工程问题」。124M 模型在单卡上 6 分钟训完,你永远不会遇到显存不够、通信瓶颈、节点挂掉要回滚 checkpoint、loss 突然变成 NaN 这些事。而真正做预训练的人,80% 的时间在处理这些。书里没有一页讲它们,这是正确的取舍(讲了你也跑不了),但读者必须自己补上这个认知:你在这本书里学到的「能跑通」,和工业界的「能训」,中间隔着的不是一个放大镜,是一整套分布式系统。
短板二:它不给你看失败。全书 429 屏正文,每一段代码都跑得通,每一个练习都有答案(整齐地放在附录 C 的 20 屏里)。这不是坏事,但教学效果上有代价:真实的开发不是这样的。真实的开发是 shape 对不上、梯度变成 NaN、loss 卡在 2.3 不动、显存 OOM 在第三个 batch。书中唯一一次展示「不体面」的结果,是第 5 章那个验证集损失发散的图——而那一次恰恰是全书最有教学价值的一页。它证明作者会写「失败」,只是没多写。
短板三:2023 年之后的结构,全部缺席。这本书的模型是「绝对位置嵌入 + 多头注意力 + GELU + LayerNorm」的经典 GPT-2 结构。而现在所有主流模型用的 RoPE(旋转位置编码)、GQA(分组查询注意力)、SwiGLU、RMSNorm,在 7.9.2「跟上领域的最新进展」那一节里只是被点名,没有一行代码。附录 E 讲了 LoRA(53 屏,讲得不错),这算是抓住了 2023 年之后最实用的一项技术;但结构层面的更新,它没跟上。读者读完能理解 GPT-2,但打开 Llama 的 modeling_llama.py 还是会有一半看不懂。
短板四:它不教你怎么把模型变成产品。没有推理服务、没有量化、没有批处理调度、没有 KV cache 优化。第 4.7 节的生成函数是逐词元 for 循环,速度慢到不能上线。这不是它的目标(它的目标是「理解」),但如果一个读者抱着「学完就能做产品」的期待来,会失望。从「跑通」到「能服务一个用户」,这本书一个字没写。
短板五:全书没有一条「规模曲线」。这是一条更隐蔽的短板。它在 124M 上验证的所有结论——验证损失第 2 轮发散、温度 5 时 4% 出现离谱句子、5 个 epoch 就收敛——都是「这一个规模、这一份语料」下的观察。而这本书从头到尾用的是同一本小说(约 20 万词元的《The Verdict》)做预训练语料。读者很容易把「124M 的表现」当成「语言模型的规律」,这在方法论上是危险的。真正该有的一页是:当参数量从 124M 涨到 1.24B 时,过拟合出现在第几轮?温度的最优值会不会漂移?这一页全书没有,也不可能在一台笔记本上做出来——但至少应该有一句话提醒读者「你看到的是小尺度现象」。
还有一条不算短板、但值得提醒的:中文版的排版对代码不友好。正文里大量行内代码在电子版里会显示成空框(比如讲点积那段的变量名),必须靠上下文猜。纸质版应该没这个问题,微信读书上读会有明显损耗。这不是书的问题,是阅读载体的问题,但会影响你的阅读体验。
六、那它值不值得读
分人,而且分得很清楚。
如果你是「会用 API 但不懂原理」的开发者:强烈推荐,而且这是目前最省时间的一本。它的路径设计得很聪明:先让你分词,再让你算注意力,再让你拼模型,最后让你训它。每一步只依赖上一步,没有跳跃。你花两个周末跟着敲完,对「token 是怎么变成概率的」这件事会有肌肉记忆,而不是概念记忆。
如果你是做算法的研究生:值得读第 3、5、7 章。第 3 章的手算过程可以帮你把公式和实现对上;第 5 章的过拟合诊断方法(读生成文本、看验证损失发散点)是能直接搬到实验里的;第 7 章的掩码细节(只对回答算损失)是很多人第一次做指令微调时会写错的地方。其余部分可以快翻。
如果你是想转行做 AI 工程的:这本书是好的第一本,但绝不是最后一本。读完它你会知道模型内部长什么样,但你不会知道怎么把它塞进一个 GPU 里服务 100 个并发。那部分要另找书(或者直接读 vLLM 的源码)。
如果你只是想知道「大模型是什么」:别读这本。它太细了,616 屏里 400 屏是代码,你要的那点概念在第 1 章 31 屏里,读完就够了,剩下的对你没有增量。
给一个省时间的读法:先读第 2 章(60 屏)把分词和嵌入跑通,再读第 3 章(73 屏)把注意力算一遍,然后跳到第 4 章(60 屏)拼装,第 5 章(67 屏)训练。这 260 屏是主干,能拿到全书七成。第 6、7 章看你的方向——做分类任务读第 6 章,做对话读第 7 章。附录 A 别通读,当成 PyTorch 字典,遇到不会的 API 现查;附录 C 在卡住的时候再看,提前看会毁掉练习的价值;附录 E 那 53 屏讲 LoRA,如果你要微调自己的模型,它可能是全书投入产出比最高的部分。
时间上给个实话:光读,两个晚上够了;跟着敲,两个周末;敲完还能讲清楚每一行为什么这么写,大概要一个月。这个成本比读十篇博客高,但比读十篇博客有用——因为博客给你的是结论,这本书给你的是能复现结论的那 400 行。
七、一句话收尾
这本书最大的价值,是它让「大模型」这四个字从名词变回了动词——它不是你要膜拜的东西,是你要一行一行写出来的东西。而它最大的局限,是它教你的那个东西只有 1.24 亿参数,是一个能装进笔记本的小盒子。
但我不觉得这是欺骗。相反,一个愿意在书名里写「大模型」、却在正文里老老实实只做 124M 的作者,比一个写「千亿参数实战」、实际只给你跑 API 的作者,可信得多。他知道你能跑什么,就只教你跑得动的那部分,然后把「跑不动的那部分」明确留在门外——这比假装它不存在,要体面。
所以我的结论是:把它当「第一本」,别当「唯一一本」。读完它,你会拥有一个别人拿不走的底座:你知道那 400 行代码长什么样,因此当有人说「大模型是黑箱」时,你心里会有一句反驳——它不是黑箱,只是箱子有点大。
书名:从零构建大模型
本次阅读:微信读书逐页截图 616 屏,版权信息 + 前言 + 7 章 + 附录 A–E,从版权信息至「看完了」,耗时 807 秒,抓取标记
end=last_page。未读到:无。全书一次抓完,无会员卡遮挡、无章节缺失。
判断依据:章屏数按 pages.jsonl 逐页章节归属统计(第 1 章 31、第 2 章 60、第 3 章 73、第 4 章 60、第 5 章 67、第 6 章 60、第 7 章 78;附录 A 64、B 21、C 20、D 14、E 53);引文与数字均来自截图原文,页码为本次截图编号(如 p0272 即第 272 张截图)。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: