
BERT基础教程:它把 Transformer 拆成了 63 张连环画
微信读书《BERT基础教程:Transformer大模型实战》· 本次逐页翻阅 84 屏:版权信息、献词、前言,以及第 1 章「Transformer 概览」全部 74 屏。第 2 章之后抓取中止,没有读到全书完。
说明:这书的原版是 Packt 2021 年的《Getting Started with Google BERT》,作者苏达哈尔桑·拉维昌迪兰,译者是周参,人民邮电出版社 2023 年 2 月出中文版。所以下面所有「这本书」的说法,其实只覆盖它的第一章——一本书的前十章我只读到第一章,这个比例我得先摆出来,免得我拿 7.4% 的篇幅去评价整本书。
先说一句公道话:这是我最近读过的、把 Transformer 讲得最像流水线的一章。
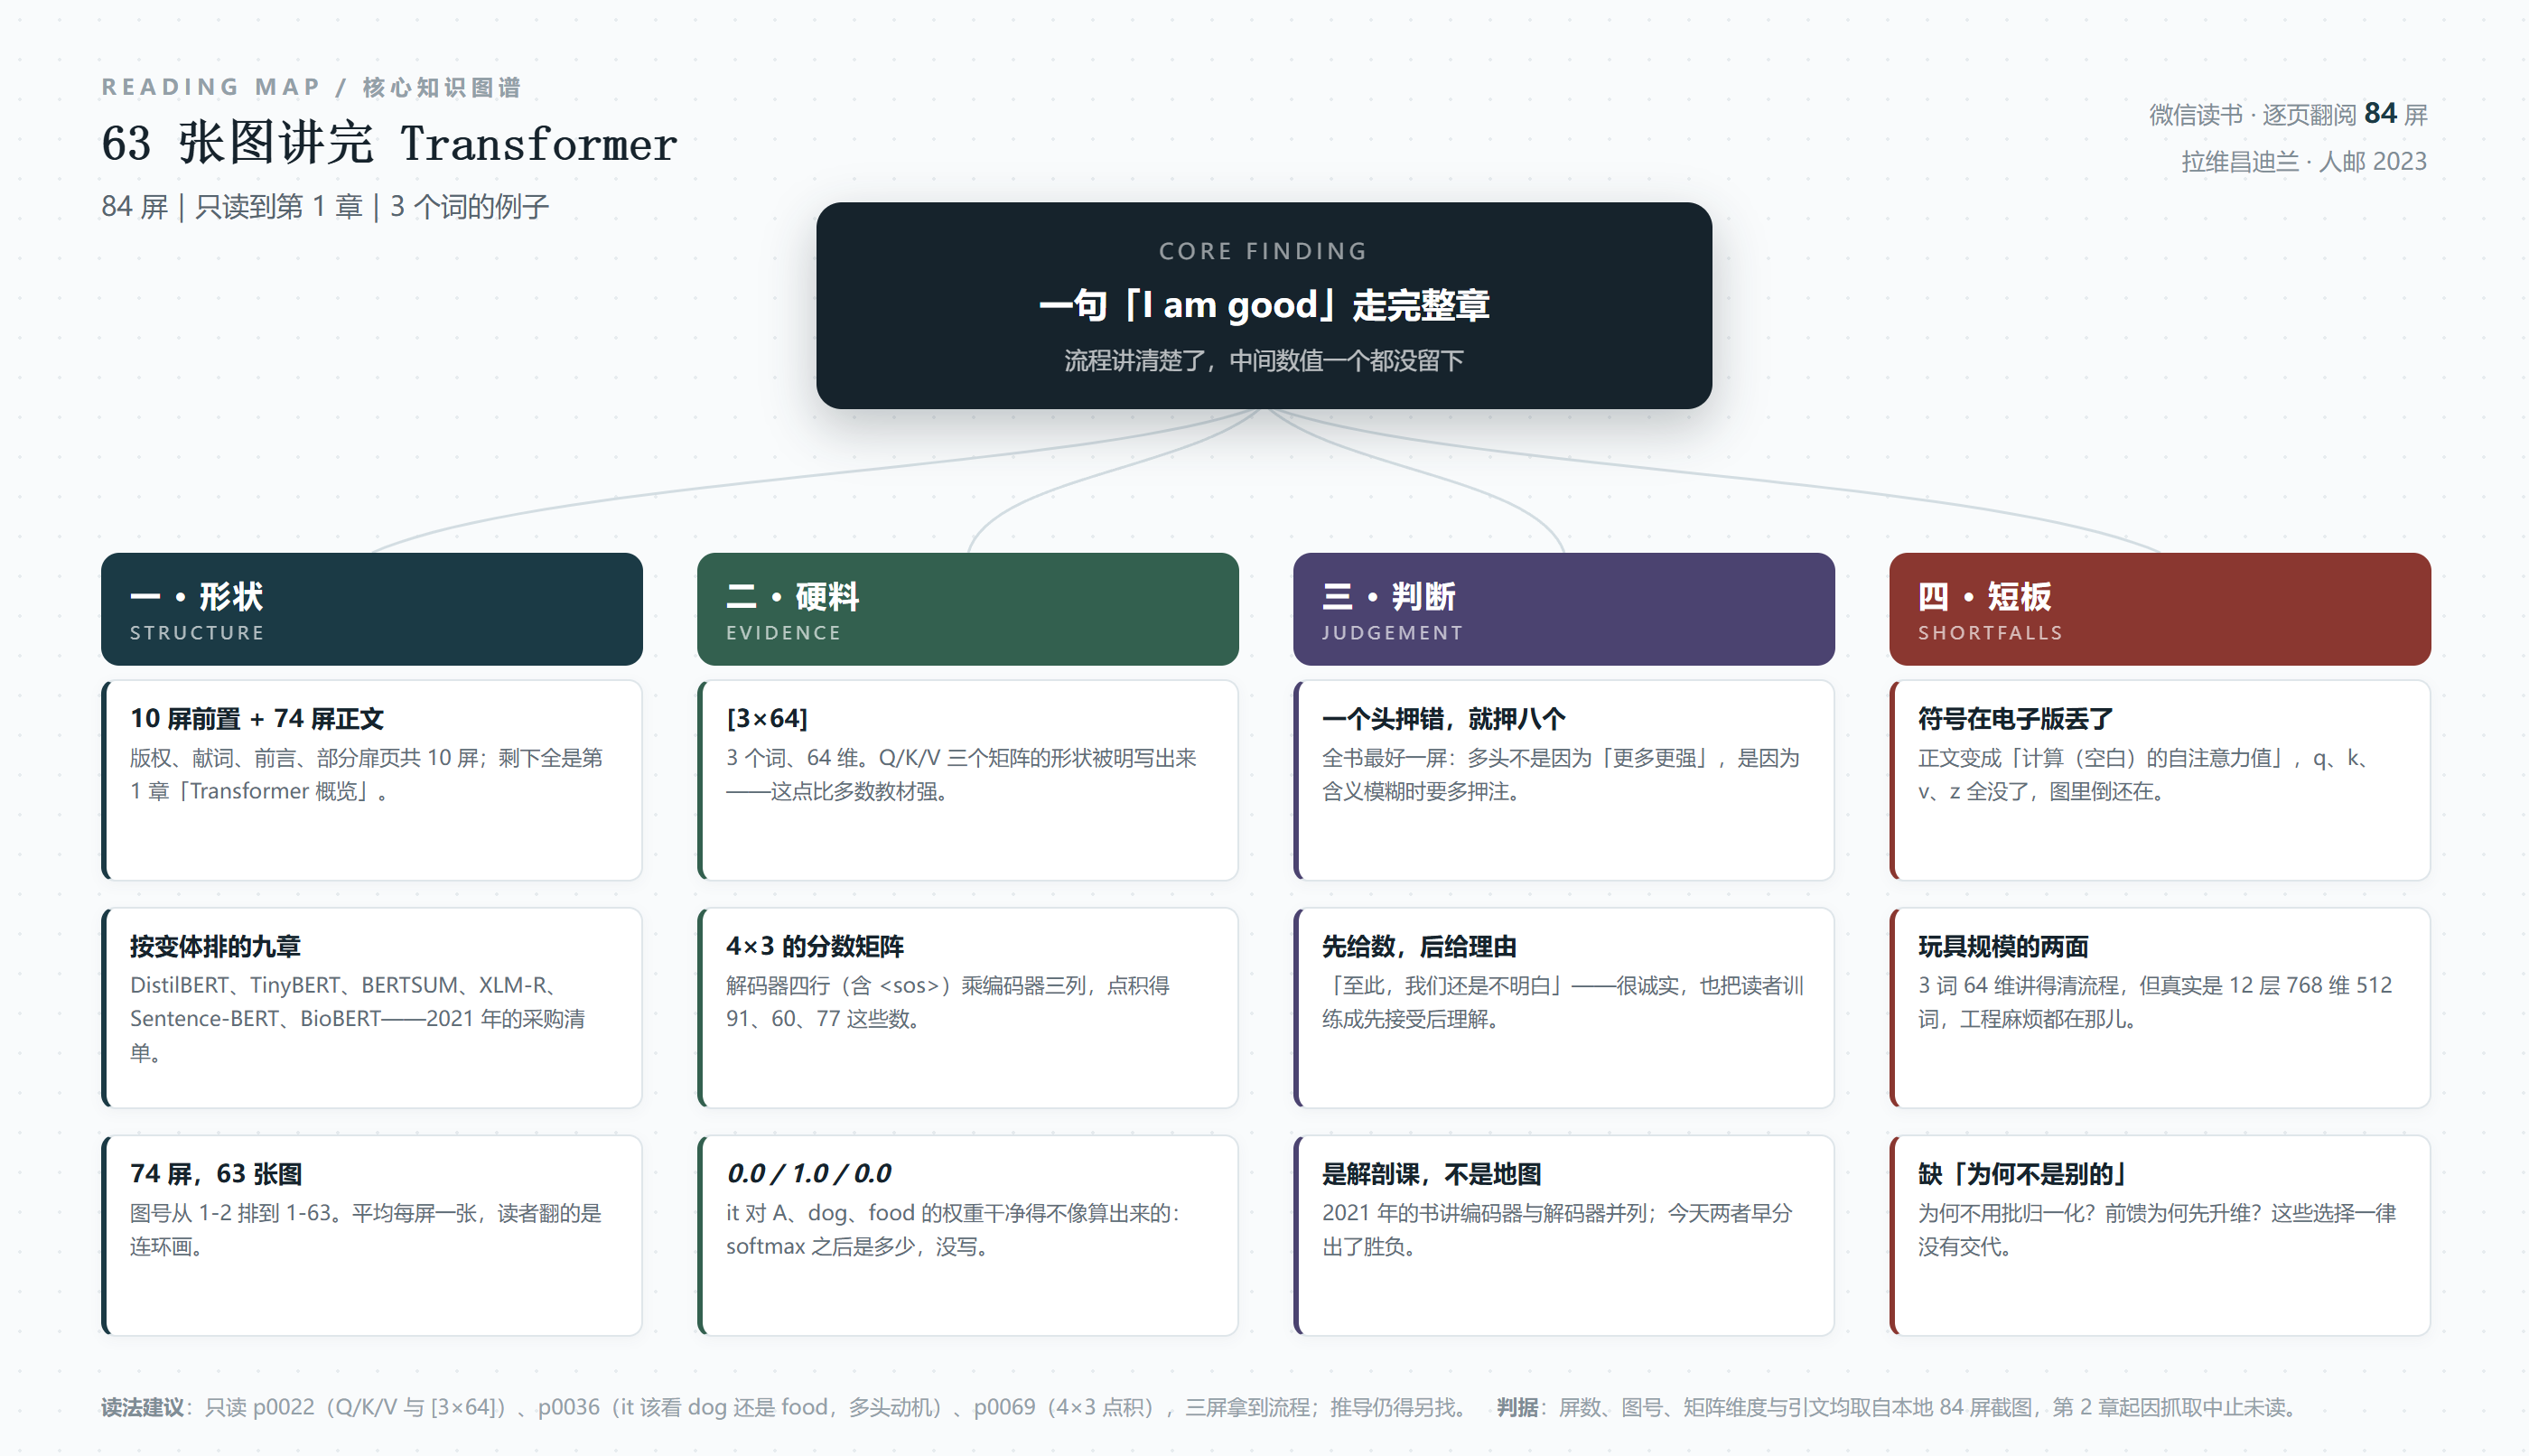
它从头到尾只用一句三词英文——「I am good」——和它的法语译文「Je vais bien」,把编码器、自注意力、多头注意力、掩码、位置编码、前馈网络、层归一化、解码器逐步生成,全部走了一遍。每一步都配图,图号从 1-2 排到 1-63。
也正因为这样,我对它的评价是分裂的:作为「第一次接触 Transformer」的读物,它好用得罕见;作为「想搞明白公式怎么来的」的读物,它不够。它把 Transformer 拆成了 63 张连环画,你每一步都看得懂,合上书却发现还是不会自己算一遍。
一、我读到的这 84 屏,是这么构成的
84 屏里,版权信息 2 屏、献词 1 屏、前言 6 屏、「第一部分 开始使用 BERT」的扉页 1 屏,剩下 74 屏全部是第 1 章「Transformer 概览」。也就是说,前置部分占 11.9%,正文 88.1%,而正文只是一个章节。
前言那 6 屏值得单独说,因为它是我唯一能看到全书轮廓的地方。它一章一句地简介了九章:第 5 章讲基于知识蒸馏的 BERT 变体(DistilBERT、TinyBERT),第 6 章讲文本摘要的 BERTSUM 模型,第 7 章讲把 BERT 用于非英语语言(XLM、XLM-R),第 8 章讲 Sentence-BERT 和特定领域的 BERT(ClinicalBERT、BioBERT),第 9 章讲 VideoBERT 和 BART。
看到这个目录,我心里有个数:这是一本「BERT 生态图鉴」式的书——它按「变体」组织章节,而不是按「问题」组织。DistilBERT、TinyBERT、BERTSUM、XLM-R、Sentence-BERT、ClinicalBERT、BioBERT、VideoBERT、BART,九个名字排过去,像一份 2021 年的采购清单。
这不是缺点,2021 年这么写很正常。但它意味着这本书的寿命是有期限的:它讲的是「BERT 有哪些亲戚」,而 2026 年大家真正在问的是「为什么现在没人再训 BERT 了」。这个问题,一本 2021 年的书不可能回答。
二、一句玩具句子,走完全程
第 1 章的教学设计,我给它打高分,原因就一个:它真的只用一句话。
输入固定是「I am good」,三个词;输出固定是「Je vais bien」,三个词。整个第一章,从嵌入到 softmax,所有矩阵都围绕这六个词展开。
第 22 屏,图 1-7「创建查询矩阵、键矩阵和值矩阵」:三行分别是 I、am、good 三个词,三列是查、键、值三套权重下的 64 维向量;作者特意给了几个具体数字(I 的查询向量是 3.69、7.42……4.44,am 是 11.11、7.07……76.7,good 是 99.3、3.69……0.85),然后在图下面总结了三条:三个矩阵的第一行分别代表单词 I 的查询向量、键向量和值向量;第二行是 am;第三行是 good。接着给了一句很实在的话:
「因为每个向量的维度均为 64,所以对应的矩阵维度为[句子长度×64]。因为我们的句子长度为 3,所以代入后可得维度为[3×64]。」
然后它自己承认了一件事:
「至此,我们还是不明白为什么要计算这些值。该如何使用查询矩阵、键矩阵和值矩阵呢?它们怎样才能用于自注意力模型呢?这些问题将在下面进行解答。」
这一句我要给它记一分。很多教材在这一步会假装读者已经懂了,或者直接跳到公式。它没有,它明说「我们还是不明白」——这个「我们」用得也好,把作者和读者放在同一侧。
但也要记一笔账:这种「先给数、后给理由」的写法,全章出现了不止一次。它的教学节奏是「先让你看见,再告诉你为什么」,好处是不劝退,坏处是读者被训练成了先接受、后理解——而数学最怕这个顺序,一旦养成,遇到看不懂的地方,读者会习惯性地跳过去,因为「后面会解释」。
三、它最会讲的一段:it 到底该看 dog 还是 food
第 36 屏是全书我读到的最好的一屏。它讲的是自注意力到底在干什么,例子是一个歧义句:it 指的是 dog 还是 food。
屏幕上给出了一行算式:it 的自注意力值,等于 0.0 乘 v1(A)、加 1.0 乘 v2(dog)、加 0.0 乘 v3(food)、加 0.0 乘 v5(hungry)。然后作者解读:
「从图 1-24 中可以看出,it 的自注意力值正是 dog 的值向量。在这里,单词 it 的自注意力值被 dog 所控制。这是正确的,因为 it 的含义模糊,它指的既可能是 dog,也可能是 food。」
紧接着是全章逻辑最漂亮的一次转折:
「如果某个词实际上由其他词的值向量控制,而这个词的含义又是模糊的,那么这种控制关系是有用的;否则,这种控制关系反而会造成误解。为了确保结果准确,我们不能依赖单一的注意力矩阵,而应该计算多个注意力矩阵,并将其结果串联起来。使用多头注意力的逻辑是这样的:使用多个注意力矩阵,而非单一的注意力矩阵,可以提高注意力矩阵的准确性。」
这段话把「多头注意力」从「论文里说有 8 个头」变成了「因为一个头会押错注,所以要押八次」。这是我在这类教材里很少见到的讲法——它不解释公式,它解释动机。
我甚至认为,如果整章都按这一屏的水准写,这本书会是经典。可惜不是:这一屏之所以讲得好,是因为它有一个「错的可能性」——it 可能指错。而全章大部分步骤(位置编码、层归一化、前馈网络)没有这种「可能错」,作者就只能写「我们这样做,是为了让模型更好」,动机的锋利度立刻掉下来。
顺带说一句,这也是我觉得「多头」这个词该改的原因:中文「多头」听起来像「多个脑袋」,而这一段讲清楚的是「多份独立的押注」。叫「多注注意力」或者「多视角注意力」,读者第一次就能记住它为什么存在。
四、63 张图的代价
第 1 章 74 屏,图号排到了 1-63。就算有个别图占了两屏,平均也是每一屏就有一张图。
随手记几个节点:图 1-2,N 个编码器堆叠,「I am good」从底部进去,一路向上,顶部输出「特征值」;图 1-7,Q/K/V 三个矩阵;图 1-24,it 的自注意力;图 1-38、1-39,解码器在第 N 步的预测结果,编码器 1、2 和解码器 1、2 之间画了斜箭头,把「编码器的特征值喂给解码器」这件事画成了两条斜线;图 1-54、1-55,解码器的查询矩阵(四行:<sos>、Je、vais、bien)乘编码器的键矩阵转置(三列:I、am、good),得到一个 4×3 的分数矩阵,里面是 91、60、77 这种数;图 1-63,最后把编码器和解码器拼在一起,位置编码进圆圈加号,多头注意力、叠加和归一、前馈网络层层往上,N× 的虚线框标着「重复 N 次」。
这套图有个明显优点:它把「张量形状」画出来了。编码器侧是 3 个词,解码器侧是 4 个词(多了一个起始符 <sos>),所以点积出来是 4×3——很多书讲了半天注意力,读者却不知道矩阵是几乘几,这本书没有这个问题。
但图多了有代价,代价在第三层:图像替代了推导。
举个具体的。图 1-24 里,it 对 A、dog、food、hungry 的权重是 0.0、1.0、0.0、0.0——这四个数太干净了,干净到不像算出来的,像画上去的。读者看完会以为注意力权重天然就是 0 和 1,而实际上真实的 softmax 输出是一堆 0.1、0.07、0.23 这样的小数。书里没有一屏展示「从分数到权重」这一步的中间数值,也就是 softmax 到底把 91、60、77 变成了几个零点几。
这就是「连环画」式教学的通病:图能让你看懂流程,但不能让你复现计算。合上书,你知道 it 看了 dog,但你不知道该怎么从一堆点积分数算出这个结论。而 Transformer 的门槛,从来不在流程上,在那一步归一化上。
五、公式在电子版里丢了
这一条不是作者的错,是版本的问题,但读者实际拿到手的就是这样,所以我必须写。
在我截下来的这些屏里,凡是行内公式和符号,大量显示为空白:
第 22 屏的正文写的是「三个矩阵的第一行(此处符号显示为空白)、(空白)和(空白)分别代表单词「I」的查询向量、键向量和值向量」;第 36 屏写「假设我们需要计算(空白)的自注意力值」;再往后还有「单词(空白)的查询向量」这种句子。
也就是说,书里所有下标变量(q、k、v、z、W 这些)在电子版里是丢的,而图里的符号是好的(图是图片,公式是文字层)。结果是:图你能看,句子你能读,但句子里指代「哪个符号」的那部分,全是黑洞。
对一本通篇靠符号推进的书,这等于把路标全拔了。你读到「计算(空白)的自注意力值」,只能靠上下文猜它指的是 z_it。这不是理解难度的问题,是信息缺失的问题。
我把这条算作「短板」,但要注意归责:排版失误在电子化环节,不在作者。作者的文字是对的,是渲染把它弄丢了。这也提醒一件事——技术书买电子版,尤其是公式多的,先翻到最密的一页看看符号还在不在。
六、从 2021 到 2026:这本书的时间差
版权页写得很清楚:原书版权 © 2021 Packt Publishing,英文原名《Getting Started with Google BERT》;中文版 2023 年 2 月,ISBN 9787115603722。
我读它的时候,有一个挥之不去的错位感。这本书花 74 屏讲编码器—解码器架构,讲 BERT 是「只有编码器」、GPT 是「只有解码器」,这套讲法在 2021 年是对的,也是当年理解 BERT 的标配路径。
但 2026 年读,这套路径有个副作用:它会让读者以为「编码器 + 解码器」是两种平等的设计选择,而实际上它们已经分出了胜负。今天主流的大模型几乎全是解码器路线,编码器式的 BERT 退到了检索、分类、重排这些「配角」位置上。这本书不会告诉你这件事,因为写它的时候还没发生。
我不认为这是「书过时了」的批评——2021 年的书不该为 2026 年的格局负责。我想说的是另一件事:这类书的正确用法,是把它当「解剖课」,不是当「地图」。它教你的东西(自注意力怎么算、多头为什么存在、位置编码为什么必须加)五年后依然成立;它没教的东西(谁赢了、为什么赢、现在该怎么选),得去别处补。
买这种书最常见的错误,是把「解剖课」当地图用:读完了 BERT 的每一个部件,就以为理解了今天的大模型。其实这两件事之间,隔着的正是这本书没写的那部分——规模、数据、训练目标、以及「为什么解码器赢了」。
七、它的短板
第一,玩具规模保护了读者,也骗了读者。整章只用 3 个词、64 维、2 层编码器(图里写 N 个,例子用 2 个)。这个规模对理解流程是必要的,但书里没有一屏告诉你真实规模长什么样:BERT-base 是 12 层、768 维、12 个头,输入 512 个 token。3 个词乘 64 维是 192 个数,512 个 token 乘 768 维是 39 万个——读者在这个尺度上完全无法建立直觉,而工程上的所有麻烦(显存、批大小、注意力是 O(n²))都发生在这个尺度上。
第二,只有「是什么」,很少「为什么不是别的」。除了多头注意力那一段(第 36 屏)给了动机,其余关键设计基本是「我们这样做」:为什么要加位置编码?因为注意力本身没有顺序概念——这句它说了,但没说「不加会怎样」;为什么用层归一化而不用批归一化?没讲;为什么前馈网络要先升维再降维?没讲。这些「为什么不是另一个选择」,恰恰是把知识变成判断力的地方。
第三,公式推导被图替代。63 张图换来的是流程清晰,代价是中间数值全程缺席:softmax 之前是 91、60、77,之后是多少?没有。缩放因子除以根号 d_k,除完变多少?没有。读者跟着走完,能画出示意图,但算不出一个数。
第四,电子版符号丢失。上面第五节说的,正文里所有下标变量是空白。这是我这 84 屏里最影响阅读的一件事,且无法通过「认真读」解决。
第五,只读得到第 1 章,这是我的限制不是书的问题。第 2 到第 9 章(BERT 预训练、微调、DistilBERT、BERTSUM、XLM-R、Sentence-BERT、VideoBERT/BART)我只有前言里的一句话简介,没有任何正文。所以上面关于「BERT 生态图鉴」的判断,是从目录结构推的,属于推测;如果后面几章真的按问题组织而不是按变体组织,那我这句要收回。
第六,也是最要紧的一条:它没有回答「我该不该用 BERT」。一本叫「BERT 基础教程」的书,全书(至少我读到的部分)都在讲 BERT 怎么运作,没有一页讲「什么任务该用 BERT 而不是别的东西」。对 2021 年的读者,这不算失职,因为当时没得选;对今天翻开它的读者,这是最大的空白——你今天学 BERT,八成不是为了训一个 BERT,而是为了读懂别人的系统里那个 embedding 层。
这一章最值钱的,是那句「至此,我们还是不明白为什么要计算这些值」。承认不懂,然后一步步把不懂解开——这是好教材的姿态。它做到了七成:把「怎么走」讲得比大多数书都清楚,把「为什么非得这么走」留了一半没讲,把「电子版的符号」弄丢了。
如果你只需要一样东西,拿走第 36 屏那段:一个头会押错注,所以要押八个。这句话比任何一张架构图都更接近 Transformer 的真相。
书名:BERT基础教程:Transformer大模型实战 作者:苏达哈尔桑·拉维昌迪兰 译者:周参 出版:人民邮电出版社 2023-02(原书 Packt 2021《Getting Started with Google BERT》)
本次阅读:微信读书逐页截图 84 屏(版权 2 / 献词 1 / 前言 6 / 部分扉页 1 / 第 1 章 74),第 2 章起抓取中止,未读到全书完。
未读到:第 2—9 章全部正文,仅在前言看到每章一句话简介。
判断依据:屏数与章节归属按本地 pages.jsonl 统计;图号(1-2 至 1-63)、矩阵维度([3×64]、4×3 分数矩阵)、示例句(I am good / Je vais bien)与所有引文均取自截图 p0001、p0006、p0014、p0022、p0036、p0052、p0069、p0080;「每屏一张图」是按 74 屏对 63 张图估算。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: