
RAG-Driven Generative AI:它说没有灵丹妙药,然后递来一箱零件
微信读书《RAG-Driven Generative AI》· 本次逐页翻阅 280 屏,从版权页读到第 3 章(索引式 RAG)中途,抓取在第 280 屏中止,没有读到全书完。所以下面所有比例都是「我实际读到的 280 屏」的比例,不是全书的比例,这一点我先说清楚。
说明:这是一本 Packt 出的英文技术书的中英对照版,每段英文后面紧跟一段中文译文。我的评价标准因此不是「讲得全不全」,而是三件事:它有没有给出可迁移的判断、它的例子能不能在没有作者那台机器的前提下复现、以及它对自己方法的局限有没有交代。加引号的话都能在截图里核对,页码为本次截图编号。
这本书最诚实的一句话,在第 35 屏。
原文是这样的:「A project manager, however, already encounters a wide range of generative AI platforms, frameworks, and models such as Hugging Face, Google Vertex AI, OpenAI, LangChain, and more. An additional layer of emerging RAG frameworks and platforms will only add complexity with Pinecone, Chroma, Activeloop, LlamaIndex, and so on. All these Generative AI and RAG frameworks often overlap, creating an incredible number of possible configurations. Finding the right configuration of models and RAG resources for a specific project, therefore, can be challenging for a project manager. There is no silver bullet.」
译过来就是:一个项目经理,本来就已经面对 Hugging Face、Google Vertex AI、OpenAI、LangChain 这一大堆平台和模型;现在再叠上一层 RAG 框架——Pinecone、Chroma、Activeloop、LlamaIndex 等等——只会更复杂。这些框架功能常常重叠,组合出来的配置数量多到离谱。所以为一个具体项目找到正确的模型与 RAG 资源组合,对项目经理来说是件难事。没有灵丹妙药。
一本叫「RAG 驱动的生成式 AI」的书,在第一章就告诉你「没有灵丹妙药」,这句话值得先记一分。但紧接着就有个问题:这本书接下来 245 屏做的事,是把那十个框架一个个装起来给你看。它承认了「选型难」,然后用「全都试一遍」来回答「选型难」。
我把判断放在前面:这是一本知道问题在哪、但只肯给零件的书。它的骨架是对的,它的例子是能跑的,它的评估是敷衍的,它的译文是不可信的。它可以当操作手册用,不能当选型依据用——而它开篇明明想当后者。
一、先看形状:280 屏,其实只有三章
把 280 屏按章节切一遍,形状很不均匀:
前置部分 33 屏,占 11.8%。这里包括版权信息、Preface、这本书适合谁读、这本书讲了什么、如何获得最大收益、联系方式,以及三段出版社的权益说明。
第 1 章「Why Retrieval Augmented Generation?」110 屏,占 39.3%。它下面挂着这些节:为什么需要 RAG(6 屏)、什么是 RAG(5 屏)、朴素·进阶·模块化三种配置(3 屏)、RAG 与微调的对比(6 屏)、RAG 生态(16 屏)、用代码实现三种 RAG(64 屏),最后是 Summary、Questions、References、Further reading。
第 2 章「RAG Embedding Vector Stores with Deep Lake and OpenAI」90 屏,占 32.1%。从原始数据到向量库里的嵌入(6 屏)、把 RAG 组织成流水线(4 屏)、一条 RAG 驱动的生成式 AI 流水线(5 屏)、动手搭一条流水线(53 屏)、用余弦相似度评估输出(7 屏)。
第 3 章「Building Index-Based RAG with LlamaIndex, Deep Lake, and OpenAI」我读到 47 屏,占 16.8%,章节没读完。它的开头是:为什么要用索引式 RAG(8 屏),然后进入「搭一个语义搜索引擎和生成式 AI agent」(34 屏),我在这一节里停住了。
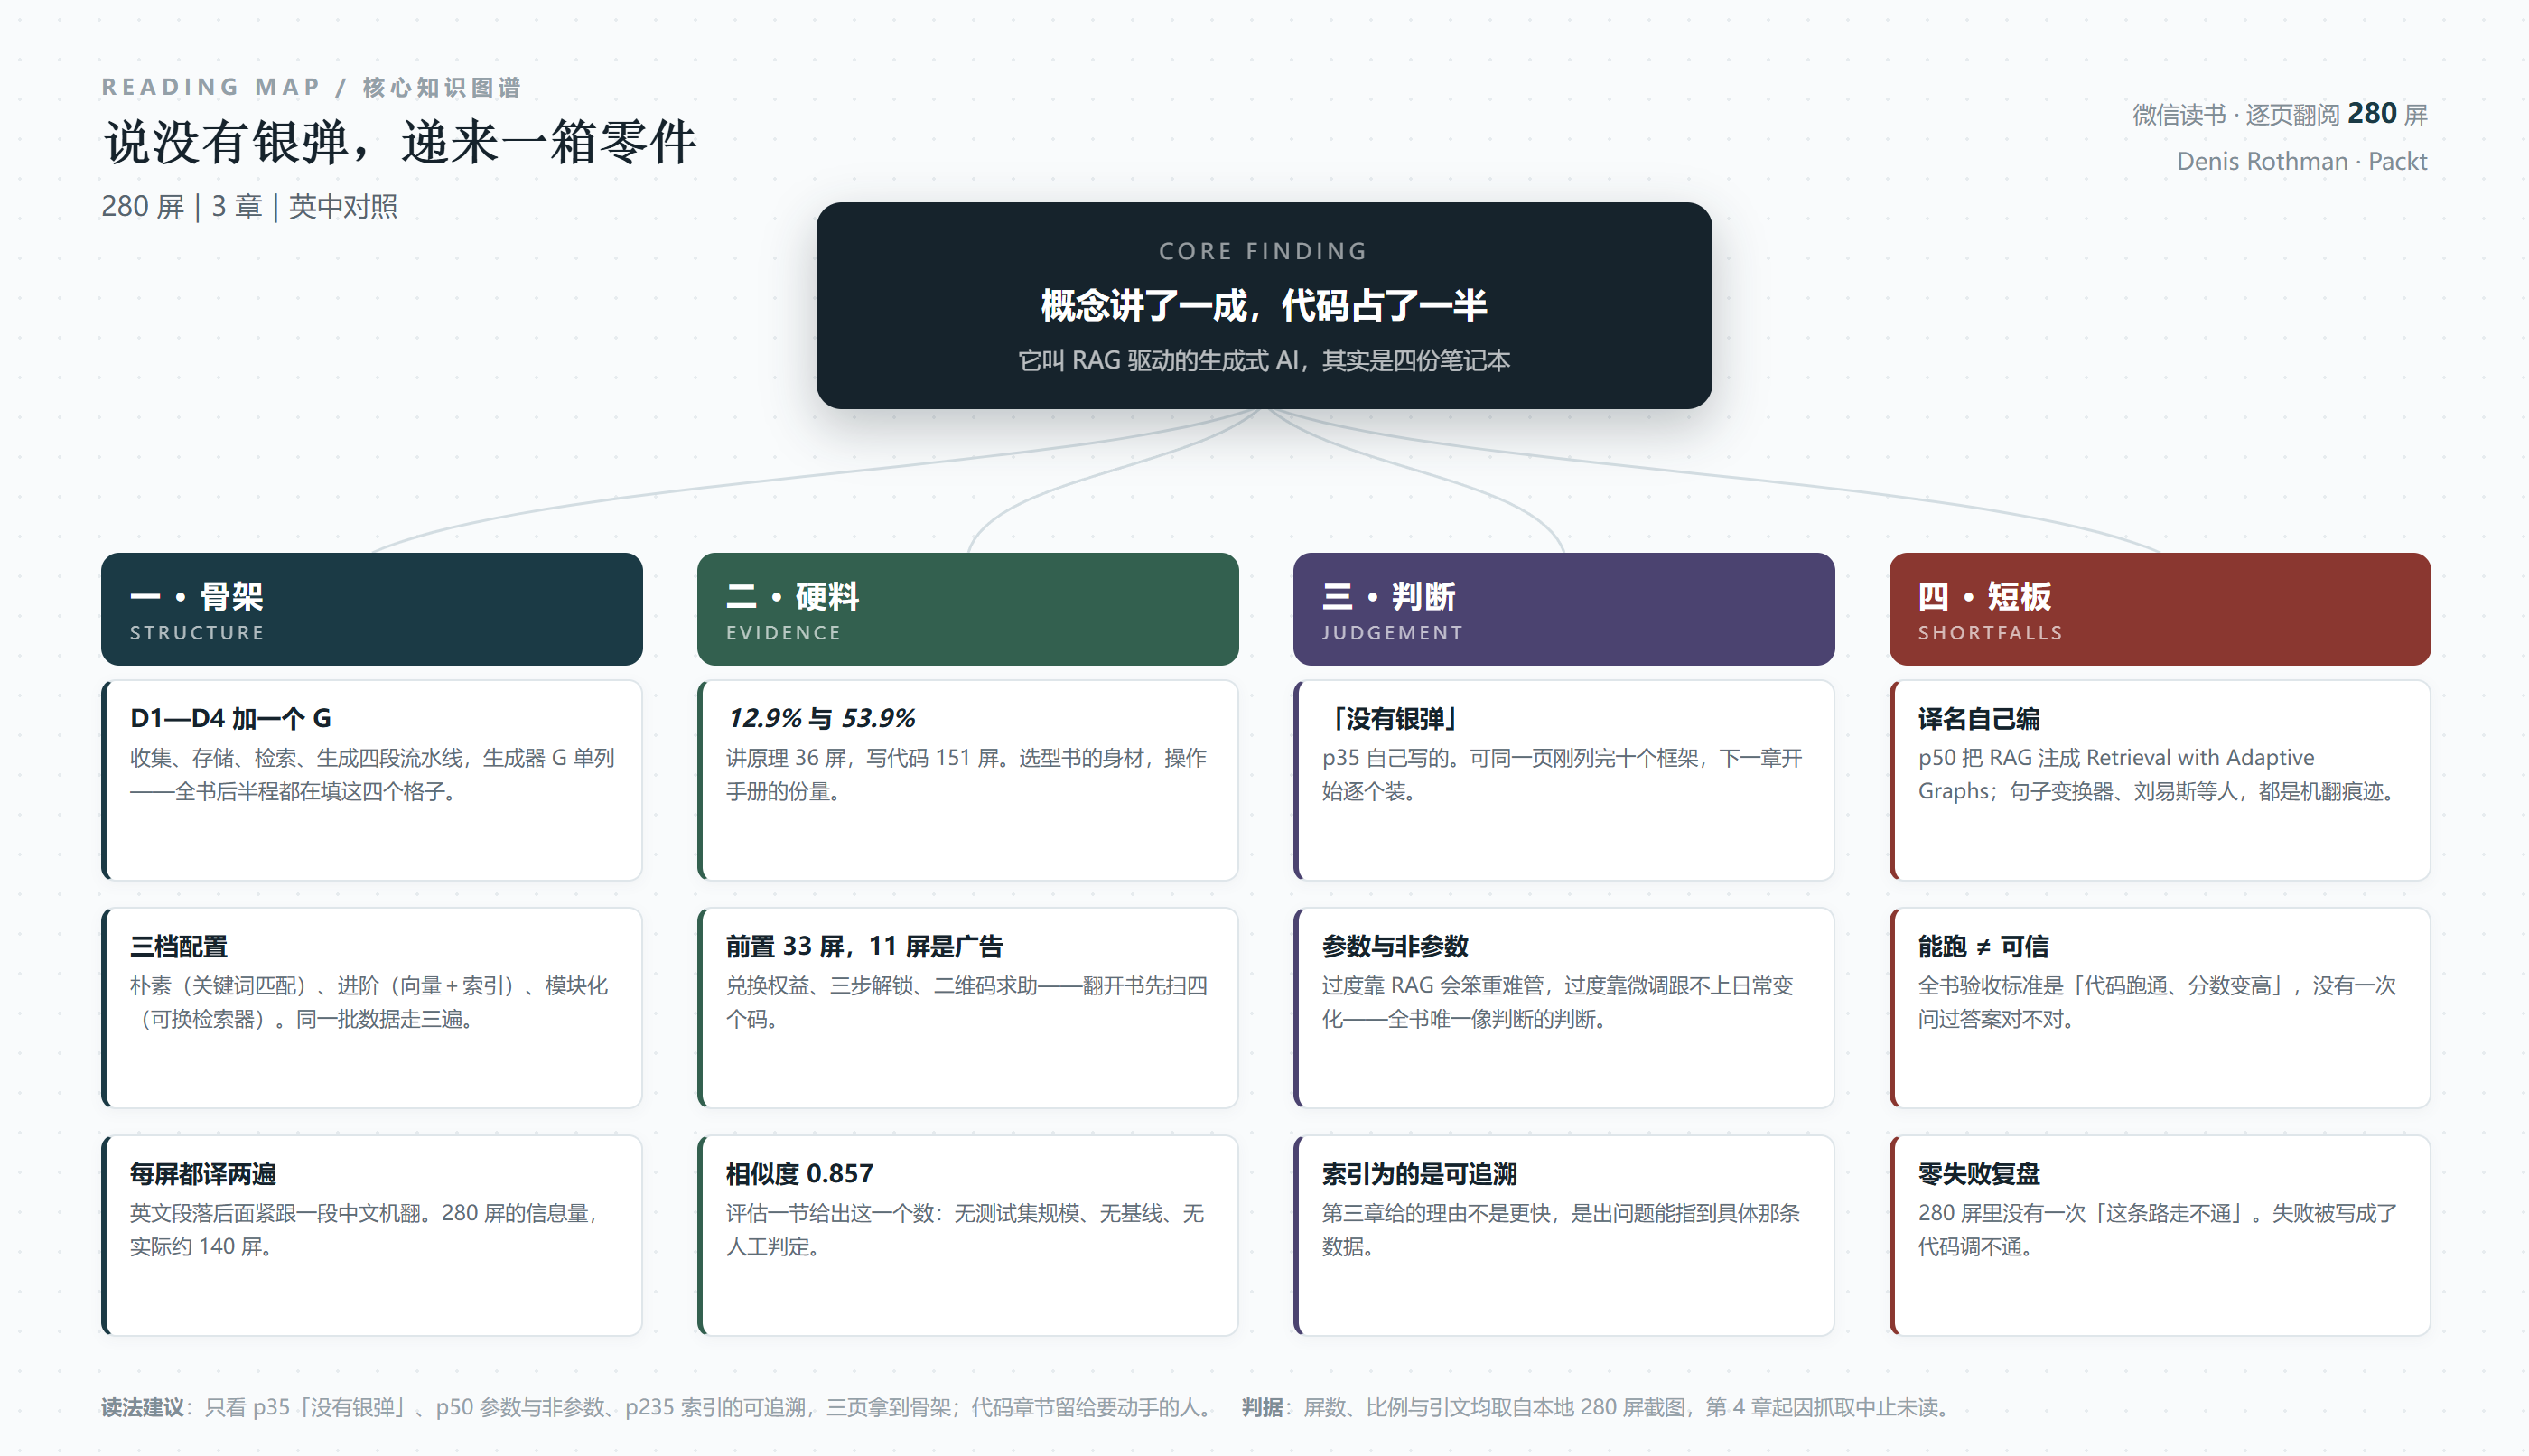
看清楚这个形状,第一个结论就出来了:概念讲解一共 36 屏(12.9%),代码章节一共 151 屏(53.9%)。一本讲「为什么」和「怎么做」的书,用超过一半的篇幅在贴代码,用不到八分之一的篇幅在讲道理。
第二个结构事实更影响阅读体验:它是中英对照排版。每一段英文原文后面跟一段中文译文,一段英文约 5 行、一段译文约 4 行,等于每屏有接近一半的版面在重复同一件事。所以 280 屏的实际信息量,按单语排版算大概只有 140 屏。这不是书的错,是译版的排版选择,但它直接解释了另一个违和感——为什么 280 屏才读完三章:因为一章的英文原文本来就只有五六十屏。
第三个事实有点难看:前置 33 屏里,有 11 屏是出版社的兑换权益页——「Making the Most Out of This Book」4 屏讲怎么拿到免费 PDF 和代码包,「Unlock Your Book's Exclusive Benefits」2 屏,「How to unlock these benefits in three easy steps」3 屏配二维码,「Need help?」2 屏给了一个 packtpub 的求助链接和一个二维码,还有一行「If you are still facing issues, reach out to customer care@packt.com」。
我不是说出版社不该放这些,纸质书里它们在第一页和最后一页,读者一翻就过去了。但在电子版里,它们被排进了正文流,占掉了 3.9% 的篇幅,而且是在你还没开始读第一章的时候。你翻开一本讲 RAG 的书,前 33 屏里有 11 屏在教你怎么扫二维码换权益包。
二、它给的骨架:D1 到 D4,再加一个 G
如果这本书只能留下一样东西,留下这条流水线。
作者在第 60 屏把数据处理拆成阶段编号:D1 是数据收集——用爬虫或任何别的信息源,把文本、图像、视频抓下来;然后是「分块(chunk)、嵌入(embed)、建索引(index)」三步,把数据对象转成统一特征表示,用来提高可搜索性和检索效率。D3 是存储——到这一步,你手里已经有一大堆从互联网上收集来的视频、照片、文本,「那么我们能拿这些数据做什么,才能让它有用?」
第 62 屏接着往下:D4 是检索查询,由用户输入或自动输入(G1)触发;为了快速检索,数据要先转成合适格式装进向量库和数据集,然后用关键词搜索、智能嵌入、索引三者组合来检索;余弦相似度负责把「密切相关的项目」找出来,保证结果不只是快,而且高度相关。检索完了,「我们就会对输入进行增强」,交给生成器 G。
这套 D1—D4 加 G 的写法,比大多数中文 RAG 书里「检索器 + 生成器」两段式要细一档。细在哪里?细在它把「存储」单独拎成了一个阶段(D3),并且明确说了一句很要紧的话:「输入与检索之间的界线,在 RAG 生态里是模糊的。」
这句话翻译成人话是:一个 RAG 系统出了错,你很难判断是「用户没问清楚」,还是「检索没找到」。这是 RAG 工程里最真实的困境,作者用一句话点出来了,然后——就没有然后了。全书后面 200 多屏里,没有再回到这个界线问题上来。第 2 章用余弦相似度评估输出,评的是「检索到的和期望的像不像」,而不是「界线到底画在哪」。
第 41 屏有全书唯一一张概念图(图 1.1):左边一栏写 RETRIEVAL,画的是书架、梯子、找书的人;右边一栏写 GENERATION,画的是同一批书架,但人在桌边讨论、把书翻开。作者的注释是:RAG 从生成式 AI 结束的地方开始,为 LLM 补上它缺的那部分准确回答所需的信息;这个框架是刘易斯等人 2020 年提出来的,它把「优化过的信息检索」和「生成」接在一起。
图画得挺用心,但它也泄露了这本书的自我定位:左边是找书的人,右边是读书讨论的人,而真正的活——分块多大、嵌入用哪个模型、索引怎么建、检索回来几条——全在书架的背面,图里看不见。这本书后面的 245 屏,做的就是书架背面的活。
三、概念 12.9%,代码 53.9%:一组算术题
我把 280 屏按「内容性质」重新分了一次类,这只是一种读法,但它能把这本书的性格照出来:
概念与论述 69 屏,占 24.6%。其中纯概念(什么是 RAG、三种配置、RAG 与微调、RAG 生态)36 屏;流水线设计叙述 20 屏(第 2 章从原始数据到嵌入、组织成流水线、一条 RAG 流水线);索引式 RAG 的动机 13 屏(第 3 章开头)。
代码 151 屏,占 53.9%。第 1 章 64 屏(RAG_Overview.ipynb,从第 72 屏开始,要求你先去 GitHub 仓库打开笔记本),第 2 章 53 屏(搭流水线),第 3 章 34 屏(语义搜索引擎)。
章节收尾 27 屏,占 9.6%。Summary、Questions、References、Further reading,三章各来一遍,格式统一,问题都是「我们为什么需要 RAG」「朴素 RAG 和进阶 RAG 的区别是什么」这种自问自答。
前置 33 屏,占 11.8%。上面已经说过,其中 11 屏是出版社权益页。
加起来 69 + 151 + 27 + 33 = 280,刚好对上。这组算术说明什么?
说明这本书的默认读者不是「要决定上不上 RAG 的人」,而是「已经决定上、现在要动手的人」。可它开篇自称的读者是谁?第 6 屏「Who this book is for」写得很清楚:数据科学家、AI 工程师、机器学习工程师、MLOps 工程师,以及解决方案架构师、软件开发人员、产品经理和项目经理。
这里面有一半人是不写代码的。产品经理和项目经理读到第 72 屏,会看到一行字:「要开始,请在 GitHub 存储库里打开 RAG_Overview.ipynb。我们将从建立笔记本的基础开始,探索基本实现。」然后紧接着是「第 1 部分:基础和基本实现」,再往后就是 60 多屏的 notebook 内容。
这不是说不能写代码,而是说:它把一半目标读者请进了门,然后让他们坐了两个小时看别人敲键盘。一本真想让项目经理读懂的书,会在每段代码后面补一段「这段代码在替你做什么决定、如果换成另一种做法会怎样」。这本书没有。它的代码注释是代码注释级别的(这一行做什么),不是工程决策级别的(为什么这么做、不这么做会怎样)。
我举个具体的对照:第 1 章那 64 屏代码,把同一批数据用三种方式检索了一遍——关键词匹配(朴素)、向量搜索加索引(进阶)、可换检索器(模块化)。这个设计的教学意图很好,是让你看见「三档配置」的差别。但三档跑完,它没有给出任何一档的量化对比:同样 100 个问题,三档各答对了多少?检索耗时差几倍?召回率是多少?
三档配置全部跑通,却没有任何一个数字能告诉你「该选哪一档」。这就是操作手册和选型书的差别。
四、唯一像「判断」的判断:参数与非参数
全书 280 屏里,真正在讲「怎么选」的,只有第 50 屏那一屏。
作者先把数据分成两类:参数化数据是嵌在模型权重里的知识,非参数化数据是存在外部、可以直接访问的显式数据。然后他说了这么一段:
「RAG 与微调之间的区别,取决于生成式人工智能模型需要处理的静态数据(参数化数据)和动态数据(非参数化数据)的数量。过度依赖 RAG 的系统可能会变得负担过重且难以管理;而过度依赖微调的系统则无法适应日常信息的变化。」
这段值得单独拎出来,因为它是全书唯一一处「两边都会坏」的表述。绝大多数 RAG 教程的写法是「RAG 有很多优点:不用训练、可更新、可溯源、成本低」,列完优点就开始搭。这本书没有回避另一侧:RAG 用多了会笨重、会难管。
「负担过重且难以管理」这七个字,是干过活的人才会写的。一个把检索器堆到五层的系统,问题不在于慢,在于你无法判断某个错误答案的成因——是分块切坏了、是嵌入模型选错了、是召回条数不够、还是提示词把检索结果挤掉了。每加一层,可能的故障组合乘一次。
作者接着引到图 1.2「决策阈值」:一个 RAG 项目的管理者,在动手之前要先评估这套生态里「已训练的参数化模型」的潜力,再决定参数化和非参数化的配比。这个思路是对的:先算清楚哪些知识是稳定的、哪些每天在变,再决定哪些进权重、哪些进向量库。
可惜的是,图 1.2 之后就没有下文了。没有给出阈值怎么定、没有给「稳定/易变」的判据、没有给一个真实项目的配比案例。它停在「你要先评估」这句正确的话上。这也解释了我前面说的那个性格:它知道难点在哪,但它只肯点到为止。
五、0.857:从「能跑」到「可信」差着三个问题
第 2 章的最后一节叫「用余弦相似度评估输出」,7 屏。这是全书唯一一处谈「怎么知道它答得好不好」的地方,所以它值得被认真读一遍。
作者的做法:拿一个查询,先用 TF-IDF 算余弦相似度,屏幕上打出一行 Cosine Similarity Score: 0.857。然后他自己提出疑问——TF-IDF 的余弦相似度「非常依赖精确的词汇重叠」,虽然也考虑了语义、同义词、上下文用法这些语言特征,但对「概念相似而用词不同」的文本,会给出偏低的分数。所以换成句子变换器(Sentence Transformers),用嵌入来捕捉更深层的语义关系,「这种方法在识别文本之间的上下文和概念相似性方面更为有效」。
这个自我否定是对的,也是必要的。但作为一个「评估」章节,它缺三个最基本的东西:
第一,没有测试集的规模。0.857 是对一个查询算出来的,还是对一百个查询的平均?如果是后者,标准差多少?如果是前者,那这只是一个演示数字,不是评估结果。
第二,没有基线。0.857 算高还是低?和什么比?和「不检索、直接问 GPT」比是多少?和「关键词匹配」比是多少?没有基线,这个数字连量级判断都做不了。
第三,没有人判对错。余弦相似度衡量的是「检索到的文本」和「期望答案」在向量空间里像不像,它不衡量「生成的回答是不是事实正确」。一个 RAG 系统完全可以检索到高度相似的错误文档,然后流畅地生成一个错误答案,相似度依旧漂亮。
更微妙的一点是:作者自己刚论证了 TF-IDF 会低估同义改写的相似度,那么当他报出 0.857 这个 TF-IDF 分数时,读者根本不知道这个数是被低估过的、还是正常的。他先拆掉了自己的尺子,再拿这把尺子量了一个数给你看。
这就是我说的「从能跑到可信」。这本书的验收标准,通篇是「代码跑通了、分数变高了」,没有一处是「答案对不对、错在哪个环节、换一批数据还成不成立」。这是一个 notebook 的标准,不是一套系统的标准。而它卖给你的,是一套系统。
六、索引的理由不是更快,是可追溯
读到第 3 章,我以为会看到「LlamaIndex 更快、更省、更方便」这类话。结果第 235 屏给的理由是另一个:
「如果输出结果不令人满意,原因就不再难以理解了,因为索引使我们能够识别并检查问题的具体数据来源。这一功能使我们能够优化数据输入、调整系统配置,或者更换相关组件(如向量存储软件和生成模型),从而获得更好的结果。」
这段是全书最有工程味的一段,因为它讲的不是「怎么让它跑起来」,而是「它跑歪了以后怎么办」。索引的价值不是检索更快——向量检索本来就不慢——而是可追溯:任意一个不满意输出,你能顺着索引指回「是哪几条数据喂歪了」。有了这个落点,你才能区分三种故障:数据脏、配置错、模型不行。
第三章选的例子也挺好:一个无人机技术的 LLM RAG agent,因为无人机技术正在往消防、交通信息、体育赛事这些领域扩散。作者说这一章要做的是「准备一个 LLM 无人机技术数据集」,下一章再用多模态数据去增强它。同时把 LlamaIndex、Deep Lake、OpenAI 三家拼在一起用,理由是「不必自己实现所有必要功能」,并且列出了四种索引类型:向量索引、树索引、列表索引、关键词索引。
这是全书结构上最合理的一章:先给动机(可追溯),再给工具(三家拼装),再给索引类型的分类,最后落到一个具体领域的数据集上。如果整本书都是这个节奏,它会是本好书。可惜前两章不是——前两章是「先搭,搭完再说」。第一章搭完三档配置,第二章搭完一条流水线,都是在第 70 屏、第 164 屏这种位置突然开始贴代码,前面没有任何「我们为什么要这样搭」的铺垫。
七、机器翻译在你读不懂的地方替你做主
这本书的中文是机翻的,而且是没有通读过的机翻。这不是风格问题,是准确性问题,我举三处,都是随手记下来的:
第一处,也是最严重的一处:第 50 屏把 RAG 注释成了「Retrieval with Adaptive Graphs」。RAG 是 Retrieval-Augmented Generation,检索增强生成,这是全书的核心概念,在讲「RAG 与微调的区别」这一关键段落里,它被译成了一个不存在的词——「自适应图检索」。读者如果只看中文,会以为 RAG 是一种图检索技术,后面所有关于「生成」的论述就全部接不上了。
第二处:第 219 屏把 Sentence Transformers 译成「句子变换器」。这个词在中文技术圈有约定俗成的叫法(句向量模型 / 句子嵌入模型)。「变换器」在中文语境里几乎专指 Transformer 架构,读者看到「使用句子变换器来计算相似性」,第一反应会是「用 Transformer 算相似度」——方向对,但对象错了:算相似度用的是句向量,不是 Transformer 本身。
第三处:第 41 屏把 Lewis et al., 2020 译成「刘易斯等人,2020 年」。这个错不算大,但很说明问题:参考文献里的人名被音译了。你没法拿「刘易斯等人 2020」去查原文,而这本书每章末尾都专门给了 References 和 Further reading——它一边鼓励你去查文献,一边把文献作者的名字译成了查不到的形式。
三处错误有个共同点:都发生在概念最吃劲的地方。RAG 的定义、句向量的名字、奠基论文的作者——这三处恰好是读者最需要准确的地方,而它们恰好是机翻最容易糊弄过去的地方。这不是巧合:机翻在常见句式上表现很好,在术语和专名上最不可靠,而术语和专名恰恰是技术书的价值所在。
所以我给一个实用建议:这本书可以买,但中文部分当导读用,关键概念一律回到英文原文核一遍。好在它是双语对照排版,英文就在上面几行,核起来不费事。这也算是它排版「啰嗦」的一个意外好处。
八、它的短板
第一,验收标准停在了「跑通」。151 屏代码,没有一处给出量化对比:三档配置的召回率、准确率、延迟、成本,一个数都没有。唯一一个数是余弦相似度 0.857,还是个没有基线的孤立数字。这导致全书最有教学价值的那个设计——同一批数据跑三种配置——失去了它最大的价值:你看见了三档,但你不知道该怎么选。
第二,零失败复盘。280 屏里没有一次「这条路走不通」。真实搭 RAG 的人都知道,绝大部分时间花在失败上:PDF 解析把表格拆碎了、分块把一句话切成两半、嵌入模型对中文财报术语不敏感、召回五条里三条是同一段的重复。这些真实的坑,这本书一个都没写。它的世界里,代码只有两种状态:还没写,和跑通了。
第三,成本与延迟完全缺席。它用了 OpenAI 的模型(第 1 章末尾明确说对 GPT-4o 的输入做了增强),用了 Deep Lake 做向量库,用了 LlamaIndex 做索引,这三样都要钱,也都有延迟。但全书没有出现过一次 token 数、一次调用费用、一次端到端耗时。对项目经理这个目标读者来说,这是最该有的一节。
第四,结构是「先搭后讲」。第 1 章第 72 屏突然开始贴 notebook,第 2 章第 164 屏突然开始搭流水线,两处都是在概念铺垫还没完成时切进代码。结果是读者一边读代码一边猜意图。第 3 章反过来做了(先讲动机再给工具),效果好得多,说明作者不是不会,是前两章没这么做。
第五,前置 11 屏广告页进了正文流。3.9% 的篇幅用在教读者扫二维码换权益包,位置还在一本书最宝贵的开头。
第六,也是最根本的一条:它承认「没有银弹」,却只给了弹药清单。第 35 屏那句 There is no silver bullet,是全书认知水平最高的一句。但承认没有银弹之后,一个负责任的做法是给出「怎么在十个框架里做减法」的方法——什么情况下你根本不需要向量库、什么情况下关键词检索就够了、什么情况下该去做微调而不是加检索层。这本书的选择是反过来:把十个框架都介绍一遍,把三档配置都实现一遍,让读者自己去感受。
对工程师,这个做法可以接受,因为工程师会自己试。对项目经理——书的另一个目标读者——这个做法等于把选择权原封不动退回去了,还多收了 280 屏的时间。
最后一条要老实交代:我只读到第 280 屏,第 3 章没读完,第 4 章之后(多模态、以及后面关于部署与优化的章节)我完全没看到。所以上面关于「全书」的判断,严格说只对前 280 屏成立。如果后面几章补上了成本、延迟、失败复盘这些内容,那我这几条批评就要打折。从已有的三章节奏看,我不太乐观,但这是推测,不是结论。
这本书最值钱的三页,是第 35 屏的「没有灵丹妙药」、第 50 屏的「过度依赖任一侧都会坏」、第 235 屏的「索引是为了可追溯」。三页读完,一个做过项目的人已经能自己往下走了。剩下 277 屏是给要动手的人的——而且你得带着英文原文一起读,因为中文那半边的术语,得你自己校对。
书名:RAG-Driven Generative AI 作者:Denis Rothman 出版:Packt(中英对照版,微信读书)
本次阅读:微信读书逐页截图 280 屏,33 个章节块,覆盖版权页、Preface、第 1 章全章、第 2 章全章、第 3 章前 47 屏;在第 280 屏抓取中止,未读到全书完。
未读到:第 3 章「搭一个语义搜索引擎」之后的部分,以及第 4 章起全部章节。
判断依据:屏数比例按本地 pages.jsonl 的章节分段逐段统计(前置 33 / 第 1 章 110 / 第 2 章 90 / 第 3 章 47,合计 280);概念与代码的划分以「是否连续贴 notebook 代码」为准,属于我的读法,不是书里的分类。引文均取自截图 p35、p41、p50、p60、p62、p72、p135、p219、p235。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: