
《具身智能》:最难的那一步,只写了两屏
微信读书《具身智能》(刘云浩 著,中信出版集团,2025 年 1 月,ISBN 9787521772098)· 本次逐页翻阅 273 屏,从版权页读到「全书完」,序言、上下篇 10 章、结语与参考文献全部覆盖,抓取标记为全书读完(end=last_page),耗时 289 秒。这本没有遇到会员卡遮挡,273 屏我都读到了。
说明:同名或近名的书这两年出了不少,这一本是刘云浩写的,路子是「讲清来龙去脉」而不是「教你怎么跑代码」。我的评价标准也就照着它的野心来:看它有没有把「具身」这件事讲出跟「离身」不一样的地方。
这本书叫《具身智能》,但它有 92 屏在讲「离身」的人工智能。
不是顺带提一句那种讲法。上篇「机器可以思考吗?」整整 87 屏,从图灵的童年、哥德尔不完备、达特茅斯会议,一路讲到符号主义的野望、联结主义的翻身、行为主义的机器崛起、大模型的困局。等到第 5 章「和光同尘,从离身智能到具身智能」,页码已经翻到 98。
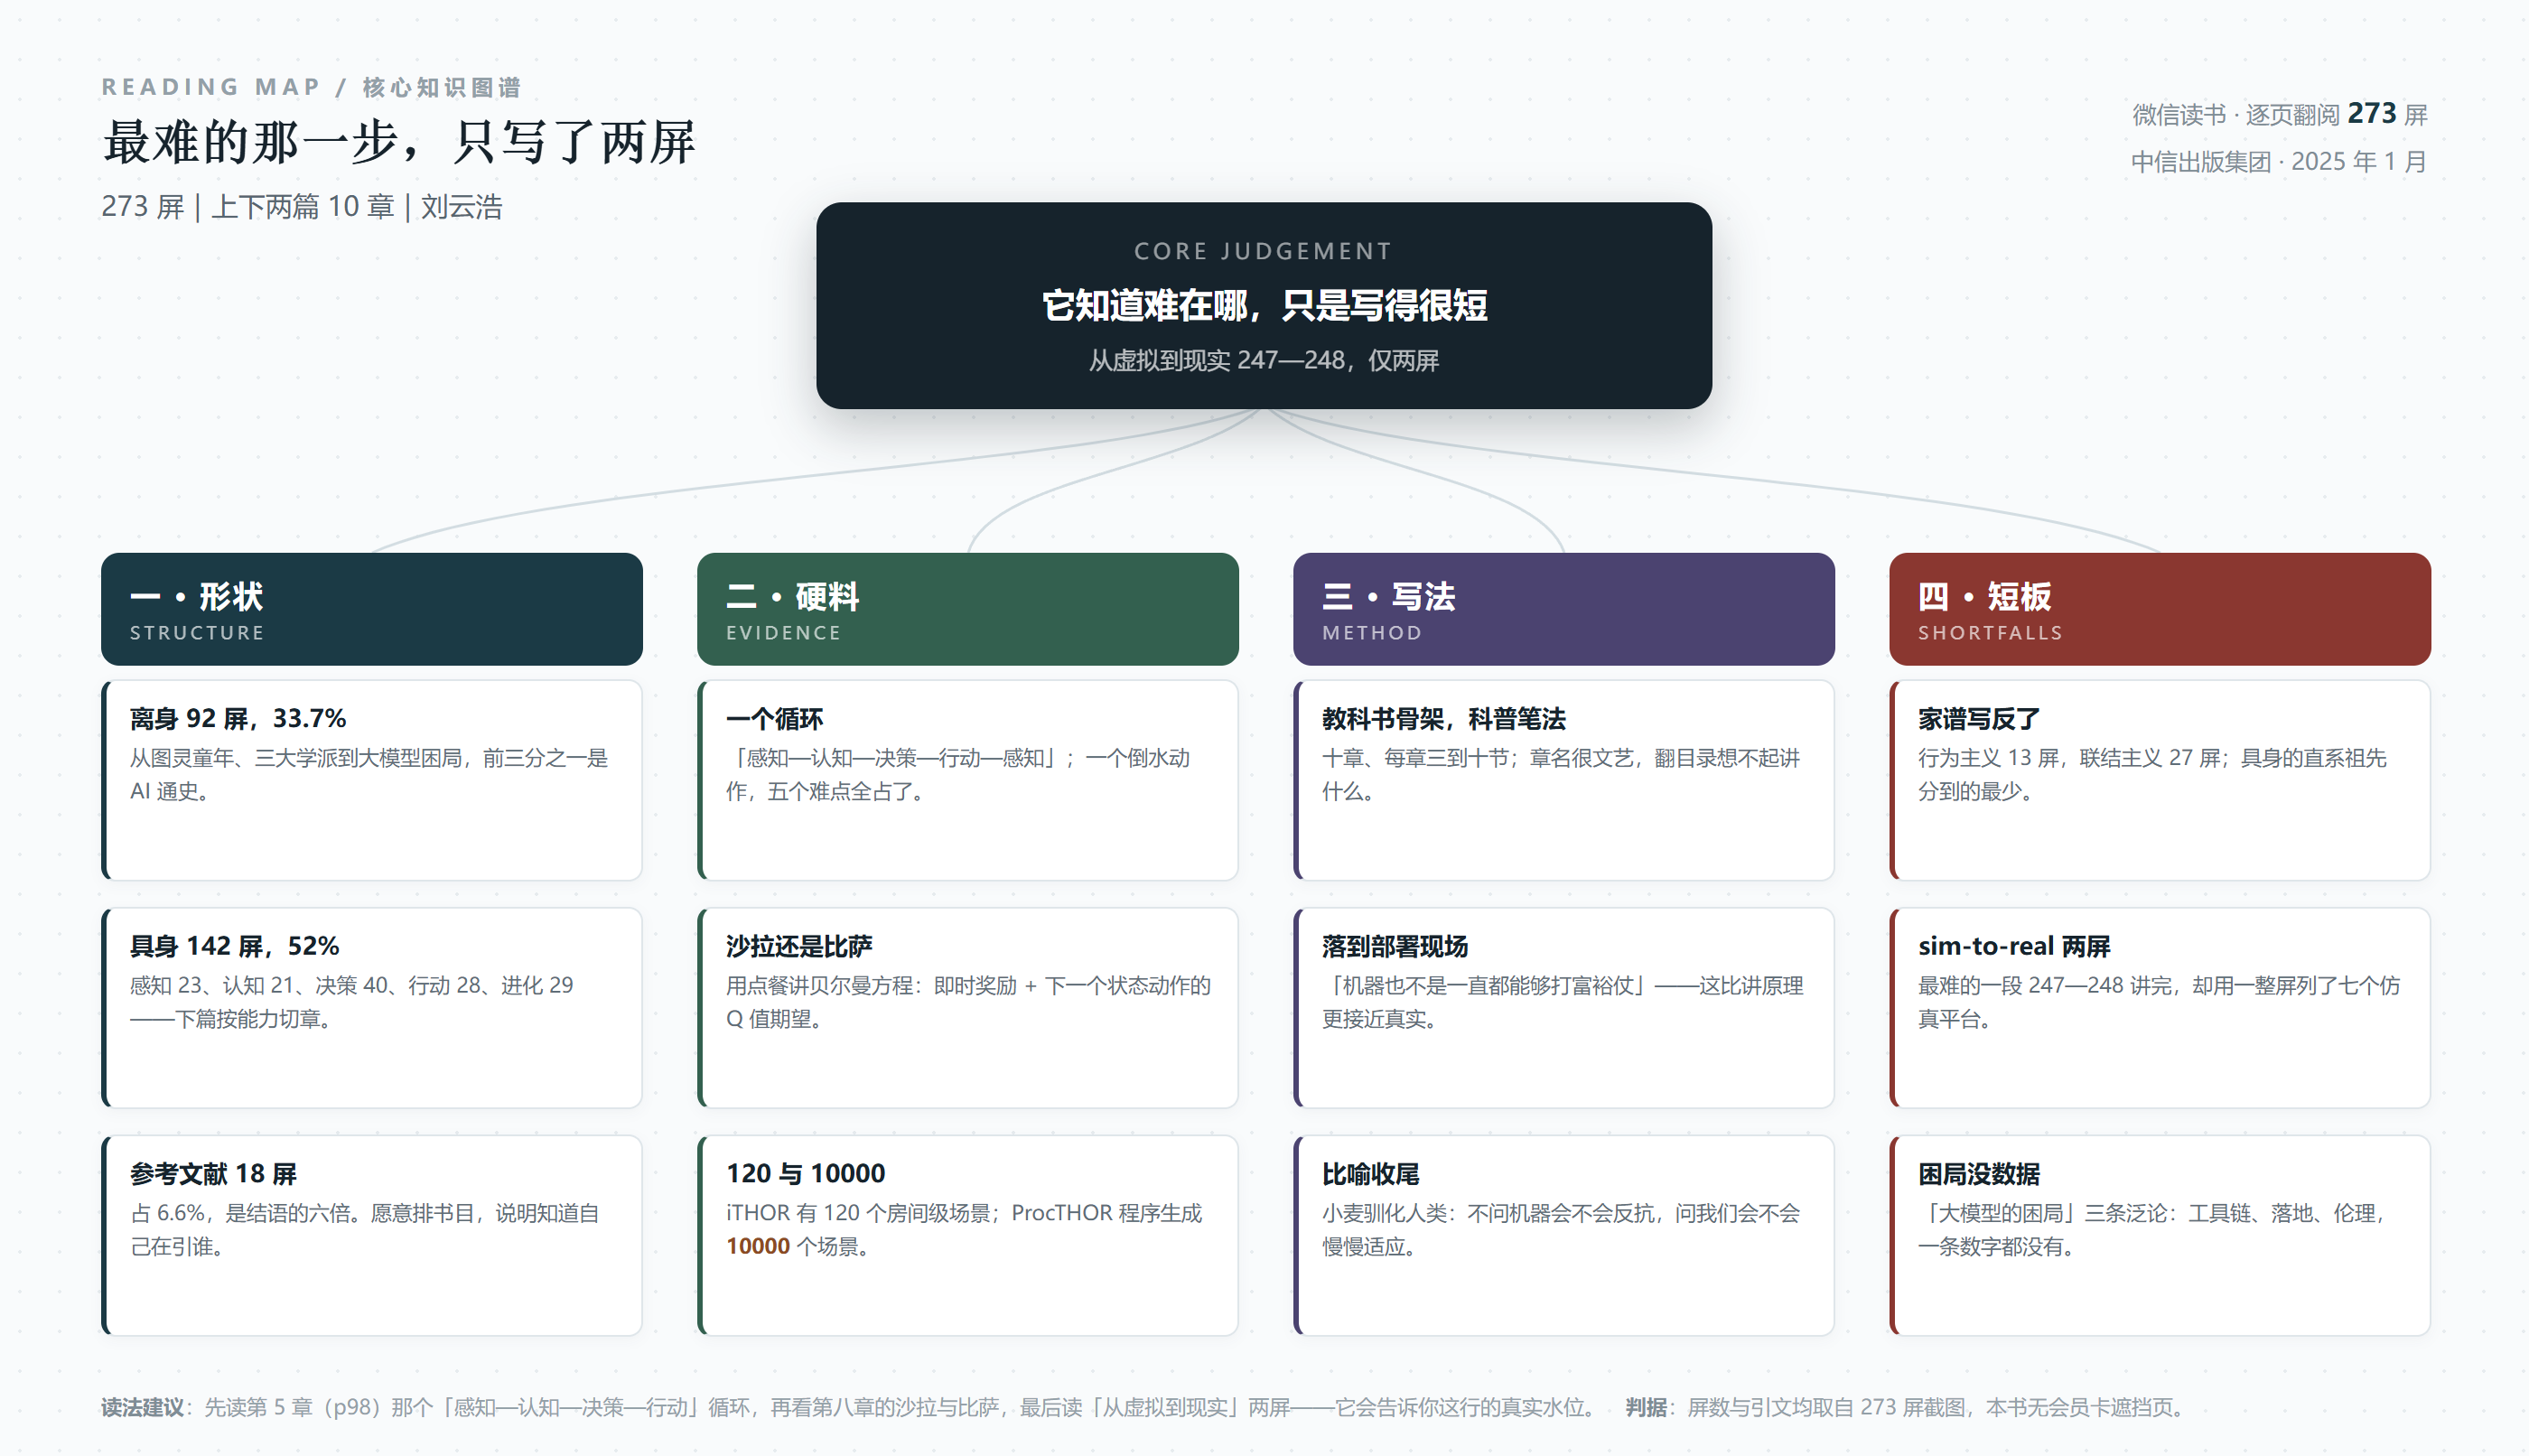
我先把判断放前面:这个结构不是失误,是这本书最诚实的地方——因为「具身」这件事,本来就是在跟前面那 92 屏的失败史对照着才说得清的。但它也因此暴露了一个更难堪的事实:全书 273 屏里,最难的那一步「从虚拟到现实」,只写了两屏。
一、先交代这本书的形状
按章节起始页相减,273 屏是这么分的:
版权与序言「种到地里的娃娃」3 屏;图灵前史(从童年、完备性、让机器思考到人工智能诞生)19 屏;上篇「机器可以思考吗?」87 屏,其中符号主义 16 屏、联结主义 27 屏、行为主义 13 屏、大模型 17 屏、离身到具身 13 屏;下篇「模仿游戏」142 屏,其中感知 23 屏、认知 21 屏、决策 40 屏、行动 28 屏、进化 29 屏;结语 3 屏;参考文献 18 屏。
三句话概括这个结构:讲历史的部分占 33.7%,讲能力的部分占 52%,参考文献占 6.6%。
参考文献能占到 18 屏,先给它记一分。这两年讲 AI 的中文书,末尾直接「全书完」的太多了;一本愿意把参考书目排 18 屏的书,至少作者知道自己在引用谁。
体例上,这是「教科书骨架 + 科普笔法」:十章,每章三到十个小节,小节标题写得有点文艺——「符号主义的野望」「联结主义:从模仿到超越」「和光同尘」「知者敏于行」「楚门的世界」。这个搭配不算常见,好处是读得下去,坏处是有些小标题一看就不知道要讲什么(「P人行为主义学派」这种,我读完了也没完全确定那三个字想说什么)。
结构里最值得说的一处失衡,我先记在这里,后面展开:联结主义 27 屏,行为主义只有 13 屏。而「具身」这件事,从思想血缘上讲,恰恰是行为主义的直系后代。
二、他为什么从图灵的童年讲起
序言只有 3 屏,但把这本书的问题意识交代干净了。他先给了一个规模的对比:
接着他提了一件当时的新闻:2023 年 OpenAI 的「宫斗」,奥尔特曼被解雇,「人们猜测其中原因可能有人类尚未准备好迎接通用人工智能的到来」。然后他抛出真正的问题:
三个问题,问得很准。尤其第二个——「方法论还是一个发展阶段」——这是行内才问得出的问题:如果具身是一种方法论,那它跟「多模态」「强化学习」是并列的技术路线;如果它是一个发展阶段,那它就是「AI 的下一个阶段」,所有公司都得转。这两条路对产业的含义完全不同。
他的答案是回到起点:「带着这些疑问,我们可能要回到梦的起点,『人工智能之父』艾伦·图灵的那个遥远的下午。」
于是有了前面那 92 屏。我必须公平地说:这 92 屏写得比市面上多数 AI 通史好。他没有把它写成「某某年某某发明了某某」的年表,而是围绕一个真问题——机器能不能思考,为什么这件事这么难——把三大学派的分歧摆开。哥德尔不完备、达特茅斯、感知机的起落、专家系统的兴衰,这些故事的讲法是有选择的,不是流水账。
但公平之后还是要说:这三个问题,书里到最后也没有逐条回答。「是方法论还是发展阶段」——我读到结语(253 屏起,3 屏)也没看到一句「所以它其实是……」。他更愿意讲故事和比喻,不太愿意下定义。这是科普作者的自由,也是这本书在学术上站不到最前排的原因。
三、行为主义只给了 13 屏,这是全书最大的失衡
上篇四章讲三大学派,篇幅是:符号主义 16 屏,联结主义 27 屏,行为主义 13 屏,大模型 17 屏。
这个分配放在一本 AI 通史里毫无问题——联结主义今天赢了,多给篇幅是应该的。但这是一本讲「具身」的书。「具身」的思想祖先是 Brooks,是行为主义,是「没有表征、没有推理,直接在环境里反应」那条路。你讲具身,却把它的来处写成全书最短的一章(除了序言和结语),这个比例说不过去。
更具体地说,第 3 章「行为主义的世界很大」13 屏里,真正讲 Brooks 那套「包容架构」(subsumption architecture)的地方很少,更多在讲「机器崛起」这类产业侧的故事。而第 2 章联结主义 27 屏里,从感知机到反向传播、从「重要的常识」到「英雄不问出处」,讲得很细——细到花 8 屏专门讲「常识」这件事。
我理解作者的选择:读者关心大模型,关心常识,关心「为什么 ChatGPT 会胡说」。但一本叫《具身智能》的书,读者最该被讲清楚的恰恰是「为什么不能只靠大模型」——而这个答案,就藏在被压缩到 13 屏的那一章里。书的开头答应你要讲「具身和离身有什么不同」,读到三分之一,你拿到的却是「离身智能是怎么长出来的」。这笔账,读者会用页码来算。
四、他用一个循环把半本书串起来了
第 5 章(98 屏起)是全书转折,也是我认为写得最经济的一处。他没有用人形机器人开场,而是先问「具身一定是人形吗」,然后用一个循环把下篇五章的结构定了下来:
这个循环落得很实。他不是抽象地说「要有感知」,而是给了一个能看见的场景:「一个想喝水的智能体观察到周围有水壶和杯子,基于水壶里有水、杯子能装水的认知,就会制订一个行动计划:走向水壶,拿起杯子,倒水,最终喝水。」
倒水这件事,对人是一秒钟,对机器是四十年。这个例子选得好,因为它同时包含了视觉(找到杯子)、常识(杯里有水)、规划(先拿杯再倒)、控制(别洒了)、力觉(别捏碎)。五个难点,一个动作全占了。
下篇五章就照这个循环排:第六章感知、第七章认知、第八章决策、第九章行动、第十章进化。
我要挑一处:「进化」被排在最后,当成收尾,这是把因果顺序搞反了。对具身智能来说,「数据从哪来、怎么积累」不是最后一章的事,是第一章的事——正因为真实世界的交互数据又贵又慢,才有仿真、才有人形、才有遥操作,整个行业的技术选择都是被这一条约束逼出来的。把进化放在末尾,读起来像是「最后我们展望一下未来」,其实是把全书最硬的那根约束挪到了脚注的位置。
五、最聪明的一段科普:减肥与贝尔曼方程
第八章 40 屏,是下篇最长的一章。里面有一段,我认为是全书写得最聪明的地方。
他要讲贝尔曼方程,没有上公式,先设了个场景:你在点餐,一家轻食餐厅的蔬菜沙拉,和一份满肉比萨,选哪个?
他还补了一个很容易被漏掉的细节:「这里的奖励不一定是指体重变化的数值,但是一定反映了我们想要的体重变化趋势。」这一句把「奖励设计」这个新手最容易踩的坑点到了——奖励不是目标本身,是目标的代理,而代理一旦设歪,Agent 就会去优化那个歪的东西。
更妙的是他把「状态转移」也落到了吃饭上:同样的食物吃多了会腻,「这也可以被包括在状态转移当中」。然后他说,把身体所有可能的状态和所有可能吃的食物列出来,就能「构建出一堆贝尔曼方程」,每个方程的 Q 值都是未知量,只有即时奖励是已知常量,解出来存成一张表,「策略学好了,就大功告成」。
但这里也正是我要挑的地方。「策略学好了,就大功告成」这句话,只在网格世界和点餐这种离散小空间里成立。真实的具身场景里,状态是连续的高维向量,动作是关节力矩,状态空间根本列不出来,那张表也存不下。贝尔曼方程在书里是甜的,在机器人身上是苦的——这个落差,作者用「实战」两个字轻轻带过了。
我猜这是科普写作的必然妥协:要让读者尝到味道,就得先切掉骨头。但读者至少该被告知骨头在哪。这本书在第八章给了 40 屏讲决策,却没花半屏说明「为什么真实机器人不用 Q 表」——这是我认为它最可惜的一处省略,比前面那 92 屏的篇幅问题更可惜。
六、最难的那一步,只写了两屏
现在说这本书真正的破绽。
具身智能有一个所有人都知道、但很少有人愿意细讲的问题:仿真里训好的策略,搬到真机上就废了。行话叫 sim-to-real gap。光照变了、摩擦系数不一样、摄像头有噪声、电机有回差——每一条都足以让一个在仿真里成功率 95% 的策略掉到 30%。这是这个领域最贵、最慢、最不体面的一段路。
这本书讲它的地方,是第十章「进化」里的「从虚拟到现实」一节。页码:247 到 248,两屏。
对比一下:讲平台清单的那一屏(p233),信息密度是这样的——AI2-THOR 于 2017 年由艾伦人工智能研究所开发,iTHOR 有「120 个房间大小的场景,涵盖卧室、浴室、厨房和客厅,由专业 3D 艺术家进行建模」;RoboTHOR「旨在解决从仿真到现实的领域自适应问题」;ManipulaTHOR 专注机械臂精细操纵;ProcTHOR「通过程序生成技术来大规模创建多样化的训练环境,其数据集包括 10000 个场景」。一屏之内,七个平台名,两个数字。
我不否认这份清单有用,它确实是一份能直接拿去查的索引。但把它和「两屏的 sim-to-real」放在一起看,一本书的重心就露出来了:它更愿意告诉你「有哪些平台」,不太愿意告诉你「为什么搬不过去」。前者是可以查到的公开信息,后者才是作者本人的经验。
第九章「行动」里倒是有真东西。他讲多传感器融合的难处——「人类的感官融合是长久以来的进化结果,而在这方面,机器智能刚刚起步」;讲 DenseFusion 为什么分别处理 RGB 和深度数据而不是简单并成一路;讲 TAVI(从视觉激励中做触觉适应)为什么要用视觉奖励来优化触觉策略,因为「仅依靠现有智能机器的触觉感知无法提供足够的线索来推理物体的空间配置」;讲 AnyGrasp 用一台普通深度相机就能对堆叠、不规则、没见过的物体稳定抓取。
还有一句我很喜欢:「机器也不是一直都能够打『富裕仗』」——意思是别假设机器人有全套传感器、有无限算力、有干净环境,真实部署里它什么都没有。这句话比前面 200 页都更接近工程现场。
抓取那一段也写得活:「不同的物体需要不同的抓取策略:滑溜的陶瓷杯和粗糙的橡胶球,它们的抓取方式截然不同。」后面还跟了个括号,说不想让「自己精心淘来的……咖啡壶被打碎」。这句括号里的原文我读着有点别扭(主谓像是漏了个「不」字),意思倒是清楚的:抓取这件事,力度差一点就是碎片。
所以我的结论是:这本书不是不知道难在哪,它知道,只是把那部分写得很短。273 屏里,「感知—认知—决策—行动」各给 21 到 40 屏,写得从容;轮到把它们连起来、落到一台真机器上的那一步,只给了 2 屏。这不是作者偷懒,这是这门学科当下的真实状况——能公开讲的东西还太少。但书里没有把这句「少」说出来,反而用平台清单把版面填满了。读者读完会觉得「都讲到了」,其实最难的那一格是空的。
七、他最后想到的是小麦
结语前最后一节叫「模仿游戏还是进化游戏」,是全书思想密度最高的一节,也是我最想跟作者争论的一节。
他借了一个《人类简史》式的比喻:小麦没有主观意识,却在进化竞赛里「驯化」了人类,让人类从狩猎采集者变成农民,改变了生理结构、生活方式乃至社会结构。然后他把这个比喻推到机器身上:
他还给了两个具体的例子:「特斯拉的人形机器人『擎天柱』已经在工厂中帮助工人完成各种任务,Figure 01 机器人展现了与人类以自然语言沟通的能力。」
这个比喻的力量在于它换了个视角:不问「机器会不会反抗」,问「我们会不会不知不觉地适应它」。后者比前者现实得多——我们已经在为手机调整作息、为导航放弃记路、为推荐算法改变口味。具身智能只是把这套适应推进到身体层面。
但我要提一个反驳,而且我认为这个反驳挺要紧:小麦没有目标,机器有。小麦的「驯化」是自然选择的无意图结果,机器人的「驯化」是有人写需求、有人投钱、有人调参的结果。用「进化竞赛」来讲 AI,最容易被抹掉的就是这一层——设计者的意图。而这个意图恰恰是可以被追问的:谁在定义「有用」?谁在为「适应」付费?把这些抹掉,剩下的就是一个听起来很酷、但没法归责的故事。
这也是我读这本书整体的一个感受:它的比喻都比它的论证好。「感知—认知—决策—行动」循环、喝水倒水、减肥讲贝尔曼、小麦驯化人类——每一个比喻都准、都好记、都能立刻转述给别人。但比喻到此为止,再往下那一步(谁的意图、谁的成本、搬不过去的那 2 屏)它就不走了。这不是一本要跟你吵架的书,是一本要让你听懂的书。听懂之后要吵架,得靠自己。
八、它的短板
一条条说,都能指到页码。
第一,篇幅分配跟书名不一致。讲「离身」的历史 92 屏(33.7%),讲「具身」的能力 142 屏(52%),中间 13 屏过渡。而「具身」的直系祖先行为主义只分到 13 屏,比联结主义少一半。读者奔着「具身」来,前三分之一拿到的是 AI 通史——写得再好,也是答非所问。
第二,「大模型的困局」写得敷衍。这一节 3 屏(p95—97),列了三条:开源社区与工具链不完善、商业化落地待探索、伦理与安全问题。三条全是泛论,一条数据都没有;「最后是伦理和安全问题」一句就收尾了。同一本书里讲 CUDA 的局限时,能具体到「它只能在英伟达的 GPU 上运行」、能提到 OpenCL 和 ROCm——说明作者有能力写具体,只是这一节没舍得花力气。
第三,术语和小标题有门槛。「P人行为主义学派」这个标题,我读完整章都没确定那三个字指什么(是某个人名缩写,还是排版里掉了字?);「和光同尘」「大道之行,多则异也」这类章名很漂亮,但翻回目录时想不起里面讲了什么。科普书的小标题首先是导航,其次才是文采,这本书常常把顺序颠倒了。
第四,平台清单挤掉了判断。p233 那一屏塞了 AI2-THOR、iTHOR、RoboTHOR、ManipulaTHOR、ProcTHOR、Habitat、Gibson 七个名字。信息是真信息,但它更像是「查得到的东西」,不是「只有作者能说的话」。一本科普书的价值应该在后者。
第五,正文与参考文献没挂钩。参考文献 18 屏,看得出用了功;但我翻过的十几页正文里,没有见到一处角标编号指向它。也就是说,那 18 屏读者基本用不上——想核一句话出自哪篇论文,还是得自己猜。
九、一句话
这本书我读了 273 屏,记住的是那个喝水的循环、那份蔬菜沙拉与满肉比萨、那句「机器也不是一直都能够打富裕仗」,还有小麦驯化人类那个让人脊背发凉的比喻。
具身智能最诚实的地方,是它承认自己还没走完「从虚拟到现实」那一步;这本书最诚实的地方,是它把这一步写得很短——短到你看完会明白,这个领域真正难的部分,现在还写不成书。
书名:具身智能 作者:刘云浩 出版:中信出版集团,2025 年 1 月 ISBN:9787521772098
本次阅读:微信读书逐页截图 273 屏,序言 + 上下篇 10 章 + 结语 + 参考文献 18 屏,从版权页至「全书完」,耗时 289 秒,抓取标记
end=last_page。未读到:无。本书未遇到会员卡遮挡页。
判断依据:章屏占比按 pages.jsonl 章节起始页相减得出;引文均来自截图原文,页码为本次截图编号。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: