
《人工智能安全发展报告(2024—2025)》:叫安全报告,只花 10.4% 讲安全
微信读书《人工智能安全发展报告(2024—2025)》(蒋艳 主编,国家工业信息安全发展研究中心)· 本次逐页翻阅 364 屏,从版权页读到「全书完」,15 篇报告、5 个部分、2 个附录与英文摘要全部覆盖,抓取标记为全书读完(end=last_page),耗时 997 秒。需要说明:个别页面(如 p70)被会员卡提示遮挡,那部分正文我没有读到。
说明:这是一本年度皮书,不是专著。所以我的评价标准也不该一样——我不要求它有创见,只要求它记账准确、出处可查、口径统一。本篇不复述目录;加引号的话都能在截图里逐字核对,页码为本次截图编号。
这本 364 屏的报告,书名里有「安全」两个字,出版方叫「国家工业信息安全发展研究中心」。我读完之后做的第一件事,是把每一章的屏数数了一遍。
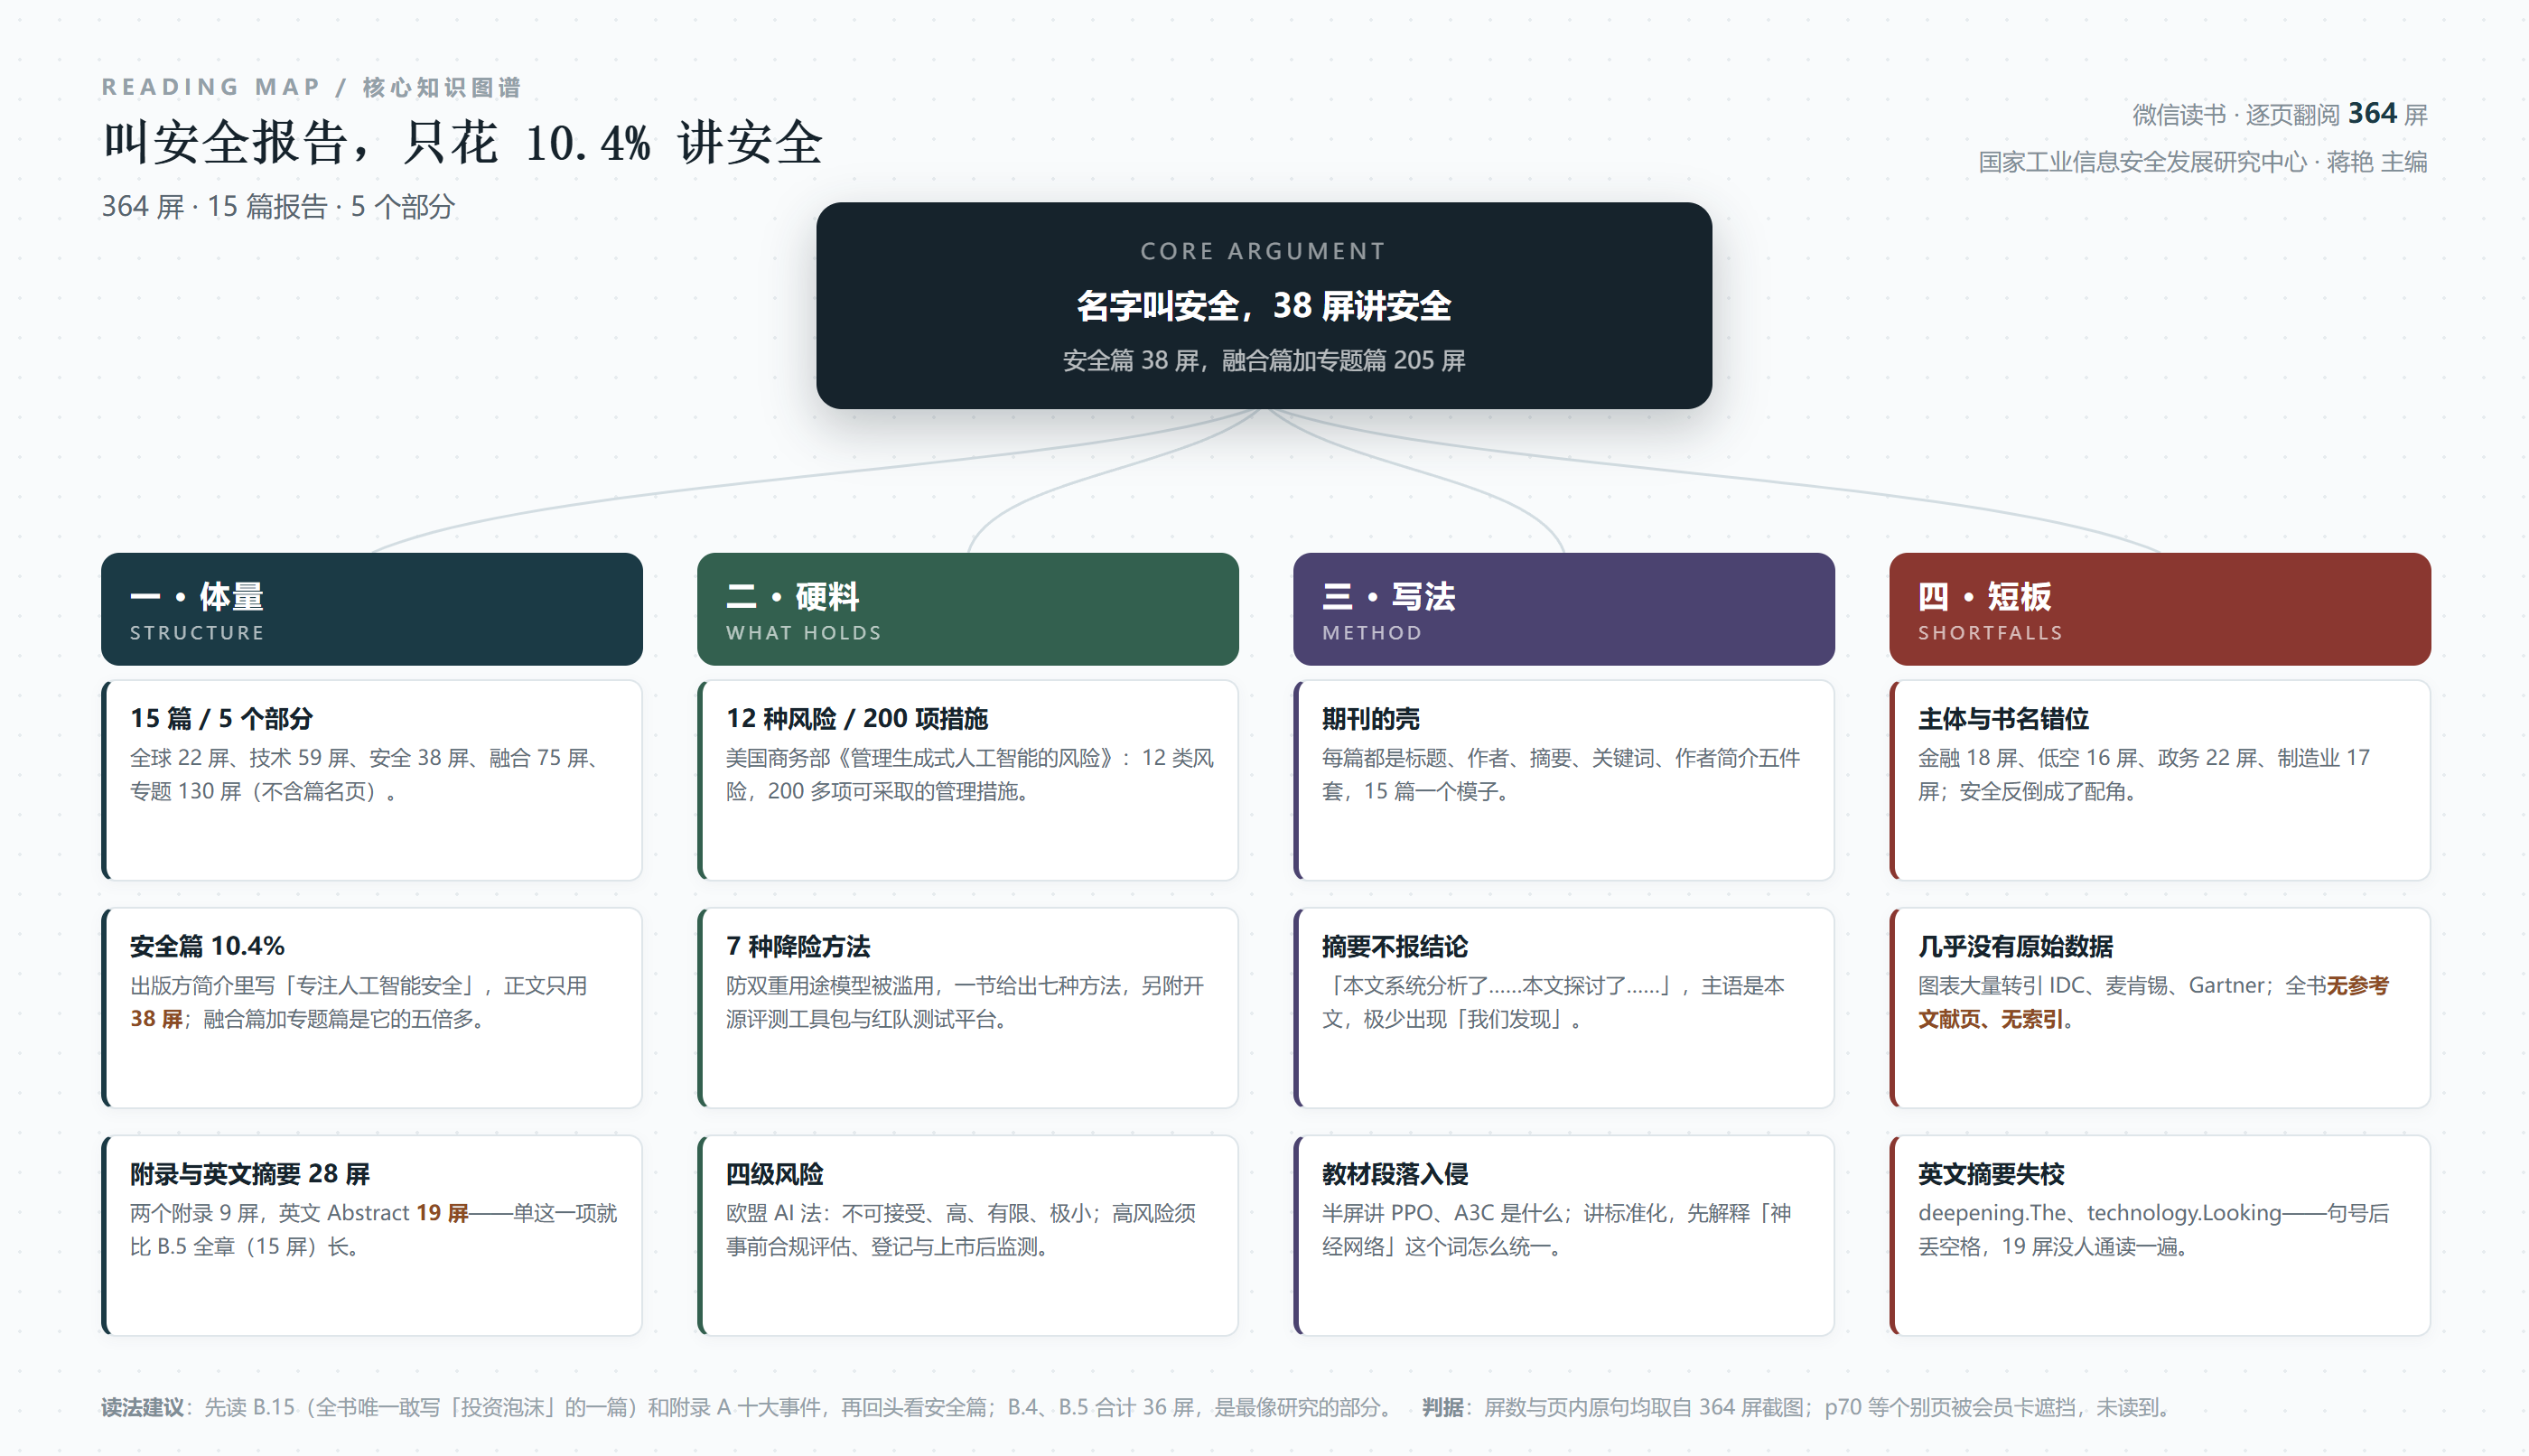
结果是:真正归在「安全篇」名下的,只有 38 屏,占全书 10.4%。
一、先算一笔账:这本书有多厚,安全就有多薄
先说这本书的骨架。摘要页写得清楚:主体分 5 个部分,即全球篇、技术篇、安全篇、融合篇、专题篇,共 15 篇报告。按章节起始页相减,屏数分配是这样:
全球篇 22 屏(B.1 全球人工智能产业发展综述);技术篇 59 屏(B.2 推理大模型 27 屏、B.3 端侧算力 30 屏);安全篇 38 屏(B.4 全球人工智能安全治理研究 21 屏、B.5 美国商务部人工智能安全研究所计划启示 15 屏);融合篇 75 屏(B.6 制造业 17 屏、B.7 政务 22 屏、B.8 金融 18 屏、B.9 低空经济 16 屏);专题篇 130 屏(B.10 大模型的未来 22 屏、B.11 AI 智能体 21 屏、B.12 具身智能 28 屏、B.13 标准化 18 屏、B.14 开源社区 12 屏、B.15 投资 27 屏);最后是两个附录 9 屏和英文 Abstract 19 屏。
把这些数字排在一起,问题就自己浮出来了。一本叫《人工智能安全发展报告》的书,安全篇占 10.4%,融合篇加专题篇占 56.3%。金融、政务、低空经济、制造业这四个行业的篇幅加起来 73 屏,是安全篇的近两倍。
我不认为「安全篇薄」这件事本身是错的。安全是个横切面,它可以散在各章里——制造业那篇确实提了「安全风险」,政务那篇也提了数据安全。但散着写和集中写,是两种不同的书。「散着写」的代价是:没有任何一章对风险做过定量评估。15 篇报告里,我找不到一处这样的句子——某类风险在什么条件下、多大概率、造成了多大损失、用哪个评测集测出来的。
有一点要公允说:安全篇的这两篇,是全书最像「研究」的两篇。B.4 和 B.5 合计 36 屏,信息密度明显高于其他章。它们不好,不是因为写得差,是因为写得太少。这本书最该长的那一块,恰恰是最短的那一块。
顺带一个外部信号。微信读书上这本书的推荐值是 74.2%,20 人点评。样本很小,不能当结论,但方向和我的体感一致:有用,但不好读。皮书这种体裁的读者,大多是「要用」而不是「要读」,74.2% 这个分数恰好落在这个位置上——不是写得差,是不适合从头读到尾。
二、体例:期刊的壳,年鉴的骨
要理解这本书为什么会写成这样,得看它的体例。15 篇报告,每一篇的结构完全一样:标题、作者、摘要、关键词、作者简介,五件套齐备。
B.2「推理大模型」的开头是这样的(p37 原文):
摘要:本文系统分析了推理大模型的技术发展现状,涵盖其定义、分类、关键技术及国内外的研究进展。本文探讨了推理大模型在产业中的应用现状,包括产业规模、发展特点、产业链结构、市场格局以及重点企业的布局情况。本文深入剖析了当前技术与产业发展面临的瓶颈与难点,并展望了未来的技术创新方向和产业趋势,为相关领域的研究与实践提供了参考。
关键词:推理大模型;技术发展;产业现状;瓶颈;趋势
这段摘要把「期刊的礼貌」学得很到位:摘要、关键词、作者单位、研究方向,一应俱全。但你仔细读它的动词——分析了、探讨了、剖析了、展望了、提供了。五个动词,主语全是「本文」。它告诉你这篇文章做了哪些动作,没有告诉你它发现了什么。
摘要的功能本来是「结论前置」:让没时间读全文的人,只看这一段就知道作者的判断。这里的摘要变成了「动作登记」:登记自己按流程走完了哪些步骤。这两者的差别,相当于一份体检报告的两种写法——一种是「你的血脂偏高,建议复查」,另一种是「本文对受检者进行了血常规、肝功、血脂、心电图等项目的检查」。
我抽查了几篇的摘要,B.10「大模型的未来」是相对最好的一篇,因为它至少点了具体的名字:「相关研究(如 JEPA)展示了自监督学习在提升模型泛化能力方面的潜力」。这是全书摘要里少见的、可以被追问的一句——JEPA 是什么、它的泛化能力怎么测的、和对比学习比强在哪。可惜正文没有接着答。
然后是作者构成,这一条我认为是全书最关键的一条线索。15 篇报告的作者,绝大多数来自国家工业信息安全发展研究中心内部:人工智能所工程师、科研部副主任、正高级工程师。这本来没什么问题——一个机构出年鉴,当然用自己的人。
但有一个例外。B.15「人工智能投资触底反弹聚焦 AIGC」的作者是海玉洁,单位写的是「北京清研灵智科技有限公司」,职称是「中级统计师」。而这一篇,恰好是全书唯一敢下判断的一篇(下一节细说)。
我不认为这是巧合。一个机构的内部作者写内部报告,要照顾的是「口径」;一个外部作者写一章,要照顾的只是「我说的话站不站得住」。同一本书里,唯一一处带锋芒的判断,来自唯一一位不在编制内的作者。这句话比这本书里任何一段分析都更能说明「年度报告」这种体裁的天花板在哪。
三、真正立得住的三张清单
批评归批评,这本书有三处东西是可以直接拿去用的。我把它们叫「三张清单」,因为它们的共同点是:可抄、可对照、不需要再加工。
第一张:美国商务部那五份指南,和三个数字。B.5 讲的是 2024 年 7 月 26 日美国商务部发布的人工智能安全研究所计划。它把五份文件列了出来,其中三份给了具体数量:《管理生成式人工智能的风险》指南「集中列出 12 种风险以及开发人员可以采取的 200 多项管理措施」;防双重用途基础模型被滥用的指南「提供了七种降低模型被滥用风险的关键方法」;另外还有 AI 模型响应攻击测试平台,提供了一个开源软件包,帮测试人员确定 AI 软件能否抵御对抗性攻击。12、200、7——这三个数字是全书最硬的东西,因为它们可以被追问,也可以被拿去对比。
第二张:欧盟的四级风险。B.4 写欧盟《人工智能法案》时,给了三个层次的信息:2019 年 4 月高级别专家组《可信人工智能伦理指南》提出 3 个要素(合法、符合伦理、稳健)、4 项原则(尊重人的自治、预防伤害、确保公平、具有可解释性)、7 项关键要求;2020 年 7 月的评估清单把 7 项要求细化成评估方法;2024—2025 年先后修订三个版本的《通用人工智能实践准则》。落到监管上,是四级分类:「不可接受、高、有限、极小」,高风险应用要做事前合规评估、登记报告、上市后监测、事件报告。
第三张:附录 A 的十大事件。这是全书最像「台账」的部分,也是最好用的部分。它按时间排:2 月 OpenAI 发布文生视频模型 Sora、9 月发布 o1、12 月发布系列产品;3 月英伟达发布 Blackwell B200,「性能较 H100 提升 5 倍」;6 月工信部等四部门印发《国家人工智能产业综合标准化体系建设指南(2024 版)》;8 月欧盟《人工智能法案》正式生效;10 月本年度诺贝尔物理学奖和化学奖接连颁给人工智能领域科学家;8 至 12 月工信部科技司围绕「技术底座、行业应用、装备产品、支撑保障」四大领域征集典型案例,151 项入选。
为什么这三张清单值钱?因为它们是「对照表」,不是「论述」。你要向老板解释欧盟怎么给 AI 分级,翻 B.4 比翻任何公众号都快;你要知道一个合规方案该列多少条措施,B.5 那个「200 多项」给了你一个量级感;你要快速回忆 2024 年发生了什么,附录 A 四屏就够。
但三张清单摆在一起,也露出了一个问题:它们的颗粒度完全不一样。第一张给的是「数量」(12 种、200 项、7 种),第二张给的是「结构」(四级、3 要素、4 原则、7 要求),第三张给的是「时间」(月份加事件)。三种完全不同的记录方式混在一本书里,说明编者没有为「数据」定过统一规范——每章作者按自己的习惯写,编者按顺序装订。这就是「年鉴」和「研究」的分界线:年鉴允许颗粒度不齐,研究不允许。
四、教材段落的入侵
这本书还有一个特征,读的时候会不断被绊一下:它会在最不该讲基础的地方,突然开始讲基础。
p45 属于 B.2「推理大模型」,正文讲强化学习,然后出现了这么两段:
近端策略优化(Proximal Policy Optimization,PPO):PPO 是一种先进的策略优化算法,旨在平衡探索与利用之间的关系,同时避免策略的剧烈波动。通过引入信任区域的概念,PPO 限制了每次策略更新的幅度……
异步优势演员-评论家(Asynchronous Advantage Actor Critic,A3C):A3C 是一种经典的异步训练框架,通过多个并行智能体与环境交互,收集经验并异步更新全局策略,从而加速策略的收敛。
这两段写得没错,放进教科书是合格的。但它出现在一本「2024—2025 年度报告」里,是错位的。年度报告要提供的是「这一年发生了什么」的信息增量;而「PPO 是什么」「A3C 是什么」,是「这类算法一直存在」的背景知识,跟 2024 年没有任何关系。
同样的错位在 B.13「人工智能标准化研究」里更明显。这一章 18 屏,前三节讲的是「标准化为什么重要」,甚至专门解释术语统一的必要性:「例如,对于『深度学习』『神经网络』等常见的人工智能术语,通过标准化的定义,可以确保不同的研究人员和开发者在用此类术语时具有一致的理解。」——这句话放在 2024 年的国家级报告里,就像在讲「为什么要统一度量衡」。一直到第四节「典型领域标准化实践与案例」,才终于出现具体的东西:ISO 21448《道路车辆 预期功能的安全性》。
我把这个现象叫「教材段落的入侵」。它的成因不难猜:篇幅是按「章」切的,不是按「信息增量」切的。15 篇报告,每篇都得写满 20 屏上下,于是没有新东西可写的章,就靠教科书内容填满。B.2 要凑到 27 屏,就补 PPO 和 A3C;B.13 要凑到 18 屏,就补术语统一的重要性。
这个选择在流程上是最省事的,在阅读上是最贵的——因为读者付出的不是纸钱,是注意力。364 屏里,我估计至少有 40 屏属于「我已经知道,或者我查百科就有」的内容。这 40 屏挤掉的,正好是「安全」那一块本该展开的定量分析。
再说一个对照。B.12「具身智能:人工智能的下一站」28 屏,是全书最长的单篇,它至少做了两件实事:一是把技术演进切成三段(萌芽期、行为主义与计算智能各自突破、2022 年至今的技术突破阶段),二是点名——2023 年的 VoxPoser 用 ChatGPT 理解任务语言描述并分解成步骤,PaLM-E 把真实世界的连续传感器模态融入大语言模型,2024 年的 NaviLLM 为导航任务设计了统一的指令输入,让 LLM 直接生成运动方向、对象位置等行动信息。B.11「AI 智能体」21 屏也点名了 MCP 协议,说它正作为「AI 工具的统一接口」重塑格局,并提到模型厂商通过降低 API 调用费用吸引开发者。
这些名字是有价值的,它们是这一年真实发生的事。但问题还是一样的:VoxPoser 用了多少条演示数据、成功率多少、在什么平台上跑的;PaLM-E 的参数量和训练成本是多少;MCP 到 2024 年底被多少家工具接入——一个数字都没有。所以这两章读起来的手感是「知道发生了什么,不知道事情有多大」。而「有多大」恰恰是判断一件事要不要跟的唯一依据。
五、那 19 屏英文摘要,暴露了一件更基本的事
全书最后 19 屏是英文 Abstract,占全书 5.2%。这个比例本身已经值得说一句:它比 B.5 整章(15 屏)还长。也就是说,一本中文报告用来「证明自己国际化」的英文章节,比它讲美国 AI 安全治理的那一章还厚。
更值得说的是这 19 屏的质量。p347 上,我照抄几句:
…with industry applications expanding and deepening.The open-source ecosystem is gradually being established…
…the AI sector has demonstrated strong industrial resilience, with its investment and financing scale showing counter-cyclical growth.Open-source large models, exemplified by DeepSeek…
…accelerating the democratization of technology.Looking ahead, as computing power clusters undergo continuous upgrades…
三处,全都是句号后面丢了空格。这不是排版软件的小毛病——英文排版里,句号后必须有空格,这是最基础的规范。三处一样的错,只能说明一件事:这 19 屏是用中文摘要机器对齐生成的,生成之后没有人从头读过一遍。
内容上的问题更实在。这 19 屏并不是 15 篇摘要的逐篇翻译,而是把全书压成一段话:全球 AI 技术与产品加速迭代、开源生态逐步建立、在宏观压力下表现出产业韧性、DeepSeek 为代表的开源大模型表现突出、未来走向多模态融合与大小模型协同、人机协同,最后推动技术与产业链关键环节融合。然后是三个关键词:Artificial Intelligence、Large Models、Industry Trends。
也就是说,364 屏、15 篇报告、5 个部分,在英文里被压成了 300 来个词,和三个万能关键词。
我不认为这是翻译水平问题,我认为是定位问题。这 19 屏的真实功能,不是给英文读者看的,是给「需要交一份英文摘要」的评审流程看的。它的存在是为了让这本书在体例上完整,而不是为了让谁读懂。这个动机可以理解,但它挤掉了 19 屏——差不多是一整篇报告的长度。
六、全书唯一敢写「泡沫」的地方,在最后一章
如果这本书只让我留一页,我留 B.15 的摘要页(p310)。它是 15 篇里唯一一段「承担判断风险」的文字:
2024 年,全球人工智能投融资显著回暖,OpenAI 引领热潮,全年融资规模激增。国际科技巨头加速并购,微软、亚马逊、英伟达等密集投资头部企业,资源集中趋势明显。中国市场则趋于理性,早期投资占比略有回升,一级市场融资事件连续三年下滑。AIGC 投融资金额全球领跑,但行业隐现泡沫风险,新增独角兽企业多数未验证商业模式,高估值依赖预期而非盈利,叠加市盈率持续下降,或引发市场调整。
关键词:生成式人工智能;云计算;投资泡沫
注意它的写法,和前面那些「本文系统分析了」完全不同。这一段里有三个可以被证否的句子:一级市场融资事件连续三年下滑;新增独角兽企业多数未验证商业模式;高估值依赖预期而非盈利、市盈率持续下降。每一句都可以被反驳,也都可以被数据支持或推翻——这才叫判断。
再看它的英文关键词:Investment Foam。全书 15 篇的英文关键词里,只有这一篇用的是负面词。
而写这一篇的人,是全书唯一一位不在中心编制内的作者。
我在这本书里读到的最大信息,不是它讲了什么,而是这个对照:同一个体例、同一本书、同一批编辑,内部作者写出来的是「综述」,外部作者写出来的是「判断」。这不是能力差距,是位置差距。站在机构里写年度报告,你要交的是「全面、平稳、无争议」;站在机构外写一章,你要交的只是「我说得对」。前者是记账,后者是研究。年度报告这种体裁,天生偏向记账。
顺带核一个数字。B.15 里有一张「国际科技巨头投资并购」表:微软 2 月投资 Mistral AI 1630 万美元、4 月投资阿联酋 G42 15 亿美元;亚马逊 2 月和 11 月投资 Anthropic 67.5 亿美元;谷歌 8 月「并购 AI 虚拟名人聊天机器人研发商 Character.ai,并购金额为 25 亿美元」。
最后这一条,按公开报道,性质是「非独家技术授权 + 返聘创始团队与部分研究人员」,不是股权收购。这两个词在反垄断语境里差得很远:并购要过经营者集中审查,授权协议不用。一本以「安全」「治理」为主题的报告,在这种基础事实上用词宽松,是不该的。你可以不评价一件事,但你不能把它的法律性质写错。
七、它的短板
五条,都落到具体位置。
第一,主体与书名错位。书名许诺「安全发展报告」,安全篇只占 10.4%(38 屏)。如果这是一本《人工智能产业发展报告》,这个分配完全合理;但它叫安全报告,读者带着「风险地图」的预期进来,拿到的是「产业年鉴」。这不是内容质量问题,是承诺问题。
第二,没有参考文献页,没有索引。364 屏到「全书完」,最后是英文摘要的三个关键词,然后就是结束页。而这本书里到处都是二手数字——产业规模、融资额、市场份额,几乎全部转引 IDC、麦肯锡、Gartner 之类的机构。转引不是错,转引不标出处才是错。读者看到「融资规模激增」,没法知道是哪个口径、哪个统计周期、哪份报告。一本皮书最不该缺的就是这一页。
第三,数据颗粒度不统一。如第三节所说:B.5 给数量,B.4 给结构,附录 A 给时间。三种记录方式没有换算关系,也没有一处交代「为什么这里用数、那里用级」。这让全书无法横向比较——你没法回答「欧盟的四级风险里,'高'对应美国那 12 种风险里的哪几种」,而这恰恰是最需要回答的问题。
第四,时间线上有一处错位。附录 A 第一条写:「12 月,OpenAI 发布了系列产品,包含正式版 Sora 和下一代 AI 模型 o3,模型能力进一步升级。」按公开信息,o3 是 2024 年 12 月公布、2025 年 4 月才对外开放使用。一本横跨「2024—2025」的报告,把「公布」写成「发布」,是把两个时点压成了一个。这种错在单篇报道里可以原谅,在年度台账里不行——台账的价值就在时点准确。
第五,摘要不报结论,教材内容占位。15 篇摘要里,主语几乎都是「本文」;PPO、A3C 这类教科书内容占了 B.2 的篇幅,术语统一的重要性占了 B.13 的前三节。这两件事合起来造成一个结果:书很厚,但「2024 年到底发生了什么变化」这个问题的答案,被稀释在 364 屏里,需要读者自己捞。
(另外说明一句:p70 那一页被会员卡提示遮挡,端侧算力的分级表我没读到,所以关于 B.3 的判断只基于其余 29 屏,不涉及被遮住的部分。)
八、怎么读这本书
我给三种用法,按需求选。
当台账用。只看附录 A 的 4 屏十大事件,加上 B.15 那张投资并购表。这是全书信息密度最高的地方,也最适合「我需要快速回忆 2024 年发生了什么」这个场景。
当对照表用。B.4(21 屏)加 B.5(15 屏),合计 36 屏,是全书最像研究的部分。你要写合规方案、要做风险分级、要向不懂的人解释「欧盟和美国的路子有什么不同」,这 36 屏够用。特别是 B.5 那三个数字——12 种风险、200 多项措施、7 种降险方法——是可以直接引用的量级。
当选题地图用。这本书最有用的读法,是看它哪里没写。15 篇报告覆盖了全球、技术、安全、制造、政务、金融、低空、未来、智能体、具身、标准、开源、投资——看起来全覆盖,但「安全篇」只有 38 屏,且没有一处定量评估。这个空白本身就是明年的选题:谁能在 2025—2026 年拿出一份「某类 AI 风险在真实系统中的实测发生率」,谁就补上了这本报告缺的那一块。
最后说整体判断。这本书我给「值得当工具书」,不给「值得通读」。它的价值不在观点,在归位——它把一年里散落的事件按五个盘子摆好了,这件事本身有工作量,也确实省了别人不少时间。但它也暴露了「年度报告」这个体裁的通病:为了全面,牺牲了准确;为了体例完整,牺牲了判断。
如果要给编者一条建议,我只给一条:与其 15 篇各 24 屏,不如 5 篇各 70 屏。每篇给一组原始数据、一个可复现的评测、一条可以被否证的判断。年度报告的价值从来不在「全覆盖」,在「有据可查」。一本 364 屏的报告,如果读者合上之后只能记住「今年很热」,那它和一份新闻合集没有区别。
阅读记录
书名:人工智能安全发展报告(2024—2025)
主编:蒋艳|编写:国家工业信息安全发展研究中心
本次阅读:微信读书逐页截图 364 屏,版权页至「全书完」全覆盖,15 篇报告、2 个附录、英文摘要全部读完,抓取标记为全书读完(end=last_page),耗时 997 秒
篇幅分配(按章节起始页相减,篇名页计 2 屏):全球篇 22 屏(6.0%)/ 技术篇 59 屏(16.2%)/ 安全篇 38 屏(10.4%)/ 融合篇 75 屏(20.6%)/ 专题篇 130 屏(35.7%)/ 附录 9 屏(2.5%)/ 英文摘要 19 屏(5.2%)
15 篇报告的屏数:B.1 20 / B.2 27 / B.3 30 / B.4 21 / B.5 15 / B.6 17 / B.7 22 / B.8 18 / B.9 16 / B.10 22 / B.11 21 / B.12 28 / B.13 18 / B.14 12 / B.15 27
说明:本文引句均来自本次截图,可逐字核对;「12 种风险 / 200 多项措施 / 7 种降险方法」「四级风险」「12 种风险」「151 项典型案例」「Blackwell B200 较 H100 提升 5 倍」等均为书中原文;p70 被会员卡提示遮挡,相关部分未读到;微信读书推荐值 74.2%,20 人点评
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: