
Claude Code橙皮书:51万行源码里最值钱的是取舍,不是功能
微信读书《Claude Code 橙皮书:从入门到精通(微信读书特别版)》· 附录 A「51 万行代码告诉我们的事」,6 屏(p0072–p0077),本次逐页翻阅,全书 77 屏至此读完。
说明:这是这本书的附录专篇,与正文的「终篇」(第 9 章末至第 10 章)分开写,因为这一段谈的不是怎么用,是这套东西为什么长成这样。引句页码为本次截图编号,与纸书页码无关;文中标"我的判断"处是评论,凡是加引号的话都能在对应截图里逐字核对。
这本书最值钱的六页,在最后面,而且是个附录。
正文十章教你怎么把话说清楚、怎么把项目切开、怎么搭 Skill 接 MCP。附录 A 不教这些,它讲的是源码泄露之后,作者从客户端代码里读出来的东西。标题很唬人——「51 万行代码告诉我们的事」。读到这我第一反应是警惕:这种标题最容易变成"我有一个朋友在 Anthropic"式的转述。但读完这六屏,我得承认它撑住了:它给的不是结论,是取舍,而取舍是唯一没法靠看教程获得的东西。
先说这六屏里我最认同的一句话,它在 p0073 中间:「为什么选 Bun 不选 Node.js?一个字:快。」
一、先把"泄露了什么"说清楚
p0073 开头,作者做了一件很克制的事:先划边界。"需要澄清的是,这次泄露不涉及模型权重、训练数据或任何用户信息。泄露的纯粹是客户端工具代码,也就是你电脑上跑的那个 CLI 程序。"
这一句看着像免责声明,其实是全篇的方法论前提。它决定了这六屏能推出什么、不能推出什么。能推出的是工程选型、上下文策略、权限模型、产品野心;不能推出的是模型能力、训练方法、成本结构。而市面上关于"泄露"的讨论,九成栽在第二条上——拿着客户端代码去猜模型有多强,那是拿菜谱猜厨子的手艺。
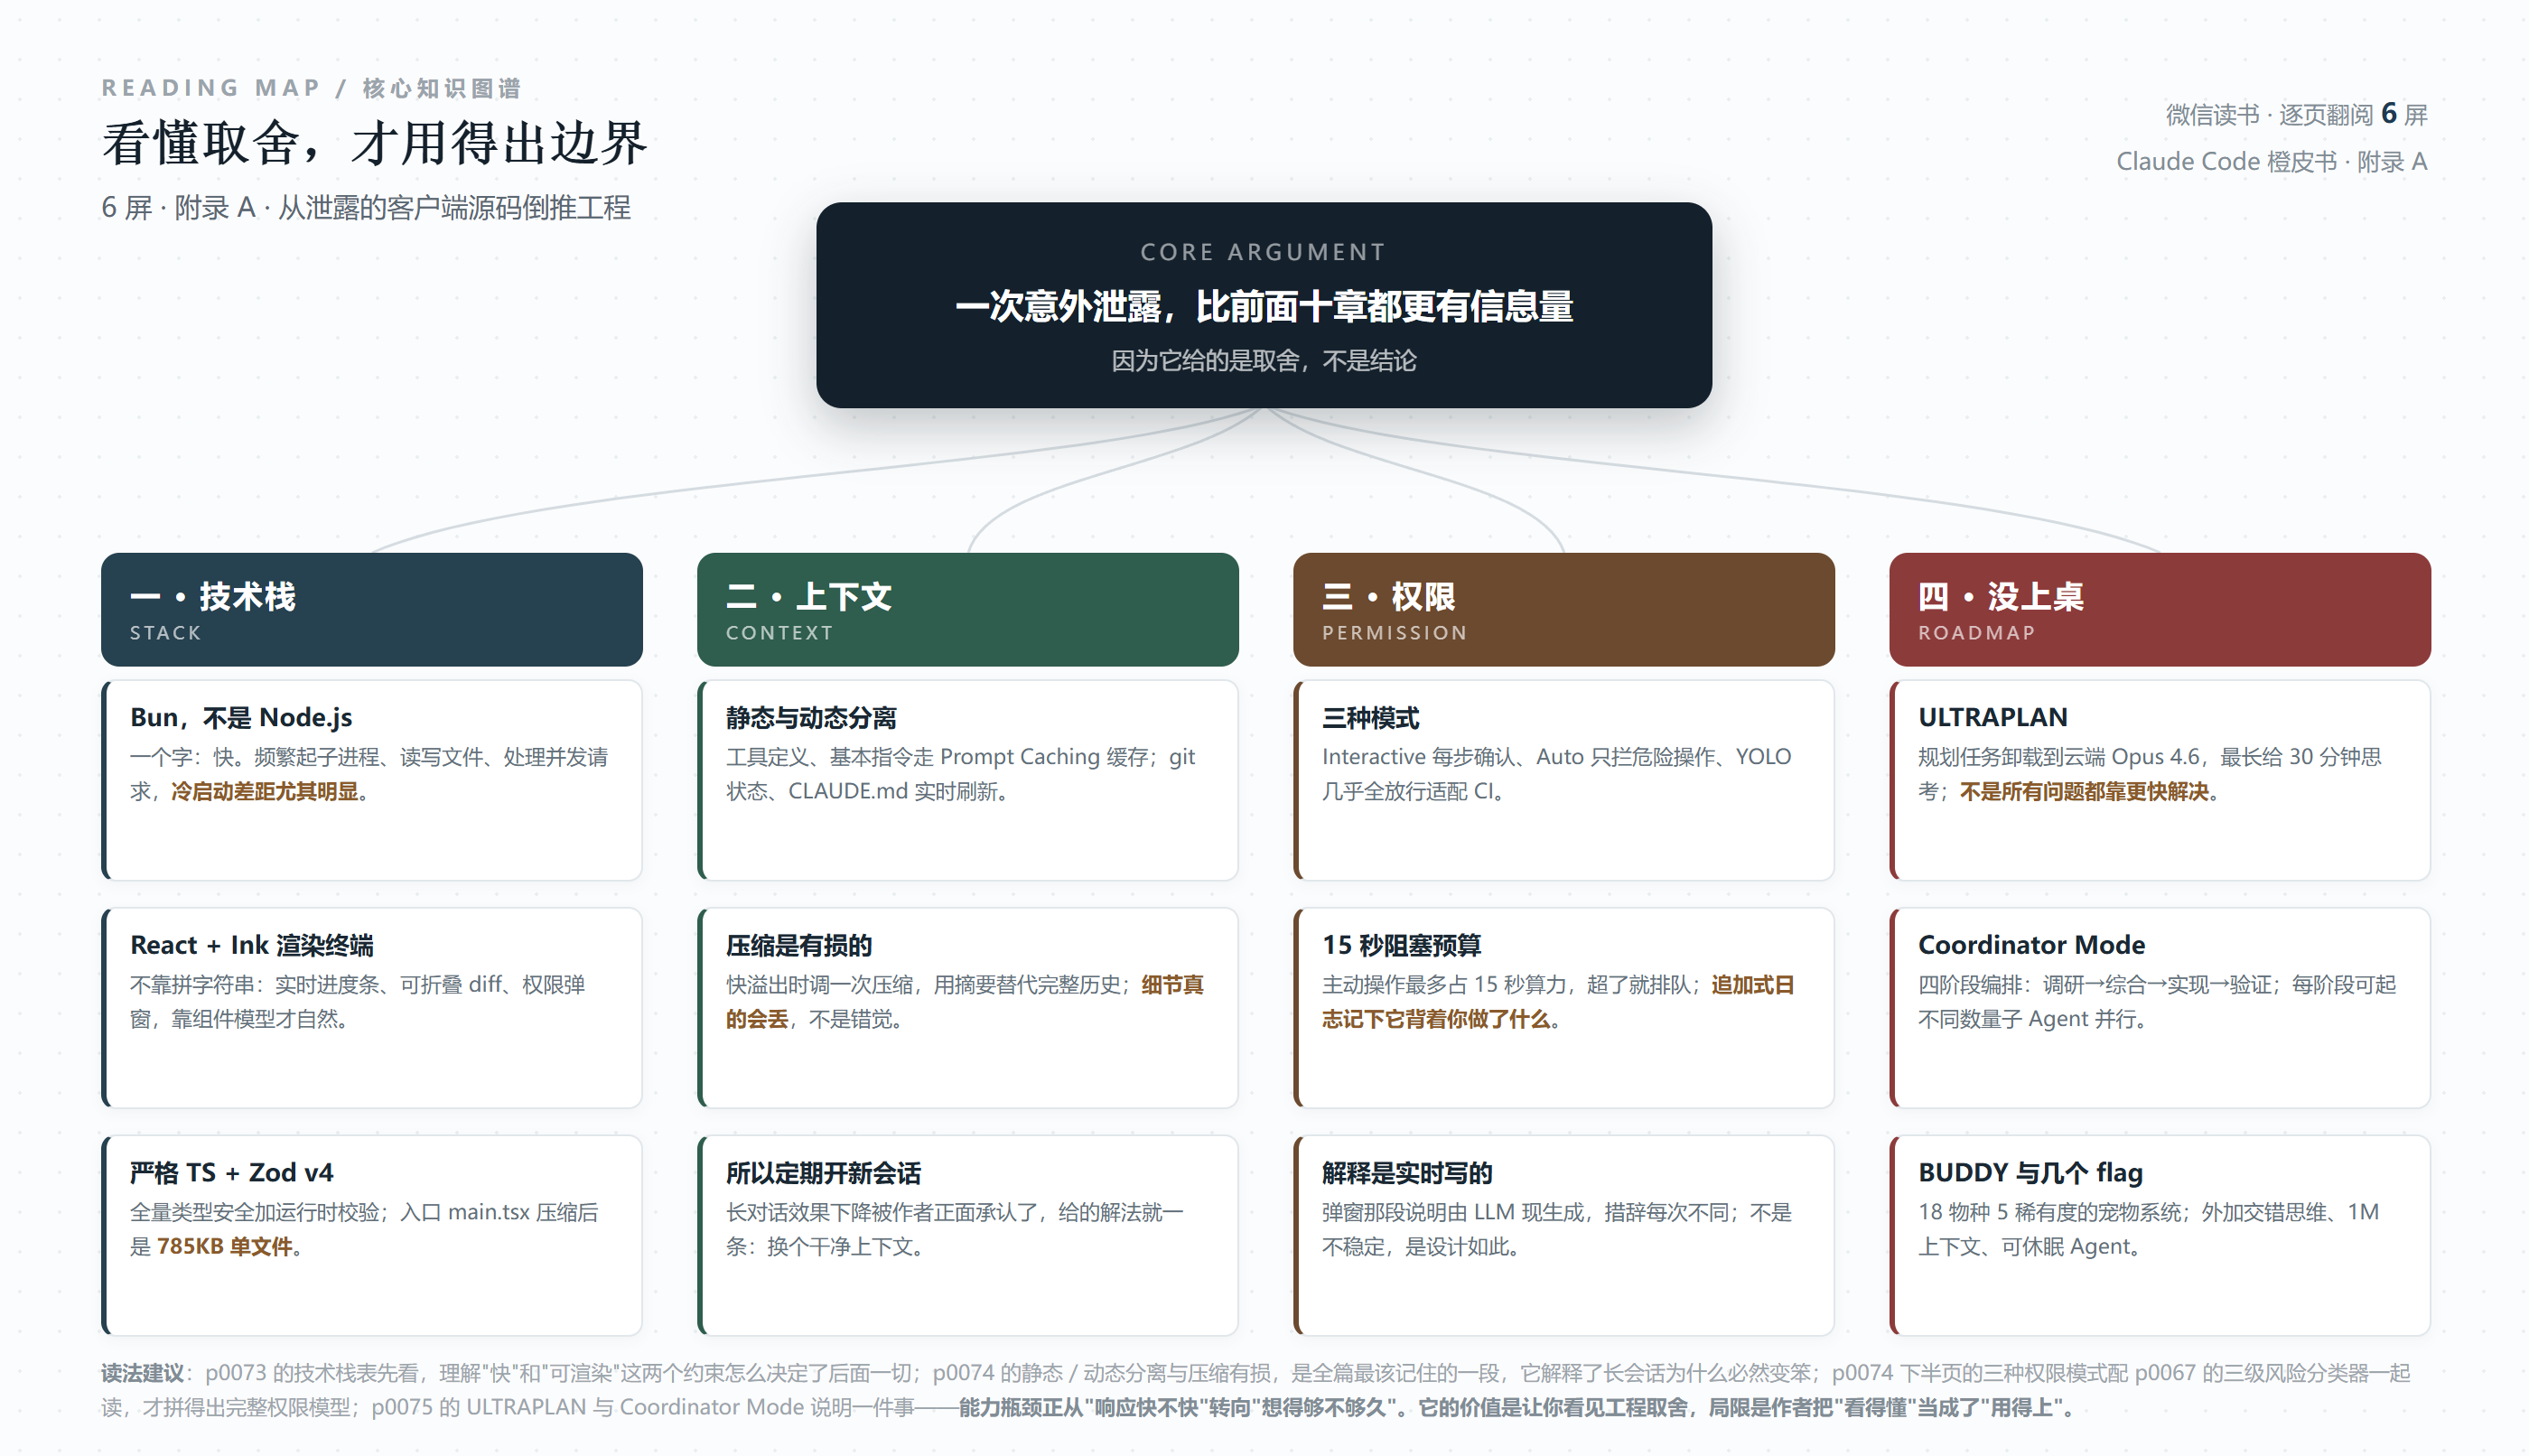
紧接着是一张技术栈表,五行,四行有解释,一行只有数字:运行时 Bun(不是 Node.js)、UI 框架 React + Ink(终端里跑 React)、语言 严格模式 TypeScript(全面的类型安全)、Schema 验证 Zod v4(运行时类型检查)、入口文件 main.tsx(编译后 785KB 单文件)。
我的判断是:这张表真正的信息量不在"用了什么",在"为什么肯付这个代价"。一个命令行工具,把 React 塞进终端,编译出 785KB 的单文件入口,这在传统 CLI 的世界里是离谱的——你会想,一个打字工具为什么要这么大。但书里给了答案,而且答案很干净。
二、Bun、React、Zod:三个选择,同一个动机
关于 Bun,作者的原话是:Claude Code 需要频繁启动子进程、读写文件、处理大量并发请求,Bun 在这些场景下性能比 Node.js 好不少,冷启动速度尤其明显。"对于一个命令行工具来说,每次敲回车到看到响应之间那几百毫秒延迟,直接影响使用体验。"
关于 React + Ink,作者先反问:为什么不直接用 console.log 拼字符串?然后给理由:因为 Claude Code 的终端 UI 其实很复杂,有实时更新的进度条、可折叠的代码 diff、权限确认弹窗——这些"在传统终端工具里很难做到的东西,用 React 的组件模型就自然了"。
这两条放在一起看,才看出这本书附录 A 真正的价值。它们不是三个独立的技术偏好,是同一种取舍的三次重复:为了交互体验,愿意付出体积和复杂度的代价。Bun 是为了那几百毫秒,React 是为了那些能折叠、能实时、能弹窗的东西,Zod 是为了让"运行时才发现的数据形状不对"提前变成类型错误。三者都在回答同一个问题:怎么让一个终端工具,摸起来像一个应用。
这里我要补一句作者没说的:这个取舍之所以成立,是因为它服务的用户是要在里面待几个小时的。如果你只是偶尔敲一条命令,785KB 的启动体积和 React 的抽象成本都是纯负担;但如果你一天八小时在这个界面里和模型来回,那几百毫秒乘上几百次,就变成了值得为之重构的理由。所以"Claude Code 用 React 渲染终端"这件事,别人抄不走——不是技术难,是前提不一样。抄的人往往没有"用户会长时间待在里面"这个前提,抄过去就只剩成本。 785KB 这个数字也值得单独算一笔账。它比一个前端页面小得多,比一个普通 CLI 大得多——正好落在一个很微妙的位置:大到必须解释,小到可以接受。我的理解是,这个体积说明团队做过减法:只打进必要的东西,没有把整个生态拖进去。命令行工具的用户对启动时间极其敏感,一次卡顿就会被记住;而 785KB 在本地磁盘上读进内存是毫秒级的,比一次模型请求的延迟低了三个数量级。换句话说,它把"给用户看的东西"做得尽可能重,把"启动要付的代价"压到可以忽略——这是一次很明确的主次排序,不是随手的选择。
三、上下文管理:静态缓存、动态刷新、有损压缩
p0074 是全篇技术密度最高的一页,讲上下文管理,拆成两件事。
第一件是分层。系统提示词被做成模块化结构:有些部分是静态的、可以被缓存(比如工具定义、基本指令),有些部分是动态刷新的(比如当前 git 状态、CLAUDE.md 的内容)。"静态部分利用 Anthropic 的 Prompt Caching 节省 token,动态部分确保信息实时准确。"
这句话解释了一个我原来没想通的现象:为什么 CLAUDE.md 改了之后,下一个 session 立刻生效,但你不会因此付更多钱。因为它是被放在"动态部分"的——不进缓存,每次重读,但也不占缓存的便宜。而几十个工具的定义是死的,进缓存,只付一次。这是把"不变的"和"变的"分开计价的典型做法,工程上叫冷热分离,用在 prompt 上就是省钱。
第二件是压缩,作者写得比前面都坦白:
当对话太长、上下文快要溢出时,Claude Code 会自动调用一次「压缩」:让模型总结之前的对话内容,用更短的文本替代完整历史。这是个有损操作。所以长对话效果下降不是你的错觉,是因为压缩过程中一些细节确实会丢失。知道这一点,你就理解了为什么定期开新会话是个好习惯。
我认为这整篇附录里,这一段是最该被单独拎出来传播的。因为它正面回答了一个被无数人用玄学解释的问题:为什么 AI 聊久了会变笨。答案很朴素——不是你运气不好,不是模型降智,是它的历史被摘要过了,而摘要有损。你三小时前随口提的那条约束,很可能在第三次压缩时被当成"细节"删掉了。
这也顺带解释了另一件事:为什么 CLAUDE.md 那么重要。因为它是"动态刷新"的那一部分,不进摘要、不被压缩,每一轮都原样在。凡是不能被丢的信息,都得写进那里,而不是指望它记住。书里正文说"把信息沉淀到 Context 层",附录 A 给出了机制上的理由——这两处隔了十几页,但其实是同一句话的两种说法。作者没把它们连起来,这是编辑的失职。
四、权限不是一个开关,是一套解释系统
p0074 下半页给出权限的三种模式:Interactive,每个操作都弹窗确认,适合初学者和敏感项目;Auto,安全操作自动执行、危险操作要确认,适合日常开发;YOLO,几乎所有操作自动执行,适合受信任的环境和 CI。
这三档本身不新鲜,任何工具都能做。真正让我停下来的是 p0067(正文里那页)补的两个细节,它把"权限"从一个开关变成了一套系统:一是风险分级器(LOW/MEDIUM/HIGH),读文件是 LOW 直接放行,写配置文件是 MEDIUM 或 HIGH 要确认,.gitconfig、.bashrc、.zshrc 被硬编码为受保护,还有针对 unicode 字符与大小写混淆的路径穿越防御;二是那段解释文字——"不是预设的模板,是实时生成的。系统会单独调用一次 LLM 来生成这段说明。所以每次的措辞都略有不同,这不是不稳定,是设计如此。"
我的判断:这是全书的隐藏高点,也是最容易被读者略过的一页。因为它回答了一个比"安全"更难的问题:怎么让人愿意把权限交出去。答案不是"我们很安全",而是"每次向你要权限,我都写一段针对当前处境、你能读懂的说明"。这不是安全机制,是信任机制——安全靠拦,信任靠解释。而"多调一次 LLM 只为了写一句提示"这个成本,被明确接受了,这是只有成熟产品才会做的取舍。
顺着这个逻辑,p0075 的两个细节就更好理解了:一个是 15 秒的「阻塞预算」,每次主动操作最多占用 15 秒计算资源,超过就自动排队;另一个是追加式日志,"记录它在你不看的时候都做了什么"。作者还补了一句展望:"如果上线,AI 助手就从'你找它'变成'它主动帮你'。"
我得在这里泼一盆冷水。"它主动帮你"是所有 AI 产品最危险的宣传语,而 15 秒预算和追加式日志恰恰证明了 Anthropic 自己也知道这一点。为什么要有预算?因为主动行为必须被限速,否则它会在你不知情的时候把算力、把注意力、把改动都吃掉。为什么要有追加式日志?因为主动行为必须可审计,否则你无法在事后追责。这两个设计不是"更贴心"的功能,是"主动"这件事的必要护栏。作者把它们写成了亮点,我读出来的是克制——而克制才是这套系统里最难抄的部分。 "追加式"这三个字尤其值得停一下。它不是"记录日志",是"只追加、不修改"。这个区别在工程上很重:可修改的日志可以被后续操作覆盖,你看到的是"最后状态";只追加的日志保留全部中间态,你能还原"它到底在第几步做了什么"。这是审计和回顾的分界线——前者要你信,后者让你查。一个愿意让用户回放的自动化系统,和只给结论的自动化系统,是完全两种信任结构。书里只用半句话带过,我认为它低估了自己手里这个东西的分量。 再往深一层,YOLO 那一档的真正风险不在"它会不会删错文件",在"你已经不在回路里了"。一旦进到这个模式,你放弃的不是某一次确认,是发现问题的时间窗口:错误可能已经写进仓库、推上去、被同事拉下来。所以书里把它限定在"受信任的环境和 CI"是对的,但读者容易把它理解成"熟了就开"——正确的判据不是"我熟不熟",是"出错后我能不能用一条命令回退"。有版本控制兜底的环境,YOLO 是效率;没有兜底的环境,YOLO 是把判断权彻底交出去。这个前提书里没写,但它是这一档能不能用的分水岭。
五、没上桌的东西,比上桌的更能说明方向
p0075 后半页是全篇最像"内部消息"的部分,列了四样还在代码里、没正式端出来的东西。我按它给的信息记:
ULTRAPLAN,把复杂规划任务卸载到云端。"本地 Claude Code 有响应时间限制,但有些任务真的需要深度思考。ULTRAPLAN 允许你把规划任务发到云端的 Opus 4.6,给它最长 30 分钟的思考时间。去喝杯咖啡回来看结果就行。"作者的评价我很喜欢:Anthropic 很清楚一件事——不是所有问题都能靠更快的响应来解决,有些问题就是需要慢慢想。
Coordinator Mode,四阶段的多 Agent 编排器:Research(调研)→ Synthesis(综合)→ Implementation(实现)→ Verification(验证),每个阶段可以启动不同数量的子 Agent 并行。"这比现在的 Agent Teams 更结构化,更像一个真正的项目经理在调配团队。"
BUDDY,一个 Tamagotchi 风格的 AI 宠物系统,18 个物种、5 个稀有度、确定性的 gacha 抽卡。"代码写得还挺认真的,不像是一个随手加的实验。"作者猜它是愚人节彩蛋(泄露时间恰好是 3 月 31 日),也可能是团队在认真想"怎么让命令行工具不那么冰冷"。
还有几个 flag:交错思维模式(让模型在生成过程中穿插推理步骤)、1M 上下文窗口支持(当前默认 200K)、可休眠 Agent(暂停和恢复长时间运行的任务)。
这四样东西放在一起,我读出的是一个很清晰的转向:瓶颈正在从"响应快不快"移到"想得够不够久"。ULTRAPLAN 拿 30 分钟去换一次规划质量,Coordinator 用四个阶段去换一次执行的可靠性,可休眠 Agent 承认了"有些任务就是长",1M 上下文承认了"有些上下文就是塞不进 200K"。这四条全都在同一个方向上:牺牲即时性,换深度。而 BUDDY 在这堆里显得突兀,但它其实也在回答同一个问题的另一面——当工具要陪你待几个小时,它就得有点人味。
六、作者给开发者的那段话,我基本同意
p0076 有一段是专门写给开发者的:"Claude Code 的架构值得认真看。这可能是目前能看到的最成熟的 AI Agent 系统实现。TAOR 循环的设计、工具系统的抽象方式、上下文管理的分层策略、权限模型的风险分级,每一个都是可以借鉴的工程模式。你不需要从零开始设计自己的 Agent 系统,这 51 万行代码已经趟过了大量的坑。"
同页还有一段写给普通用户的,落在具体的机制上:TAOR 循环解释了为什么 Claude 有时候要多试几步才能完成任务,这不是「犯错」,是「迭代」;Context Compaction 的有损性解释了长对话为什么下降;权限三层模型让你不必在"全手动"和"全自动"之间二选一。
我同意这段的九成,但要留一成的反对意见:它把"读过代码"当成了"获得能力"。"这 51 万行代码已经趟过了大量的坑"——坑是趟过了,但趟坑的过程不在代码里,代码里只有趟完之后的形状。你能看到它把工具抽象成四个原语,看不到它为什么最初不是四个;你能看到权限分三级,看不到它在哪一级上出过事故。工程经验最难传递的部分,恰恰是被代码格式抹掉的那部分。所以这段话对开发者是有效的启发,不是可替代的经验。
顺带说一句硬伤:TAOR 循环在这一篇里被提到两次,但整篇没有一处解释它是哪四个字母、怎么运转的。正文里也许讲过,附录 A 却当读者都记得。可附录本来就是给跳读的人看的——我翻到这一页时,第一反应是"TAOR 是什么",只能往前找。这不是小毛病,是一本以"手册"自我定位的书,在结构上的失守。
七、它的短板
这一篇只有六屏,问题却很集中。
第一,全篇没有一处可核对的一手证据。所有结论都以"代码里能看到""翻看代码首先注意到"开头,但没有一个文件名、没有一个函数名、没有一段引用代码。"51 万行代码"这个数字在标题里,正文里再没出现过一次——没有模块行数分布,没有依赖清单,没有 commit 数量。这就像一篇财报分析只写"营收不错",不给数字。对一篇以"源码告诉我们的"为卖点的附录,这是根本性的失守:它让你相信作者读过,却没法让你验证他读到的是不是真的。
第二,它在最关键的地方停在了"可能是"。BUDDY 那一段,作者自己说"这可能是 Anthropic 的愚人节彩蛋……但也可能是团队在认真思考一个问题"。两个"可能",读者什么也没得到。同样的问题出现在 ULTRAPLAN("如果上线")、Coordinator Mode("这比现在的 Agent Teams 更结构化")、可休眠 Agent("暗示着演进方向")。整篇的时间态是分裂的:讲技术栈用完成时,讲功能用猜测时。一个读者读完,分不清哪些是已经在跑的东西,哪些是埋在代码里没启用的开关。而这两者对使用者的意义完全不同——前者你现在就能用,后者你只能等。
第三,它最该展开的机制,被一句话带过了。压缩(Compaction)是全篇唯一直接影响日常使用的机制——它解释了长对话为什么变笨。但书里只给了三句话:会自动压缩、压缩是有损的、所以定期开新会话。至于什么时候触发、压缩时保留什么丢什么、能不能手动控制、有没有办法避免关键约束被压掉,一个字没有。这是全书最典型的失衡:把"我知道内部机制"写成了"我懂这个机制",而读者要的是后者。我作为使用者最想要的一条答案是——把不可丢的约束写进 CLAUDE.md,让它待在动态刷新区里免于压缩——书里没说,但它其实是前面所有机制的必然推论。
第四,有一处夸大了因果。作者说"这次泄露虽然是意外,但它客观上做了一件好事:让更多人理解了 AI Agent 系统到底是怎么工作的"。这话听着温暖,逻辑上站不住:让更多人理解的,是作者的这篇解读,不是泄露本身。泄露出去的是 51 万行没有注释的代码,绝大多数人读到的是二手结论。把"我写了篇好解读"归功于"泄露是好事",是一种很常见的自我抬举。同页作者自己也写了相反的一面——"AI 工具已经不只是技术产品了,它正在进入需要讨论伦理边界的阶段。就像社交媒体当年经历的那样:先是'这个东西好方便',然后是'等等,它在收集我什么数据?'"——这句才是这六屏里最有分量的话,可惜它被放在"我的判断"框里,一笔带过,没有展开成任何一节。
八、这六屏该怎么用
如果你只是日常用 Claude Code:只读 p0074 那半页,记住两件事。一是长会话会因压缩而失真,重要的约束写进 CLAUDE.md,别指望它记住;二是权限有三档,日常开发用 Auto,碰生产环境和 CI 才用 YOLO。这两条能省你不少"它怎么又忘了"的火气。
如果你在搭自己的 Agent:把 p0074–p0075 当设计清单看,四件事值得抄——上下文冷热分离(不变的进缓存、变的每轮刷新)、压缩必须被当成有损操作来设计(所以要有"免压缩区")、权限要分级并且每次解释、主动行为必须配预算和审计日志。这四条都不是技术难点,是产品判断,而产品判断最难自己想到。
如果你只是好奇那 51 万行:这六屏不够。它给的是形状,不是内容。真想吃透,去看原文泄露仓库和社区的拆解,把这篇当导读用。
谁不必读:想靠这篇学会用 Claude Code 的人。附录 A 一行操作都没有,它讲的全是"为什么这样设计",而你还没到需要问为什么的阶段。
但我仍然觉得这六屏是全书最值得读的部分,理由和正文那篇不同:正文教你动作,动作三个月就旧;附录给你取舍,取舍能活很久。一个工具的能力上限,往往不写在它的功能列表里,写在它愿意为什么付出代价里。这本书的正文一直在讲"它能做什么",只有这六屏讲了"它为了做到这些,放弃了什么"。后者才是判断一个工具能不能长期用的依据。
一句话:这六屏是全书唯一敢谈代价的部分——Bun 换来冷启动、React 换来可交互、压缩换来长上下文、预算换来主动——但它谈代价时只肯谈到"设计如此",不肯谈到"所以你该防着什么";一篇好的技术附录应该停在后者。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: