
Claude Code橙皮书:把时间花在搭舞台上,别花在打磨话术
微信读书《Claude Code 橙皮书:从入门到精通(微信读书特别版)》· 本次逐页翻阅 15 屏,覆盖第 9 章末至第 10 章末(p0057–p0071),全书共 77 屏、12 章,本次读完全书,最后一屏出现"全书完"与评分卡。
说明:这是这本书的终篇,前面 56 屏(安装、第一个项目、核心工作流、对话技巧、扩展能力)已单独写过一篇,本篇不重复。另有一篇专讲《附录 A:51 万行代码告诉我们的事》。引句页码为本次截图编号,与纸书页码无关;文中标"我的判断"处是评论,已与原文分开,凡是加引号的话都能在对应截图里逐字核对。
一本书读到最后一页,才看得出来它到底想教你什么。
这本书前面三分之二,一直在教你"怎么点"。安装、第一个项目、把需求喂进去、让它改 UI、装 Skill、接 MCP、部署。读起来很顺,但也很像说明书——那种你照着敲一遍就忘的顺。到了第 9 章末尾和第 10 章,它突然不教动作了,开始讲顺序:先做什么、后做什么、什么活该交给机器、什么活必须攥在自己手里。这十几屏,是全书唯一没法被一篇博客替代的部分。
但这十几屏也暴露了作者最大的软肋:他给了一个极好的框架,却没有一次真实的失败来支撑它。下面我按自己的阅读顺序讲,讲它不仅说了什么,也讲它没说的地方。
一、第 9 章最后四屏:它把"做完"拆成了能验收的动作
第 9 章叫「从零构建一个完整产品」,前面用大段篇幅演示一个周报工具:从 GitHub 拉 commit、AI 总结、生成可分享页面。到了 p0057,画风变了。作者贴出一份 CLAUDE.md 的完整内容,然后写了一句后来被反复强调的话:
有了这份 CLAUDE.md,后续每次新 session 或新的对话,Claude 都知道这个项目的技术决策和代码规范。不需要你每次都重新说明。
这份文件写了什么?项目概述(AI 驱动的周报生成器,连 GitHub、总结 commit、生成可分享页面)、技术栈(Next.js 15 App Router + TypeScript、Tailwind CSS、NextAuth.js 做 GitHub OAuth、Claude API 走 Anthropic SDK)、代码风格(默认 server components,只在需要时用 'use client';API 路由放 app/api/,用 Route Handlers;优先具名导出;API 路由里永远包 try-catch)、测试(提交前跑 npm run lint,建 UI 之前先用 curl 测接口)。
我的判断是:这一页比前面所有"提示词技巧"加起来都值钱,但它的价值不在内容,在它示范的那种写法。大多数人写 CLAUDE.md,写的是"请用中文回答""请写详细注释"这类口号;作者写的是可以被机器当约束执行的条目——"只在需要时用 use client""API 路由永远包 try-catch"。前者是许愿,后者是规格。区别在于:许愿可以被忽略,规格被违反时会露出来。
接下来 p0058 是全章最实在的一页。他把"让它做"拆成三个必须逐一验证的动作:先让它跑 npm run dev,看登录按钮能不能跳到 GitHub 授权页,报错就把错误信息粘回给它;再用 curl localhost:3000/api/github 看返回的 commit 数据对不对;最后拿真实 commit 数据调总结接口,检查它有没有幻觉。然后他写了一段自述,我在书里做过标记:
每做完一步就验证,这是我踩过最多坑之后总结出来的最重要的习惯。不要让 Claude 一口气写完所有代码再测。问题越早发现越容易修。我曾经让它连续写了 8 个文件,最后发现第 2 个文件的 API 路由就写错了,后面全废了。
这段自述之所以重要,不是因为"要验证"这个结论——谁都知道要验证——而是因为他给出了代价的具体形状:第 2 个文件错,后面 6 个全废。这是级联失败,不是单点失败。参数错可以改参数,架构层的路由约定错了,后面每一个文件都在错的约定上生长。所以验证的频率不该按"文件数"来定,该按"约定确立的节点"来定:路由约定、数据形状约定、鉴权约定,这三处一立住就必须立刻验一次,其余的可以批量。
p0059、p0060 是收尾动作:把整套流程封成一个 Skill(.claude/skills/generate-report/SKILL.md,五行步骤:起服务、拉 commit、调总结、开页面、给分享链接),配好后在任何 session 里敲 /weekly-report 就能十秒出周报;再接 MCP 打通 Slack,最后部署到 Vercel,顺手加一个 GitHub Action 让它自动 review PR。到 p0060 结尾,作者摆了一张回顾表,把整个过程归到四个 Phase,每个 Phase 标出对应章节。
这张表看着是目录索引,其实是这本书的骨架:Phase 0 用 Claude 采访自己、生成 SPEC.md;Phase 1 初始化 + 写 CLAUDE.md;Phase 2 Plan 模式讨论、Auto 模式实现;Phase 3 截图反馈、迭代 UI。四个阶段里,Claude 只在 Phase 2、3 是主力,Phase 0 是它当 interviewer,Phase 1 是它当记录员。这个分工是这本书真正想说的东西,可惜它只在表格里露了一次。
二、一个下午做完一个产品,赢的不是速度
p0061 是全书写得最狠的一页。作者先把新手的典型动作摊开:兴奋地把整个产品需求一股脑甩过去——"帮我做一个完整的 XX 应用,需要登录、数据库、付费、推送、分享……",然后写:
Claude 确实会开始做,但最终产出往往是一团乱。
接着他给了一张对照表,同一件事三种给法。合格给法:"先实现 GitHub OAuth 登录。登录成功后在页面上显示用户名和头像。"验证通过后再加:"现在添加获取 commit 的 API,获取登录用户最近 7 天在所有 repo 的 commit,返回 JSON。"错误给法就是把六件事一次说完。
这张表我想多说两句,因为它藏着一个很多人没意识到的机制。一次给六件事,坏处不是它做不完,是它做完了你无法判断哪一件坏了。产出是一团,你面对的是一个黑箱:是登录有问题,还是数据拉错了,还是总结在编?你只能整体重来。一次给一件,你得到的是六个可以独立打勾的格子,坏掉的那个会自己举手。这不是"让 AI 更好用"的技巧,是把软件工程里"可观测性"的思路搬到了对话里。
p0061 下半页,作者拿自己的产品举例:做小猫补光灯时,第一个版本只有一个功能——打开 App,屏幕变白,亮度拉满。他拿它自拍了一张,确认补光效果还行,才开始加色温调节、亮度滑块、定时拍照。这段话没有一句是技术,但它比整章的命令都有用:先让一件事成立,再让第二件事成立。
p0062 讲 session 的分法:Session 2 核心后端逻辑、Session 3 前端页面和交互、Session 4 测试和 bug 修复、Session 5 部署和 CI/CD。每个 session 专注一类事,session 之间靠 CLAUDE.md 和代码本身传递上下文。"这比在一个超长 session 里硬撑要高效得多。"
然后是全书标题级的判断,他把它编成"五、产品感知才是你最大的杠杆",并且自己标注"这条是最重要的":
Claude Code 能帮你写代码、调 UI、配部署、修 bug,但它帮不了你决定:这个产品到底应该解决什么问题?目标用户是谁?什么功能该做什么功能该砍?……AI 能让你的执行速度提升 10 倍,但方向错了,你只是以 10 倍速度走向错误。
我同意这句话,但我想把它说得更准一点。"十倍速度走向错误"这个说法其实偏温和了。方向错了的时候,损失不是线性放大的。因为你跑得快,你会更快地把错误固化进架构、更早地把用户拉进来、更快地把预算烧完;等你发现的时候,返工的成本里还要加上"已经上线的兼容包袱"。所以真实情况是:AI 放大的不只是速度,是错误被固化的速度。这解释了为什么这本书里做得最好的例子(补光灯)恰好功能最少——功能少,纠错成本就低,十倍速度才是纯收益。
三、五条坑那张表,比前面十章都值钱
p0063 是一张表,标题我没看到(跨页了),内容是五条"常见坑 + 对策"。这是我在整本书里唯一想抄进自己项目文档的一页:
需求膨胀——做着做着不断加功能,永远做不完;对策是回 SPEC.md,不在规格内的功能记进 todo,不在当前 session 做。上下文污染——session 越来越长,Claude 开始忘记之前的代码结构;对策是及时开新 session,让 CLAUDE.md 和代码库承载上下文。不验证就继续——让 Claude 连续写了 10 个文件,最后发现第 2 个就有 bug;对策是每完成一个模块必须验证,宁愿慢一点。环境变量混乱——本地能跑,部署后各种 undefined;对策是在 CLAUDE.md 里列出所有环境变量,部署前用 checklist 确认。过度依赖 AI 判断——Claude 说"这个方案最好"就采纳;对策是 AI 给方案、你做决策,特别是架构选型永远自己拍板。
这五条的价值在于它们都是"行为"层面的,不是"知识"层面的。你知道 RAG 怎么切片,不代表你不会在第 10 个文件上翻车;但你知道"上下文污染"这件事存在,你至少会在 session 变长时警觉一下。而且这五条里有一条格外刺眼:第 2 条和第 3 条是同一个病。上下文一长,模型就开始忘结构;忘了结构,它就会用错的约定继续写;你一心软让它写完,级联失败就发生了。所以真正的根因只有一个——别让一个 session 承担两件事。这一条作者写出来了,但他没把它们并成一条讲,读者容易当成五个独立的小毛病。
四、三层投入:全书唯一能带走的框架
第 10 章(p0064 起)是全书的收束。真正撑住这一章的是 p0065 的一张表和一个比喻。表是这样的:Prompt 层,每次对话都要重新投入,一次性回报;Context 层,写一次 CLAUDE.md 持续生效,复利回报;Harness 层,搭一次自动化流程永久运行,指数回报。比喻是:
Prompt 是你开口说话,Context 是你提前准备好的 PPT,Harness 是你搭建的整个舞台。观众(Claude)的表现,取决于这三层的综合质量。
然后是那句被作者自己当成全书总结的话:如果你读完这本手册只记住一件事,就记住——把时间花在构建 Context 和 Harness 上,而不是优化 Prompt。
我的判断:这是这本书唯一真正属于它自己的东西。市面上讲 Claude Code 的文章,九成停在 Prompt 层——教你写"你是资深工程师"、教你加"让我们一步步思考"。这些话不是没用,是回报一次性:换个项目、换个 session,你得重讲一遍。而 Context(CLAUDE.md、代码约定、目录结构)和 Harness(Skill、Hook、MCP、Agent Teams)是会留下来的东西——留下来的部分才产生复利。
但这个框架有一个作者没说清的前提:"复利"和"指数"都要以"你知道自己在做什么"为利率。一份写错约定的 CLAUDE.md,不是复利,是负复利——它会稳定地把每个 session 都带偏;一个搭错触发条件的 Hook,不是自动化,是自动化的错误。所以三层投入的正确顺序其实是:先用 Prompt 探路,把需求摸清楚;再把摸清的部分沉淀进 Context;最后才把重复的部分固化成 Harness。作者把顺序说成了"别优化 Prompt",我理解他的意思,但这句话对新手是有害的——新手连"这个功能到底要什么"都还没想清楚,就去搭 Harness,搭出来的是空转的流水线。
p0065 结尾页还有一个细节值得夸:作者提到循环需要停止条件。"如果你的需求描述模糊,它不知道什么时候算做完了,就会不停地循环下去,改来改去。告诉它'测试通过就停'或'生成文件就行',它收敛的速度会快很多。"这句话在 p0066 开头,是全章最实用的一句。它是"人机协作"里最容易被忽略的一侧:你得给它一个停机判据。没有判据的循环不是勤奋,是发散。
五、从"怎么写"到"写什么":这笔账他只算了一半
p0068 有一张"能力重要性迁移"的清单,前半被页面切掉了,我看到的部分是:重要性下降的一侧列出"手动调试技巧""代码模板积累";重要性上升的一侧列出"需求拆解能力""架构判断力""输出质量评审""产品品味"。
作者紧接着补了一句很关键的限定:他说的是"重要性下降",不是"没用"。"理解代码仍然有价值,它能帮你更好地描述需求、更准确地评审输出。但你不再需要能从零手写一个完整应用,你需要的是能判断一个应用写得好不好。"
然后是这段话的核心:从「怎么写」到「写什么」。以前你可能花 80% 时间在"怎么实现这个功能",20% 在"应该做什么功能";现在比例倒过来了。"Claude Code 解决了'怎么写'的问题,但'写什么'这个问题,它帮不了你太多。"
我的判断:这个 80/20 的翻转是对的,但他漏了第三项,而第三项才是最花时间的——"验收"。书上把能力迁移写成"拆解、判断、评审、品味"四件事,其中"评审"被当成一个轻动作。实际做过就知道,评审 AI 写的代码比你自己写累得多:你要读懂一段你没写过的实现,判断它是否符合你脑子里的约定,还要找出它"看起来对但其实错"的地方。前者是阅读成本,后者是怀疑成本,两个都比写代码贵。所以真实的时间分配更像:20% 写需求、30% 陪它实现、50% 验收与返工。这本书从头到尾没承认过这 50%。
至于那句给焦虑者的建议——"学会定义需求、设计交互、评审质量,这些能力不会因为 AI 变强而贬值"——我认为方向对,但"不贬值"三个字太乐观了。贬值的是执行,升值的是判断,而判断的供给量是有限的:一个团队里能拍板"这个功能该砍"的人,永远是少数。所以 AI 不会让所有人平等受益,它会让"有品味的人"和"没品味的人"之间的差距,从 1 倍拉到 10 倍。这句话作者没写,但它才是这本书真正的冷峻之处。
六、权限分级与自动记忆:书里最像工程的两页
p0066、p0067 插了一段"内部机制",是全书写得最像工程师的部分。三个点值得记:
第一,它解释了自己为什么长这样。"你在终端里看到的 Claude Code 界面,其实是 React 组件渲染的。Claude Code 运行在 Bun 上(不是 Node.js),用 React 的 Ink 框架渲染终端 UI,全部用严格模式 TypeScript 编写,Schema 验证用 Zod,入口文件压缩后 785KB。"然后作者给了因果:"权限确认弹窗、多行代码高亮、进度指示器,这些在传统终端工具里很难做到的东西,用 React 的组件模型就自然了。你感受到的'流畅'不是错觉,是工程选型的结果。"
第二,权限不是 Yes/No。Auto 模式背后有一个分类器,把每个操作的风险分成 LOW、MEDIUM、HIGH:读文件通常 LOW,直接放行;写配置文件是 MEDIUM 或 HIGH,需要确认。有些文件被硬编码为受保护状态——.gitconfig、.bashrc、.zshrc;还有路径穿越防御,防止恶意代码用 unicode 字符或大小写混淆绕过检查。最妙的一句在这:
每次弹出权限确认时,你看到的那段解释文字不是预设的模板,是实时生成的。系统会单独调用一次 LLM 来生成这段说明。所以每次的措辞都略有不同,这不是不稳定,是设计如此。
这一句是整本书里我最想鼓掌的地方。它回答了一个几乎所有 AI 工具都没回答的问题:怎么让人愿意把权限交出去。答案不是"我们很安全",是"每一次要求授权,我都给你一段用你当前处境写出来的、能被读懂的理由"。这不是安全机制,是信任机制——安全靠拦,信任靠解释。而解释的成本(多调一次模型)被明确接受了,这是一个成熟产品才会做的取舍。
第三,自动记忆维护。后台有个子代理,分四步整理记忆文件:审阅现有内容、提取新的有用信息、整合重复条目、修剪过长的部分,目标是把记忆保持在合理大小内,大约 200 行。
"这就是为什么长期用 Claude Code 之后,你会觉得它越来越懂你。不完全是模型变聪明了,而是你的偏好、习惯、项目上下文,都被这个记忆系统慢慢积累和维护着。"这段话解释了 CLAUDE.md 为什么要写、为什么不能写太长——200 行不是建议,是系统在帮你修剪的上限。你写三千行,它也会剪回两百行,剪掉哪两百行不由你决定。这个隐含风险,作者没提。
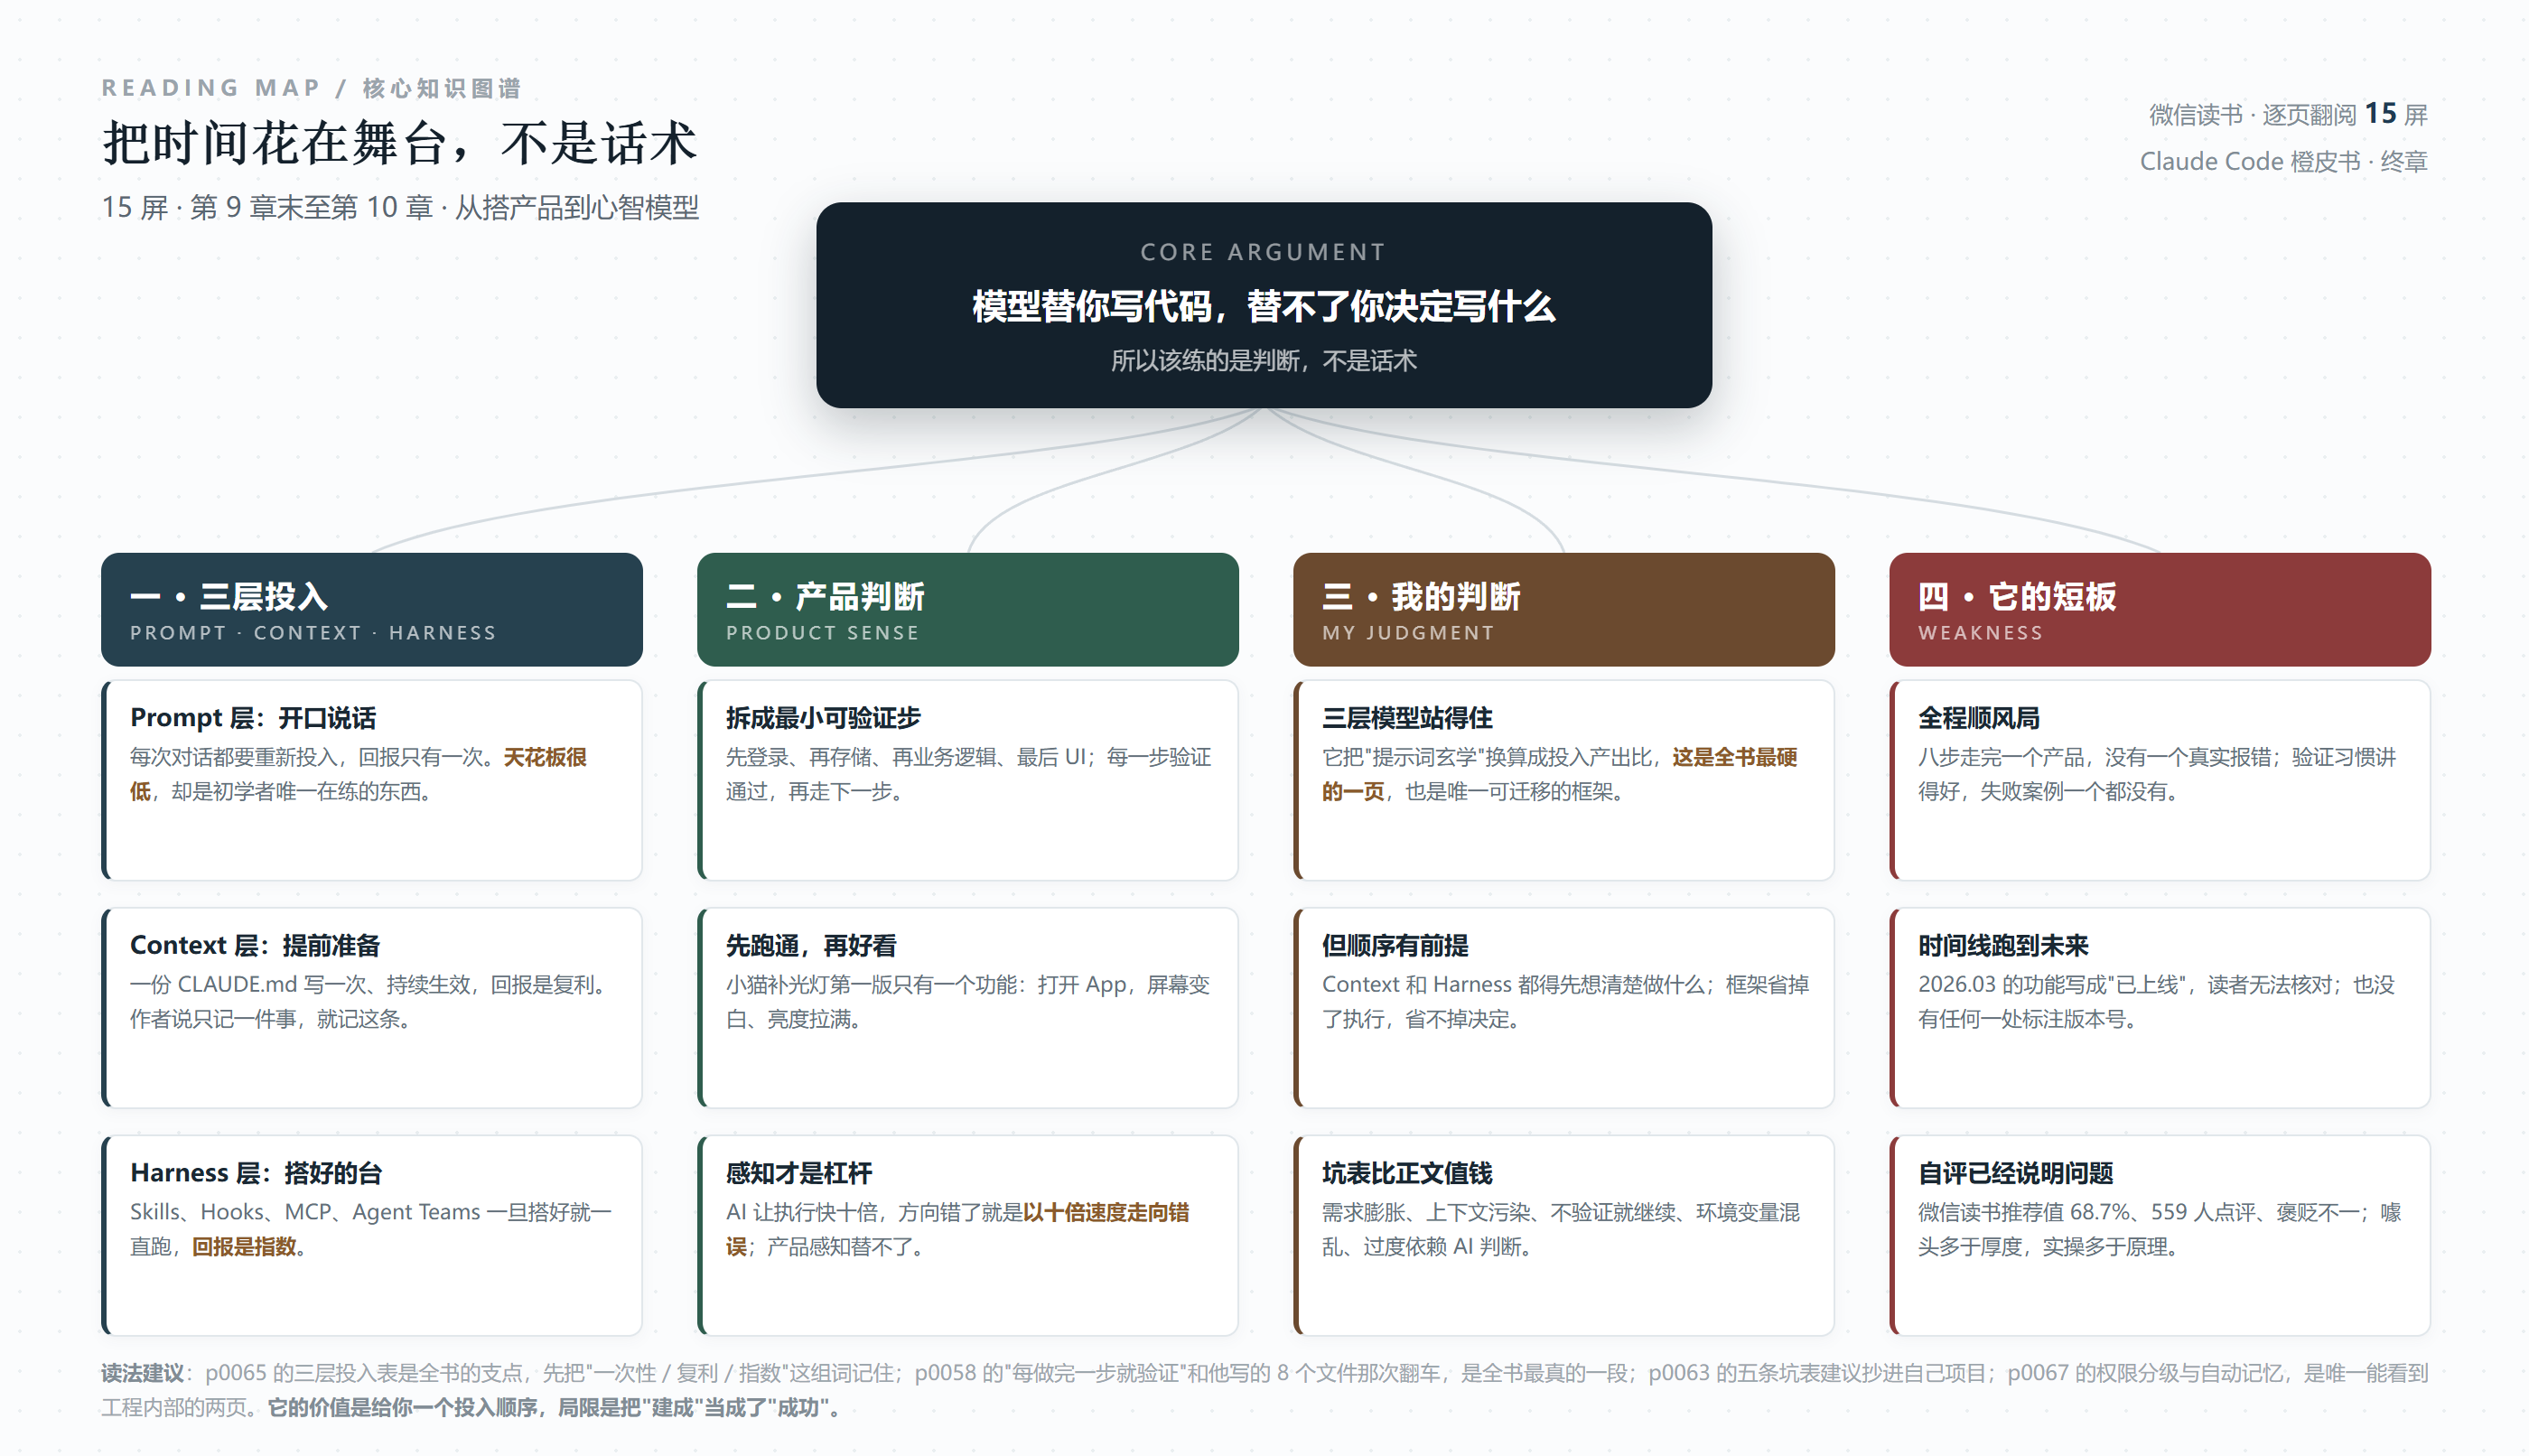
如果只让我留四页:p0065(三层投入表,全书唯一可迁移的框架)、p0058(三步验证与他那次 8 个文件的翻车)、p0063(五条坑表,直接抄进项目文档)、p0067(权限分级与实时解释,理解什么叫"可被信任的工具")。其余部分快翻即可,命令和步骤三个月就会过时。
七、它的短板
这本书的问题不在写得浅,在它只写了顺风局。
第一,全程零失败。从装环境到一个完整产品上线,八步走完,没有一个真实的报错。唯一被承认的失败,是 p0058 那句"曾经让它连续写了 8 个文件,最后发现第 2 个就错了"——而这句话被放在一个引用框里,用来论证"要验证",不是用来展示"会失败"。真正的问题比如:OAuth 回调地址在本地和线上不一致怎么办?Vercel 的环境变量和 NextAuth 的 secret 怎么配?部署后 session 丢失怎么查?这些是每个实操者必然撞上的墙,书里一堵都没有。它把"我认为该验证"讲成了"验证了就没事"。
第二,时间线跑到了读者前面,而且不做标注。p0069 那条时间线里,出现了"2026.03 / Computer Use 上线,Claude 获得操作屏幕的能力;Voice Mode 让你对着终端说话""2026.03 / 源码意外公开,社区首次窥见 Agent 系统的完整架构",还有"Agent Teams 正式推出"。一本书把未来三个月的事写成已经发生,却不给任何版本号、日期出处或"据官方公告"的限定,读者没法核对,也没法判断哪些是事实、哪些是作者的预期。紧接着作者自己承认:"平均每 2 个月一个大功能。这意味着你手上这本手册的某些具体操作步骤,可能在 3 个月后就需要更新了。"——他知道这书会过期,却仍然用"是这样"的语气写"将会这样"的事。这是内容产品最常见的毛病:把不确定写成陈述,把预测写成历史。
第三,也是最要命的:它的结构是"教程",野心却是"方法论"。前九章教你点按钮,第十章突然要给你一套心智模型,中间没有过渡。三层投入表出来的时候,读者手上还没有任何 Harness 可搭——Skills 讲了两页、Hooks 只提了名字、Agent Teams 只有一段。一个刚学会 npm run dev 的人,被告知"别优化 Prompt,去搭舞台",他搭什么?框架的层次是对的,但它给出框架的时机太早,落地路径太薄。
第四,还有一个硬伤是它自己没法回避的:微信读书上这本书的推荐值是 68.7%,559 人点评,标签是"褒贬不一"。这是我在最后一屏看到的数据,也是我对这本书的整体判断的一个旁证——它不是坏书,但它是一本"看起来比实际厚"的书:装帧、开本、橙皮色的封面、"51 万行代码"这样的标题,都在暗示它比实际内容更硬。真正的干货密度大约是全书的三分之一,集中在第 9 章末到第 10 章这十几屏。
八、谁该读,怎么读
如果你还没装过 Claude Code:读第 2 章到第 4 章,照着做一遍,把第一个项目跑通就停。后面先别读,读了也用不上。
如果你已经在用,但总觉得它"不够听话":直接跳到 p0057–p0067。先照 p0057 那样写一份能被当约束执行的 CLAUDE.md,再照 p0058 把验证拆成三个可打勾的动作,然后把 p0063 的五条坑抄进你的项目文档。这三件事做完,你的体验会有明显变化,而且不需要学任何新命令。
如果你在带团队:p0067 那两页(权限分级 + 实时解释 + 记忆修剪)值得拿去当内部方案讨论的参照。它示范了一个 AI 工具如何把"授权"这件事做成可解释的流程,而不只是一个开关。
谁不必读:想找一本能当参考手册长期放在桌上的人。它的命令细节三个月就旧了,作者自己都这么说。
但它仍然值得花两个下午。理由不是它讲得多深,是它把"人该干什么"这件事,放回了正确的位置。整本书最好的那句话不在三层模型里,在最后一段:他做了一年多,十几个产品,"每一个产品最终的质量,都不是由 AI 的能力上限决定的,而是由我对'什么是好的'的判断决定的。AI 可以在 30 秒内写出一个登录页面。但是否需要登录页面、登录后应该看到什么、什么样的体验才算流畅,这些只能由人来判断。"
一句话:它给了你一个正确的投入顺序(Context 与 Harness 优先),却没给你一次真实的失败;而这本书最该被记住的那句"AI 让你快十倍,方向错了就是十倍速度走向错误",恰恰是它自己没敢深写的地方——因为一旦深写,就得承认那十倍的代价,也是十倍。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: