
复合型AI Agent开发:能跑通的都写了,该想清楚的没写
微信读书《复合型 AI Agent 开发:从理论到实践》(陈祯民、李春燕 著,清华大学出版社 2026 年 1 月第 1 版,ISBN 9787302705611)· 逐页翻阅 558 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在第 8 章 8.7「本章小结」之后的"全书完")· 阅读器共记录 134 个章块,八章 · 抓取耗时 531.7 秒。
抽样说明:我按"代码密度"抽读——p0001 版权页、p0005 推荐序(张栩)、p0009 前言(离职那一段)、p0060 市场前景、p0080 DeepSeek 返回体、p0089 流式响应、p0146 本地向量化环境、p0160 块优化切割、p0171 Chroma 元数据过滤、p0190 RAGAS 字段表、p0243 MCP 手工服务端、p0331 LangGraph 记忆与 thread_id、p0396 ChatUI 的 useMessages、p0526 意图识别微调超参、p0545 安全边界、p0551 工具结果缓存、p0557 第 8 章小结。
章屏数按阅读器章标签逐页归属计算,含章标题页。所有引文与数字只来自上述页面;关于"它把能跑通写到可以照着敲、把该不该这么设计留成思考题"的判断,是我的核查意见,不是书里的原话。
先说结论:这本书把「怎么跑起来」写得很扎实,把「为什么这么设计」留给了你自己。它是一本合格的操作手册,但不是一本设计手册。这两件事的差别,看完第 8 章就明白了。
一、一本讲 Agent 的书,从一个人的辞职开始
p0004 开始的推荐序,是 TRAE IDE 技术专家张栩写的,落款「2025 年 11 月 29 日于深圳」。整段话里我认为最要紧的是这一句:
工程领域对技术的判断标准一直都很朴素:能不能减少重复劳动、能不能降低整体复杂度、能不能让系统行为更可控、更可靠。智能体技术正在这些核心指标上持续向前,让模型、工具与工作流共同构成一个能够围绕目标稳定运行的体系。(p0005)
「减少重复劳动、降低整体复杂度、让行为更可控更可靠」——这三个标准写给的是工程,不是论文。它就摆在这本书的门口,等于提前告诉读者:接下来 550 屏里,你该用「能不能上线」而不是「够不够先进」来打分。
按这个标准,这本书在「减少重复劳动」这一项拿了高分,在「降低整体复杂度」这一项拿了及格,在「让行为更可控更可靠」这一项……我在第 8 章找到了答案,但那个答案只有 4 屏。
真正让我意外的是前言。第 7 页到第 13 页这 7 屏,写的是作者自己辞职的过程:收到几家独角兽和「国内 TOP3 的大厂」的意向,面试官说「如果你选择我,第一个 OKR(Objectives and Key Results,目标与关键成果法)就是不要逼自己太紧」,然后:
然而,新的阶段并没有想象中顺利。项目节奏依旧紧张,适应新环境的过程也比预期艰难。短短一个月,我再次感受到身体和心理的极限:心率失常、睡眠失衡与持续焦虑。这些信号让我不得不重新思考:继续硬撑,还是为长期发展做一次主动调整?(p0009)
接着是一个月内离职,是重新联系那些给过意向的公司、坦白说明自己的情况,是那句「那一刻,我不是在求职,而是在与过去的自己和解」。
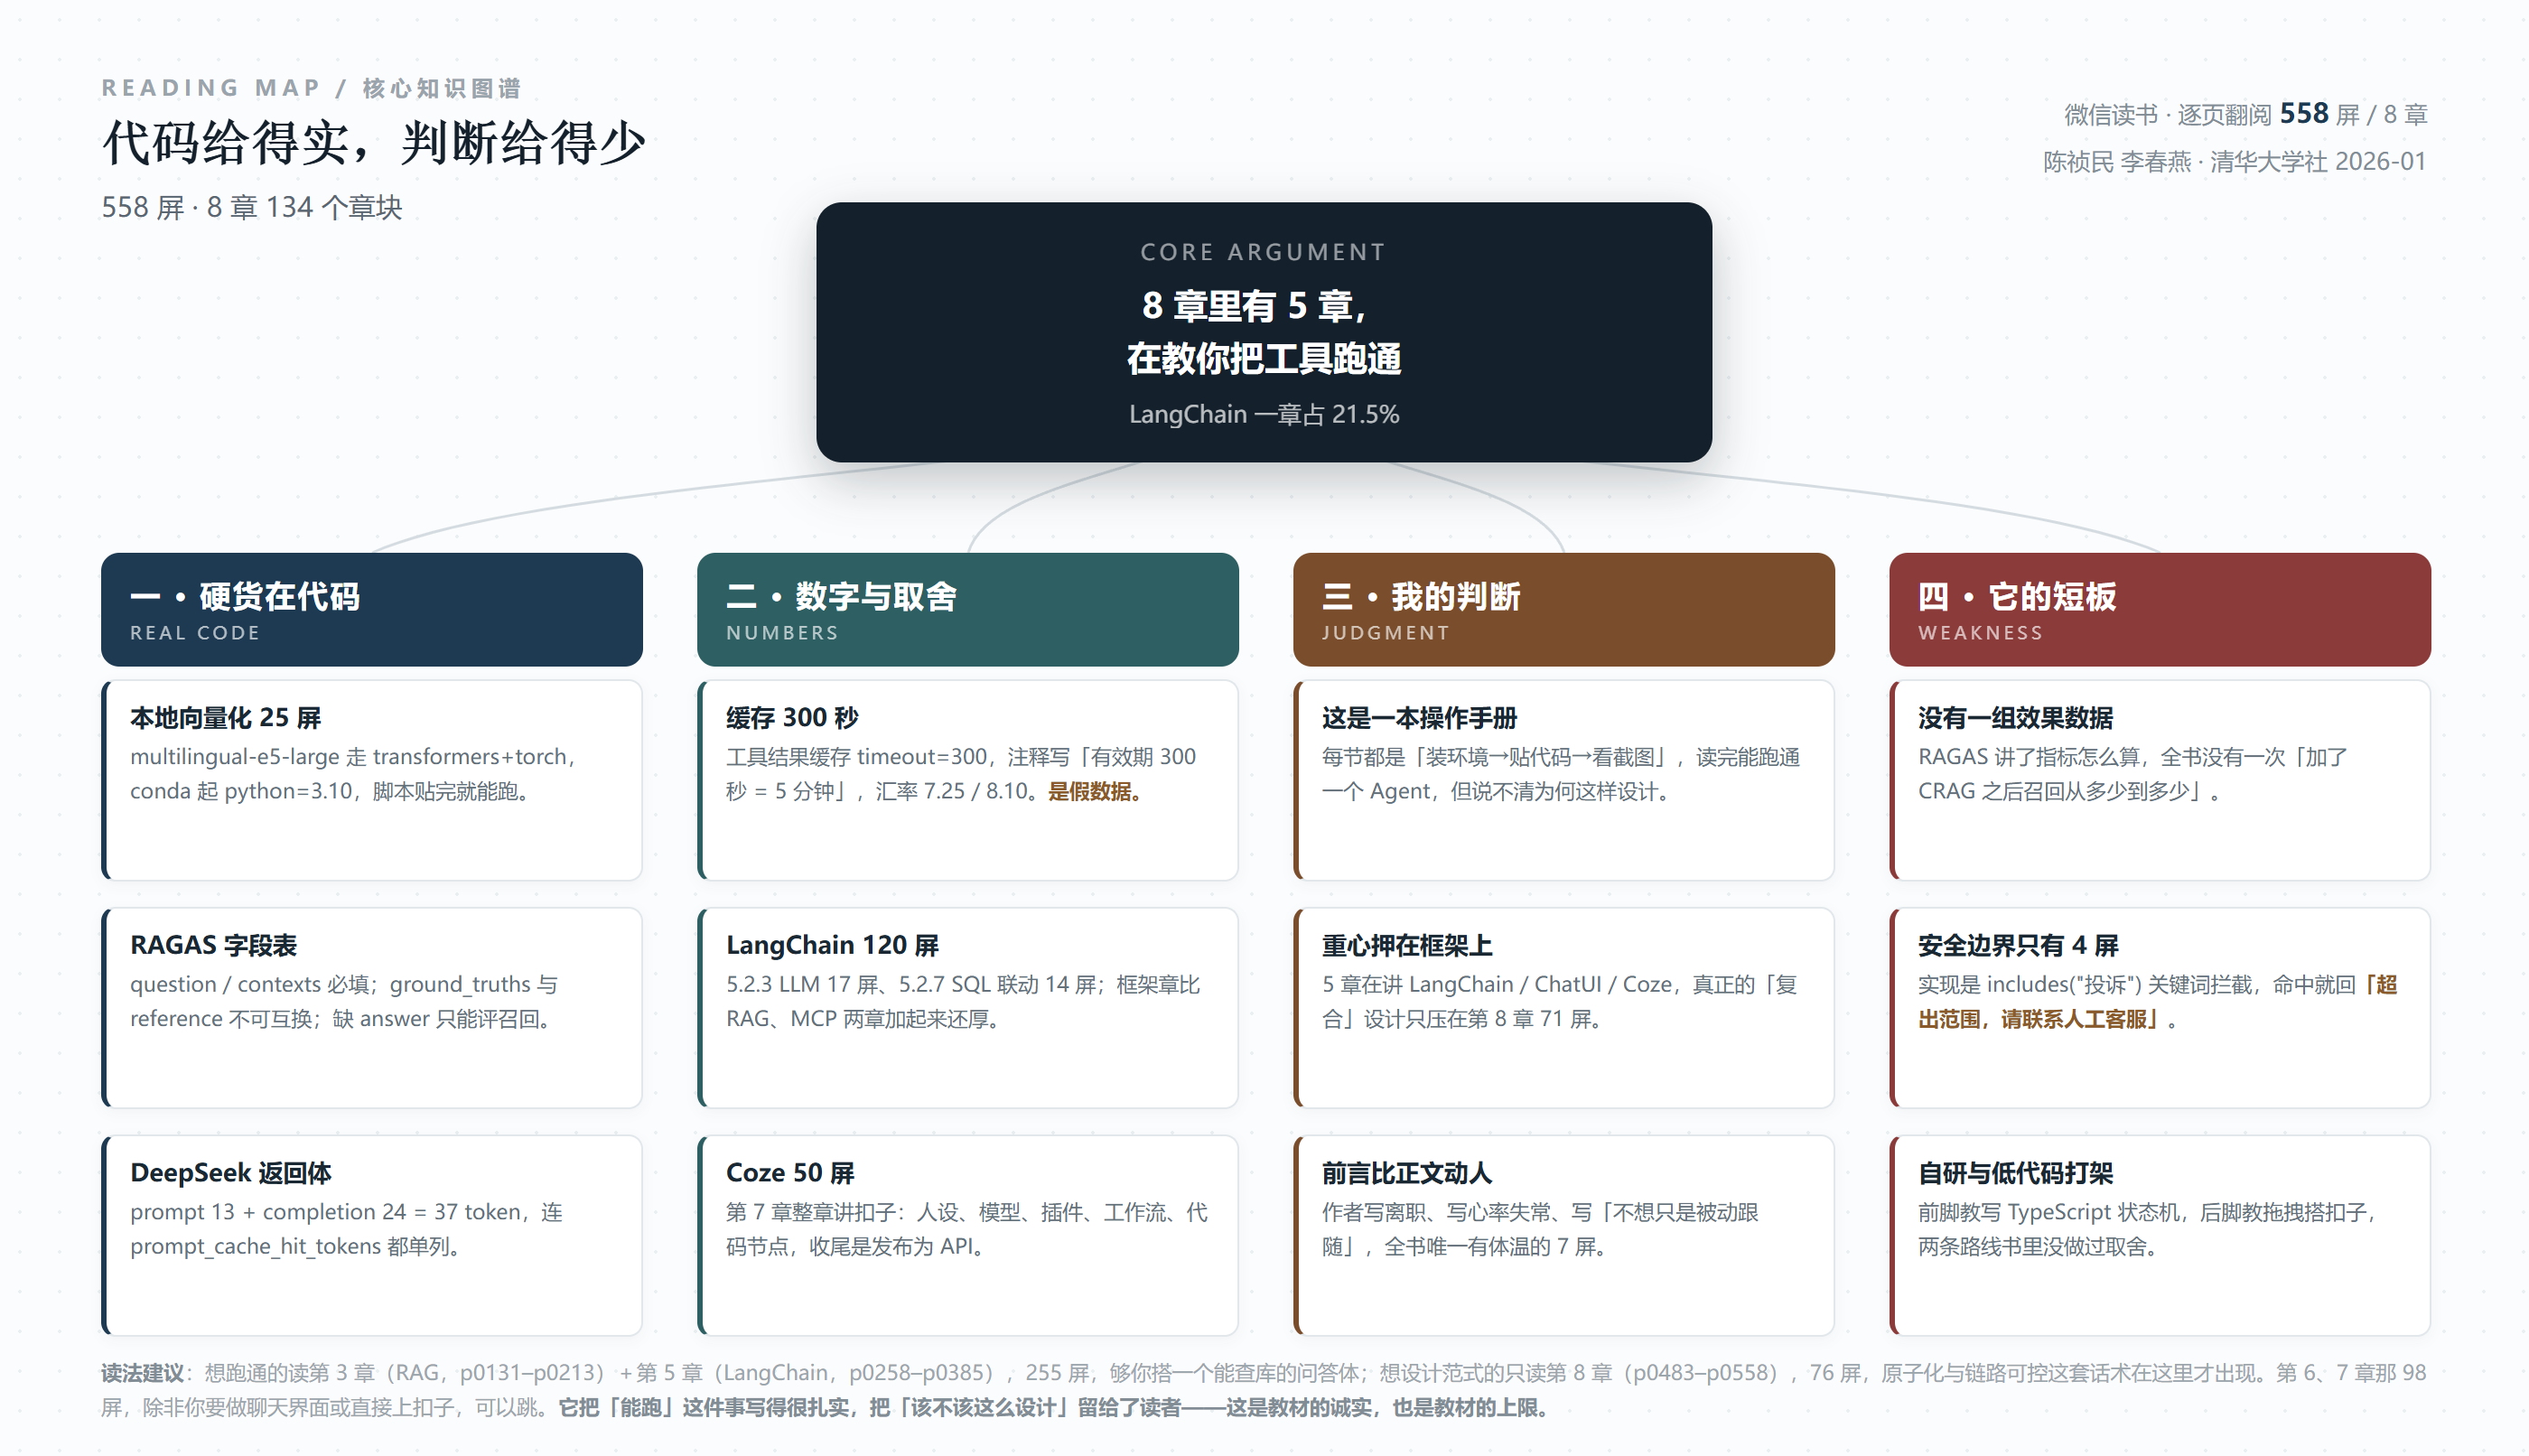
在一个讲 Agent 架构的技术书里放这么一段,是有风险的——显得矫情。但我觉得它反而是全书最重要的上下文:它解释了为什么这本书的重心在「能跑起来」。一个刚从高压里出来的人,写书时最想给读者的东西,往往不是「最优架构」,而是「一条能走通的路」。这也解释了为什么 LangChain 章能有 120 屏,为什么 ChatUI 能占一整章——那是他真正用来交付过东西的部分。
二、558 屏是怎么分的:五章在教工具,三章在讲设计
我把 134 个章块按章汇总了一遍,屏数分布是这样的:
第 1 章绪论 53 屏(9.5%);第 2 章 Agent 开发基础 64 屏(11.5%);第 3 章 RAG 83 屏(14.9%);第 4 章 MCP 44 屏(7.9%);第 5 章 LangChain 120 屏(21.5%);第 6 章 ChatUI 48 屏(8.6%);第 7 章 Coze 50 屏(9.0%);第 8 章 Agent 设计范式 71 屏(12.7%)。
这张分布表比目录更能说明问题。LangChain 一章占了全书五分之一还多,比 RAG 加 MCP 两章加起来(127 屏)只少 7 屏;而讲「Agent 该怎么设计」的第 8 章,71 屏,比框架章少了整整 49 屏。
更值得琢磨的是第 6 章。ChatUI——对话式交互组件库,48 屏,讲了对话容器、气泡、打字气泡、思考区域、输入态、消息状态、系统消息、主题定制,最后一节拿 8 屏做了个「具备图形界面的复合型 Agent」。一整章讲前端组件,厚度超过讲 MCP 协议的第 4 章。
这个比例透露了作者的身份:他首先是个做应用的人,其次才是讲协议的人。做应用的人会觉得「界面怎么渲染、消息状态怎么管」是天天要碰的真问题,而「协议的分层语义」可以压缩。这不是错,但读者得知道自己在买什么——如果你是想搞懂 Agent 之间怎么互通、工具怎么被安全调用的人,这本书给你的只有 44 屏。
三、它真给东西的地方:代码不糊弄,细节不上桌
这本书最让我服气的一点,是它几乎不写「伪代码」。举几个我核过的例子。
第一个是本地向量化,3.2.1 节整整 25 屏。从建环境开始:conda create -n vector_storage python=3.10,pip install transformers torch,然后直接落到 intfloat/multilingual-e5-large 这个具体模型,AutoTokenizer 和 AutoModel 各一行,示例文本是中文「这是一个测试文本。」加英文「This is a test text.」各一条——这个细节说明作者心里清楚这个模型的多语言场景,不是随手抄一段 Hello World。
第二个是流式请求,7 屏。他没有停在「把 stream 设成 True」,而是用 requests 手写了一遍 SSE 解析:payload 里 model 是 deepseek-chat、stream 是 True、max_tokens 设 60,靠检测 data: [DONE] 判断响应结束,system 是「You are a helpful assistant」,user 是「宋朝延续多少年,输出不超过50字」——这个提问本身就带着长度约束,明显是为了让流式输出在几屏里跑完,方便读者看效果。
图 2-9 贴的那段响应数据块更有意思:usage 里 prompt_tokens 17、completion_tokens 13、total_tokens 30,system_fingerprint 是 fp_8802369eaa_prod00623_fp8_kvcache。注意最后那几个字母:kvcache。这个指纹说明服务端这次走的是带 KV 缓存的分支,而书里前面 2.2.1 贴的另一个返回体,指纹是 fp_8802369eaa_prod0425fp8。两次调用、两个指纹,都原样留在书里,没被修图抹平——这种不修饰,反而让我相信后面那些数字都是真跑出来的。
第三个是 RAGAS 的字段表(p0190)。表里把五个字段的必填性列清楚:question 和 contexts 必填,ground_truths、reference、answer 都不必填。紧跟一段提醒,我认为是全书信息密度最高的几句话之一:
reference(通常指检索到的上下文 contexts)和 ground_truths(标准答案)在 RAGAS 评估中有着不同的用途,并非可以互换或「用途一致」,具体使用哪个取决于计划使用的评估指标。(p0190)
这句话值钱。市面上讲 RAG 评估的文章,十个有八个把这两个字段当同义词用,然后抱怨「评估结果对不上」。书里把它俩的差别点出来了,还补了一句「在涉及对 LLM 的评估时,answer 是评估生成结果的必要字段,否则只能评估 RAG 召回部分」——这是踩过坑才写得出的句子。
第四个是文本切割(p0160)。书里给了两套做法:整句切割和块优化切割,后者用一个 chunkOptimizedSplit(longText, 50, 10) 的调用说明——块大小 50,重叠 10。作者的取舍说得很清楚:
块优化切割虽然无法像整句切割那样严格保证语义边界完整,但能够显著提升分片长度的均匀性与可控性,便于批量并行向量化处理,且通过分片重叠有效降低上下文割裂带来的信息丢失问题。(p0160)
道理是对的,但这个 50/10 我要说句不好听的:50 个字一块,对中文来说大约是一到两个句子,切出来的向量语义太碎,检索时召回的往往是半句话。生产环境里常见的是 300 到 800 字、重叠 10% 到 20%。书里没提醒「这是教学示例、不是推荐值」,一个照着敲的读者很可能就把 50 带进项目里,然后在召回率上折腾很久也找不到原因。这类「参数没有量级提示」的问题,全书里不止这一处。
第五个是 Chroma 的元数据过滤(p0171)。这一段我觉得是全书被埋没的宝藏。它讲 where 和 where_document 两个过滤器,用 $eq、$ne、$gt、$gte、$lt、$and、$or、$in 这些运算符在相似度检索前先做一次条件筛,并举了两个场景:按业务标签、时间范围、来源类型过滤,以及——
在多租户场景下,仅对特定租户ID下的数据进行相似性匹配,避免跨租户泄露上下文。(p0171)
「避免跨租户泄露上下文」——这九个字,比第 8 章那 4 屏安全边界值钱得多。因为它给出的是一个真正能挡住事故的机制:隔离做在检索层,而不是做在提示词层。可惜它被放在「3.2.3 向量存储与相似匹配」下面,当成一个 API 用法写完就过去了,没有一句把它提升成原则。读者如果只记「Chroma 有 where 参数」,就浪费了这一段。
第六个是 MCP 服务端(p0243)。书里没有直接上官方 SDK,而是用 Node 的 http.createServer 起了一个 3001 端口的服务,手写 /server-info.json 路由,返回 {name: "mcp-streamable-server-demo", version: "1.0.0", capabilities: ["tools","resources","prompts"]}。
这个选择有它的道理:手写一遍,你才知道 MCP 的握手到底交换了什么。但从「能不能上线」的角度看,这段代码里没有会话管理、没有鉴权、没有并发保护——它是一个理解协议的教学样本,不是能拿去接生产的骨架。书里没说这个区别,而读者最容易犯的错,恰恰是把教学样本直接搬进项目。
这五六个例子放在一起看,能看出这本书的性格:它舍得给代码,舍得贴真实返回体,但很少告诉你「这段代码在什么量级上会失效」。细节全在,原则不在。而工程能力的分水岭,从来不在「会不会调」,在「知道什么时候不能这么调」。
四、「复合型」这个词,书里给得比标题少
书名里「复合型」三个字是最大的卖点,但我在全书里找它的正面定义,找到的位置很不均匀。
第 2 章 2.1 节给的是「Agent 三要素:LLM、Prompt、Action」,这是教科书式的拆法,没问题,但它是「一个 Agent 的构成」,不是「复合」。第 3 章末 3.5 节有一节叫「示例:从 RAG 到复合型 Agent」,9 屏——这是全书唯一一次正面演示「复合」,把检索和工具调用串起来。9 屏。
然后第 4 章讲 MCP(协议),第 5 章讲 LangChain(框架),第 6 章讲 ChatUI(界面),第 7 章讲 Coze(低代码平台)。这些章各自都成立,但它们更像是「复合」这个词的四个可选零件,而不是四条拼装路径。真正把这些零件按设计意图重新组织起来的,只有第 8 章。
这就是我读这本书最核心的一个不适感:它把「复合型」当作一个既定名词在用,却很少解释「什么该复合、什么必须分开」这个设计决策。而后者恰恰是从「会调 API」到「能设计系统」的那道坎。
举个具体的例子。第 5 章 5.2.7 节「SQL 联动」14 屏,教的是如何让 LLM 生成 SQL 去查库。但全书没有一屏讨论「什么时候该让模型生成 SQL,什么时候该写死几个参数化查询更安全」。前者灵活、后者可控——这正是「复合」最典型的取舍点,而书里把这个取舍跳过去了,直接给了能跑的实现。
再比如第 5 章 5.3.2「记忆」9 屏给了 LangGraph 的 MemorySaver 和 thread_id:builder.compile({checkpointer: memory}),然后每次 graph.invoke 带上 {configurable: {thread_id}} 就实现了「同一个线程记得上文」。代码是干净的,三行就记住了。但记忆的难点从来不在「怎么存」,在「存什么、留多久、什么时候该忘」——这三件事书里全没讲。一个把对话全量存进 MemorySaver 的 Agent,跑一百轮之后上下文窗口就爆了,而书里没有预警。
五、第 8 章才是这本书的真身
如果只读一章,读第 8 章。它 71 屏,是全书唯一把「设计」当主题而不是当结论的地方。
这一章的骨架是六层:框架设计(ReAct、Supervisor、Hierarchical)、通信设计(SSE 与 WebSocket)、状态设计(状态管理、上下文跟踪)、渲染设计(组件原子的 Function Calling、渲染管道隔离)、工作流优化(意图识别、Human in the Loop、自回归机制、记忆机制、安全边界)、成本优化(Prompt token、上下文与工具缓存、合理使用不同模型)。
「渲染设计」这一节是我在别的 Agent 书里没见过的东西。8.4.1 讲「把 UI 组件当成 Function Calling 的原子」——模型不返回一段 HTML,而是返回「该渲染哪个组件、参数是什么」,前端按组件表去填。8.4.2 接着讲「渲染管道隔离」,把模型输出和渲染逻辑隔开。这两节加起来 5 屏,但它解决的是一个很实际的问题:让模型直接产出界面代码,等于把 XSS 和布局崩坏一起交给了它;让模型只产出组件名和参数,才是可控的。
8.5.1「意图识别」11 屏,也是我没想到会这么厚的。它没有停在「用 Prompt 分类意图」,而是往下走到了微调:LoRA、QLoRA(4bit/8bit 量化)、全参微调三种路线各自适用什么场景,然后贴了阿里云 PAI 平台的超参配置截图(图 8-12):训练方式 sft、learning_rate 5e-5、num_train_epochs 1、per_device_train_batch_size 1、seq_length 128、lora_dim 32。
这组参数一看就是跑过的——seq_length 128、lora_dim 32、epoch 1,是「意图分类这种短文本任务」的典型省算力配置,不是论文里的默认值。同节还有一句我觉得说得很准:全参微调「能达到最佳效果,但训练开销大,对算力和数据量要求较高,通常用于关键业务场景或对精度要求极高的任务」。
8.6.2 的成本优化,给了一段 Python 缓存实现(p0551):字典当缓存,key 是 rate:{currency},命中条件是 now - cache[key]["time"] < 300,注释写「有效期 300 秒 = 5 分钟」,示例数据是 {"USD": 7.25, "EUR": 8.10}。
这段代码本身很简单,甚至有点土。但它的价值在于「把成本当成一个可以被工程手段削减的量」这个视角。工具结果缓存 300 秒、上下文缓存、按任务难度换模型——三件小事加起来,能砍掉的 token 可能比换一个更便宜的模型还多。这种「不体面但有效」的建议,比讲一堆推理优化理论实在。
六、安全边界那 4 屏,把全书的软肋露出来了
8.5.5「安全边界」,4 屏。我原以为这里会有提示注入防护、工具白名单、权限分级——毕竟前面 25 屏讲向量化、17 屏讲 LLM 接口,投入是够的。结果那 4 屏给的实现是这样的(p0545):
if (userInput.includes("投诉") || userInput.includes("退货")) {
return `根据您的需求,处理内容:${userInput}`;
} else {
return "您的问题超出当前智能客服范围,请联系人工客服。";
}(p0545)
一个 if-else,两个关键词,白名单。命中就处理,没命中就转人工。
我不否认这个例子在「智能客服」这个特定场景里能用——业务范围窄、意图有限,关键词白名单确实是最省事的边界。但作者紧接着写的那段话,把标准抬高了:
安全边界的存在并不是为了限制模型能力,而是让模型在明确的轨道内运行,避免「越轨」带来的不确定性。它不仅是复合型 Agent 能在指定地区或特定业务场景安全运营的关键一环,还能有效防止用户通过特定 Prompt 或输入尝试套取系统的上下文信息、敏感数据或内部实现细节。(p0545)
「防止用户通过特定 Prompt 套取系统的上下文信息、敏感数据或内部实现细节」——这句话是对的,而且切中要害。但 includes("投诉") 实现不了它。关键词白名单挡不住提示注入,挡不住「忽略以上指令」,更挡不住越权的 tool call。
这里就是这本书的结构性短板:它把「安全」当成一个章节小节(4 屏)来处理,而不是当成一条贯穿全书的约束。讽刺的是,全书最像安全设计的那句话,出现在第 3 章讲 Chroma 过滤的地方——「避免跨租户泄露上下文」(p0171)。真机制藏在工具用法里,假机制摆在第 8 章的小标题上,这个错位挺可惜的。
同理,MCP 那一章 44 屏,讲了服务端、客户端、Inspector、STDIO、SSE 与 Streamable HTTP,但没有一屏讨论「第三方 MCP Server 该不该被信任、它的工具描述能不能被投毒」。而这恰恰是真实项目里最早踩到的坑。
七、它的短板
老老实实列五条。
第一,全书没有一组效果数据。RAGAS 那 8 屏讲了指标怎么算、字段怎么填,但全书找不到一次「加了 CRAG 之后,召回率从多少到多少」。3.4 节「自我矫正:CRAG」只有 5 屏,从「什么是 CRAG」直接跳到「怎么实现」,中间缺了「为什么值得做」的证据。第 8 章讲成本优化,也没有一组「优化前后 token 消耗对比」。一本讲工程实践的书,最缺的恰恰是工程实践的度量。
第二,自研与低代码两条路线打架,作者不做取舍。第 5、6 章教你用 LangChain 写状态图、用 ChatUI 拼界面、用 TypeScript 管消息流;第 7 章整整 50 屏教你拖拽搭扣子,讲人设、插件、工作流、代码节点,最后发布成 API。这两条路线服务的是完全不同的人:前者要的是可控,后者要的是快。书里把它们并列成两个章节,却没有一屏讨论「什么团队该走哪条路」。读者学完会同时会两种做法,但不知道什么时候该用哪种。
第三,参数只给值不给量级。块大小 50、重叠 10;缓存 300 秒;max_tokens 60;seq_length 128。这些都是能跑的示例值,但书里没有一句「这是示例,生产环境该取什么范围」。对已经有经验的人无害,对刚上手的人有害——因为报错信息不会告诉他「你的 chunk 太小了」。
第四,协议章太薄,且止步于「怎么连」。MCP 44 屏,其中 4.3.2「HTTP SSE & Streamable HTTP」10 屏,讲配置和代码,没有讲「为什么 SSE 要迁到 Streamable HTTP」这个协议演进背后的推演。4.4.2「与 Memory/Rules 联动」只有 4 屏——记忆与规则联动是 MCP 最有意思的部分,4 屏太少了,基本只够放个例子。
第五,成书时的结构校对不算严。第 5 章从 5.2.5「RAG」直接跳到 5.2.7「SQL 联动」,5.2.6 在我这份 134 个章块的抓取记录里缺席——这可能是排版遗留,也可能是我抓取时段落归并的偏差,我如实标出来,不下结论。另一处是 1.1.2「前传:Transformer 架构」在章节流里出现了两次(p0017–p0024 与 p0050–p0058)。这些对读懂内容影响不大,但会让人怀疑「是不是漏了一节」。
八、怎么读它,以及一句话
如果你的目标是「两周内做出一个能查内部文档、能调几个工具、有界面的 Agent」,按这个顺序读:第 3 章(RAG,p0131–p0213)+第 5 章(LangChain,p0258–p0385),255 屏,够你跑通。遇到界面问题再翻第 6 章。
如果你的目标是「设计一个能长期维护的 Agent 系统」,那前七章都可以只做索引,直接读第 8 章(p0483–p0558),76 屏。特别是 8.4「渲染设计」和 8.6「成本优化」,前者讲的是「让模型输出组件而不是页面」的分层思路,后者讲的是把成本当工程量来削的具体手段——这两样能迁移到别的项目里去。
如果你只想补 RAG 那一段,我建议只读 3.2 到 3.3 这 56 屏,尤其是 p0171 那张 Chroma 过滤表。那张表教你的是「把隔离做在检索层」,比第 8 章那 4 屏安全边界有用。
至于第 7 章的扣子,50 屏,我不建议技术型读者按顺序读——它是给「不想写代码但要交付」的人准备的。你要真打算上低代码平台,直接开账号点一遍,比读 50 屏快。
一句话:它把「能跑通」写到了可以照着敲的程度,把「该不该这么设计」留成了一道没有答案的思考题——这是教材的诚实,也是教材的上限。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: