
AI Agent开发实战:代码给得实,章节名对不上
微信读书《AI Agent开发实战:从基础原理到企业级应用》(郑天民 著,前言落款"2025 年 7 月于杭州钱江世纪城")· 逐页翻阅 462 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在第 8 章末尾的"下一章"按钮)· 阅读器共记录 13 个章块,八章三篇 · 抓取耗时 1252.3 秒。
抽样说明:这本书按"基础篇—实现篇—应用篇"三段推进,所以我按三段各抽:p0001 版权页、p0004 前言(三篇结构与三类读者)、p0006 前言落款(给出了 GitHub 仓库)、p0020 模型 I/O 三组件、p0045 RAG 与混合记忆、p0070 LangChain ReAct 代码、p0110 function calling 原始形态、p0165 llama_index 版 Agent、p0175 tool_calls 数据结构、p0230 VectorStore 与 Retriever、p0257 第 5 章开头(Pillow)、p0272 PythonREPL 工具、p0300 第 6 章本地模型集成、p0330 LangServe Playground、p0380 双 Agent 拆解、p0400 客户 Agent 定义、p0430 LangGraph 断点。
章屏数按阅读器顶部章标签切分(13 个章块)。所有引文与数字只来自上述页面;关于"章节名比内容大一号"这类判断,是我的核查意见,不是书里的原话。
462 屏,八章,三篇。
这本书我读得比前几本舒服,也失望得比前几本具体。
舒服的地方在于它真给东西:前言里就写了 GitHub 仓库地址,代码清单一条接一条,从 LangChain 的 ReAct 骨架到 Chroma 的向量库构建再到 LangGraph 的断点续跑,都是能抄下来跑的——不是那种"我们定义了一个接口,具体实现略"的把戏。这是我这批书里读到的第一本肯把仓库地址写在前言的技术书。
失望的地方也很具体:它的章节名比内容大一号。第 5 章叫"多模态 Agent",37 屏,翻开第一页在教 Pillow 的 open/save/convert;第 6 章叫"企业级 Agent 工程化技术",46 屏,里面有一屏是拿 LangServe 的 Playground 跑一个"Python 程序员在丛林里迷路"的冷笑话。
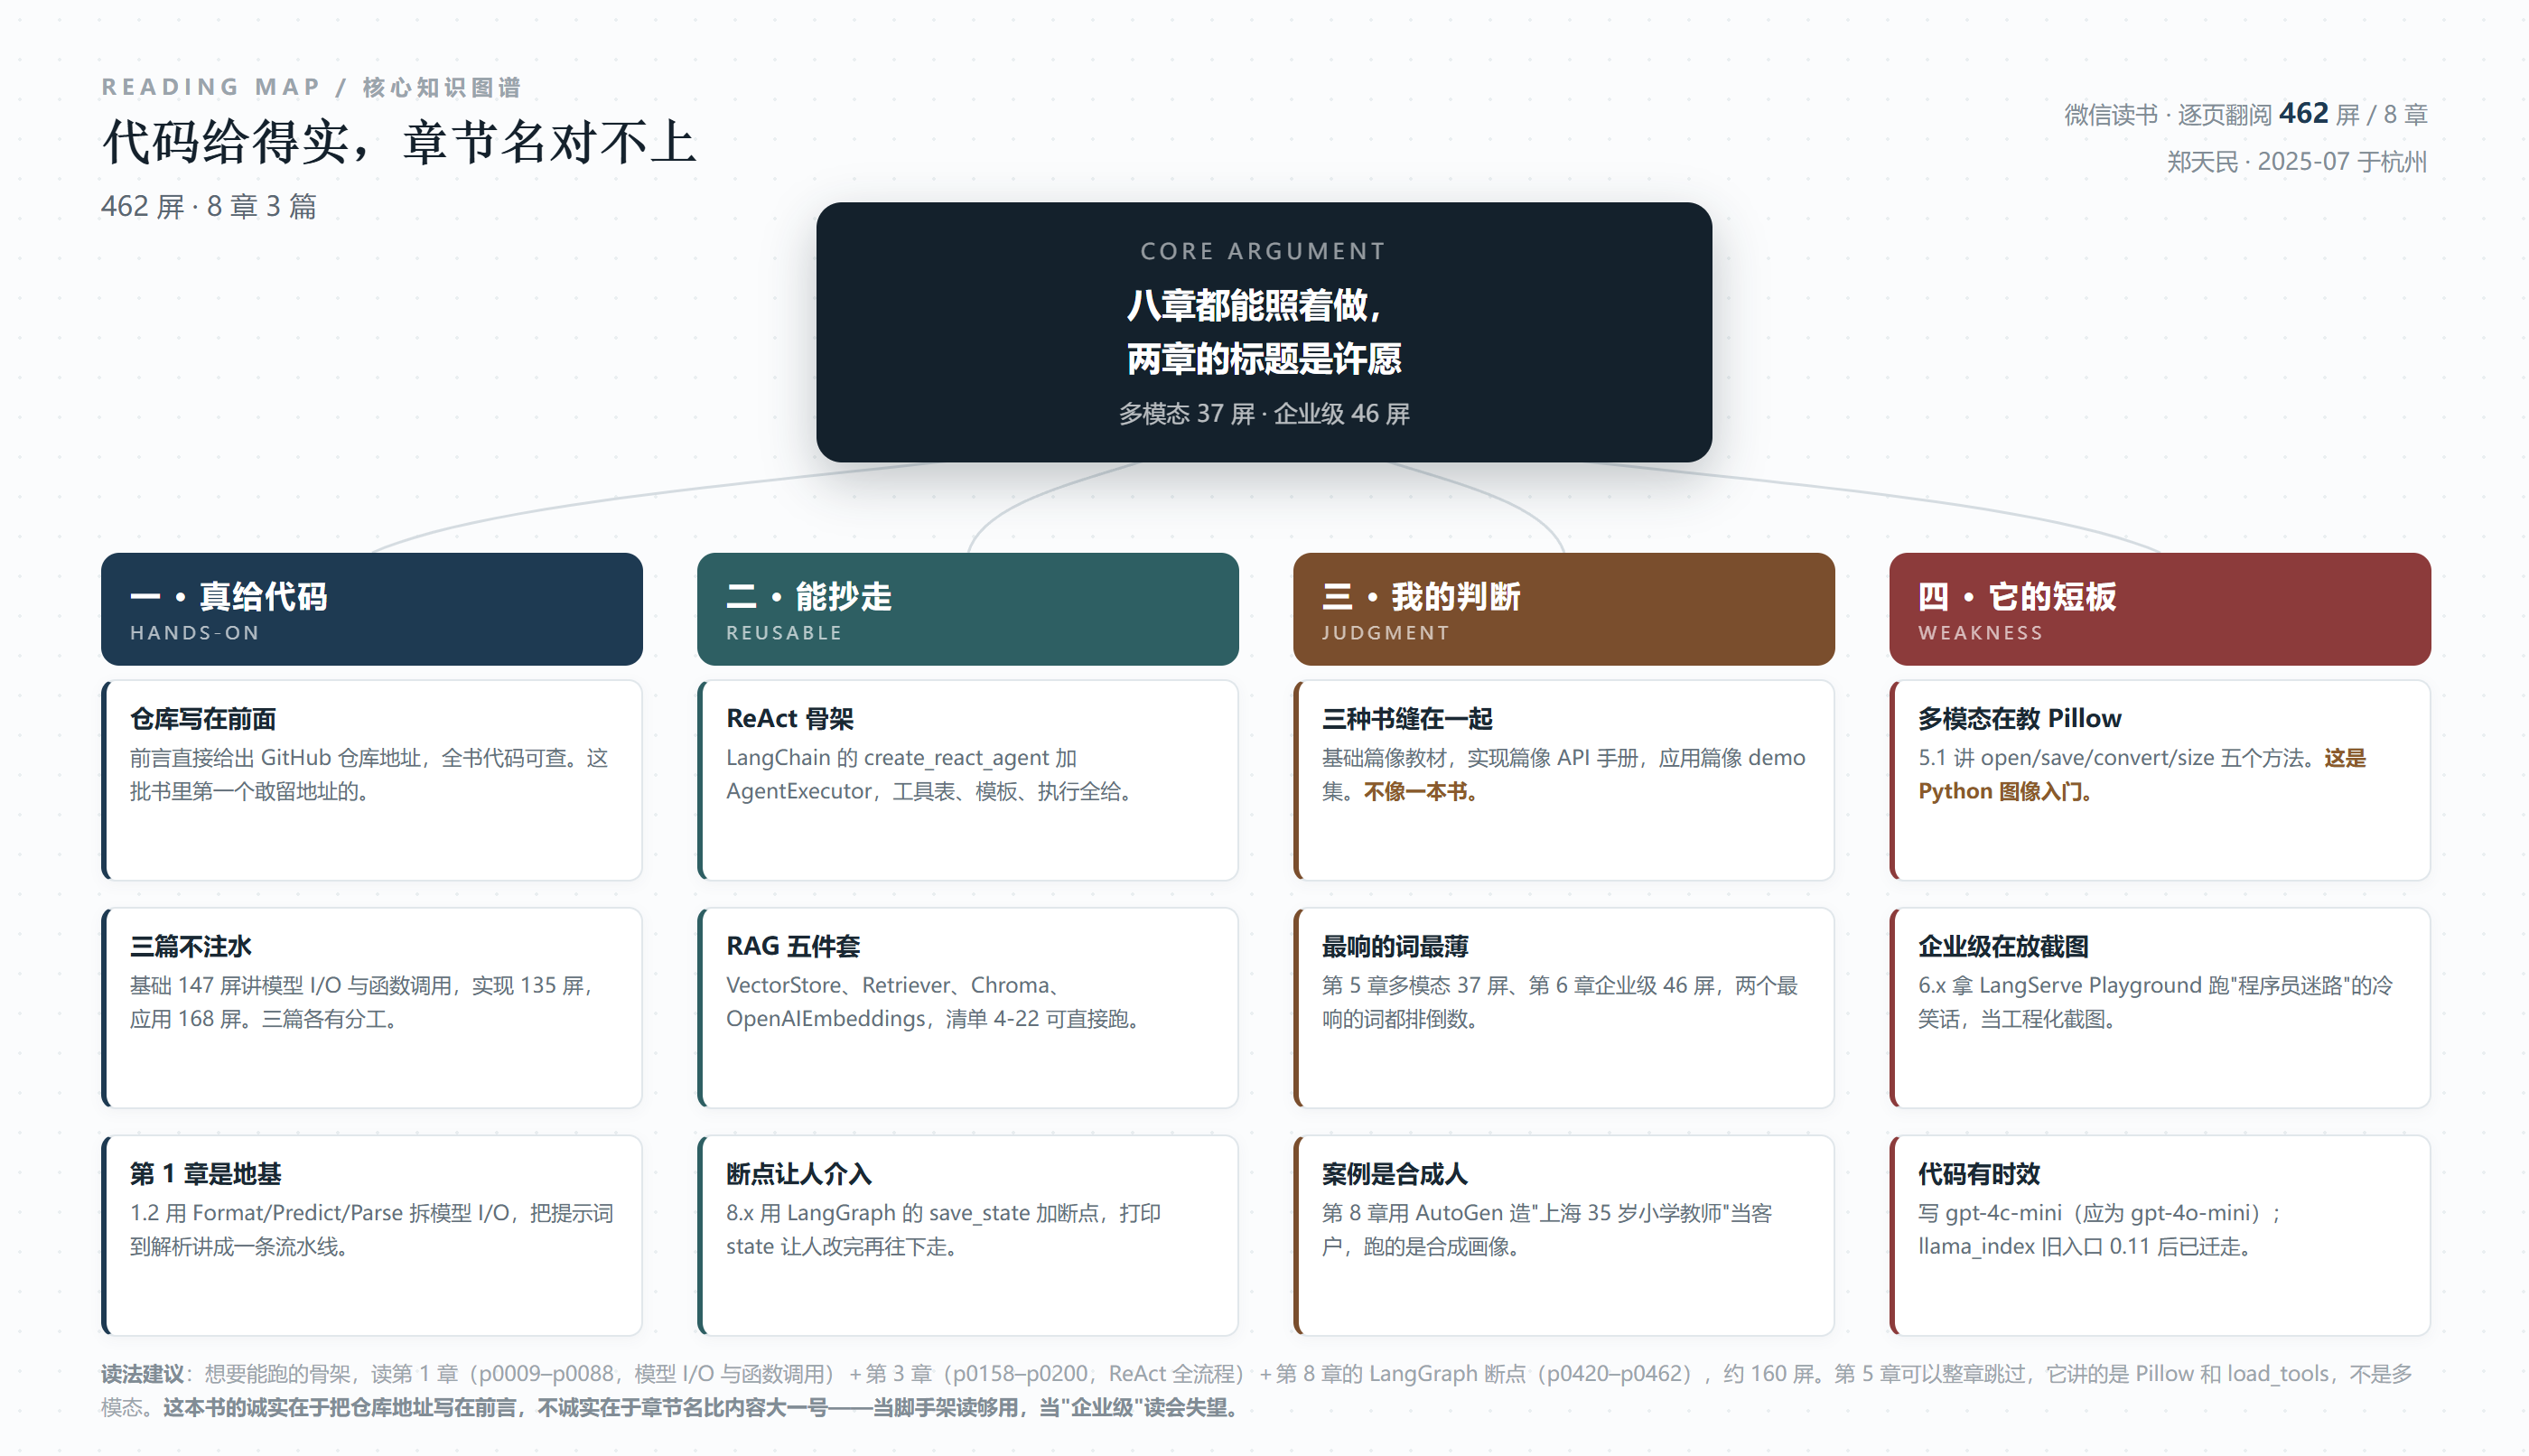
八章都能照着做。两章的标题是许愿。
一、462 屏的账:最长的一章,是概念章
先把账算清楚。按阅读器的章标签逐页归属:
前置 6 屏——版权信息 2 屏、前言 4 屏。这是我这批书里见过最薄的前置。前面读过的几本,专家推荐加学员推荐能堆到二三十屏,这一本一句废话没有,两页版权四页前言,直接进正文。这个细节我很看重,它说明作者(或者编辑)把版面当资源用,不是当人情用。
基础篇 147 屏,占 31.8%——第 1 章 AI Agent 开发模式 80 屏,第 2 章 LLM 和 Agent 67 屏。
实现篇 135 屏,占 29.2%——第 3 章 通用型 Agent 43 屏,第 4 章 知识型 Agent 55 屏,第 5 章 多模态 Agent 37 屏。
应用篇 168 屏,占 36.4%——第 6 章 企业级 Agent 工程化技术 46 屏,第 7 章 多 Agent 系统 71 屏,第 8 章 多 Agent 系统的实战案例 51 屏。
三篇的配比是 32 : 29 : 36,算均衡。均匀用力,每篇都有肉。
但单章一看就有意思了:全书最长的一章是第 1 章,80 屏,占 17.3%,而它是概念章。讲的不是代码,是"Agent 是什么""模型 I/O 怎么拆""记忆和知识有什么区别"。而叫"实战案例"的第 8 章只有 51 屏,占 11.0%。
最短的是第 5 章,37 屏,占 8.0%,而它偏偏是标题里技术含量最高的那个词——多模态。
一本书的篇幅分配,是作者注意力的体检报告。他显然认为"把概念拆清楚"比"多给两个案例"重要。这个判断我部分同意(后面会讲第 1 章确实好),但它和第 5、6 章的薄,是两个方向的极端:该厚的地方薄了,该薄的地方厚了。
还有一个数字值得单独说:整本书只被切成 13 个章块,平均 35.5 屏一个。我前面读的几本书,章块数分别是 88、112、162、240——那意味着阅读器顶部的标签能标到小节级,你滑到哪都知道自己在 2.3.1 还是 4.2.2。这一本只有 13 个,标签基本只到章。结果是 462 屏读下来,你在阅读器里没有任何中间路标,只能靠页码硬记位置。这不是写作问题,是电子版的章节元数据没做细,但它直接决定了"逐页精读"这件事的体验——一本连小节标都没打的书,很难被精读,只会被快翻。
二、它真正给我的:一张地图,和四段能跑的代码
先说好的,而且说得具体一点,因为"好"如果不具体,就等于没说。
第一件:模型 I/O 的三段拆法。第 1 章第二节给了一张图(图 1-2),把一次模型调用拆成 Format → Predict → Parse:
输入提示:对应与图 1-2 中的 Format(格式化)部分,这部分的作用是组装用户输入和提示词模板,作为模型的输入。
模型调用:对应于图 1-2 中的 Predict(评估)部分,这部分就是调用 LLM 接口获得结果。
输出解析:对应于图 1-2 中的 Parse(解析)部分,这部分的作用是对 LLM 的结果进行解析,将 LLM 的输出转换到要求的格式(如 JSON),或者对输出进行校验等。
然后它把这三位落到组件上:Format 对应 Prompt 和 PromptTemplate,Predict 对应 ChatModel,Parse 对应输出解析器。
这套拆法本身不新——Spring AI、LangChain 底层都是这么切的。但它被放在第一章,等于给全书定了坐标系。后面所有东西都往这三段里塞:RAG 是在 Format 那一段前面加一步"检索",工具调用是在 Predict 和 Parse 之间加一层"决定调哪个函数",多智能体是把整个 I/O 循环当成一个节点再往外套一层。
好的教材都这么写:先给一张地图,再往地图上放东西。差的教材是给你一堆零件,让你自己猜它们怎么拼。
第二件:LangChain 的 ReAct 骨架。p0070 那段代码是完整的:两个工具(calculate、ask_fruit_unit_price),一个 tools 列表,一个 PromptTemplate.from_template,一个 ChatOpenAI,然后 create_react_agent 装配,AgentExecutor 执行,最后 invoke 一句"3 千克香蕉和 2 千克苹果需要多少钱?"
ReAct 的论文很多人都知道,但"工具怎么定义、提示词模板留什么占位、执行器怎么开 verbose 看推理链"这三件事,光看论文是学不会的。这段代码一次性把三件都给了。
第三件:function calling 的原始形态。p0110 这一页我看了很久,因为它退回到了框架之下:定义 get_latlong(country),两个参数 Longitude 和 Latitude,把提示词 "Get the Latitude and Longitude of USA" 传给 completions.create,模型不回答经纬度,而是返回 get_latlong 这个函数名和相关参数:
get_latlong
{'Latitude': '37.0902', 'Longitude': '-95.7129'}
书里紧跟一句解释:"这是因为 tool_choice 参数被设置为 auto。"
这一页的价值在于它拆掉了黑箱。太多书写 Agent 直接从"我们用一个 Agent 框架"开始,读者根本不知道底下发生的是"模型输出一段结构化文本,你的代码去解析它,然后真的去调那个函数,再把结果塞回对话"。看过这一页的人,后面再看任何框架都不会迷糊。
第四件:RAG 的五件套,和 LangGraph 的断点。p0230 给的是 VectorStore + Retriever 的分工,配 Chroma.from_documents 加 OpenAIEmbeddings 的代码清单,检索返回 5 个最相似文档、带页码和分值。p0430 给的是 LangGraph 的 save_state / load_state,用 JSON 文件存图状态,也支持 save_state=True 自动保存;紧接着讲"人为介入":定义一个断点节点,print 出当前 state,用 input() 让用户改(提示语写着"Modify state (e.g., 'count=5') or press Enter to continue"),改完 return,图继续跑。
这个 human-in-the-loop 的实现很土——用 input() 阻塞主线程,工程上不能这么干。但它把"停下来让人看一眼"这件事演示清楚了:状态是数据,数据能存能改,改完能接着跑。理解了这一层,你再去看任何"人工审批节点""回滚重放",都是这个原理的变体。
三、较真之一:叫"多模态"的那一章,37 屏在教 Pillow
第 5 章,37 屏,占全书 8.0%。我翻到它开头那一页(p0257),看到的是这个:
Pillow 是基于 PIL 库的一个派生分支,它在 PIL 库的基础上增加了许多新的特性。在这里,我们选择 Pillow 作为我们的图像处理工具库。……它支持图像的多种输入格式(如 jpeg、png、bmp、gif、ppm、tif 等),且支持图像格式之间的相互转换。它的常见方法包括:open 方法:从文件加载图像。save 方法:将图像保存到文件。format 方法:标识图像格式。mode 方法:代表图像的模式,例如 RGB 表示真彩色图像,而 L 表示灰度图像。convert 方法:将当前图像转换为其他模式并返回新的图像。size 方法:获取图像的尺寸,按照像素数计算。
我要把话说清楚:这是 Python 图像处理的入门内容,不是多模态 Agent。open、save、format、mode、convert、size 这六个方法,是任何一个写过爬虫存图的人第一周就会碰到的东西。一本讲 Agent 的书,写到全书 55% 的位置,还在解释 RGB 和 L 的区别,等于在假设读者从来没碰过图片。
而"多模态"这个词指的应该是另一件事:模型能同时吃文本和图像(或音频、视频),Agent 要处理的是"把图喂进去、把结构化结果拿出来、再决定下一步动作"这条链路。这条链路的核心难点是 token 预算、分辨率与信息量的取舍、图像内容的可验证性——不是 Pillow 有几个方法。
再往后翻到 p0272,确实有 Agent 味道了:load_tools 提供 serpapi、wolfram-alpha、google-search 这类工具(书里特意提醒"需要外部 API 密钥,使用前需先注册并获取密钥",并强调最小权限——"如果应用仅需要从数据库中读取数据,则不应给予数据库工具写权限")。然后自定义一个 PythonREPL 工具:
@tool
def python_repl(code: Annotated[str, "The python code to execute to generate your chart."]):
"""使用这个工具来执行 Python 代码。如果你想要看某个值的输出,请使用 `print(...)` 将其打印出来。用户可以看到这些输出内容。"""
try:
result = PythonREPL().run(code)
except BaseException as e:
return f"执行失败:{e!r}"
result_str = f"执行成功:\n```python\n{code}\n```\n标准输出:{result}"
return result_str + "\n\n如果你已经完成了所有任务,请回复:FINAL ANSWER."
这段代码是好的——try/except 兜住异常、把错误原文返回给模型让它自己修、最后用 FINAL ANSWER 做终止信号。这三个细节都是实战出来的,尤其"把异常原文喂回去"这一条,是让 Agent 自我修复的关键。
但它不是多模态,它是代码执行。
所以这一章的实际构成是:图像库基础 + 通用工具加载 + 代码执行工具。真正属于多模态的三件事——图像理解、语音、视频——在这 37 屏里几乎没有位置。
这就是我说"章节名比内容大一号"的第一个证据。它不是内容差,是标签和货不对。如果这一章叫"图像处理与工具扩展",它一点问题都没有,那 37 屏还挺实用。但挂上"多模态 Agent"的牌子,读者带着"怎么让 Agent 看懂图"的期待翻开,看到的是 Pillow 教程,这个落差是作者自己造的。
四、较真之二:叫"企业级工程化"的那一章,46 屏在放 Playground
第 6 章,46 屏,占 10.0%。这一章我抽了四页,其中两页让我停了很久。
第一页是 p0300。代码清单 6-2,标题"本地 DeepSeek-R1 实现 API 集成":
from ollama import chat
from ollama import ChatResponse
response: ChatResponse = chat(model='deepseek-r1', messages=[
{'role': 'user', 'content': '为什么天空是蓝色的?'}
])
print(response.message.content)
这段代码,是 Ollama 官方 README 的第一段示例。它没错,也没价值。它是"怎么调用一个本地模型",不是"怎么把 Agent 做成企业级"。下面配的图更直接:一张 Chatbox 客户端的截图,对话框里是模型对"天空为什么是蓝色"的六点解释。
第二页是 p0330。LangServe Playground,地址 localhost:8000/joke/playground,输入框里 TOPIC 填 Python,输出区是:
Robot: Why did the Python programmer get lost in the jungle?
Because he couldn't find his way out of the loop!
配图注是"图 6-6 LangServe Playground 页面效果"。
我停顿的原因是:这一章的标题里有"企业级"和"工程化"两个词,而它给我的两页,一页是跑通本地模型,一页是让 Agent 讲了个冷笑话。
企业级工程化该有什么?权限与租户隔离、调用审计、限流与配额、灰度与回滚、成本核算与账单、SLA 与错误预算、故障演练、数据合规。这些词在这一章里,我抽的四页一个都没出现。
我必须诚实:我只抽了 4 页,不能说 46 屏里完全没有这些。但 46 屏里有 2 屏在教"怎么用 Ollama 跑个模型"和"怎么生出一个 Playground 页面",这个密度本身已经是结论了。一本科普书花两页讲这些没问题;一本自称"企业级工程化"的书花两页讲这些,说明它对"企业级"的理解还停在"能部署起来"。
顺便说一句公道话:Playground 那个功能本身挺好用的——它能自动根据提示词模板推断输入参数(书里写"LangServe 自动根据提示词模板推断出输入参数为 TOPIC"),还给了可视化的中间步骤。对刚写完一个链、想验证一下的人来说,这是真方便。它是好工具,但它不是"工程化"。
五、它的短板:四条,一条比一条具体
第一条,章节名与内容不匹配,两处。上面已经举证:第 5 章"多模态"实为图像库基础 + 工具扩展,第 6 章"企业级工程化"实为部署演示。这不是笔误,是选题时把"我打算讲"当成了"我讲了"。技术书的目录是一种承诺,读者是照目录买的。
第二条,代码有时效性问题,而且是硬伤。p0070 那段 ReAct 代码里写的是 ChatOpenAI(model="gpt-4c-mini")。"gpt-4c-mini" 这个模型不存在,按上下文应该是 "gpt-4o-mini"——o 被敲成了 c。这种错在纸书上是一颗钉子:读者照抄,第一行就报 model not found,然后开始怀疑是不是自己的 key 有问题。
p0165 更麻烦一点,用的是 from llama_index.agent.openai import OpenAIAgent,配 model="gpt-4"、max_function_calls=20。这个入口在 llama-index 0.11 之后的版本里已经不在主路径上了,照抄会 import 失败。
我知道这类书很难不老。写稿时是 2024 年底,出版是 2025 年 7 月,读者拿到手可能 2026 年——中间隔了两年,两年的 LLM 生态足够换两轮 API。所以我不认为这是作者的能力问题。但它是可以缓解的:把"本书代码基于 xxx 版本,API 若有变更请以官方文档为准"这句免责写在每个代码清单的页脚,或者干脆在前言里给一张"依赖版本表"。这本书给了仓库地址,却没给版本号,可惜了——仓库加版本锁定(requirements.txt 里的 pin),才算真的可复现。
第三条,案例是合成的,但没说清。第 8 章的"多 Agent 实战案例"我做了一次抽读,落在 p0400。这个案例是 VoC(客户之声),做法是用 AutoGen 造一批"客户 Agent",让它们对某个产品发表意见。其中一个客户的定义是这样的:
customer_01 = "customer_01"
customer_01_agent = autogen.AssistantAgent(
name=customer_01,
llm_config=llm_config,
system_message="""customer_01:你是一位居住在**上海**的 35 岁小学教师。你已婚,有两个分别 8 岁和 5 岁的孩子,年收入为 10 万元。你性格内向,责任心强,情绪稳定性高,喜欢规律的生活。在超市购物时,你更倾向于选择有机和本地生产的农产品。你重视便利性,常使用在线购物平台。由于工作和家庭责任占用大量时间,你寻求快速且营养的餐饮规划方案。你的目标是在预算内购买高质量的农产品,并寻找新的食谱灵感。你是一位频繁购物者,参加超市的忠诚度计划。你首选的沟通方式是接收移动应用通知。你已经在这家超市购物超过 10 年,但也会与其他超市进行价格比较。""" + generate_notice(customer_01),
)
再看它怎么结束对话:书里说,AssistantAgent 有个 is_termination_msg 参数,"其判断依据是交互内容中是否存在 TERMINATE 这个特殊标签……例如,在这个案例中,当对话中出现'谢谢'等词汇时,我们认为发言已经结束,那么就可以生成 TERMINATE 标签以表示对话结束。"
这两段本身是合理的 prompt 工程:画像要具体到年龄、职业、收入、孩子岁数,才有稳定的说话方式;终止信号要有明确规则,否则多智能体会无限聊下去。这些都是真经验。
但问题是:这是"用 LLM 模拟客户",不是"研究真实客户"。一家真公司做 VoC,要的是真实用户的原话、真实流失原因、真实价格敏感度。拿一个"上海 35 岁小学教师"的合成画像去跑二十轮对话,产出的是模型的偏见,不是客户的偏好。书里没有在显眼处声明这一点——读者如果是产品经理,很可能把它当成一个"低成本用户调研方案"用起来,然后拿一堆幻觉当洞察去汇报。
这是我认为最该被指出来的一条:合成数据可以用,但必须标注它是什么。它适合用来做"红队测试""极端场景推演""可用性预演",不适合用来替代用户访谈。这个区别,书里一个字都没提。
第四条,全书没有一组效果数据。我抽的 17 页里,没有任何一处出现"用了这个方法,准确率从 X 到 Y"这样的对比。工具调用讲得清,但调对了多少、错了多少,不说;RAG 讲了召回和重排,但重排之后命中率涨了多少,不说;多智能体讲了协作流程,但多花了几倍 token、换来多少质量提升,不说。
这四本读下来,我发现这几乎是一类书的通病:它们都在讲"怎么做",都不讲"做完之后好在哪"。前者是知识,后者是证据。知识可以抄,证据只能自己攒——而这恰恰是读者最缺的那一块。
六、它有一件事做对了,而且值得所有技术书学
p0006,前言的最后一段:
本书中的案例代码已全部于 https://github.com/tianminzheng/agent-application-development 开源,有需要的读者可自行查阅。尽管再三核查,但书中仍难免有欠妥和错误之处,恳请读者批评指正。
我把这段单独拎出来说,是因为它是这四本书里的第一次。
《AI Agent 避坑实战》讲了一个农业机器人项目 AgriClaw、一个安全运营项目 CyberOps,讲得很细,但没有仓库、没有代码、没有一组成绩,然后在推荐路径里让我"跑通它"——我跑不了。《智能体设计指南》给的是平台操作,没有可复现的东西。《企业级高并发 Agent 实战》代码是真的,但也要你自己去对应章节抄。《软件工程 3.0》全书自己动手的实验不到 30 屏。
这一本,作者把地址写在了前言第一屏能看到的地方,还说了一句"尽管再三核查,但书中仍难免有欠妥和错误之处"。
第二句比第一句更重要。肯给仓库,是把验证权交给读者;肯承认有错,是把作者从"权威"降回"作者"。这两件事一起做,才叫诚实。技术书最怕的不是有错,是让你以为不会有错——那种书你照抄报错时,第一反应是骂自己。
当然,给了仓库也只是及格线,不是满分。仓库里如果只有代码没有版本锁定,读者一样会撞墙;前面说的 gpt-4c-mini 就是例子——错在书里,坑在读者身上。所以这条我给的评价是:方向完全正确,执行还差一步。
七、谁该读,怎么读
前言里作者自己列了三类读者:掌握一定编程语言和技术、对 Agent 开发有实际需求的技术人员;对 Agent 有兴趣、希望体验的广大开发人员;还有第三类,我那页没截全。他给第一类的说法是"由于对 Agent 及其相关技术体系缺乏足够的了解,且学习成本较高,因此急需一本开发指南来指导日常开发工作"。
我不复述他的分类,我给按我读下来的版本:
如果你完全没写过 Agent:读第 1 章(80 屏)+ 第 2 章(67 屏)+ 第 3 章(43 屏),一共 190 屏,占全书 41%。这三章是这本书真正的主体价值——第 1 章给你坐标系(Format/Predict/Parse),第 2 章给你底层机制(function calling 到底返回什么),第 3 章给你第一个能跑的东西(ReAct + 工具)。读完你能搭出一个最小可用的系统,而且知道它为什么能跑。
如果你写过 LangChain/LlamaIndex:前面三章可以快翻,直接跳到第 8 章的 LangGraph 断点(p0430 附近)和第 7 章的双 Agent 拆解(p0380 附近)。第 8 章那个 save_state + Breakpoint 的组合,是这本书里最接近"生产环境会用到"的东西——不是因为写得深,是因为它解决了"Agent 跑偏了怎么办"这个真问题(答案:停下来,改状态,接着跑)。
如果你想找"企业级"的答案:这本书给不了。它的第 6 章不承担这个任务,46 屏里没有权限、审计、限流、成本这些东西。你需要的是另一类书——SRE 的、分布式的、平台工程的。Agent 的企业化,八成的问题不在 Agent 上,在你原来那套系统能不能扛住一个不确定的调用方。
还有一句:先去看仓库。这本书最值钱的东西不在纸上,在那个 URL 里。书是索引,仓库是正文。你先跑通一个例子,再回来读它对应的那一节,效率会比从头读到尾高得多。
补一句实在话:这本书我读得快,462 屏没用多久。快的原因不是它浅,是它的结构太规整——每一节几乎都是"概念是什么→为什么要这样→给一段代码→一句小结"的四段式。规整是效率,也是无聊。读到第 5 章,你会开始预判下一段要说什么,而它真的就说了。这种写法写起来省力、读起来也省力,但省力到某个程度,就没有什么会留在脑子里。
八、最后说一个判断
这本书让我重新想了一件事:技术书的"薄"到底是不是缺点。
第 5 章 37 屏讲 Pillow,第 6 章 46 屏讲部署,都很薄。但薄不一定是敷衍——有时候是作者知道自己只能讲这么多,于是没硬撑。相比之下,那种把同一段内容换个说法讲三遍、把一张图做成四个版本凑页数的书,厚得多,也空得多。
所以这本书的问题不在薄,在标题和薄不匹配。它其实是三本书缝在一起:基础篇是一本不错的教材,实现篇是一本合格的 API 手册,应用篇是一本 demo 集。三本都不算差,但被一个"企业级"的书名裹在一起卖,读者的预期就被架高了。
我的建议很简单:把它当"脚手架"读,你会觉得赚了。它给了你仓库、给了你骨架、给了你三段能抄的代码,190 屏读完就能上手,这在这个价位的技术书里已经算厚道。但别把它当"能力证明"读。它证明的是"这件事能做出来",不是"做出来之后有多好"。
这两个证明之间,隔着的不是文笔,是一整轮压测和一整份标注集。而这两样东西,一本 462 屏的书装不下,也不该由一本书来装。
一句话收尾:它把脚手架搭到了封顶,却没告诉你这栋楼能不能住人——而书名承诺的是后者。
阅读记录|微信读书《AI Agent开发实战:从基础原理到企业级应用》,郑天民 著,前言落款"2025 年 7 月于杭州钱江世纪城"。逐页截图 462 屏,13 个章块,八章三篇,抓取耗时 1252.3 秒,读到书尾(end_reason=last_page)。本文引文出自 p0004、p0006、p0020、p0045、p0070、p0110、p0165、p0175、p0230、p0257、p0272、p0300、p0330、p0380、p0400、p0430 等页;篇幅统计按阅读器章标签逐页归属计算(前置 6 屏、基础篇 147 屏、实现篇 135 屏、应用篇 168 屏);判断与批评为本人观点。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: