
多模态大模型:算法、应用与微调:多模态只占 12%,剩下是大模型通识课
阅读提示:399 屏,从内容简介翻到 5.5.5 节。抓取到 p0400 被判"章回环"停下(end_reason=loop_chapter,reached_end=false),第二篇只读到 ChatGLM 金融大模型挑战赛这一节,后面的图像生成、代码生成、LangChain 三章我一个字都没看到,所以这篇也一个字不提。引句都标了页码,可以拿去复查。各节屏数按阅读器顶部章标签切分,标签偶尔滞后一两屏,占比数在小数点上别较真。
先给判断:这是一本认真写的教材,但它不是一本讲多模态的书。
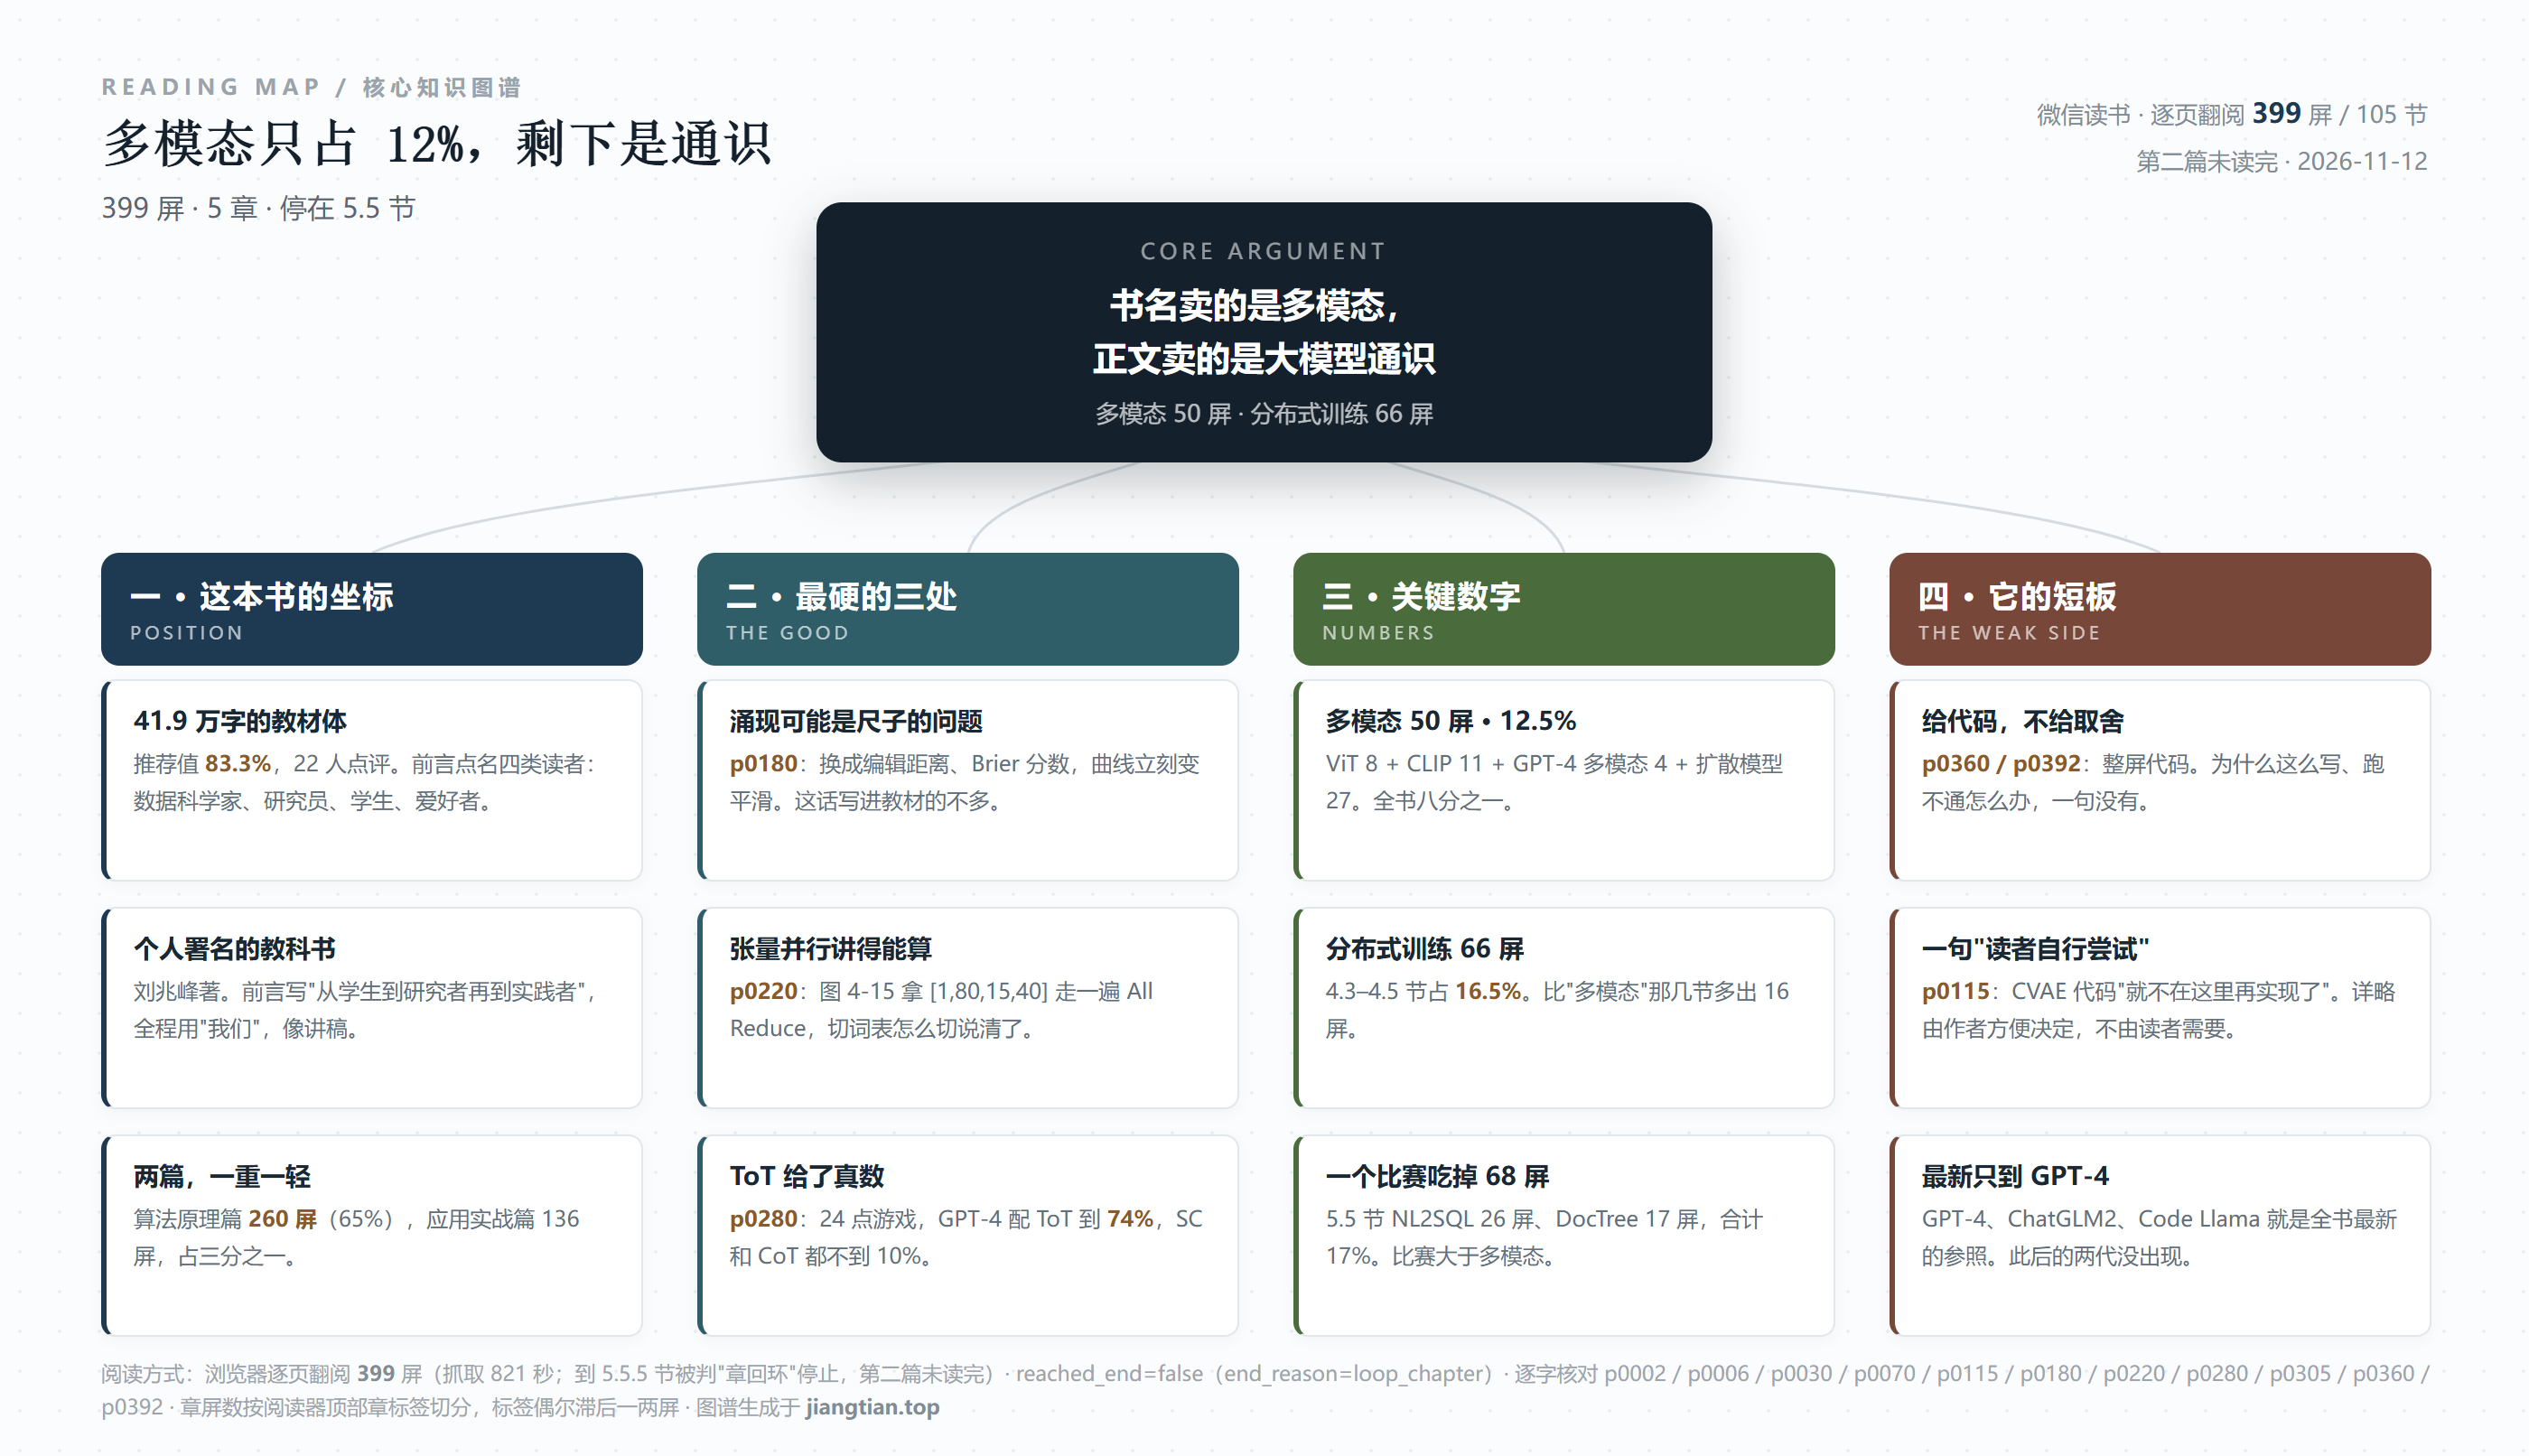
书名《多模态大模型:算法、应用与微调》,41.9 万字,微信读书推荐值 83.3%,22 人点评(推荐 17、一般 4、不行 1),3043 人读过。作者刘兆峰。我把 399 屏按小节切完,算出一个数:真正讲多模态的内容——ViT、CLIP、GPT-4 的多模态架构、扩散模型——加起来 50 屏,占 12.5%。而"分布式训练"那几节占 66 屏,16.5%。一本叫多模态的书,讲分布式训练比讲多模态多出三成。
这不是挑刺,这是这本书最核心的事实。它决定了你该不该买,也决定了你买到手之后该怎么翻。
一、先把账算清:多模态只有 50 屏
我把每一屏挂到它所在的小节上,按章汇总,得到这么一张表:
第 1 章 Transformer 模型,p0004–p0043,40 屏。其中 1.3 节 ViT 占 8 屏(1.3.1 注意力机制在图像上的应用 1 屏、1.3.2 ViT 模型架构 2 屏、1.3.3 大数据预训练 2 屏、1.3.4 ViT 模型训练实践 2 屏)。
第 2 章 GPT 系列模型,p0044–p0100,57 屏。其中 2.5.3 多模态架构 4 屏。
第 3 章 深度生成模型,p0101–p0173,73 屏。其中 3.3 节 CLIP 11 屏、3.4 节稳定扩散模型 27 屏。
第 4 章 预训练模型,p0174–p0263,90 屏。其中 4.3 节通信数据量、4.4 节分布式训练、4.5 节 DeepSpeed 合计 66 屏。
第二篇 + 第 5 章 文本生成应用实战,p0264–p0399,136 屏。其中 5.5 节那个比赛吃掉 68 屏。
50 屏多模态,摊在四个地方:ViT 8 屏、CLIP 11 屏、GPT-4 多模态架构 4 屏、扩散模型 27 屏。四个数加完,12.5%。
看到这个数,第一反应是"作者挂羊头卖狗肉"。但我读完 399 屏,愿意给一个更客气的解释:他真正想写的是"从分词器到 ZeRO 的一条完整链路",多模态只是这条链路上最时髦的一段。证据在结构里——第 1 章从分词器讲到 Transformer,第 2 章从 GPT-1 讲到 GPT-4,第 3 章从自编码器讲到扩散模型,第 4 章讲参数量估算、通信量分析、数据并行、模型并行、混合精度、ZeRO。这是一条"训练一个大模型需要知道什么"的路线,不是"多模态模型有什么特别"的路线。
这件事在 2026 年格外要紧。多模态已经是主战场——图文理解、视频生成、语音对话、屏幕操作,全在这一条线上。一个想补多模态的人,翻开一本 41.9 万字、封面写着"多模态大模型"的书,期望的是"跨模态这件事的特殊性":图像怎么对齐到语言空间、不同模态的 token 怎么混着送进同一个 Transformer、训练时各模态数据怎么配比、推理时怎么处理模态缺失。这些恰恰是跨模态独有的难点。书里给了 CLIP 的对齐(11 屏)和扩散模型的加噪去噪(27 屏),但"混着送进去"这件事本身,只在 GPT-4 那一节占了 4 屏。这就是 12.5% 带来的实际损失:不是少读了什么,是该讲的地方没讲。 这条路线本身有价值,我在第三节会说它甚至比多模态那 50 屏更值钱。但它跟书名是两件事。你冲着"多模态"三个字买,会觉得自己被骗了 12.5%;你冲着"大模型全栈"买,会觉得这书挺厚道。同一本书,两种买家,两种评价。这也解释了为什么它的推荐值停在 83.3%——不低,但也不是那种"五星刷满"的书。22 个人里有 4 个点"一般",1 个点"不行",比例不算小。
二、它最值钱的一节,藏在一堆公式中间
如果这本书只让我买四屏,我买 p0178–p0181,4.1.2 节"涌现能力"。
这一节干的事,是把"涌现"这个被媒体用烂的词拆开看。作者的讲法是:所谓能力突然出现,很多时候不是模型内部发生了什么相变,而是你换了一把尺子。用准确度这种非线性、不连续的评价指标,模型必须把一整串词都答对才算对,指标就呈现阶跃——前面一片平地,某处突然抬起来,看着像"涌现"。换成连续的指标,比如词级别的编辑距离,或者 Brier 分数,同一条曲线立刻变得平滑、可预测。
书里用了四张小图并排(图 4-3 的 c、d、e、f):左边两张用非线性打分,曲线上有明显的台阶;右边两张换线性打分,台阶被抹平成了斜坡。这个对比做得干净,不需要读者懂信息论也能看明白。
我要给这一节一个很高的评价,理由不是它讲对了什么,而是它敢在教材里放一句让"能力跃迁"叙事不舒服的话。市面上讲大模型的书,绝大多数在这一节会写"当参数量超过某个阈值,模型突然获得了推理能力",配一张漂亮的 S 曲线,然后开始讲 AGI。这本书没这么写。它说:先看看你的指标长什么样。
但批评也在这里:它把结论收得太早了。如果涌现很大程度上是评价指标的产物,那么下游有一连串东西要重写——模型能力的分级表、榜单排名、"某项能力在 X 亿参数解锁"的产品话术、以及基于这些结论做的采购决策。书里一句没提。四屏讲完,翻页去讲参数量估算,仿佛刚才那句话只是个小注脚。
这一节的实用价值比它的篇幅大得多。你以后看任何一张"能力曲线"——厂商发布会上的、榜单上的、某篇论文里的——都可以先问一句:横轴是什么,纵轴是什么,这个纵轴是连续的还是阶跃的。如果纵轴是"答对率""通过率""完全正确率"这类非黑即白的指标,那条陡峭的上升大概率有尺子的成分;如果纵轴是损失、困惑度、编辑距离这种连续量,斜率才是模型真实的进步速度。这个方法不需要跑实验,一支笔就能用。我把这一节记成了"全书唯一一个可以带走的方法",而不是"全书唯一一个正确的结论"。 这是这本书的典型毛病:它经常能走到正确的问题面前,然后转身走开。我后面几节还会遇到同样的情况。
三、分布式训练 66 屏:不是跑题,是另一个主题
4.3 到 4.5 三节,66 屏,占全书 16.5%。这是全书技术密度最高的地方,也是我读得最慢的地方。
举一个具体的例子。4.4.3 节讲模型并行里的张量并行,p0220 给了图 4-15「单词嵌入的张量并行示意图」,然后用一组数字把这件事说穿:假设输入是 [1, 80, 15, 40],四个数字是词在词表里的索引;把词表切成两半放在两张 GPU 上,第一张查出 [I, 0, fine, thanks],第二张查出 [0, am, 0, 0];两张卡各有一半位置是空的,做一次 All Reduce,合并成 [I, am, fine, thanks]。
这个例子好在哪?好在它把"张量并行"从一句术语变成了一个可以手算的过程。你看完就知道:切词表会产生空洞,空洞要靠通信填,通信是有成本的——后面 4.3 节讲通信数据量分析,讲点对点通信和集群通信,正好接得上。4.2 讲参数量估算、3.4.3 讲数据集构建,也都是这种"给公式、给例子、给数"的写法。
所以我的判断是:这 66 屏不是跑题,它的质量甚至高于多模态那 50 屏。多模态那 50 屏里,1.3.2 讲 ViT 模型架构只给了 2 屏,你只能知道"图片切成 patch、加位置编码、送进 Transformer"这个大概;而分布式这 66 屏,从通信量估算到 ZeRO 的三级卸载(4.5.1 ZeRO 8 屏、4.5.2 ZeRO-Offload 5 屏、4.5.3 ZeRO-Infinity 3 屏),是一条能走通的路。
这 66 屏还有一个隐性价值,是它给出的"数量级感"。4.2 讲参数量估算,4.3 讲通信数据量分析,两节加起来才 11 屏,但它们回答的是同一个问题:这件事到底有多贵。看懂这两节,你再看"某某公司训了万亿参数模型"的新闻,心里会有一个大概的换算——参数涨十倍,通信量涨多少,卡时涨多少,电费涨多少。这种数量级感,是很多只讲架构的书给不了的。我个人的经验是:判断一个人懂不懂训练,不看他会不会画 Transformer 图,看他对"这一步要多少卡、多少天、多少钱"有没有直觉。这本书在这件事上是合格的,甚至可以说是它最不像"教材"的地方。 问题在于它跟书名承诺的读者不匹配。一个想知道"多模态模型怎么用起来"的人,不需要先搞懂 All Reduce 的通信量怎么估;反过来,一个真要训模型的人,66 屏又不够——他需要的是踩坑记录,不是示意图。这 66 屏处在一个尴尬的位置:对上一半读者太深,对下一半读者太浅。
这也是"面向所有人"的书必然的结局。前言里点名了四类读者:数据科学家和机器学习工程师、学术研究人员、在校学生、技术爱好者。这四类人的需求互相冲突——学生要推导,工程师要取舍,研究员要前沿,爱好者要能跑起来的例子。一本书想同时满足,最后就是每一段都写得"够用但不够狠"。
四、前言的三个承诺,兑现了两个半
p0002 是前言,我把它里面的承诺抄下来,逐条对账。
本书旨在提供全面而深入的技术与实践指南……既详细解释复杂算法的原理,又直观展示它们在现实世界中的具体应用。从基础到高级,从理论到实践,本书旨在成为连接两侧的桥梁。
第一个承诺,"全面"。这条兑现得不错。分词器、编码器-解码器、注意力、残差、损失函数、ViT、GPT-1 到 GPT-4、Codex、RLHF、RLAIF、稀疏专家、自编码器、VAE、CVAE、GAN、CLIP、Stable Diffusion、涌现、缩放法则、参数量估算、点对点通信、集群通信、数据并行、模型并行、混合精度、ZeRO、Hugging Face、GLM 系列、Adapter、Prompt Tuning、Prefix-Tuning、P-Tuning、P-Tuning v2、ChatGLM2 微调、NL2SQL。这份清单放在任何一本大模型教材里都不寒碜。
第二个承诺,"深入"。这条要打折。打折的证据是页数:1.3.2 节"ViT 模型架构"2 屏;3.3.2 节"CLIP 的训练与推理"4 屏;2.5.3 节"多模态架构"4 屏。一个架构用 2 屏讲,能讲到什么程度?大概就是"输入怎么切、位置编码怎么加、输出送到哪",再往下——patch 大小怎么选、位置编码用可学习还是正弦、预训练数据配比——都没有。对比之下,4.4.3 节模型并行给了 13 屏。同一本书里,讲并行比讲多模态细五倍。
第三个承诺,"连接理论与实践的桥梁"。这条只修到一半,而且桥墩是歪的。应用实战篇 136 屏,其中 68 屏是一个比赛的解题代码。真正讲"怎么把一个模型用到业务里"的,是 5.1 节(大模型落地应用 3 屏、领域工具增强 4 屏、提示词工程 10 屏)——17 屏,占全书 4.3%。
还有一个细节值得记下来:全书写"局限"的地方,比写"实战"的地方短得多。3.3.4 节"CLIP 的局限性"2 屏;3.2.3 节"实战:手写数字图像生成"7 屏。讲一个模型能干什么用 7 屏,讲它不能干什么用 2 屏。这个比例,在整本书里反复出现。
五、"实战"这两个字被用坏了
书里有七个带"实战"字样的小节:1.1.4 实战:日期转换(3 屏)、1.2.6 实战:日期转换(8 屏)、3.2.3 实战:手写数字图像生成(7 屏)、3.3.3 实战:图像文本匹配(4 屏)、3.4.5 实战:图像生成(7 屏)、5.3.6 ChatGLM2-6B 的 P-Tuning v2 微调(5 屏)、5.4.1 快速开始(7 屏)。合计 41 屏,占 10.3%。
我随手翻了其中两屏。p0360 是一整屏 Python,正在用正则从文本里抠股票代码和股票简称,一行行 re.search(r"(?:0|6|3)\d{5}", text),注释还是中文的;p0392 也是整屏代码,DocTree 那个类的 _parse_json、_is_valid_json、_identify_pattern 三个方法,逐行带 docstring。两屏,一个字的技术判断都没有,全是实现。
我不反对书里放代码。但代码不是实战。实战是"在什么约束下选了什么、放弃了什么、跑不通时怎么回退"。书里给的是可运行的片段,缺的是决策记录:为什么用正则抠而不是让模型抽?正则漏了怎么办?模型抽错了怎么兜底?这些问题在 26 屏 NL2SQL 和 17 屏 DocTree 里,我没看到答案。
再往下想一层:比赛代码的可迁移性有多高?这不是苛责,是判断题。一个特定赛题的解法,价值取决于它解决的是"通用难点"还是"这道题的特殊约束"。NL2SQL 的通用难点是"库表结构怎么塞进上下文、生成的 SQL 怎么校验、多表关联怎么拆";DocTree 的通用难点是"长文档怎么切、层级怎么还原、检索时怎么定位到节"。如果这 43 屏讲的是这些,那它值这个篇幅。但我翻到的两屏,一屏在讲怎么用正则从文件名里提日期和股票代码,一屏在讲怎么判断一行是不是合法 JSON——这是工程管道里的胶水,不是难点本身。胶水当然要写,但胶水不值得印在书上,因为它换个项目就作废。
最能说明问题的是 p0115 那句话。作者讲完 CVAE 的原理,写道:
至于 CVAE 的代码,我们就不在这里再实现了,感兴趣的读者可以自行尝试。
这句话本身没错,教材都这么写。但它暴露了这本书的详略标准:详略是按作者写起来方不方便定的,不是按读者用起来需不需要定的。同一个作者,能花 26 屏贴比赛代码,却在 CVAE 上省掉 5 屏。
反过来说,这本书有一个地方把"为什么"讲透了,值得单独拎出来:p0070,2.4.2 节"为什么要用强化学习训练"。作者先摆事实——大部分模型是一步到位、端到端的,即使是"预训练 + 微调"也只是两步,为什么 InstructGPT 要分三步、训三个模型?然后他自己提出三个可能的反驳:难道强化学习效果更好?还是单靠监督学习不够?接着回答:预训练完的 GPT-3 文本生成能力很强,但生成的结果只是更符合自然语言习惯,在数学上只是出现的累计概率更高,实际上可能并不符合交流的需要;给定一个问题的前文,模型可能回答问题,也可能生成一系列跟这个问题比较相关的新问题,还可能开始介绍这个问题的背景,这些都是遵循自然语言规律的有效延续;要改善,就得对前文做定制化,这叫"提示词工程",比如把"什么是 AIGC?"改成"问题:什么是 AIGC?回答:",但对只想提出问题或发布指令就能得到回答的普通用户来说并不方便。
这一段是全书最好的写作。它不是在解释一个技术,它是在解释一个技术为什么必须存在。可惜这种段落太少——399 屏里,我能数出来的不超过五处。
六、它给的判断里,我不同意的两处
第一处,分词那一节(p0006–p0009)。作者按 character、subword、word 三分法讲粒度,说 subword 相当于英文里的词根、前缀、后缀,比如 unfortunately 里的 un、fortun(e)、ly;然后说中文的分词算法经历了按词分、按字分、按子词分三个阶段,按词分可以用 jieba。最后给了表 1-1,把"Hello World!"拆成四个 token,ID 是 1、2、3、4,其中 2 号是空格。
这套讲法在 2020 年是标准答案。放到现在有点旧了:现在主流的中文模型基本走 byte-level BPE,词表十万级上下,分词器要解决的问题已经不是"选哪个粒度",而是"词表多大、多语言怎么覆盖、生僻字和代码怎么不炸"。用 jieba 当例子讲中文分词,会让人误以为中文模型的输入端还有一个"分词算法"要选。这不算错,算是没跟上。
第二处,5.3 节参数高效微调。这一节的结构是:Adapter Tuning(3 屏)、Prompt Tuning(1 屏)、Prefix-Tuning(4 屏)、P-Tuning(2 屏)、P-Tuning v2(2 屏)、ChatGLM2-6B 的 P-Tuning v2 微调(5 屏)。五节讲五种方法,最后落到"用 P-Tuning v2 微调 ChatGLM2-6B"。
讲得准不准?准。p0305 那两屏把 P-Tuning 的几个毛病列得很清楚:对规模较小的模型表现可以跟全量微调相媲美,但规模一小差距就大;在序列标注任务上的有效性未得到证明,因为序列标注要预测一系列标签,大部分标签没有实际意义;虚拟词元只插入模型最开始的嵌入层,输入序列长度有限,可调参数量也受限;模型层数多时稳定性难保证,第一层输入的提示词对后面层的影响越难预测。然后接 P-Tuning v2:借鉴 Prefix-Tuning 的思路,在 Transformer 每一层都增加可微调的前缀参数,并且移除了重参数化的编码器(Prefix-Tuning 里的 MLP、P-Tuning 里的 LSTM),出处是 arXiv 2110.07602。
但整节读完,我读不到一句"你该选哪个"。全书最需要判断的地方,它给的是清单,不是建议。举个具体的问题:手上只有一张 24G 的卡,要微调一个 6B 模型做序列标注,Adapter、Prefix-Tuning、P-Tuning v2 选哪个?书里给了五种方法的原理,唯独没给这张决策表。而读者买"微调"这两个字,买的就是这张表。
顺带说一句:这五节里没有 LoRA。至少章标签上没有出现。如果它在后面的章节才出现,那就是编排问题;如果全书真的没讲,那就是 2026 年读这本书最大的窟窿——今天做微调的人,第一个想到的就是 LoRA。
七、它的短板
前面几节零零散散说了不少,这里收拢成四条,一条比一条硬。
第一条,选题与书名错位。12.5% 对 87.5%。这不是"侧重"的问题,是名实的问题。一本叫《多模态大模型》的书,用超过一半的篇幅讲通用 Transformer 和 GPT 系列,用 16.5% 讲分布式训练,读者冲着封面上的"多模态"三个字付钱,翻开发现讲的是别的事。出版社给它起这个名,大概是看中了这个词的搜索量。这是我的推测,但 12.5% 这个数是硬的。
第二条,详略失衡到荒唐。一个比赛 68 屏,一个架构 2 屏;讲手写数字生成用 7 屏,讲 CLIP 的局限性用 2 屏。全书最长的单节是 5.5.4 NL2SQL,26 屏;第二长是 5.5.3 问题分析,19 屏;第三长是 5.5.5 DocTree,17 屏。三节加起来 62 屏,全在讲同一个比赛的解法。一本书把 15.5% 的篇幅交给一次比赛的解题过程,这个决定需要理由,书里没有给。
第三条,代码占版面,工程判断缺席。10.3% 的"实战"屏里,大部分是贴代码。代码有个特点:它只对当时那个环境成立,库一升级就作废。一本 41.9 万字的书,如果 10% 的篇幅是这种会过期的东西,它的半衰期就被自己拉短了。真正不会过期的,是"为什么这么写"——而这部分恰恰最少。
第四条,时间坐标停在 GPT-4。书里最新的参照是 GPT-4、ChatGLM2-6B、Code Llama、MiniGPT-4、AutoGPT。这些在写作当时都是最新的,问题在于:2026 年读,这已经是两代之前的东西。我不是说书该预知未来,我是说一本以"算法、应用与微调"为副标题的书,它的价值高度依赖技术坐标的新鲜度。坐标一旧,前面那 66 屏分布式训练还能站住(那部分原理稳定),后面讲 GLM 系列和 ChatGLM2 微调的几十屏,基本只能当历史读。
还有一条不算短板、但值得提醒:这本书没有作者简介页可查(我读到的 399 屏里没有)。前言只说自己"从学生到研究者再到实践者"。这对读者判断立场是个小损失——你不知道他在哪家公司、做过什么规模的训练。相比之下,机构署名的书至少能让你知道"这是谁的经验"。
如果只能再提一条,我提"没有失败"。399 屏里,每一个方法、每一次实战、每一个比赛,都是走通的。没有一个"我们试过 A 方案,花了三周,最后放弃了"的段落。这在教材里是常态,也是教材和实战记录的分界线。真实的技术工作里,八成时间花在失败的路径上;一本把失败全部剪掉的书,会让读者以为成功的路径是唯一的。对刚入门的人,这比详略失衡更危险——他会以为照书敲一遍就能跑,跑不通就怀疑自己。我读这本书的时候一直在等一句"这里我们踩过坑",等到最后也没等到。
八、谁该读,怎么读
三类人,三种读法。
在校学生,想系统过一遍大模型全栈:读,而且按顺序读。前 263 屏(第一篇算法原理)是一条完整的链路,从分词器到 ZeRO,中间没有大跳。读的时候把代码手敲一遍——不是复制,是敲,因为这本书的代码注释写得还算清楚,敲一遍能逼你看懂每个 mask 在干什么。
工程师,想上手多模态:别按顺序读,会浪费两天。直接翻四处:1.3 节 ViT(p0035–p0042)、2.5.3 多模态架构(p0082–p0085)、3.3 节 CLIP(p0135–p0145)、3.4 节扩散模型(p0146–p0172)。50 屏,两个小时能翻完。翻完你会有一个框架,但不会有能力——因为每一处都只有 2 到 27 屏,够搭骨架,不够填肉。
做产品或选题的人:读第 4 章和第 5 章的 5.1、5.3,跳过所有代码屏。第 4 章能让你知道训一个模型的钱花在哪(通信、显存、并行策略),5.1 那 17 屏能让你知道落地卡在哪(领域工具、提示词)。其余的,尤其是 5.5 那 68 屏比赛代码,跳过。
最后说一句我的整体判断:这本书的价值不在"多模态"三个字,在于它把从分词到 ZeRO 的整条链路铺了一遍,而且铺得不糊弄。它的问题也不是不用心,是太想服务所有人——四类读者、两个篇、十几个技术方向,最后每一段都停在"够用"这条线上。你如果冲着书名来,会觉得被骗了 12.5%;你如果把它当一本大模型通识教材来读,它值这个价。
补一句时间的账。这类书有一个共同的命运:写的时候追着前沿跑,出版的时候前沿已经挪了两步,读者买到手再读半年,能用的部分只剩原理。所以读它的正确姿势是倒着用——先看你最急的那一块,再看原理,最后才看代码。原理那部分(分词、注意力、并行、通信)五年不会变;代码和平台版本那一部分,明年就该扔。一本书能不能被反复翻,取决于你留给它的那部分是原理还是代码。
阅读记录:微信读书《多模态大模型:算法、应用与微调》,刘兆峰著,41.9 万字,推荐值 83.3%。浏览器逐页翻阅 399 屏,抓取 821 秒,到 5.5.5 节被判"章回环"停止(reached_end=false,end_reason=loop_chapter),第二篇图像生成、代码生成、LangChain 三章未读。逐字核对页码:p0002、p0006、p0030、p0070、p0115、p0180、p0220、p0280、p0305、p0360、p0392。屏数按阅读器章标签统计,误差在一两屏。2026-11-12。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: