
ChatGPT:读懂产业逻辑这本,比读懂技术的更有用
阅读提示:261 屏,我逐页翻完(reached_end=true,末页落在"系列丛书"页),把所有屏按章归了类,再用占比去检验书名。这篇不谈"ChatGPT 是什么"——那部分书里写得很浅,不值得转述;我谈的是它真正下了功夫的地方,以及它在哪里偷了懒。所有引句标了页码,可复查。
这本书的序言里有一句话,我读完就决定要认真对待它:
"尽管ChatGPT作为一种新技术对整个产业发展会有重大的推进意义,但是我们也不能忘记区块链、元宇宙等一次次科技热后的一地鸡毛。厘清ChatGPT的真正价值,看清它未来可能存在的机会,尽可能梳理清楚它可能的发展路径。"(p0006)
"科技热后的一地鸡毛"——2023 年上半年敢在序言里写这句话,说明作者不打算写一本吹捧的书。这给人一种期待:他要做的是降温,不是加温。
但 261 屏翻完,我的判断是:它确实没吹,但它也没能完全兑现那句"厘清真正价值"。它做到的是把 ChatGPT 放回一张产业坐标里,让读者知道自己在什么位置;它没做到的是给出任何可以独立验证的数据。前者很有价值,后者让这本书更像一份写得不错的行业综述,而不是研究。
一、它选的战场,不在技术
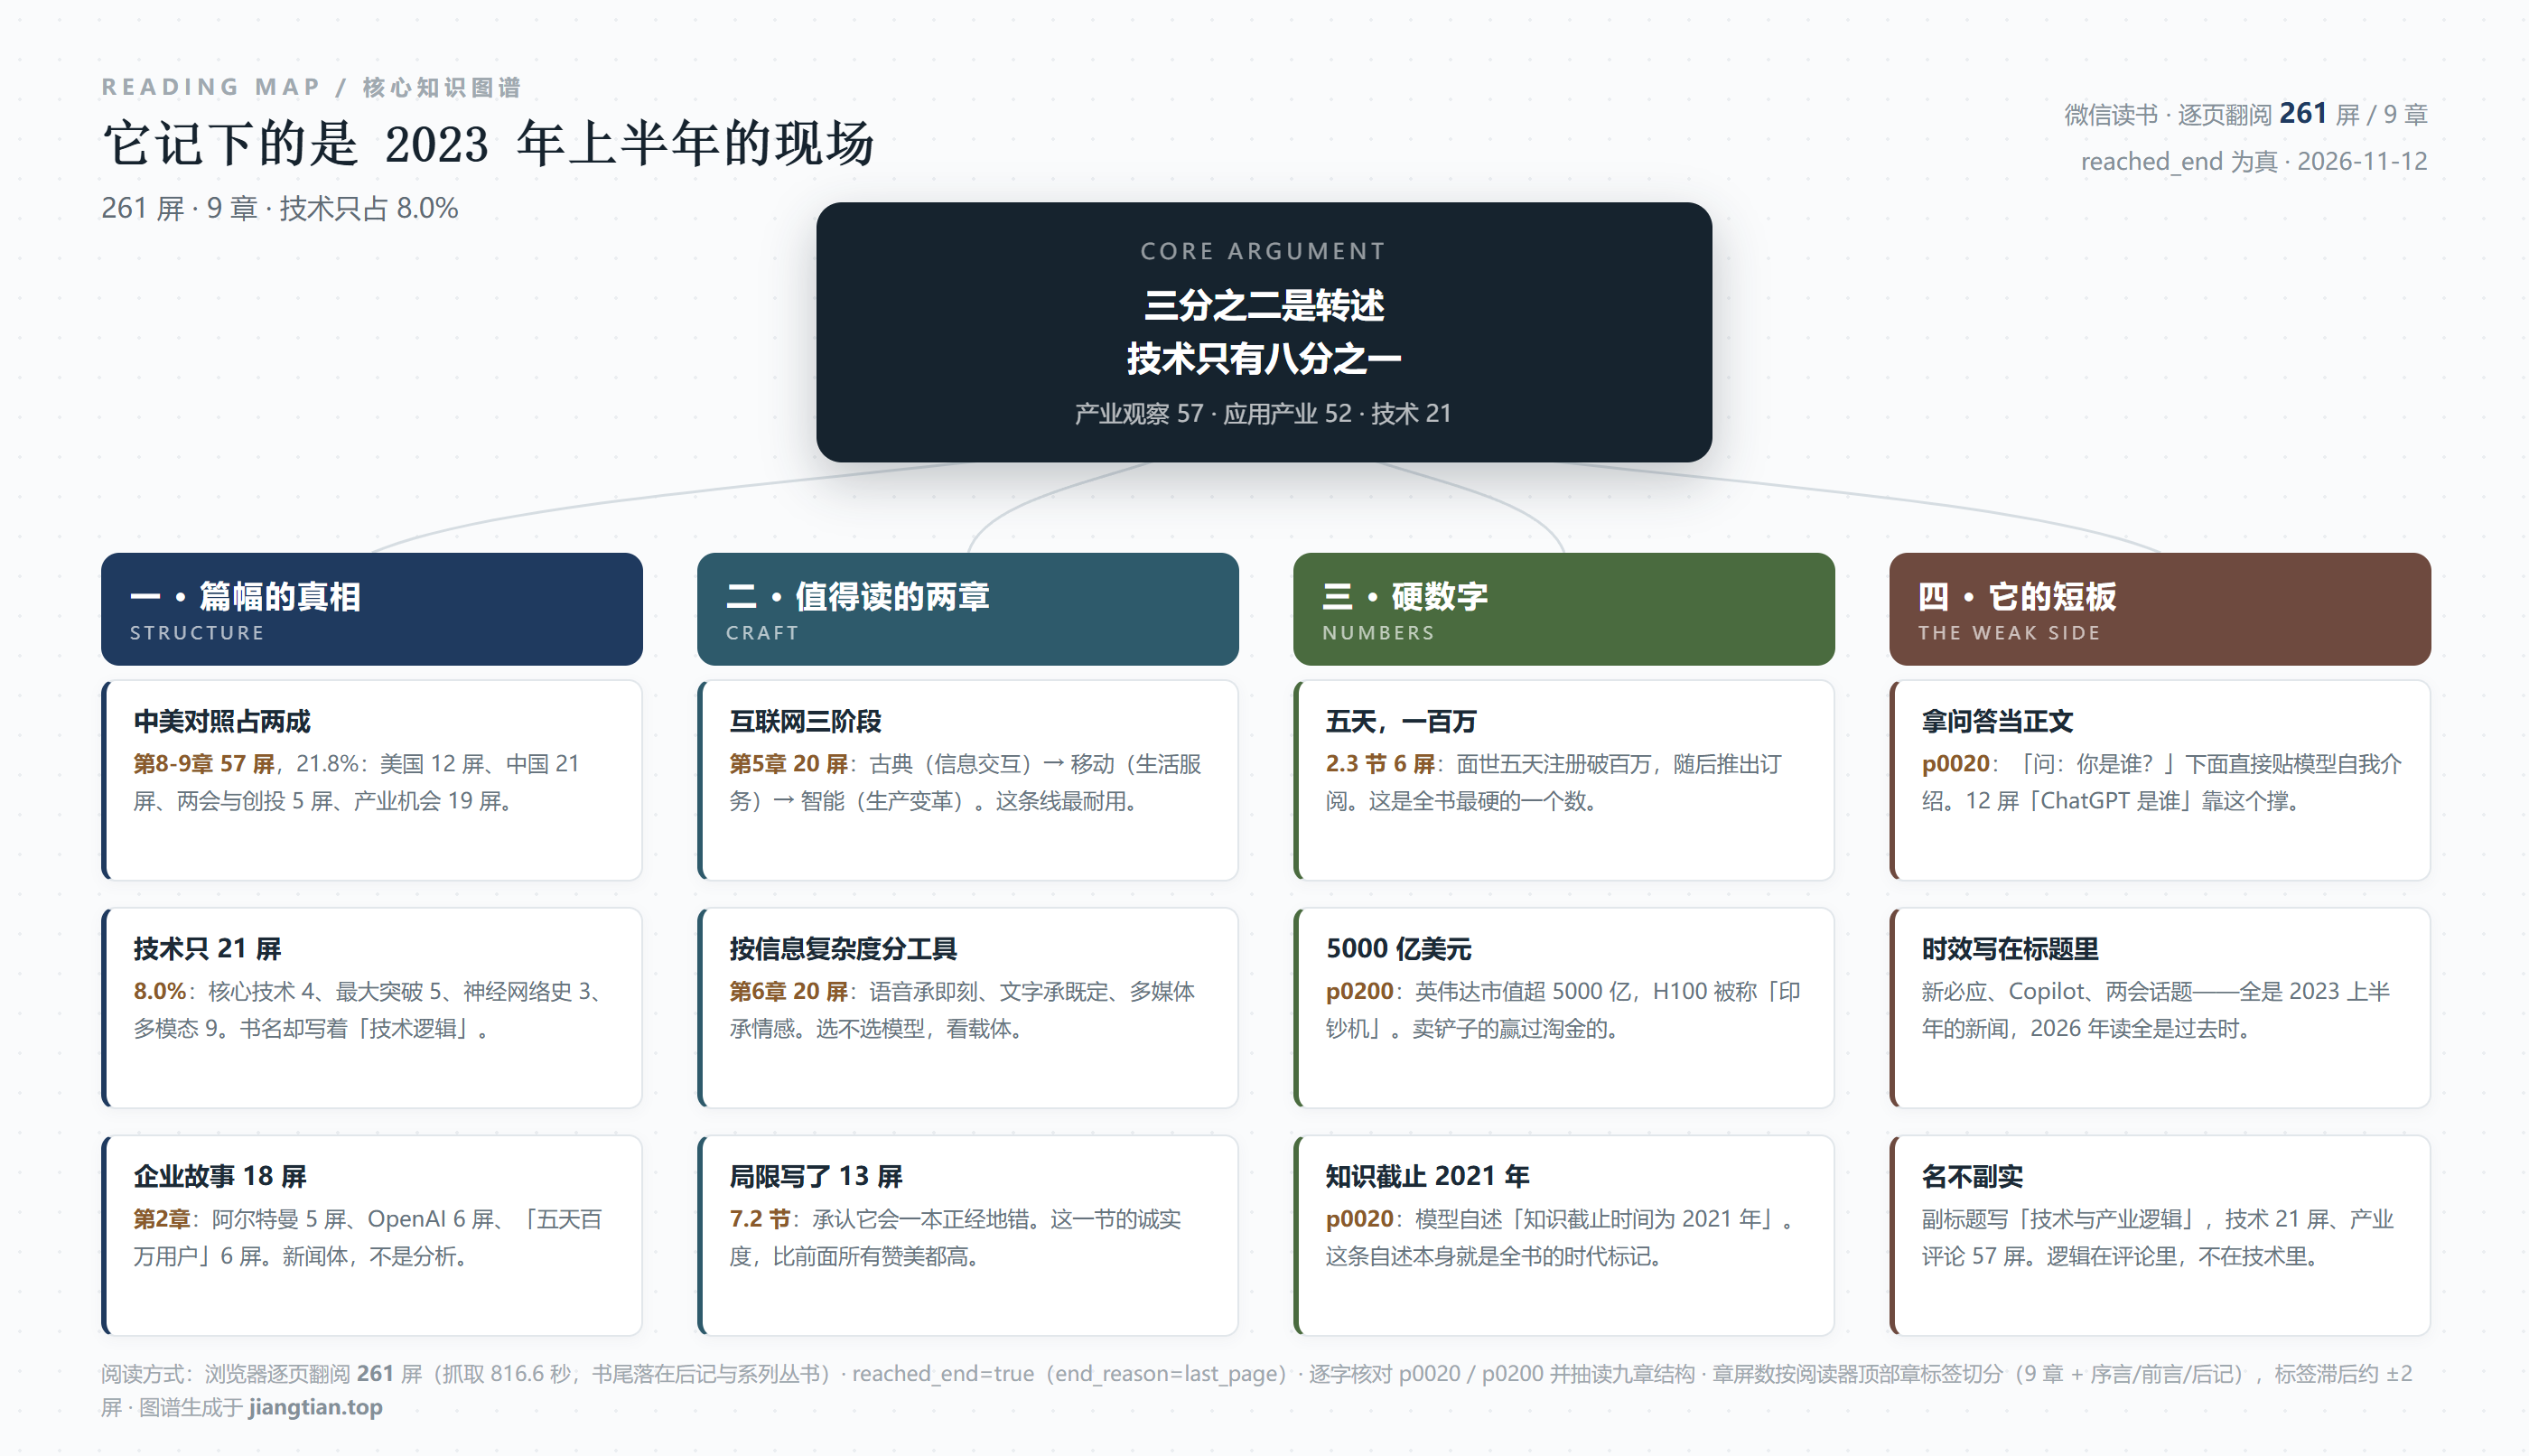
先看账面。261 屏,9 章,47 个章块。按章归类的占比是这样的:
第 1 章"认识ChatGPT"——33 屏,12.6%。
第 2 章"创始人及其发展历程"——24 屏,9.2%。
第 3 章"主要应用场景"——24 屏,9.2%。
第 4 章"潜在的产业化方向"——31 屏,11.9%。
第 5 章"从互联网三个阶段看历史地位"——22 屏,8.4%。
第 6 章"从复杂程度看信息特点"——21 屏,8.0%。
第 7 章"竞争力和局限性"——24 屏,9.2%。
第 8 章"中美两国产业界动态"——39 屏,14.9%。
第 9 章"中美AI产业发展比较"——22 屏,8.4%。
后记与丛书页——9 屏,3.4%。
前置(版权、序言、前言)——12 屏,4.6%。
把第 4、8、9 三章合起来看:产业化方向加中美动态加两国比较,92 屏,35.2%。这是全书最厚的一块,比讲技术的 78 屏(第 1、6、7 章,29.9%)还厚,更是讲应用的第 3 章(24 屏,9.2%)的近四倍。
这个配比说明了一件事:这本书的战场不在"ChatGPT 怎么用",而在"ChatGPT 让谁紧张"。它是一本产业观察,不是工具书,也不是技术书。
我认为这个选择是对的,理由很实际:2023 年上半年,讲"怎么用"的书三个月就过期,讲"谁在紧张、为什么紧张、紧张之后会做什么"的书能撑得久一点。作者选了后者,说明他清楚自己写的是什么。书名后半句"技术与产业逻辑"里,"产业逻辑"是主,"技术"是辅——这一点书里是诚实的,比很多同名书诚实。
但这个选择也解释了一个我一开始没想通的地方:为什么"主要应用场景"这么重要的一章,只给 24 屏?
第 3 章的四个小节是:聊天机器人、计算机程序的编写与调试、撰写报告、文学与艺术创作。每节 4 到 6 屏,结构都是"举几个例子 + 一张界面图"。比如"撰写报告"这一节,讲的无非是给个模板、让模型填空、再改一改;"文学与艺术创作"讲的是写诗、写故事、写文案。这些内容放在 2023 年上半年是新鲜的,放到今天就是常识。
作者显然知道这一点,所以他没有在这章多花篇幅——他知道这部分会最快过期,于是压缩到最低。这是一个理性的取舍:把有限的屏数投给"不容易过期"的部分。从"书的保质期"角度看,这个取舍是对的;从"读者当下能否用上"角度看,这个取舍是亏的。因为绝大多数人买这本书,要的恰恰是"怎么用",而书只给了 9.2%。
这就是我所说的"定位错位":它按"长期价值"分配篇幅,却按"当下需求"定价和命名。读者拿"工具书"的预期进来,得到的是"产业观察",落差感由此产生。这个落差不是质量问题,是期待管理问题,但它实实在在影响阅读体验——我翻到第 4 章时,已经意识到后面不会再教我怎么用了。
二、全书最好的一段:通用引擎与专用引擎
如果这本书只让我带走一个框架,我带走第 7 章的那个区分。
作者在第 7 章"ChatGPT发展过程中需要面对的问题"里,先给了一个判断:
"ChatGPT还是处于较早阶段,虽然其表现已经非常惊艳,让很多人震惊于其功能之强大,但是今天它主要还是一个聊天机器人,大部分人使用它,只是用它来当作玩具一般进行问题。"(p0179)
这句话在 2023 年上半年说,是有风险的。当时所有人都在谈"颠覆",作者写"玩具",等于逆着情绪走。但真正有价值的不是这句判断,是紧接着的解释——他提出了"通用引擎"与"专用引擎"的对立:
"人工智能如同一台专用的引擎,在一个个较小的范围里,解决一个个特定的问题,比如机器翻译、工业控制、智能交通管理、智慧电网等……但是,这些人工智能部署在一个较为封闭的体系里,针对某一特定的目的,小到一个机器臂的控制,大到一条生产线的管理,都是在一个封闭系统里进行的,并且采用的也是专用的智能引擎,专门对某种人工智能进行训练和处理。这种训练的数据量很少,训练的模型也较为简单,比较容易达到预期效果。"(p0179)
这个框架为什么好?因为它一句话解释了两件事,而且是别人很少连起来讲的两件事。
第一件,它解释了为什么过去六十年 AI 在工业界"用得挺好"却"看不见"。机器翻译、工业控制、智能电网,这些系统一直在跑,效果也不差,但它们藏在封闭体系里,只对一个目的负责,数据量小、模型简单、指标明确。这类系统不需要"通用",因为它的价值就在于"专用"——专用才能把误差压到可接受范围。你在一条产线上做视觉质检,模型只需要认那一种零件的那几种缺陷,它不需要会聊天。
第二件,它解释了 ChatGPT 的突破究竟突破了什么。不是"更聪明",而是"从封闭走向开放":训练数据从少量专有数据变成海量公开文本,任务从"一个特定目的"变成"任何用自然语言描述的目的"。这一步跨过去,能力就不再是线性的叠加,而是换了一个物种。
这个区分的实用价值在于:它能帮判断很多当下的争论。比如"AI 能不能替代医生"——按这个框架,读片这种专用任务,专用引擎早就能做,而且做得比通用模型稳;但"跟病人解释病情、安抚情绪、决定要不要告诉家属"这种任务,专用引擎做不了,通用模型能做但不保证对。分清任务属于哪一类,比争论"AI 行不行"有用得多。
可惜作者给了框架,没有把它用到底。全书后面 100 多屏谈产业,几乎没有再用一次"专用/通用"这个尺子去切具体行业。这是这本书最典型的毛病:好工具造出来了,只用了一次。
三、"三五年达不到 GPT-3.5",这句判断今天怎么看
第 8 章是全书最厚的一章(39 屏),讲中美两国产业界的动态。它的写法是:先讲美国企业的反应,再讲中国企业的探索,最后讲从两会到创投的热度。
最值得看的是"中国企业的突破与探索"这一节(p0205)。作者先把问题摆清楚:
"中国如何搭上人工智能的最新班车?ChatGPT是否开源,对中国企业开放到什么程度?在高成本持续训练中,未来数据的代价和条件会是什么?假如这一系列问题的答案由OpenAI等美国企业决定,中国互联网企业的人工智能发展之路无疑是被动的。"(p0205)
然后引了清华大学黄民烈的一句话:"中国必须要有自己的基座大模型、应用大模型。很简单,OpenAI关键模型不开源,只给API,中国还不能随便使用,已经是'卡脖子'了,所以我们为什么不做这样的事情呢?"(p0205)
接着是作者自己的判断:
"中国所面临的境况是:一方面,需要依靠国内的力量研发和迭代,这个过程或许很漫长,有可能三五年之内都无法达到GPT-3.5现有的水平;另一方面,作为用户需要忍受在这段爬坡的阶段,国内同款产品的体验将远低于ChatGPT。这和目前已经陷入瓶颈的芯片产业何其相似!"(p0205)
我要单独把这句话拎出来,因为它是全书最锋利、也最快过期的一句。
写这句话的时候是 2023 年上半年,"三五年之内都达不到 GPT-3.5"是一个相当悲观的估计。三年过去,这个判断被现实推翻了——国内基座模型的水准早就越过了 GPT-3.5 这条线。这不是作者的错,任何人在 2023 年春天做这种预测,命中率都不会高;但这恰恰暴露了这类书最根本的困境:它把"当下的差距"写成了"结构性的差距",把时间尺度上的落后写成了能力上的鸿沟。
更值得注意的是那个类比——"这和目前已经陷入瓶颈的芯片产业何其相似"。这个类比在当时很有说服力,因为芯片的困境是真实的、结构性的(设备、EDA、制程)。但大模型和芯片有一个关键差异,作者没有区分:芯片的瓶颈在物理产能和制造设备,突破需要长期资本开支;大模型的瓶颈在数据、算力和人才,这三样都能靠工程和迭代在较短周期内缩小差距。把一个"重资产、长周期"的产业和一个"轻资产、快迭代"的产业用同一个类比框住,会得出过于悲观的结论。作者写了"何其相似",但没写"哪里不同"。
这不是吹毛求疵。这类判断会直接影响读者的决策——如果一个做应用的人 2023 年读到"三五年达不到",他可能会放弃基于国产模型做产品。所以我把它归进"短板",而不是"时代局限"。
同一节里,作者还引了 OpenAI 的一份旧报告算力账:自 2012 年起,AIGC 模型训练所需算力大约每 3.4 个月翻一番(p0205)。这个数字是全书为数不多的硬指标,而且它比任何情绪化描述都更能说明"为什么这件事只有少数玩家能做"。可惜它只出现一次,后面再没被用来分析任何一家公司的处境。
我想多说一句这个 3.4 个月。它意味着算力需求每 3.4 个月翻一番——两年就是翻七次,四年翻十四次。任何按"买多少卡"做的预算,在这条曲线面前都会在两年内失效。所以"卡脖子"这件事的实质不是"缺卡",是"缺持续投卡的钱和电"——这才是那个类比真正成立的部分。作者引了这个数字,却没有把它推到这一步,很可惜:这是全书唯一可以长出一条完整推理链的地方。
四、互联网三阶段:一把能复用的尺子
第 5 章 22 屏,讲的是"从互联网发展的三个阶段看 ChatGPT 的历史地位和机会"。这一章的结构很清爽:
古典互联网——解决了信息交互能力,人和信息之间通了;
移动互联网——建起了生活服务体系,服务可以随时调用;
智能互联网——开始动社会管理和生产制造。
这个三段的划分不算原创(产业界早有类似说法),但作者用它做了一件对的事:把 ChatGPT 放在第三段里,而不是当成一个孤立的产品。这样一来,"ChatGPT 会不会颠覆一切"这个问题就被替换成了"它在第三段里扮演什么角色",后者是可以讨论的,前者只能站队。
第 9 章接着往下切,用了两个维度:支撑人工智能的基础能力,和产业的落地能力。前者讲通信、算力、数据,后者讲各行业的落地。这一章里有一段我划了线:
"对一个庞大的系统来说,AI最后成为一款应用产品,能够提升并改造传统行业,就不可能仅凭一个个的模型和算法来实现,它需要传统行业的配合和改造,也需要大量基础能力作为支撑。"(p0234)
这句话是全书最"不性感"也最正确的一句。它说的是:模型的胜负不在模型本身。一个行业要用上 AI,得先有通信把数据传出去、有算力把它训出来、有系统把它接进流程、有业务方愿意改流程。这四件事里,模型只占一件。
作者还专门解释了为什么"基础能力"要从通信讲起:
"通信是一切人工智能转化为应用服务的基础。任何人工智能,都需要用通信网络进行信息传输,把采集到的数据传送到云端,在数据中心进行存储,在智算中心进行训练,再把训练的结果用于各种产品的服务之中,在终端和网络上还需要通过边缘计算来降低传输时间。"(p0234)
这一段的价值在于它把"AI 竞争"从模型层拉到了基础设施层。按这个视角看,一个国家的 AI 实力不取决于有没有一个大模型,而取决于"数据能不能低成本地流动"。这才是"产业逻辑",也是这本书书名后半句真正兑现的地方。
五、它的短板
我把短板按"影响使用"的顺序排,不凑数。
第一,78 屏技术内容,没有一处推导。第 1、6、7 章合起来 78 屏讲技术:GPT-3.5 架构、Transformer、RLHF 与奖励模型、有监督微调的三步(p0034)、信息按语音/文字/多媒体分类(第 6 章)。这些都是"是什么",没有一处"为什么"。没有讲清楚为什么 Transformer 的注意力机制比 RNN 更适合长文本,没有讲清楚 RLHF 为什么能把"会说"变成"会答",没有讲清楚参数量、数据量、算力三者的换算关系。对一个想理解原理的读者,这 78 屏不够;对一个只想用产品的读者,这 78 屏又太多。
它卡在中间:比科普深一点,比教材浅很多。这个位置很尴尬,但也是大众书的常态——我不认为作者写不了,我认为是读者定位决定的。
第二,全书没有一处一手数据。这是最实质的批评。261 屏里,所有数字都有出处,但出处都是别人:黄民烈的访谈、OpenAI 的旧报告、媒体的标题、两会的提案。作者自己的调研、访谈、实测,一处都没有。
"五天注册破百万"是转引的(第 2 章);"三五年达不到 GPT-3.5"是判断,没有依据;"3.4 个月翻番"是引 OpenAI 的旧论文。这些引用本身没错,但一本叫"读懂产业逻辑"的书,如果全部证据都来自二手,它能提供的就只是"整理",不是"洞察"。整理有价值,但要认清它是整理。
第三,"紧张情绪"被当成了分析。第 8 章第一节的标题是"美国企业的紧张情绪和应对之策",39 屏的中美对比,大量篇幅在描述"谷歌倍感压力""周鸿祎表示企业搭不上这班车可能被淘汰"这类表态(p0006)。这类内容读起来很顺,但它不是分析,是舆情。
真正的产业对比应该看什么?看算力采购量、看人才流向、看开源生态的 star 数与下游依赖、看企业级 API 的调用增长。这些指标书里一个都没有。所以第 8 章虽然最厚(39 屏),信息密度却最低——它是"谁说了什么",不是"发生了什么"。
第四,时效性被低估了。书里最新的坐标是 GPT-3.5 和"新必应与Copilot"(第 2 章有一节专讲,p0064)。成书于 2023 年上半年,意味着 GPT-4 之后的所有进展都不在里面。对一本产业书,这个时效窗口只有半年,而书里没有任何一处提示"以下判断有保质期"——除了那句关于收费政策可能变化的免责(那是另一回事)。
我特别在意这一点,因为这本书的核心价值是"判断",而判断最容易被时间打脸。一个诚实的作者会在每章末尾标一句"此判断基于 2023 年 X 月的信息",这本书没有。
第五,好框架只用一次。前面说的"通用引擎/专用引擎",是全书最好的工具,但它在第 7 章出现之后,第 8、9 章谈产业时完全没被使用。同样,"互联网三阶段"这把尺子,在第 5 章用了一次,后面也没再用来切任何一个具体行业。
这是结构问题,不是能力问题。作者有能力造尺子,但没有把尺子带进后面的房间。读的时候会有一种感觉:前七章在搭概念,后两章在堆材料,两者之间少了一道工序。
第六,人物史占 24 屏,比应用章还多。第 2 章"创始人及其发展历程"24 屏,讲萨姆·阿尔特曼、讲 OpenAI、讲"五天注册破百万"、讲新必应与 Copilot。这一章的篇幅等于整个应用场景章(第 3 章也是 24 屏)。
我不反对写人。一家公司的组织方式、决策风格、和微软的关系,确实决定了它做出什么产品。但这一章的写法是"传记 + 大事记",不是"决策分析":它告诉你阿尔特曼是谁、OpenAI 怎么成立、用户涨得多快,但没告诉你为什么 OpenAI 敢在 2019 年把 GPT-2 完整版压着不发、为什么后来改成了有限开放、为什么要把营利实体套在非营利母体下面。这些才是"产业逻辑",而书里选择了讲"谁在什么时候说了什么"。
把这条和上一条放在一起看,这本书的偏科就清楚了:它在"人和事"上舍得花屏数(第 2 章 24 屏 + 第 8 章 39 屏 = 63 屏,24.1%),在"为什么"上很省。这不是一本懒书,是一本"重叙述、轻分析"的书。
六、什么人该读,什么人不该
该读的:做产业研究、投资判断、政策相关工作的读者。这本书用 261 屏给你搭了一张 2023 年上半年的产业地图:谁在紧张、卡在哪、基础设施缺什么、国内的差距在哪。它的价值不在结论(结论会过期),在于它提出问题的方式——把"AI 行不行"换成"它属于通用引擎还是专用引擎""它在互联网第几阶段""它依赖哪些基础能力"。这三个问法,今天依然好用。
不该读的:想学怎么用 ChatGPT 的人。应用只有 24 屏(第 3 章),讲聊天、写代码、写报告、文艺创作,每样几屏,全是举例,没有方法论。你花一下午读它,不如花一小时自己试。
要谨慎读的:想靠它判断"现在该投什么"的人。书里所有具体判断都带 2023 年上半年的时间戳,而那正是变化最快的半年。第 8 章关于国内"三五年"的判断已经被推翻,这提醒你:书里的其他判断也需要你自己复核一遍。
如果已经买了,我给一个读法,能把它剩下的价值榨出来:
第一步,只精读三处。第 7 章"通用引擎的局限"那几屏(p0179 附近)、第 5 章的三阶段(22 屏)、第 9 章"支撑人工智能的基础能力"(p0234 附近)。这三处是全书唯一在"造工具"的部分,其余都是在用工具或陈列材料。
第二步,把第 8 章当"舆情样本"读,不当"分析"读。它记录了 2023 年上半年中美两边的人在说什么、怕什么、喊什么。这批材料本身有价值——三年后再看,你能对照出哪些喊话兑现了、哪些没兑现。但别拿它当判断依据。
第三步,自己补数据。书里缺的一手数据,你自己去查:算力采购、开源模型的下载量、企业 API 的调用增长。查完再回来看第 9 章的判断,你会对"哪些是靠得住的推理、哪些是转述"有更清楚的感觉。这一步做完,这本书对你就从"读物"变成了"索引"。
第四步,把它的判断标上时间戳。凡是书里出现"未来""几年内""有可能"的句子,旁边写上"2023 上"。这一条不是为了嘲笑作者,是为了训练自己——所有产业判断都有保质期,养成为判断标时间的习惯,比记住任何结论都值钱。
七、一句收尾
这本书最值钱的地方,是它敢在 2023 年春天说"今天它主要还是一个聊天机器人",并且用"专用引擎 vs 通用引擎"把这个判断讲成了可复用的框架;最可惜的地方,是它把这个框架造好之后就放下了,后面 100 多屏的产业分析,靠的是媒体标题和企业家表态。
它是一份写得诚实的行业综述,但不是它自己声称的"产业逻辑"——逻辑需要推导,而这本书更多的是排列。读它,把它当一张 2023 年的地图;别把它当地图册,因为地图会过期,问法不会。
阅读记录
书名:ChatGPT:读懂AI爆发背后的技术与产业逻辑 | 阅读方式:微信读书网页版逐页翻阅
261 屏,抓取耗时 816.6 秒,reached_end=true(end_reason=last_page),末页落在"系列丛书"页
结构:9 章 + 后记 + 丛书页,47 个章块;产业类(第4/8/9章)92 屏占 35.2%,技术类(第1/6/7章)78 屏占 29.9%
核对页码:p0006(序言/前言)、p0034(核心技术)、p0179(通用引擎与局限)、p0205(中国企业突破/三五年判断/算力翻番)、p0234(基础能力)
说明:章屏数按阅读器顶部章标签切分,标签刷新滞后约 ±2 屏;成书于 2023 年上半年,正文最新坐标是 GPT-3.5 与"新必应"。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: