
想把大模型跑在自己电脑上,却卡在量化和显卡兼容?这个引擎一条命令装完(4.3 万星)
github监控器 · 2026-11-10 · 约 2648 字 · Niko1221/Strata
你想在自己电脑上跑大模型,一路上有四道坎:装环境、选量化、算显存、配接口。
Strata 把这四道坎压成一条命令:装完就能在桌面或终端里跑,不需要账号,不需要云。
4.3 万星,每天涨 895 星,C++ 写的,MIT。它只做一件事但做得深:把 Qwen3.8-Flash-Next 这类模型跑到"消费级硬件"上。下面讲量化怎么选、显存怎么估、以及几个官方没写的坑。
一、先说结论:它把"该选哪个量化"替你决定了
本地跑模型最劝退的不是安装,是量化档位表——Q2_K、IQ3_XXS、Q4_K_XL、Q8_0……十几个名字,每个对应不同的显存和不同的质量损失。
Strata 的做法是:给出推荐组合,把选择收敛到两三档。
README 里明确写了推荐顺序:先看 ISTADASLab,其次 Unsloth 等提供方,在"兼容的模型装得下"的前提下选。
二、量化档位:一张能直接用的表
从 README 的 Model 表里整理出来(同一模型,不同提供方给不同量化):
怎么读这张表:数字越小越省显存、越笨;越大越聪明、越占显存。IQ 系列是同尺寸下质量更好的变体,代价是解码稍慢。
我的建议路径:先用 IQ3_XXS 跑通,确认能用;再换 UDQ4_K_XL 看质量提升值不值。一上来就上 Q8 会因为装不下而怀疑人生。
三、装:Windows 和 Linux 两条命令
Linux / 类 Unix:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh && sh install.shWindows: 用 Release 里的 install.ps1 脚本,在 PowerShell 里执行(就是下面这一行):
irm <release 地址>/install.ps1 | iex两条路径都是"下载最新 release 里的安装脚本并执行"。方便,但有两个前提:
- 你要能访问 GitHub Releases。 国内网络经常卡在这一步;
- 你要信任这个脚本。 下载即执行,中间没有检查。
如果你对第二点敏感,就手动下 release 包,看一眼脚本再跑。这是纪律问题,不是技术问题。
四、跑起来:两条路径
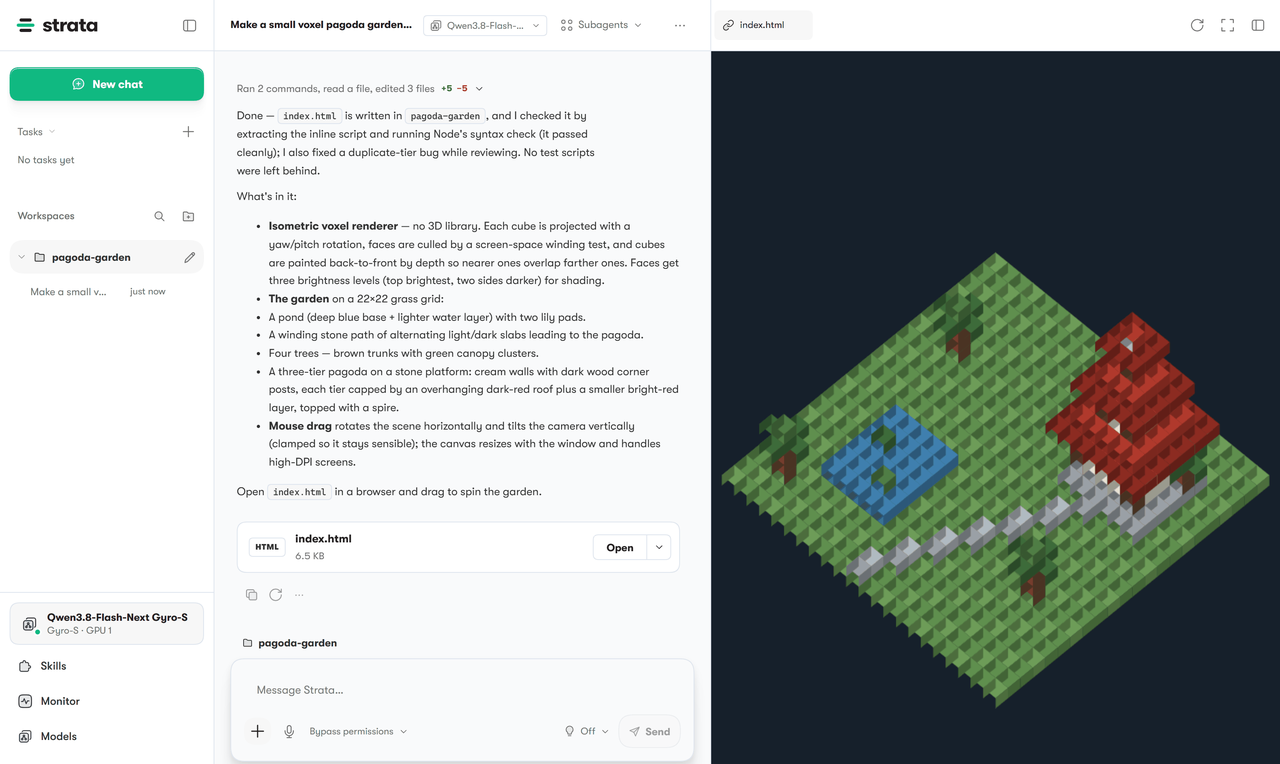
路径一:桌面应用。 装完打开,选模型、选量化、开聊。适合"我就想用"。
路径二:终端。 适合自动化和脚本:
strata launch带参数可以指定模型族和量化,并且先"试算"再真跑:
strata launch --family deepseek41 --model ist-das-2.00bpw --plan那个 --plan 很值得用。它不真跑,只告诉你:这套配置要多少显存、能不能装下、预计速度多少。
这是本地部署最该有的功能。大部分人失败是因为"下完 20G 才发现装不下"。
养成习惯:任何新模型,先 --plan,再下载。省的不是时间,是带宽和耐心。
五、显存怎么估:三个数决定一切
不管用哪个引擎,估显存就三个数:
举例:一个 30B 模型用 Q4 量化,权重约 15GB。再加 32K 上下文的 KV cache(几 GB),加上运行时开销,24G 卡刚好,16G 卡不行。
所以"我的卡能跑多大模型"这个问题的正确问法是:"我这个上下文长度 + 这个量化,能跑多大"。
六、六个坑
- 直接上 Q8。 装不下,或者装下了但速度慢到没法用;
- 不看
--plan就下载。 几十 GB 白下; - 在 Windows 上用 sh 脚本。 两条路径别搞混;
- 以为量化只掉质量不掉速度。 低比特解码通常更慢,因为要做反量化;
- 忽略显卡架构。 老卡可能不认某些量化格式(README 的 Hardware 一节有说明);
- 把它当 ChatGPT 替代。 本地模型的能力上限摆在那儿,别期待过高。
第四条是反直觉的:很多人以为"量化 = 更快",实际上低比特往往更慢——省的是显存,不是算力。
七、它能接进你的编程工具吗
项目描述里提到它兼容 OpenAI / Anthropic 风格的接口,意味着可以当"本地模型后端"给编辑器用。
实际用法大概是:起本地服务 → 在编辑器里把 base URL 指过去。具体端口和路径看 README 的 Tools 一节。
这条路的吸引力在于:不花钱、不联网、数据不出机器。代价是模型能力弱一档,长上下文容易崩。
八、适合什么场景
九、为什么"一条命令"很重要
本地推理这件事,技术早就成熟了。劝退人的一直是工程摩擦:装 CUDA、编 kernel、下模型、配参数、调显存。
Strata 的贡献不是发明了新技术,是把这五步压成一步。这也是这两年开源项目的共同趋势:赢在"少让你做决定"。
十、和其它本地方案的区别
选哪个取决于你要"能跑"还是"能调"。要能跑选 Strata/Ollama,要能调选 llama.cpp。
十一、版本与地址
install.sh | |
install.ps1 | |
形态: 本地推理引擎(桌面 + 终端)
许可: MIT
推荐模型: Qwen3.8-Flash-Next / Qwen3.6-35B-A3B
安装: install.sh(Linux)/ install.ps1(Windows)
关键命令: strata launch --plan最后一句:本地跑模型这件事,真正的门槛从来不是算力,是耐心。Strata 省的是耐心。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: