
AI 写的代码越堆越多、越改越乱?这个技能让 agent 学「最懒的老程序员」(18.8 万星)
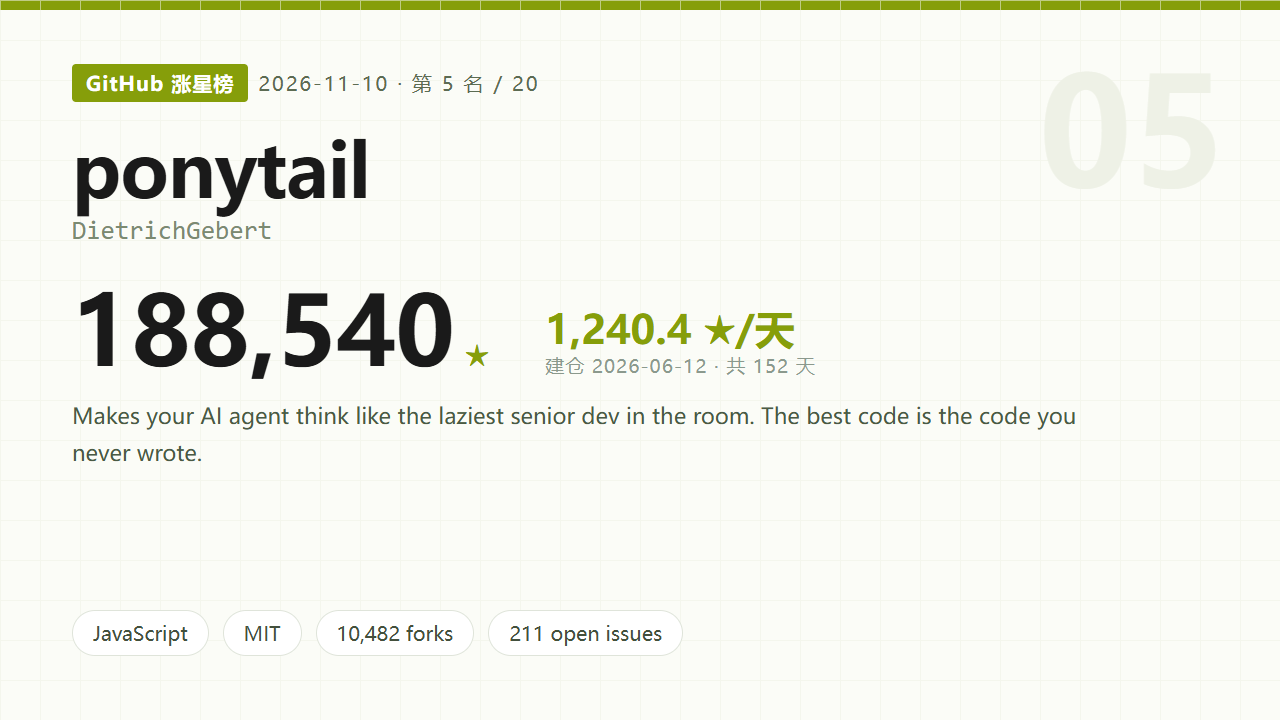
github监控器 · 2026-11-10 · 约 3161 字 · DietrichGebert/ponytail
你的 agent 很勤快:一个问题给你五十行。问题就在这五十行里。
Ponytail 干的事是反过来的:让 agent 像公司里那个扎马尾的老程序员——不说话,把你五十行换成一行,然后它能跑。
18.8 万星,每天涨 1240 星。它给了一组很硬的数字:代码少 53%、时间少 41%、成本少 26%、token 少 45%,而有风险的逻辑里 98% 带测试(不用它的时候是 68%)。下面讲它怎么做到的、怎么装、什么时候别用。
一、先说结论:它治的是「过度实现」
AI 写代码有个稳定倾向:你问一个小问题,它给你一套架构。
要个日期格式化,它给你一个带 locale 支持的工厂类;要个去重,它引入一个依赖。每一次都"更工程化",合起来就是你没时间维护的一堆抽象。
Ponytail 的全部主张就一句:最好的代码是你没写的代码。
它不是让 agent 变懒,是让它先判断这件事值不值得写代码。能删的删、能用的标准库用、必须写的才写。
二、那组数字是怎么来的
README 给了一张对照表,我把口径说明也带上了——因为不看口径,数字会误导:
最后一行是关键。很多人以为"少写代码"= "偷工减料",它反过来了:代码少了,但该测的地方测得更全。
原因不难理解:代码少了,给每个分支写测试的成本就低了。你写两百行要写二十个测试,写二十行只需要写五个,于是你愿意写。
这个逻辑值得单独记住:测试覆盖率低,往往不是态度问题,是代码太多。
三、它凭什么让模型"变懒"
它不是新模型,是一个技能——一段被注入到 agent 上下文里的行为约束。
README 里专门有一节叫 "The prompt",意思是:核心就是那段提示词。技能的本质不是代码,是把一套判断标准塞进模型的决策过程。
它约束的东西大概是这样几类:
- 先问"这需要写吗"——能删、能配、能用现成的,就不写;
- 再问"能不能更短"——同一个功能,先想最短的实现;
- 不许自作聪明——不加没被要求的抽象、不加"以后可能用得上"的扩展点;
- 该测的必须测——省下的代码量换成测试覆盖。
这四条合起来,就是那个"老程序员"的画像:他不是不会写复杂的东西,是他知道复杂的东西以后要还债。
四、装:一行插件命令
Claude Code 里:
/plugin marketplace add DietrichGebert/ponytail
/plugin install ponytail@ponytail
Codex 里:
codex plugin marketplace add DietrichGebert/ponytail
codex plugin add ponytail@ponytail
它支持的面比想象中广。仓库根目录里这些目录说明了它适配哪些宿主:
这个"一个仓库适配一堆宿主"的结构,本身就是可以抄的工程做法:核心提示词放一份,各宿主只放一个指向它的入口文件。
五、效果验证:怎么自己复现一遍
README 提到它的基准是:Claude Code,Opus 5.5,39 个任务,每个跑 5 次,其中包含一个真实的 FastAPI + React 仓库。
这个设计有两点值得学:
- 同一个 agent,装和不装各跑一遍。 控制变量,只变技能这一个因素;
- 每个任务跑 5 次。 单次结果噪声太大,5 次才能看出趋势。
你要自己验证,我的建议是缩小规模:挑你手上三个真实任务(不是玩具题),装前跑一遍、装后跑一遍,记录行数、耗时、以及"有没有多加不需要的东西"。
别只看行数。行数少了但改起来更费劲,说明它省错了地方。
六、五个边界:它不解决的问题
这类"让 AI 少写"的技能,最容易踩的坑是用错场景。
第三行和第五行的区别值得说清楚:它是"够用主义",不是"教学工具"。你想学怎么写好,别用它;你想赶紧把事做完,用它。
七、把它当"评审标准"用,比当"生成器"更值
这是我自己的用法建议:别只在写代码时开它,在 review 时也开。
让它读一遍你(或别的 agent)刚写的代码,只问三个问题:
- 这段里有没有哪一行是没人要求的?
- 有没有哪个抽象只被调用了一次?
- 如果删掉一半,功能还完整吗?
三个问题问完,通常会掉 20%–40% 的行数,而功能不变。这比"让它重写一遍"安全得多——重写会引入新 bug,删减不会。
顺序很重要:先让它生成,再让它删。反过来(先删再生成)会打架。
八、七个坑,按踩到的概率排
- 用在不该用的项目上。 需要扩展性的骨架项目,被它砍成一次性脚本;
- 只看行数不看可维护性。 行数降了,但逻辑压成一行嵌套三元,更难读;
- 不给边界。 不告诉它"哪些不能删",它会把你的兼容层一起优化掉;
- 和别的技能打架。 你还装了"架构优先"类的技能,两个约束会互相抵消;
- 在 review 里直接采纳。 它的删减建议也要人看,尤其涉及错误处理;
- 指望它提升正确率。 它优化的是量和成本,不是"写对";
- 版本差异。 README 里明确写了 v5 是重建版,v5.3 还加了新东西——看文档时注意版本号,别拿 v4 的说明套 v5。
九、为什么"懒"是个好设计目标
软件工程里有个老观察:代码是负债,不是资产。 每多一行,就多一行要读、要测、要改。
AI 把这个负债的生成速度提高了十倍,但清理速度没变。所以现在最稀缺的能力不是"写出来",是"不写"。
Ponytail 抓住的正是这个转折点。它不提升模型能力,它改变模型的默认倾向——而从"倾向多写"改成"倾向少写",效果比换一个更强的模型更直接。
十、谁该装
十一、和"自己写 system prompt"的区别
你可能会想:这不就是一段提示词?我自己写不行?
可以,但三件事它替你做了:
所以它的价值不在"那段话多神",在于它是一个被验证过、且跟着模型迭代的约束包。
十二、地址与版本汇总
/plugin marketplace add DietrichGebert/ponytail |
包名: @dietrichgebert/ponytail
版本: 5.3.3
许可: MIT
核心: 一段行为约束提示词 + 多宿主适配
效果: 代码 −53% / 时间 −41% / 成本 −26% / token −45%,风险逻辑测试率 98%
最后一句:这个项目最值钱的不是那 53%,而是它证明了一件事——给 agent 加一条"能不写就不写"的约束,比给它更多工具更能提升产出质量。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: