
想用前沿模型又不想掏钱?这个 dsh 插件声称不登录、不填 Key(6.9 万星)
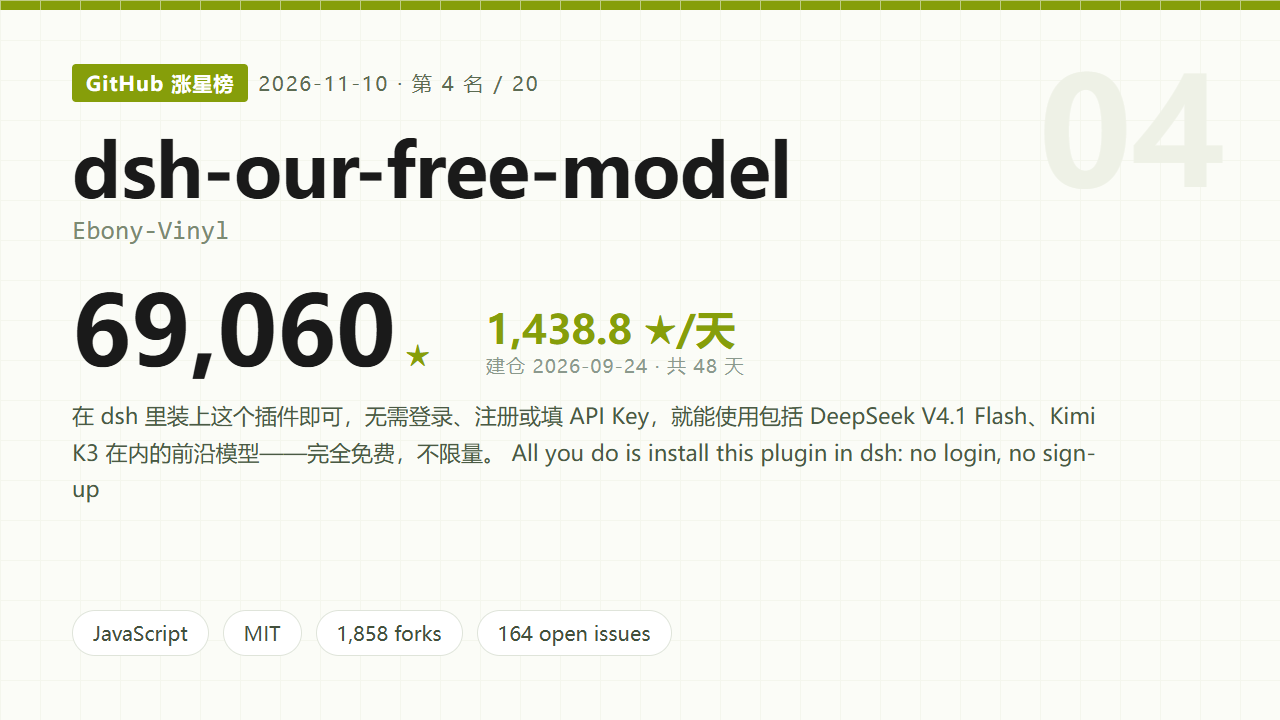
github监控器 · 2026-11-10 · 约 3421 字 · Ebony-Vinyl/dsh-our-free-model
你想用前沿模型,但一个月几十美金的订阅让你犹豫;你想试几个不同家的模型,但每家都要注册、绑卡、填 Key。摩擦全在"开始用"这一步。
这个插件声称把这一步删了:装在 dsh 里,不登录、不注册、不填 API Key,直接用。
6.9 万星,每天涨 1438 星。但"免费"这两个字背后一定有代价,我把它的 README 从头到尾看了一遍——包括它自己写的"已知边界"——这篇把机制、装法、和代价一起讲清楚。
一、先泼一盆冷水
这个项目的 README 里确实写着"完全免费,不限量"。但同一份 README 里也写了已知边界一节,还列了一堆 issue 编号。
所以正确的读法是:它解决的是"开始的摩擦",不是"永远免费"。
这句话怎么理解?你自己注册三家模型、绑三张卡、管三个 Key,第一次跑通大概要一小时。这个插件把这一小时变成一条命令。至于这条路能走多久,取决于它背后的渠道策略,不由你控制。
把期待放在这个位置,你会觉得它很好用;放在"永久免费的前沿模型",你会失望。
二、它到底是什么:一个 dsh 插件
不是独立软件,是 DeepSeek Harness 的插件。所以前置条件还是那个:先有 dsh。
node --version   # >= 24.9.0
npx @deepseek-ai/dsh web
package.json 确认身份:
"name": 与 dsh-our-free-model 相关
"version": 见仓库 releases
"license": "MIT"
零依赖
它自己在 README 里打的两个标签:零依赖、MIT。零依赖这件事对插件很重要——依赖少,随 dsh 版本升级时崩的概率就低。
装法在 README 的"安装"一节,桌面版还有 macOS 的社区构建包。装完你会看到一个和 dsh 原生界面几乎一样的窗口,只是模型列表变了。
三、它凭什么"不填 Key"
这是全文最需要说清楚的一段。它不生产模型,它做的是聚合与路由。
README 里给了几个模块,我把它们翻译成人话:
看清楚这张表你就明白它的商业逻辑了:它不是在送模型,它是在做路由层。
路由层的价值在于:当某个渠道失效,它能切到下一个。这也是为什么它要专门做"命名降级链"——这是整个项目的核心工程。
降级链有个隐形成本:你发出去的内容会经过多个渠道。如果内容敏感,你可能不希望它被"顺次试"到第三家。这一点它没法替你判断。
四、装完怎么用:三条路径
路径一:直接在 dsh 的界面里用。 装完重启 dsh,模型列表里会多出这些条目,选一个开始聊。
路径二:接别的客户端。 它起的是本地网关,兼容 Anthropic 原生接口,所以别的工具也能连:
# 指向本地网关(端口以它启动时打印的为准)
export ANTHROPIC_BASE_URL=http://127.0.0.1:<端口>
export ANTHROPIC_API_KEY=<占位值>
这一步的意义很大:你的编辑器插件、命令行工具,只要支持自定义 base URL,就能用上这套路由。
路径三:多开。 README 提到"多开账号、看额度"这类能力,深层意思是让你把多个渠道当成一个池子用。
五、README 里最值钱的一段:三个真实踩坑
大部分项目 README 只讲功能。这个项目的 README 专门写了一节"三个实际消耗过调试时间的内核行为",这是全文信息密度最高的地方。
坑一:它按 body 的形状读响应,不看 Content-Type。
为什么?因为聚合层后面的渠道五花八门,有的把 JSON 标成 text/plain,有的把错误也返回 200。按 header 判断会误判,按 body 结构判断更稳。
对你的影响:如果你自己写中间件去改它的响应,别动 body 的结构,动了它就认不出来。
坑二:速度那一栏会显示 —。
原因是没有流式的第一 token 时间可测,或者渠道没回 usage。这不是 bug,是渠道能力差异。看到横杠不代表它坏了。
坑三:长思考被截断后会自动恢复。
README 里对应 issue #12。模型思考链太长被截断时,它会重发并接上,而不是直接给你半截答案。这个处理很多人以为是模型能力,其实是插件做的。
我把这三条单独拎出来,是因为它们说明作者真的在用这个东西,而不是发个 README 就完事。
六、它自己承认的"已知边界"
这一节是我决定写这篇文章的原因。一个声称"完全免费"的项目,在 README 里老老实实列边界,这很少见。
按它列的边界,归纳成四类:
第三行我要再说一遍:任何"不限量"都不是技术承诺,是商业策略。策略会变,而且不通知你。
七、七个坑,按踩到的概率排
- 没装 dsh 就装它。 它是插件,宿主不在就是一堆文件;
- Node 版本低。 宿主 dsh 要 24.9+,插件跟着一起要求;
- 只配一条渠道。 那条挂了就全挂,降级链是它的核心价值,别浪费;
- 拿它跑生产流量。 渠道不受你控制,延迟和可用性都没保证;
- 敏感内容直接发。 降级链会试多个渠道,你要接受这个前提;
- 改响应 body 结构。 它按 body 形状判断,改了会解析失败;
- 看到"—"以为坏了。 那是速度不可测,不是错误。
八、合规与风险:必须自己判断的三件事
这一节没有标准答案,但我必须把它摆出来。
第一,渠道的合法性。 插件本身是 MIT 开源的路由器,但它连的那些来源是不是都合规,不由它保证。你自己用,责任在你。
第二,数据的去向。 你的 prompt 会经过一个或多个第三方渠道。写公司代码、贴客户数据之前,先想清楚。
第三,稳定性预期。 这类项目的生命周期取决于上游策略。今天能用,不代表下个月能用。
我的建议:把它当"试用通道"和"降级备份",不要当主力。主力还是自己付费、自己控 Key 的那种——贵,但你说了算。
九、为什么它能一天涨 1400 星
三个原因,按重要性排:
- 它删掉了最大的摩擦。 不注册、不绑卡、不填 Key——这三步劝退的人比价格劝退的还多;
- 它寄生在一个正在爆发的生态上。 dsh 一天涨 3000 星,它的插件自然跟着涨。这是生态红利;
- 它的 README 写得好。 有边界、有踩坑、有 issue 编号、有验收状态。技术人对"敢说缺点"的项目天然信任。
第三条值得所有开源作者学:把缺点写清楚,比把优点写漂亮更能涨星。
十、谁该装,谁别装
十一、和"自己配 API"的成本对比
很多人会问:我自己注册几家、配 Key,不也一样?
这张表的结论很清楚:它省的是时间和摩擦,代价是可控性。选哪个取决于你在做什么——试玩选它,干活选自己配。
十二、地址与版本汇总
版本(截至 2026-11-10):
形态: dsh 插件
许可: MIT
依赖: 零依赖
渠道: 内置 76 家提供商
要求: Node >= 24.9.0(跟随 dsh)
macOS: 有社区构建的桌面安装包最后一句实在话:这类插件真正的贡献不是"免费",而是它把 LLM 接入做成了可降级的路由层。这个设计以后会变成标配——你现在看它,是在提前看明年的基础设施长什么样。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: