
Happy-LLM:从零开始构建大模型,只兑现到第 5 章
微信读书《Happy-LLM:从零开始构建大模型》· 抓取 325 屏 / 7 章 / 106 条目录 · 读到书尾
逐字核对 9 屏 · p0006 书名条核对为本书 · 2026-11-10
抽样点位的选法:这本书按「先理论后动手」排(NLP → Transformer → PLM → LLM → 手搭 LLaMA2 → 框架训练 → 应用),我顺着这条线一节点一屏:p0006(前言里的全书分工)、p0065(2.3.1 嵌入层转 2.3.2 位置编码)、p0148(4.2 数据并行转模型并行)、p0175(5.1.3 GQA 与旋转嵌入)、p0225(第 6 章预训练的超参表)、p0250(6.1.2 加载 Qwen2.5-1.5B)、p0300(7.2 图 7.3 RAG 流程)、p0315(7.3.3 用 SiliconFlow 调 Qwen2.5-32B)、p0325(末页推荐值)。重点压在三个地方:一是「从零」这两个字覆盖到第几章;二是代码到底在书里还是在书外;三是训练那一章给了旋钮有没有给刻度。抽读 9 屏约占 2.8%。各章篇幅是用 pages.jsonl 的逐页章节映射做的全量聚合,不是抽样估的。
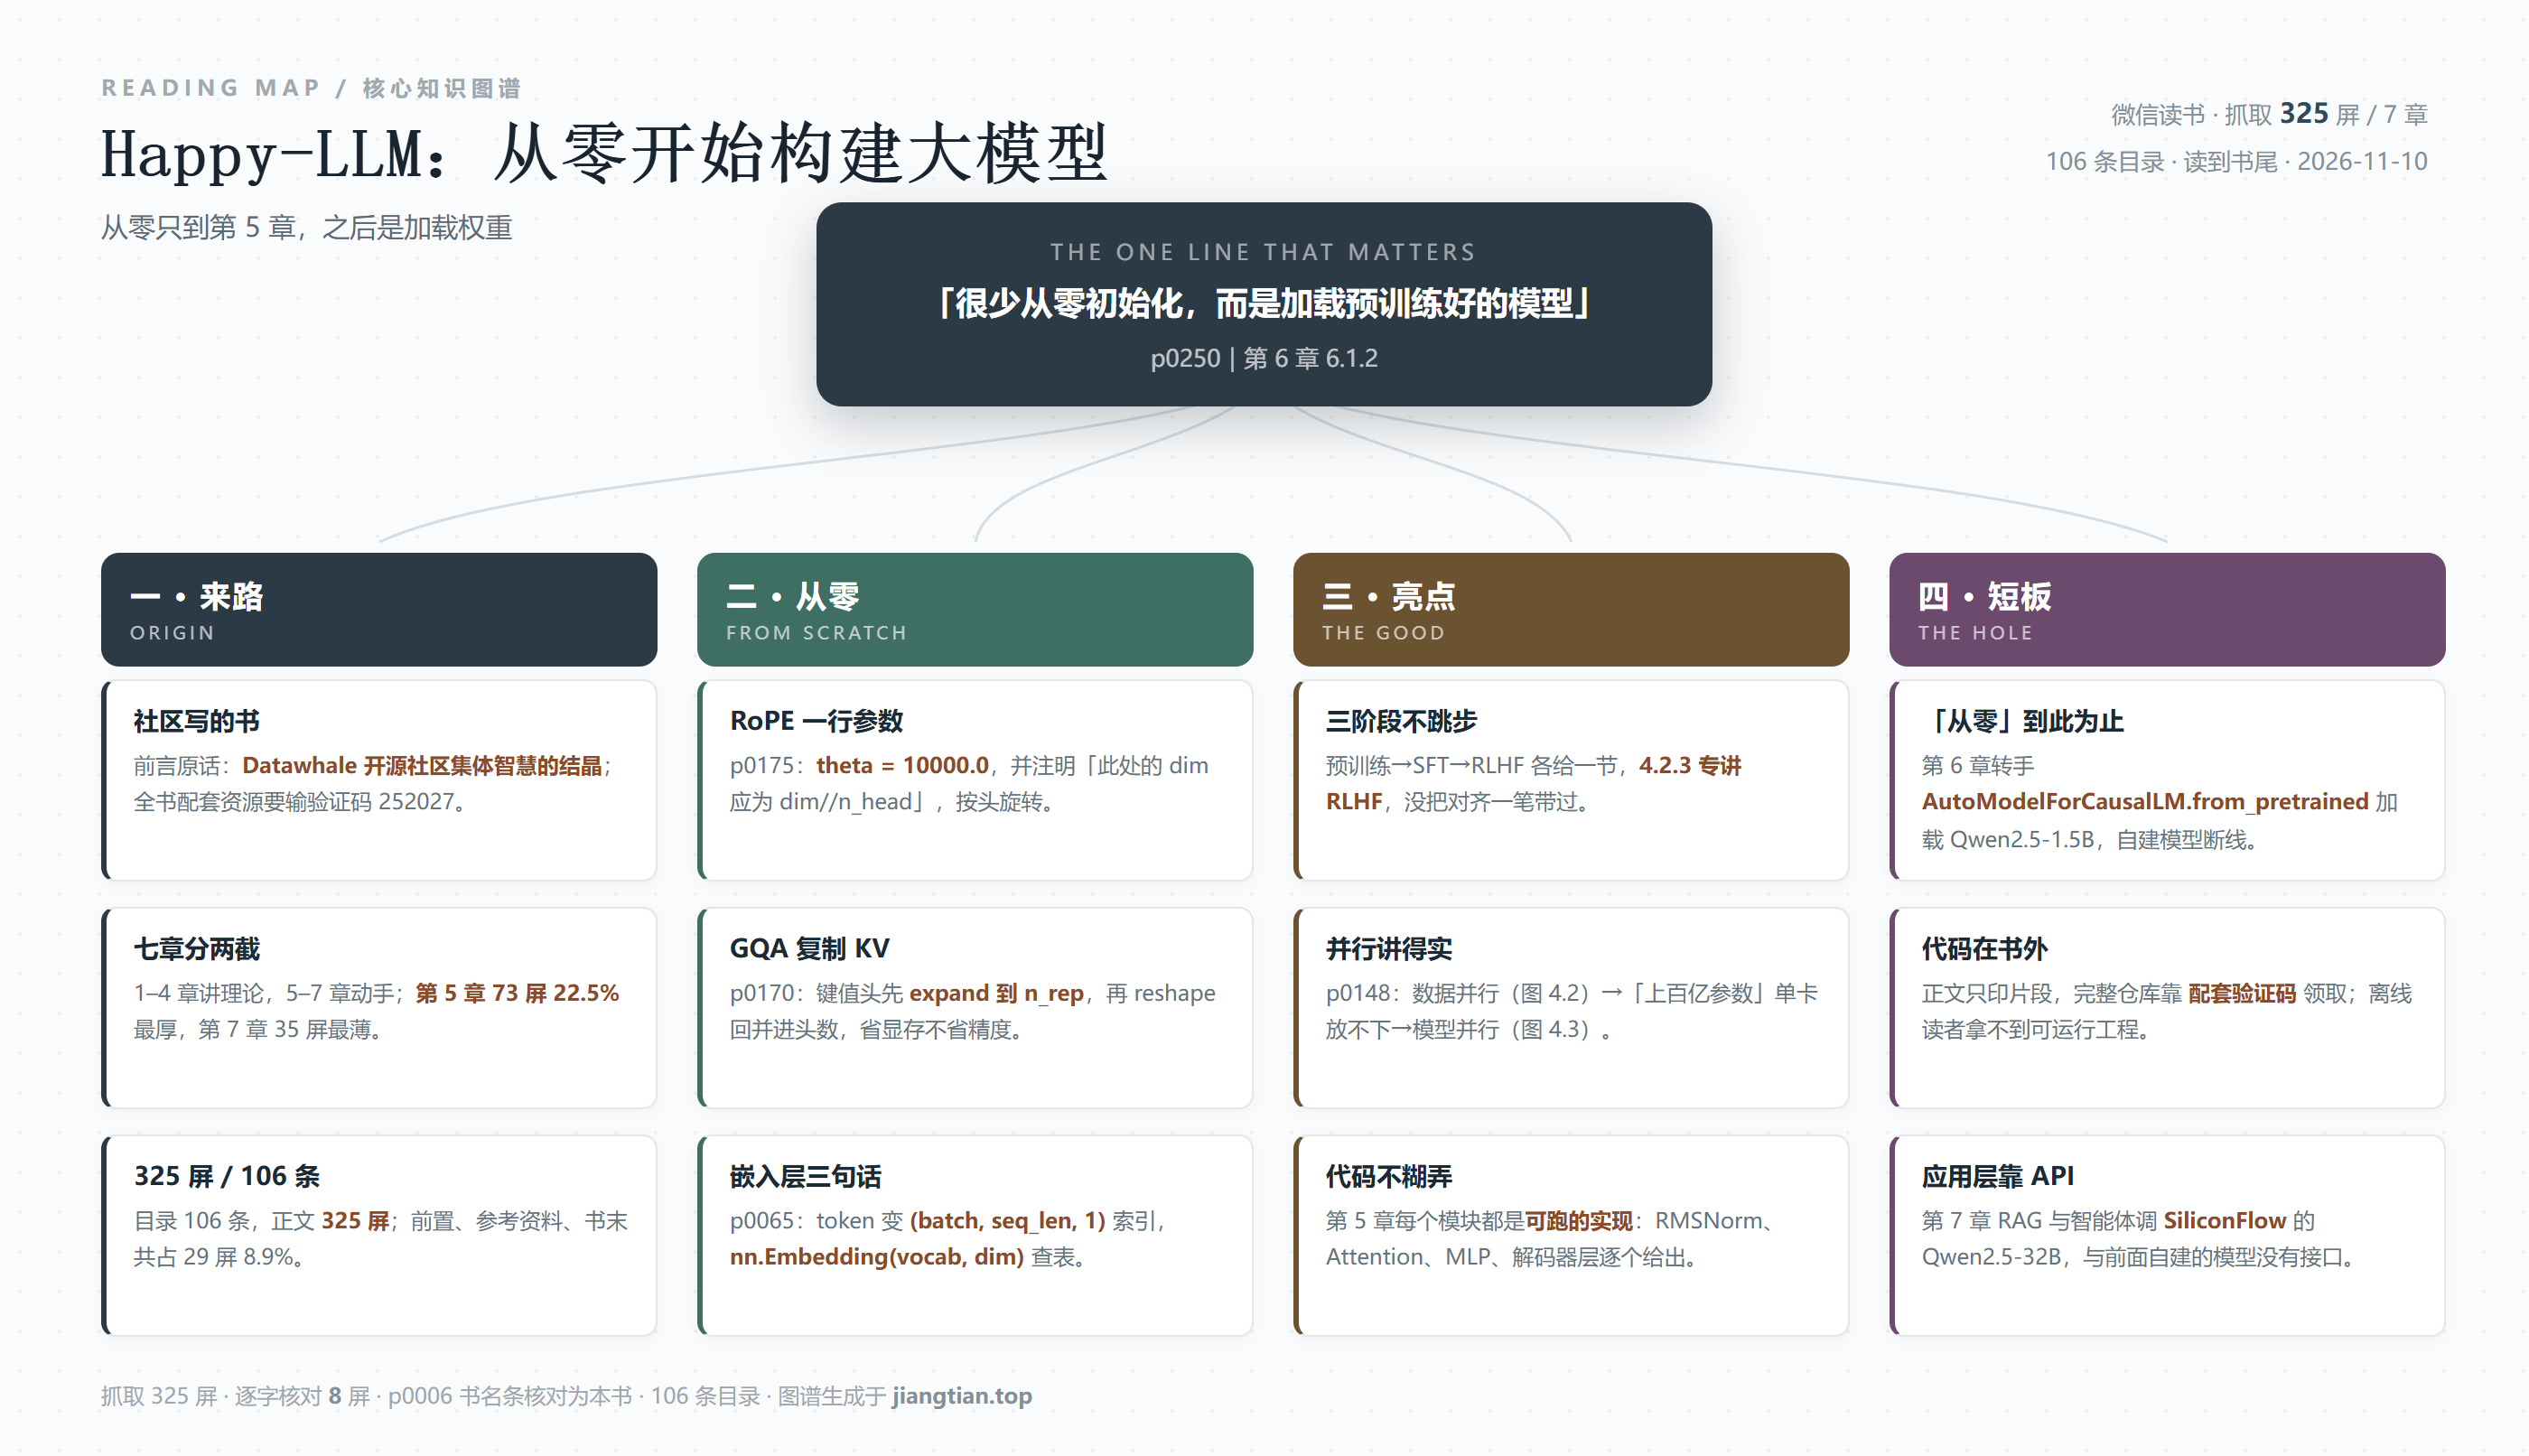
先给结论:这是一本把「造模型」讲得比大多数同类书都实的教材,但它的书名只兑现到第 5 章。第 5 章 73 屏、占全书 22.5%,从超参数、RMSNorm、Attention、MLP 一路搭到解码器层和整个模型,每一节都给可运行的代码;到了第 6 章,第一句就换了主语——「一般情况下,我们很少从零初始化 LLM 并进行预训练,而是加载一个预训练好的 LLM」。这句话本身是诚实的,甚至是专业的,但它和第 5 章之间只隔了一句过渡。一本叫「从零开始构建」的书,用五分之一篇幅教你造,用一句半话告诉你别造。这个裂缝,是我读完之后最想说的东西。
一、先说这本书的来历:社区攒的,代码在书外
这本书的身份比它的内容更值得先交代一句。p0006 的前言里写着:「本书是开源学习社区 Datawhale 集体智慧的结晶。Datawhale 多年来在 AI 领域持续践行『和学习者一起成长』的理念,凭借长期的实践积累,逐渐催生了本书的雏形。」
这句话解释了很多事。它不是一位作者关起门写两年的产物,而是一群人把项目文档、教程、代码仓库整理成书的产物。所以你会在书里看到两种气质并存:一种是教材的(每章有小结、有参考资料、有编号小节,106 条目录整整齐齐),另一种是项目 README 的(大段大段贴代码,注释写得像同事之间的提醒)。有意思是这 106 条目录的构成:7 条是章,21 条是二级节,71 条是三级节,剩下 7 条是版权信息、内容提要、前言、资源与支持、本章小结、参考资料这类前后置。也就是说,真正讲内容的是 92 条,其中七成是三级节——它的粒度细到了「一个零件一条目」。
前言把全书分工说得很清楚:第 1 章讲 NLP 的基本任务与文本表示的发展历程;第 2 章讲 Transformer 架构,包括原理、代码实现;第 3 章讲 PLM,也就是预训练语言模型的三种架构——仅编码器(BERT、RoBERTa、ALBERT)、编码器-解码器(T5)、仅解码器(GPT、LLaMA、GLM);第 4 章讲 LLM 的特点、能力和整体训练过程;第 5 章「基于 PyTorch 亲手搭建一个 LLM,并实现预训练、有监督微调(SFT)的全流程」;第 6 章引入 Transformers 框架与 DeepSpeed;第 7 章讲评测、RAG、智能体。
这里有个容易被跳过的细节。前言说第 5 章要「实现预训练、SFT 的全流程」,第 6 章又说用 Transformers 框架「快速、高效地实现 LLM 训练过程」。同一个动作讲了两遍:一遍手写,一遍调库。很多人会把这种重复当成注水,我不这么看——这个重复是全书的分水岭,第 5 章是「造」,第 6 章是「用」,而「从零」这两个字,只覆盖前半段。
篇幅分布也印证了这个判断。全书 325 屏,第 5 章 73 屏占 22.5%,是七章里最厚的;第 6 章 47 屏占 14.5%;第 2 章 45 屏占 13.8%;第 3 章 42 屏占 12.9%;第 7 章 35 屏只占 10.8%;第 4 章 34 屏占 10.5%;第 1 章 20 屏占 6.2%;前言、参考资料与书末合计 29 屏占 8.9%。
把这组数摆在一起,你能看出这本书的重心:它把最大的那块料,压在了「搭一个能跑的东西」上。第 7 章讲评测、RAG、智能体三件大事,一共 35 屏,平均一件 11 屏——这在一本讲大模型的书里是偏薄的,后面我会专门说。
二、它教得最扎实的一处:一个 token 怎么变成向量
如果要挑一屏来证明这本书「不跳步」,我会挑 p0065。
这一屏在 2.3.1 嵌入层里,讲的是分词之后的第一个动作:把 token 的索引变成向量。它的讲法是这样的——先说明嵌入层的输入「往往是一个形状为(batch_size, seq_len, 1)的矩阵」,然后逐维解释:第一个维度是批大小,第二个维度是自然语言序列的长度,第三个维度是 token 经分词器转化生成的索引值。
接着它给了一个最小例子:「例如,对于上述输入,嵌入层的输入将为如下形式:[[0, 1, 2]]」。然后自己把答案说出来:「从中可以看出,batch_size 为 1(单个样本),seq_len 为 3(包含 3 个 token)。」
再往下是机制:嵌入层内部是一个可训练的、形状为(vocab_size, embedding_dim)的权重矩阵,词表中的每一个值都对应一行 embedding_dim 维的向量,输入的值就是去查这一行,拼成(batch_size, seq_len, embedding_dim)的矩阵输出。最后落到一行代码:self.tok_embeddings = nn.Embedding(args.vocab_size, args.dim)。
我的判断是:这半页的价值,高于很多同类书一整章。因为绝大多数「从零构建」的书,第一页就跳到 Transformer block,默认读者知道输入是什么、形状为什么是三维、embedding 到底查到的是什么东西。这本书不默认:它把一个 3 token 的玩具例子摊开,让你看见 [[0, 1, 2]] 是怎么变成 3 个向量的。
但它也有明确的留白,而且这些留白恰恰是动手时最先撞上的。它没有讲词表大小该怎么定——只说了一句「词表大小则往往高达数万至数十万」;没有讲中文语料上为什么常常要另训分词器(虽然第 5 章 5.2 有「训练分词器」,但那是操作,不是取舍);也没有讲 embedding 维度和模型宽度、注意力头数之间该怎么配。这三件事,是调模型时最先要拿主意的三件事,书里全放在了「你自己去试」的位置上。
三、理论部分的结构:拆得很细,细到有点碎
第 2 章 45 屏,是理论部分最厚的一章。光看目录就能看出它的拆法:2.1 注意力机制分六节——什么是注意力机制、深入理解注意力机制、注意力机制的实现、自注意力、掩码自注意力、多头注意力;2.2 编码器-解码器架构也分六节——Seq2Seq、全连接神经网络、层归一化、残差连接、编码器、解码器;2.3 才是「搭建一个 Transformer 模型」,分嵌入层、位置编码、一个完整的 Transformer。
这个顺序我认。先讲清一个头,再讲自注意力、掩码、多头,最后才拼架构,比很多书「一上来就多头加位置编码」友好得多。它照顾的是那种「我看过公式但没写过一行」的读者。
代价也很明显:一个 Transformer 被拆成十二节讲了两遍。2.1 讲的是零件(注意力),2.2 讲的是容器(编码器/解码器),2.3 再拼一遍。对完全新手,这是三遍巩固;对有一点基础的读者,这是三倍耐心消耗。第 3 章 PLM 42 屏 12.9%,也是一样的路数:BERT、RoBERTa、ALBERT、T5、GPT、LLaMA、GLM 一个不落,每种给一节,讲清楚「它和前面那个有什么不同」,但不深挖训练细节。
我把这种写法叫「目录式覆盖」:它保证你不缺项,也保证你不会有任何一项读得过瘾。这是教材的写法,不是专著的写法。作为一本给学习者铺路的书,这个选择是合理的;但如果你的目标是「读完能改模型结构」,第 2、3 章给不了你这个能力。
第 4 章更能说明这种「覆盖」的代价:34 屏 10.5%,讲的是「什么是 LLM」(定义、能力、特点三节)和「如何训练一个 LLM」(预训练、SFT、RLHF 三节)。六个末级小节,平均 5.7 屏。图 4.2 的数据并行、图 4.3 的模型并行,都挤在 4.2.1「预训练」这一节里。
这意味着一件很具体的事:读者第一次遇到「预训练、SFT、RLHF」这三个词,是在第 4 章,而解释它们的篇幅加起来不到 20 屏。这本书真正的训练内容在第 5、6 章,第 4 章是个路牌。路牌做得没错,但它承担了一个不该由它承担的任务——让读者以为自己已经懂了。我读完之后回头再看,第 4 章那 34 屏更像一份目录的扩写,而不是一章知识。
四、第 5 章:73 屏,一个能跑的 LLaMA2
这是全书最像手册的一章,也是我愿意为它付书价的一章。
5.1 从「定义超参数」开始,然后一节一个零件:5.1.2 构建 RMS 归一化、5.1.3 构建 LLaMA2 的 Attention 模块、5.1.4 构建 MLP 模块、5.1.5 构建解码器层、5.1.6 构建整个模型。5.2 训练分词器,从字符级讲到子词级,再训练一个。5.3 预训练一个小型 LLM:数据下载、分词器训练实战、数据集、预训练、SFT 训练、用模型生成文本。
具体到细节,p0175 这一屏值得单独说。它上半段讲 GQA(分组查询注意力)怎么实现:「在第三个维度(键/值对的维度)之后添加一个新的维度,形成 x[..., None, :]」;「使用 expand 方法将新添加的维度扩展至 n_rep 大小,以实现键/值对的重复效果」;「最后,使用 reshape 方法进行重塑,将扩展后的维度合并回键/值对的数量中,即 x.reshape(bs, s_len, n_kv_heads * n_rep, head_dim)」。三句话,把一个工程细节说完了。
下半段讲旋转嵌入,给了一段 precompute_freqs_cis 的实现,注释里有一句:「注意:此处的 dim 应为 dim//n_head,因为我们对每个头进行旋转嵌入」,theta 取 10000.0。
这条注释值钱。RoPE 是抄代码最容易错的地方之一:按整个隐藏维算频率,还是按每个头的维度算频率,结果差一个 n_head 的因子,模型能训但效果不对,而且不报错。书里没有绕开这个坑,而是直接指出来。这种地方是「写过的人」才会写的,不是「查资料的人」能写的。
第 4 章的分布式也讲得实。p0148 先给数据并行(图 4.2:数据切成几份,每个 GPU 一份完整的模型,各自算梯度再同步),然后一句话把问题挑明:「但是,当 LLM 扩大到上百亿参数规模时,单个 GPU 往往就无法存放完整的模型参数了。」接着才引出模型并行(图 4.3:把模型按层切到不同 GPU 上)。这个顺序是对的——先讲清楚为什么数据并行会撞墙,再讲墙后面的路。大部分书是先给结论(要模型并行),再补原因;这本书是先给你撞一次墙。
「我们很少从零初始化 LLM 并进行预训练。」——这句话出现在第 6 章 6.1.2 的第一段,而封面上印着「从零开始构建大模型」。不是它写错了,是它对自己的定位没想清楚:到底教人造,还是教人用。
五、第 6 章:主语从「我们造」换成了「我们加载」
第 6 章 47 屏 14.5%,第一小节就把话说到底了。p0250 在 6.1.2「初始化 LLM」里写:「该模型就是一个从零初始化的 Qwen2.5-1.5B 模型。一般情况下,我们很少从零初始化 LLM 并进行预训练,而是加载一个预训练好的 LLM,然后在自己的语料上进行后训练。」
紧接着是代码:from transformers import AutoModelForCausalLM,model = AutoModelForCausalLM.from_pretrained(model_name_or_path, trust_remote_code=True);分词器同理,AutoTokenizer.from_pretrained(...)。预训练数据用的是一个叫「序列猴子」的数据集,走 Hugging Face 的 datasets 与 load_dataset 下载解压。
这句话本身没毛病,甚至可以说是全书最专业的一句判断——2024 年以后,除了少数团队,没人从零训 1.5B。但它和第 5 章之间,缺一座桥。第 5 章你亲手搭了一个 LLaMA2(小尺寸),第 6 章你加载一个 Qwen2.5-1.5B,然后开始 Trainer。那么问题来了:我自己搭的那个模型,怎么接进这套 Trainer?它的 state_dict 和 Qwen 的能不能互换?如果我要在自己造的模型上做 SFT,第 6 章的代码要改哪几行?书里没有这条线。第 5 章和第 6 章像两篇独立的教程,被装订在了同一本书里。
更值得说的是 p0225 那一屏。那是第 6 章预训练脚本的参数表,一整屏的 argparse:out_dir 默认 output,epochs 默认 1,batch_size 默认 64,learning_rate 默认 2e-4,device 自动选 cuda,dtype 用 bfloat16,use_swanlab 默认开,num_workers 8,data_path 可为空,accumulation_steps 默认 8,grad_clip 默认 1.0,warmup_iters 默认 0,log_interval 100,save_interval 1000。
十四行超参,没有一个字解释为什么。这是全书最典型的一处「给了旋钮,没给刻度」。2e-4 对一个 1.5B 模型的预训练来说偏高(常见量级在 1e-4 到 3e-4 之间,取决于批大小与 warmup),但书里没告诉你这个数是怎么来的、什么情况下该调小、调小之后 loss 曲线会变成什么样。grad_clip 1.0、accumulation 8、warmup 0——这三个数连在一起,是有故事的(warmup 为 0 却配 2e-4,小模型能跑,大模型容易炸),但书里只把它们当默认值印出来。
把第 6 章拆开看,取舍就更清楚了:6.1 模型预训练 22 屏,6.2 模型 SFT 9 屏,6.3 高效微调 13 屏。22 屏里,6.1.5「使用 DeepSpeed 实现分布式训练」独占 10 屏——占这一章的 21%,占预训练那一节的近一半。换句话说,这本书教训练,最舍得给篇幅的是「怎么把训练铺到多张卡上」,而不是「数据该怎么配、loss 该怎么看」。SFT 那 9 屏里,6.2.2 微调数据处理又拿走了几屏,真正讲微调策略的只有薄薄一层。
这不一定是错,但它决定了这本书的读者画像:它是给「一个人在一张卡上跑通全流程」的人写的,不是给「要训练出一个能打的模型」的团队写的。DeepSpeed 那 10 屏更像是「知道有这么个东西、知道怎么起」的入门,离「调得动」还差一截。
我不认为这是作者偷懒。这是「代码可运行」和「参数可理解」之间的取舍,他们选了前者。对只想跑通的人,这够了;对想调出效果的人,这不够。
六、第 7 章 35 屏:RAG 和智能体,都借了别人的枪
第 7 章 35 屏 10.8%,三节:7.1 大模型评测(评测数据集 / 主流榜单 / 特定榜单)、7.2 RAG、7.3 智能体(什么是 / 类型 / 动手构造)。
评测那三节,从目录看是「有哪些」而不是「怎么造」:有哪些评测数据集、有哪些主流榜单、有哪些特定榜单。一本教人训练模型的书,最后一章不教人怎么给自己训出来的模型造一套评测,这是结构上的缺口——你花 73 屏学会造,用几节学会查别人造得好不好,但没人告诉你自己造的那个该怎么量。
RAG 那一节给了流程图(图 7.3:文档切块 → 向量化 → 检索 → 拼上下文与提示语 → LLM 生成),然后「步骤 2:向量化」开始写代码,先定义一个 BaseEmbeddings 基类,理由写得很工程:「首先我们需要设置一个 BaseEmbeddings 基类,这样在使用其他模型时,只需要继承这个基类,然后在此基础上进行修改即可,从而方便进行代码的扩展。」
智能体那节(p0315,7.3.3 动手构造一个小型智能体)是全书离「工程」最近也最远的一屏。步骤 1 初始化客户端:client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.siliconflow.cn/v1"),模型指定 Qwen/Qwen2.5-32B-Instruct;步骤 2 定义工具函数,每个函数都要有清晰的文档字符串(docstring),「该文档字符串将用于自动生成工具的 schema」。
到这里,闭环断了。你在第 5 章辛苦搭的模型,在第 7 章一次都没被用到。RAG 的向量化用 BaseEmbeddings 抽象,接的是哪家、怎么接,书里没交代;智能体直接调云端 32B 的 API。于是全书形成了两个互不相通的世界:前五章教你造一个小模型,后两章教你怎么用别人的大模型。中间那层「我自己造的模型怎么变成一个 OpenAI 兼容的服务」——也就是部署与推理服务——一个字没有。
数字也印证了这股收尾的仓促:7.1 评测 6 屏,7.2 RAG 13 屏,7.3 智能体 14 屏。智能体那一节里,7.3.1「什么是智能体」和 7.3.2「智能体的类型」各 2 屏,真正动手的 7.3.3 只有 9 屏。一个 Hello-World 级别的智能体,9 屏;一个从零搭的 LLaMA2,73 屏。这个比例告诉你作者的心在哪:他想讲的是「模型怎么造出来」,不是「造出来之后能干什么」。
七、作为教材,它合格在哪
批评说了不少,该给的公道也要给。
第一,它敢把「全流程」三个字兑现一部分。三阶段(预训练、SFT、RLHF)各给一节,4.2.3 专门讲 RLHF,没把对齐这两百字带过。这在中文教材里不算常见——很多书讲完预训练就收工,SFT 一句话,RLHF 只在名词表里出现。这本书把 RLHF 放在第 4 章的训练流程里,是把它当成主线的一环,而不是附录。
第二,它的代码是真的在跑,不是在演示。第 5 章每个模块都给实现:RMSNorm、带 GQA 的 Attention、MLP、解码器层,最后拼成模型。这不是「伪代码 + 你以为你能写」,是「抄下来能跑」。p0175 那条 dim//n_head 的注释,就是证据。
第三,参考文献是认真列的。第 7 章末尾给了 [4] RAM O, LEVINE Y, DALMEDICO I, et al. In-context retrieval-augmented language models[EB/OL]. arXiv:2302.00083.——格式规范到能直接检索,不是「参见某某论文」那种糊弄。第 1 章也老老实实收了「1.5 本章小结」和「参考资料」两节。小结加文献,这套教材动作它做了,而且做得比很多同名教材干净。
第四,它知道自己有配套资源。书末给了「配套资源验证码 252027」。这说明作者清楚:书里只能印片段,完整工程得单独发。这个自觉,比那些假装书里代码能直接跑的书要诚实。
所以这本书到底该给谁读,我的判断分三类。第一类,刚看完 Transformer 论文、想把公式变成代码的人——这本书很适合你,第 5 章 73 屏就是为你写的,跟着敲一遍,你会第一次拥有一个自己能改的模型。第二类,已经在用 API 做应用、想搞清底下发生了什么的人——也适合,第 2 到 5 章能把你的黑盒拆开,但第 7 章对你没什么新东西。第三类,要真训一个能上线的模型的人——不适合。你需要的是数据配比、评测集设计、分布式调优、推理部署,这四件事书里分别是零屏、零屏、10 屏、零屏。
把话说白:这是一本「造一个玩具级大模型」的通识教材,不是「训一个可用大模型」的工程手册。它在这两个身份之间,选了前者,但封面写的是后者那种气势。
八、它的短板
短板一:书名只兑现到第 5 章。「从零开始构建大模型」这六个字,读者会理解成「不用别人的权重」。实际上第 5 章之后立刻 from_pretrained。我不认为加载权重是错的,错的是定位摇摆:如果这本书定位「教你造」,第 6 章应该讲怎么把你自己造的 0.1B 接上 Trainer、怎么处理 tokenizer 不一致、怎么在你的模型上做 LoRA;如果定位「教你用」,第 5 章那 73 屏就是奢侈品,该砍到 20 屏讲清结构即可。现在两头都占,两头都不彻底。
短板二:代码在书外,而且靠一个验证码。正文只有片段,完整仓库要凭「配套资源验证码 252027」去换。对纸质书读者,这意味着你合上书就没有可运行的工程——而这本书的全部价值就在「能跑」。更要紧的是,验证码会过期、会失效、会随版本换代而无人维护。一本 2024 年出的书,2026 年再拿这个码去换,能不能换到、换到的是不是当年那份,是个真问题。开源社区的书,代码却要走一个封闭的领取流程,这件事本身有点矛盾。
短板三:版本一个都没锚定。Qwen2.5、transformers 的 Trainer、DeepSpeed、peft 的 LoRA——全是会变的栈。书里没有一处写「本书基于 X.Y 版本」,也没有 requirements.txt。这类书最怕的不是写错,是写对但过期:半年后你照抄,报的是版本错,而书不会告诉你错在哪一行。第 6 章整章建立在 Transformers 的 API 上,这是全书最脆的一章。
短板四:第 7 章太薄,而且薄在最该厚的地方。35 屏覆盖评测、RAG、智能体三件大事,评测三节全是「有哪些榜单」。一个读者花 73 屏学会造模型,最后没有一节教他怎么判断自己造的好不好——这就像教人做菜,最后不教尝味。RAG 与智能体各给了一个能跑的最小实现,这个及格;但两者都接在别人的 API 上,与前半本书自建的模型没有接口,全书因此缺一个收口。
短板五:口碑样本太小。末页显示微信读书推荐值 72.2%,28 人点评。这个数字只能当参考——28 人的样本,一个人的评价能拉动三个百分点。72.2% 在一本技术书里属于「能用但有明显不满」的区间,和我的读感一致:结构清楚、代码能跑、定位摇摆。
最后说一句公道话。这本书的短板,基本都是「一本教材在时效与深度上的天然短板」,不是态度问题。它没有编数据、没有拿伪代码糊弄、没有把别人的论文改个名字当自己的章节。它甚至在 6.1.2 主动承认了「我们很少从零」。真正的问题只有一个:它在最诚实的那句话里,暴露了自己书名的不诚实。
这本书最专业的一句是「我们很少从零初始化」,最不专业的一件事是封面还印着「从零开始」。
最后交代我的态度:这五条短板一条都没让我想把这本书从书架上拿下来。因为它的长处是不可替代的——中文语境里,肯把 LLaMA2 一个零件一个零件拆开、并且注释里写清「dim 要除以 n_head」的书不多。短板让我知道该拿它当什么用:当零件图,不当装配手册;当入门的第一本,不当最后一本。想清楚这一点,72.2% 这个分数就变得很好理解——给它打高分的人,多半是照着第 5 章把模型跑起来的那批;给它打低分的人,多半是拿着「从零」两个字来、在第 6 章发现自己被骗了的那批。
说明:各章篇幅由 pages.jsonl 逐页章节映射全量聚合(前言与书末 29 屏 8.9%;第 1 章 20 屏 6.2%;第 2 章 45 屏 13.8%;第 3 章 42 屏 12.9%;第 4 章 34 屏 10.5%;第 5 章 73 屏 22.5%;第 6 章 47 屏 14.5%;第 7 章 35 屏 10.8%;合计 325 屏)· 第 2 章内部拆节、第 3 章 PLM 覆盖范围、第 7 章三节结构,均按 meta.json 的 106 条目录核对,未逐屏展开 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: