
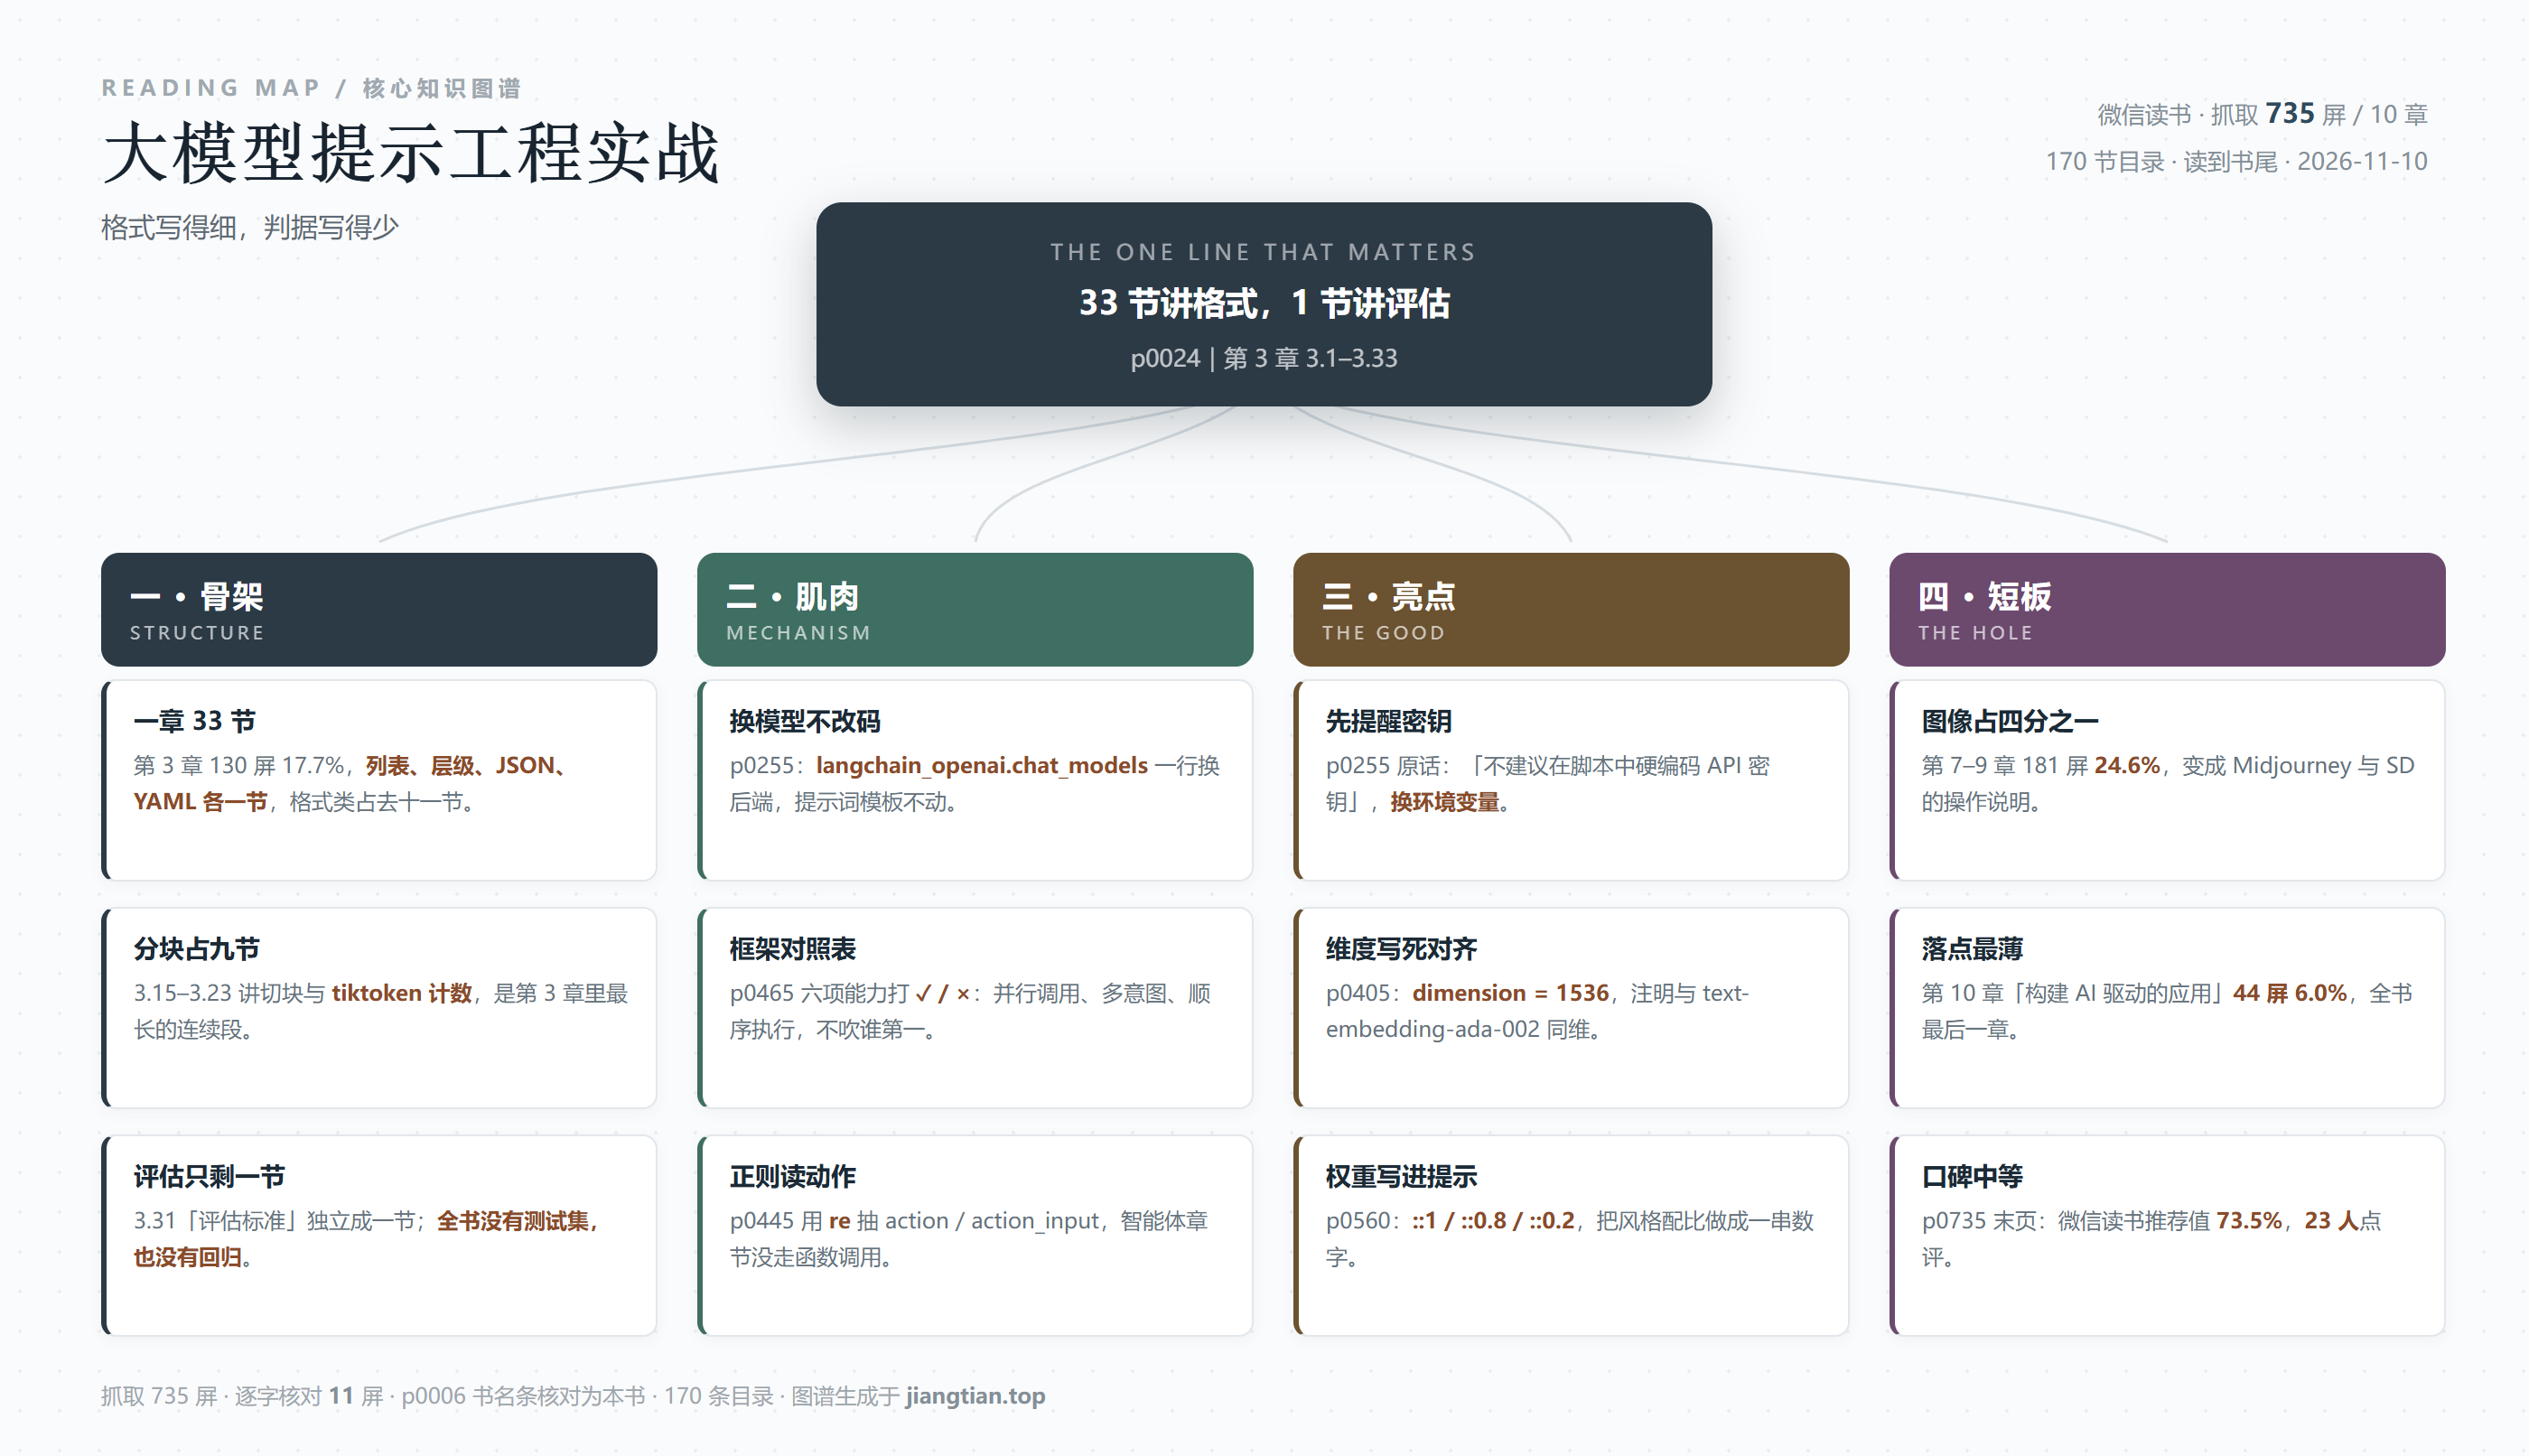
大模型提示工程实战:33 节讲格式,只有 1 节讲怎么判断对错
微信读书《大模型提示工程实战》· 抓取 735 屏 / 10 章 / 170 条目录 · 读到书尾
逐字核对 11 屏 · p0006 书名条核对为本书 · 2026-11-10
抽样点位的选法:这本书的十章是「原则—模型—文本—框架—向量库—智能体—图像理论—Midjourney—SD—应用」一条线,所以我按「一章一屏」取点,再在第 3 章(33 节、130 屏)和第 6 章各加密一屏——因为全书的结构问题恰好全在这两章显形。抽读 11 屏约占 1.5%。章节篇幅占比不是抽样得出的,是用 pages.jsonl 逐页章节映射做的全量聚合。
我先给结论:这是一本把「提示」写成「格式」的书,而且写得很细、很干净、可以直接抄。它的问题不在于错,而在于秤砣放错了地方——第 3 章用 33 节、130 屏把「要什么格式」讲到了极致,而「怎么判断你要的格式对不对」只剩一节。
把账摊开看:全书 735 屏,第 3 章「使用 ChatGPT 进行文本生成的标准实践」130 屏占 17.7%,第 4 章「LangChain 框架下的文本生成高级技巧」115 屏占 15.6%,两章加起来 245 屏,三分之一。而讲「评估」的,只有 3.31 一节加上 4.9 一节。我在抽样里没有看到测试集,没有看到通过率,没有看到一次「改完提示词之后,效果到底好了多少」的对照。一本教人写提示词的书,教会了你九种把答案装进 JSON 的办法,却没教你怎么知道这个 JSON 是不是对的。
这不是刻薄话。第 1 章 p0030 列出的五条原则里,第四条就叫「评估质量(evaluate quality)」,原文写得很清楚:「发现错误并对生成的内容打分,测试哪些因素可以提升性能。」——打分、测试,两个动作都点到了。可是往下 650 屏,这条原则再没有以任何形式回到目录里。原则被供在第 1 章,然后全书按「任务类型」重排了一遍。
一、它的骨架不是五条原则,是一张格式清单
先把这个反差说清楚。
p0030 的五条原则排得很漂亮,中英对照,一条一句解释:提供指导(give direction)——详细描述期望的风格,或参考相关的人物形象;指定格式(specify format)——定义应该遵循的规则和所需响应的结构;提供示例(provide examples)——加入一组风格多样的测试用例;评估质量(evaluate quality)——发现错误并对生成的内容打分;任务拆分(divide labor)。五句话,五个动词,干净得可以直接贴到团队 wiki 上。
然后第 3 章的 33 个小节长这样:生成列表、生成层级列表、何时避免使用正则表达式、生成 JSON、YAML、过滤 YAML 负载、处理 YAML 中的无效负载、ChatGPT 生成多种格式的能力、五岁小孩也能听懂、通过 LLM 实现通用翻译、请求上下文、拆解文本风格、摘要、在上下文窗口受限时进行摘要、文本分块、分块策略、使用 spaCy 进行句子检测、在 Python 中构建一个简单的分块算法、滑动窗口分块、文本分块工具包、使用 tiktoken 进行文本分块、编码、估算 Chat API 调用中的词元使用量、情感分析、从简到繁、角色提示、GPT 提示词技巧、使用 LLM 分类、构建分类模型、分类的多数投票法、评估标准、元提示、小结。
33 节里,讲「输出成什么形状」的有 7 节(3.1、3.2、3.4、3.5、3.6、3.7、3.8);讲「怎么把长文切碎、怎么数词元」的有 9 节(3.15 到 3.23,整整一段连续的分块专题);讲「怎么评估」的,1 节(3.31)。剩下 16 节是各种各样的具体任务。
这就是这本书真实的骨架:它不是按「原则」组织的,是按「输出格式+工程配套」组织的。这个选择本身没错,甚至可以说很实用——你明天要写一个把会议记录转成表格的脚本,翻第 3 章就能抄到东西,而且抄来就能跑。但它带来一个代价:五条原则里最贵的那条(评估),被挤成了一节;最便宜的那条(指定格式),被扩成了十七节。
分块那九节还暴露了一个更细的问题:它把「有哪些切法」讲全了,却没把「该填什么数」讲清。p0335 是第 4 章讲文本分割的收尾页,示例代码只有一句 RecursiveCharacterTextSplitter(chunk_size=300),然后是 split_documents(docs),接着就总结「引入文本分割器后,你可以战略性地管理文档的大小,在优化 LLM 的上下文窗口与保留丰富信息之间取得平衡」。这句话是对的,但 300 这个数字从哪来的、要不要给 overlap、中文标点怎么算、切断了指代怎么办——四个真问题,一个都没在页面上出现。第 3 章用九节铺陈了分块的必要性,第 4 章用一行代码交付了分块的结果,中间那段「怎么定参数」被省略了。而这一段,恰恰是 RAG 效果好坏的分水岭。
二、篇幅账:42% 给文本,24.6% 给图像,6% 给「应用」
把 pages.jsonl 的逐页章节映射聚合一下,账是这样的(合计 735 屏):
前置 23 屏 3.1%;第 1 章 五大原则 64 屏 8.7%;第 2 章 面向文本生成的 LLM 31 屏 4.2%;第 3 章 标准实践 130 屏 17.7%;第 4 章 LangChain 115 屏 15.6%;第 5 章 向量数据库 64 屏 8.7%;第 6 章 记忆与工具的自主智能体 83 屏 11.3%;第 7 章 扩散模型简介 25 屏 3.4%;第 8 章 Midjourney 70 屏 9.5%;第 9 章 Stable Diffusion 86 屏 11.7%;第 10 章 构建 AI 驱动的应用 44 屏 6.0%。
三个数字值得单独拎出来:
第一,文本三章(3+4+5)合计 309 屏,占 42.0%。这是全书的重心,合理——书名就是提示工程,提示工程的主战场在文本。
第二,图像三章(7+8+9)合计 181 屏,占 24.6%。将近四分之一。这不是「顺带讲一下」的分量,这是「另开一门课」的分量。而这三章里,理论(第 7 章)只有 25 屏 3.4%,操作(第 8、9 章)占了 156 屏——理论薄、操作厚的比例是 1 比 6。
第三,最后一章「构建 AI 驱动的应用」44 屏,占 6.0%,是全书第二薄的一章(只比第 7 章的 25 屏厚)。
这三个数字连起来读,就是这本书的性格:它极擅长把一件事拆成可复制的动作,极不擅长告诉你这些动作该按什么顺序用。拆动作的部分写了 691 屏,讲顺序的部分留了 44 屏。
三、它最扎实的一页:六行 ✓ 和 ×
说完结构,得说这本书确实做得好的地方——不然就是抬杠。
p0465,第 6 章末,有一张对照表:单工具执行 ✓/✓;易于实现 ✓/×;并行函数调用 ✓/×;迭代式的思维过程 ×/✓;多意图处理 ✓/✓;按顺序执行工具 ×/✓;可定制提示词 ✓/✓。两列,七行,左边一列打勾打得多,右边一列在「易于实现」和「并行函数调用」上直接给了叉。
这一页值得单拎出来夸,原因不是它信息量大,而是它肯在比较里承认自己那一列有短板。技术书里最常见的对照表是「我们 7 项全绿,他们 3 项红」,读者看完只知道买谁。这张表给的是判据:如果你的场景需要「并行调多个函数」,选左边;如果你需要「一步一步想、按顺序调工具」,选右边。表下面那句总结也说得很克制:「在与不同的 AI 框架互动时,明白每一个框架都有其独特的优势与局限至关重要。」没有排名,只有分工。
同类的扎实处还有三处,都不长,但都是「一句话钉住一个坑」:
p0255 讲 LangChain 换模型:「出于安全考虑,不建议在脚本中硬编码 API 密钥。应该通过环境变量或配置文件来管理你的密钥。」——这句话出现在一本讲提示词的书里而不是一本讲工程的书里,说明作者知道自己在带谁上路。
p0405 建 Pinecone 索引:dimension=1536、metric="cosine",代码注释写着「使用与 text-embedding-ada-002 相同的向量维度」。——这是全书最容易被写错、也最容易被省略的一个数字。维度不对,索引能建、能写、能查,就是不返回你要的东西,而且不报错。作者把它写死了,还注明了为什么是 1536。
p0110 讲量化与 LoRA,落点很实在:量化是「降低模型参数的数值精确度,在不显著影响性能的前提下,缩小模型的整体规模」,LoRA 是「优化网络架构」,两者合起来让「个体开发者、小型公司和初创公司不再依赖高性能数据中心」。第 2 章只有 31 屏,但这一页把「为什么要关心开源模型」交代清楚了。
还有一处我犹豫要不要夸:p0235 的「多数投票法」。写法不复杂——把同一条输入跑若干次,用字典统计每次的分类结果,count_dict.get(classification, 0) + 1 累加,最后 max(count_dict, key=count_dict.get) 取票数最多的那个,页面底部标着「预期输出:Neutral」。这是全书唯一一处「用重复换稳定」的工程思路,也是唯一一处接近「评估」的动作。但它停在「跑几次取众数」,没算账:跑三次就是三倍 token、三倍延迟,而且三次都错的时候众数错得更自信。什么时候值得投票、票数怎么定、要不要加个置信阈值——这三问不答,这个技巧就只能当练习题。
这四处加起来不到 10 屏,但它们撑住了这本书的信用。
四、它最别扭的一章:讲智能体,却用正则读动作
第 6 章 83 屏,讲「具备记忆和工具的自主智能体」。这是全书最有野心的一章,也是自相矛盾最明显的一章。
p0445,作者在讲 ReAct 那套「思考—行动—观察」的循环,要给读者一个「从模型输出里把动作抠出来」的函数,写法是这样的:定义 extract_last_action_and_input(text),里面用 re.compile(r"(?i)action\s*\*:\s*\*([^\n]+)", re.MULTILINE) 找 action,用同样的办法找 action_input,然后 findall 取最后一个。紧接着一句:「为了确认 LLM 是否已发现最终答案并提取答案,你同样可以运用正则表达式。」
问题有三层。
第一层是最表面的:这两行正则本身可能就是错的。抽到的这一页上,模式串里带了两处 \*——按字面意思,它要求原文里真的出现星号。而这一章要匹配的文本是 Action: 这种纯文本格式。这很像 Markdown 的加粗符号在排版时被吃进了代码块:原本该是 action\s*:\s*,中间被插进了两个 \*。同一页上还有一处 re.MULTILINE 被折成 re.MULTILIN 和 E) 两行,p0235 也有 le 单独占一行的断词。这本书的代码是「读得懂、抄不了」的——排版把代码折断了,而读者把代码复制走的那一刻,得到的是一串 SyntaxError。这不是小事,因为这类书的全部价值就在「抄」。但我不认为这是作者的错,这是排版没为代码做过任何检查。
第二层是方法论的:这本书明明教过更好的办法。第 4 章有 4.10「OpenAI 函数调用」、4.11「并行函数调用」、4.12「LangChain 中的函数调用」——三节,讲的全是「让模型直接吐出结构化参数,你不用解析字符串」。到了第 6 章讲智能体,作者退回去用正则抠文本。同一本书里,前面给了扳手,后面用手拧。
第三层是最要紧的:正则这条路在生产里是走不通的,而书里没提。用正则读模型输出,本质上是假设模型「一定按格式说话」。它多打一个空格、多写一句「好的,我来」,你的 agent 就停了。这不是理论风险,这是所有手搓 agent 的人第一周就会撞上的墙。书里把它写成了一个「技巧」,没有写成一个「仅用于演示的权宜之计」。
「为了确认 LLM 是否已发现最终答案并提取答案,你同样可以运用正则表达式。」
——p0445,第 6 章。这句话是全书的缩影:它把这套做法当成一种能力来介绍,而不是当成一种妥协来提醒。
我把这一章翻过来看,它其实是有骨架的:记忆、工具、循环、框架对比。但选择用正则做黏合剂,等于承认「模型输出是不可靠的文本」,却在整本书的方法论里一直假设「模型输出是可靠的格式」。这个矛盾,贯穿全书。
五、图像那 181 屏,和「提示工程」只共享一个词
第 7 到第 9 章,181 屏。抽到的 p0560 是这样的:8.6 节「加权词」,讲 Midjourney 的双冒号权重。
原文说:默认情况下提示词里所有词的权重都是 1,但位于提示词开头的词通常影响更大,所以「我们往往会将图像主体放在最前面」;要给某一部分加权,就用双冒号加数字。例子是 painting of the Golden Gate Bridge::1 in the style of Van Gogh::0.8, in the style of Dali::0.2——金门大桥的绘画作品权重 1,凡·高风格 0.8,达利风格 0.2,出来的图就是「凡·高风格占八九成,达利占两成」。
这一页写得不坏,甚至挺聪明:它把「配比」这件事变成了三个数字。但它是绘图工具的说明书,不是提示工程的原理。原因很简单:这三个数字之所以有效,靠的是 Midjourney 这个平台对双冒号语法的特定实现;换到 SD 里,同样的写法一文不值;换到任何一个用自然语言理解权重的模型里,这串冒号就是三个噪声字符。
而我在这一节里没有看到任何版本标注——没有说这套语法属于哪个版本、也没有说它在其他绘图工具里成不成立。一本 2023 年前后的书写到这里是可以理解的,但读者是在之后才拿到它的:他照着敲,得到的结果可能和书上的图完全不一样,而书里没有任何一句话为他准备好这个落差。
更根本的错位在命题上。提示工程的内核是「用语言约束一个概率模型的行为」,这件事在文本和图像里是同一件事;但 Midjourney 这一章教的是「用这个平台的语法调这个平台的参数」,那是操作,不是原理。第 7 章本该承担「原理」的角色,却只有 25 屏 3.4%——比第 10 章还薄。原理最薄、操作最厚,这个配比说明作者自己也知道:读者要的是能出图,不是能解释。
顺带说一句公道话:把 Midjourney 和 SD 放在同一本书里,是有价值的。SD 那一章 86 屏讲的是本地部署和参数,Midjourney 那 70 屏讲的是托管平台的手感,两条路确实得都摸一遍。问题不在「写了」,在「占了四分之一,却没为这四分之一付该付的代价」。
六、44 屏的落点:最后一章才想起要装机器
第 10 章「构建 AI 驱动的应用」,44 屏,6.0%。
抽到的 p0725 是这样的:一张图(图 10-5「来自世界各地的多元文化元素无缝拼贴/马赛克示例」),然后一句「为了封装整个图像生成系统,你可以将调用 ChatGPT 和调用 Stable Diffusion AI 的结果整合在一个函数中,并使用 outline_result.title 作为输入参数」,接着两行代码:from image_generation_chain import create_image、image = create_image(outline_result.title)。
这就是全书的收尾方式:把前面九章造出来的零件,用一个两行的函数串起来,然后结束。
我必须说清楚我的判断:这个收尾不算糊弄,但它暴露了这本书的结构性缺陷——它是一本零件目录,最后一章才想起要装一台机器,而只剩 44 屏。
你想想读者拿到这本书的路径:第 1 章学原则,第 3 章学格式,第 4 章学框架,第 5 章学向量库,第 6 章学 agent,第 8、9 章学出图。读完这些,他手上有一堆各自能跑的小脚本,但他不知道一个真实的产品长什么样:谁先跑、谁等谁、失败了重试几次、上下文怎么在几个环节之间传递、用户等 30 秒没响应怎么办。这些问题的答案,在第 10 章那 44 屏里,只够放一个 create_image(outline_result.title)。
第 5 章那 64 屏,也是同一个毛病。抽到的 p0405 在讲「使用托管向量数据库的步骤与设置开源 FAISS 向量存储的步骤相同」——分块、抽向量、建索引、查询时取相似记录当上下文——然后给出一段完整的 Pinecone 建索引代码:ServerlessSpec(cloud="aws", region="us-east-1")、dimension=1536、metric="cosine",还贴心地加了 if index_name not in pc.list_indexes().names() 的存在性检查。代码是干净的,坑是一个没提:免费层的索引有配额、region 选错延迟翻倍、维度写错不报错只返回垃圾、索引建好了再加数据要等冷启动。64 屏 8.7%,把这些讲完确实不够,但它至少该列一张「上线前必须确认的五个参数」——那才是读者真正卡住的地方。
p0700 倒是露出了这本书本来可以走的路。那一页在讲文档加载器,作者写了一个 ChromiumLoader 的子类,注释里坦率地写着 AsyncHtmlLoader「更快,但不一定总是可用」,然后是整套 async/await 的异步抓取,最后 create_all_summaries 返回 List[DocumentSummary]——去重、判空、异常、类型标注,一样不少。这是工程。全书的工程味,就散落在这些夹缝里,从来没被组织成一章。
七、它的短板
按严重程度排,四条。
第一,评估只有一节,等于没有评估。这是最硬的一条。p0030 把「评估质量」列为五原则之一,原话是「发现错误并对生成的内容打分,测试哪些因素可以提升性能」,但全书 735 屏里,以「评估」为名的小节只有 3.31 和 4.9 两个。第 3 章的 3.31 我只从目录知道它叫「评估标准」,具体内容不在我抽的 11 屏里;但即便它写了一整套打分方法,一节也装不下「怎么建测试集、怎么定通过线、怎么防止改 A 坏 B」。一本教人写提示词的书,最该给的是一把尺子,它给的是一盒模具。
第二,代码「读得懂、抄不了」。p0445 的 re.MULTILIN/E) 折行、p0235 的 le 独占一行、正则里多出来的 \*——这些都是排版层面的硬伤。对一本「实战」书来说,这个伤害不是美观问题,是可用性问题:读者要的是能粘进编辑器的代码,不是能看懂的代码。
第三,图像部分占了 24.6%,却是另一本书的内容。第 7 章理论 25 屏、第 8 章 Midjourney 70 屏、第 9 章 SD 86 屏。双冒号加权这类知识,是平台语法,不是提示工程原理;而抽到的这一节没有版本标注,也没有跨平台适用性的说明。读者抄走的是三个数字,不是一种方法。
第四,五条原则没有贯穿。p0030 说这五条原则「在本书的其余部分中,我们会反复引用这些原则」,但从目录看,第 2 到第 10 章的 170 条目录里,再没有一条以这五条原则命名。原则变成了开场白。这不是致命的缺陷,但它解释了为什么这本书读起来像十本小册子合订——每一册都合格,合起来没有主线。
还有一条不算短板、但值得提醒:微信读书末页(p0735)显示的推荐值是 73.5%,23 人点评。这个分数在同批技术书里属于中等偏上,说明读者认可它的实用,但没到「必读」。跟我读完的感受是一致的。
八、给要读这本书的人
最合适:手上有个具体活儿要交付的人。明天要交一个把客服对话批量转成结构化表格的脚本,或者要给团队搭一个能查内部文档的问答,这本书能让你一天内跑通。第 3 章的格式三连(JSON/YAML/过滤无效负载)和第 4 章的 LCEL 链,是全书写得最熟的部分,抄了就能用。
次合适:要给别人做内训的人。p0030 那五条原则、p0465 那张 ✓/× 表,都可以直接拿去做课件。它们的好处是短、准、不吹,一页能讲十分钟。
要当心的地方:把书里的代码当生产代码用。两个具体动作:一是所有粘贴来的代码先跑一遍 lint,遇到折行的、带 \* 的正则,按自己的意图重写;二是第 6 章的 agent 部分,把正则解析换成函数调用(书里 4.10–4.12 已经教了),这一步不做,你的 agent 上线第一天就会因为模型多说了一句话而停摆。
不合适:想学会「怎么判断一个提示词好不好」的人。这本书能让你写出格式正确的输出,但不会让你拥有判断力。要那把尺子,得去看评估相关的专门材料,或者自己老老实实攒一组测试用例——这件事没有捷径,也没有哪本书能替你做完。
读法建议:按第 1 章 → 第 3 章 → 第 4 章 → 第 5 章 → 第 6 章 → 第 10 章的顺序读,图像三章按需取用。先立原则(只有 64 屏),再练格式(130 屏是全书最值钱的一段),再上框架和向量库,最后看第 6 章和第 10 章——不是为了学会,是为了知道「一条从提示词到应用的完整链路长什么样」。第 7 到第 9 章,如果你不做图,就只读第 8 章的加权词和第 9 章的参数表,剩下的当索引。
补一句给人带团队用的:这本书最合适的用法不是「读」,是「拆」。把第 3 章的 33 节当成 33 张卡片,让你的团队各自认领一张,跑通之后写成一页内部文档——格式、参数、坑、判据四栏。三十三页攒完,你们就有了一个自己的提示词库;而这本书剩下的部分,除了 p0465 那张对照表,都不必再翻。这听起来像浪费四百多页,其实不是:一本书的价值本来就该按「能拆出多少可复用的东西」算,而不是按厚度算。
一句话:它把「怎么让模型按格式说话」讲成了一门可以照着做的手艺,却没告诉你「怎么知道它说对了」——手艺能学,尺子得自己造。
抽样核对 11 屏:p0017 排版约定(O'Reilly 体例:黑体/等宽/加粗等宽/斜体等宽分别代表什么) · p0030 1.1 五大原则概述(provide guidance/specify format/provide examples/evaluate quality/divide labor 中英对照) · p0110 2.8 量化与 LoRA(量化降低参数数值精确度以缩小模型规模;LoRA 优化网络架构;面向个体开发者与初创公司) · p0235 第 3 章末(
most_frequent_classification:字典计数取最大,多数投票;# 预期输出:Neutral;le 断行) · p0255 4.2 聊天模型(from langchain_openai.chat_models import ChatOpenAI;「不建议在脚本中硬编码 API 密钥」) · p0335 4.21 文本分割(RecursiveCharacterTextSplitter(chunk_size=300);split_documents 与 create_documents;metadata 字典列表) · p0405 第 5 章 Pinecone(dimension=1536;metric="cosine";ServerlessSpec(cloud="aws", region="us-east-1");注释「使用与 text-embedding-ada-002 相同的向量维度」) · p0445 第 6 章(extract_last_action_and_input:re.compile(r"(?i)action\s*\*:\s*\*([^\n]+)", re.MULTILINE);re.MULTILINE 折行) · p0465 第 6 章末框架对照表(单工具执行/易于实现/并行函数调用/迭代式思维过程/多意图处理/按顺序执行工具/可定制提示词,七项两列打勾打叉) · p0560 8.6 加权词(Golden Gate Bridge::1 … Van Gogh::0.8 … Dali::0.2;「位于提示词开头的词通常影响更大」) · p0700 第 10 章(ChromiumLoader 子类;AsyncHtmlLoader 注释「更快,但不一定总是可用」;create_all_summaries → List[DocumentSummary]) · p0725 第 10 章(图 10-5 多元文化拼贴示例;create_image(outline_result.title)) · p0735 末页(已读完 8 分钟;推荐值 73.5%;23 人点评)说明:篇幅占比由 pages.jsonl 逐页章节映射聚合而得(前置 23 屏 3.1%;第 1 章 64 屏 8.7%;第 2 章 31 屏 4.2%;第 3 章 130 屏 17.7%;第 4 章 115 屏 15.6%;第 5 章 64 屏 8.7%;第 6 章 83 屏 11.3%;第 7 章 25 屏 3.4%;第 8 章 70 屏 9.5%;第 9 章 86 屏 11.7%;第 10 章 44 屏 6.0%;合计 735 屏。文本三章 309 屏 42.0%;图像三章 181 屏 24.6%)· 抽样率 11/735 ≈ 1.5% · 第 2、7、8、9 章部分小节仅按目录与篇幅核对,未逐字展开 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: