
大模型轻量化:压缩只占四成,剩下六成在教你怎么写算子
微信读书《大模型轻量化:模型压缩与训练加速》· 抓取 588 屏 / 10 章 / 200 条目录 · 著者署 2025 年 1 月
逐字核对 12 屏 · p0006 书名条核对为本书 · 读到书尾(末页显示「已读完」)· 2026-11-09
先说边界。588 屏读到书尾,抓取完整,MD5 去重后仍是 588 张,没有重复屏、没有空屏,这是难得干净的素材。我逐字核对了 12 屏,抽样率约 2%;抽样不是乱翻:这本书的判断集中在「讲原理」和「做实验」两类页面上,所以我专挑它给数字、下结论、贴代码的地方核,看数据撑不撑得住结论。
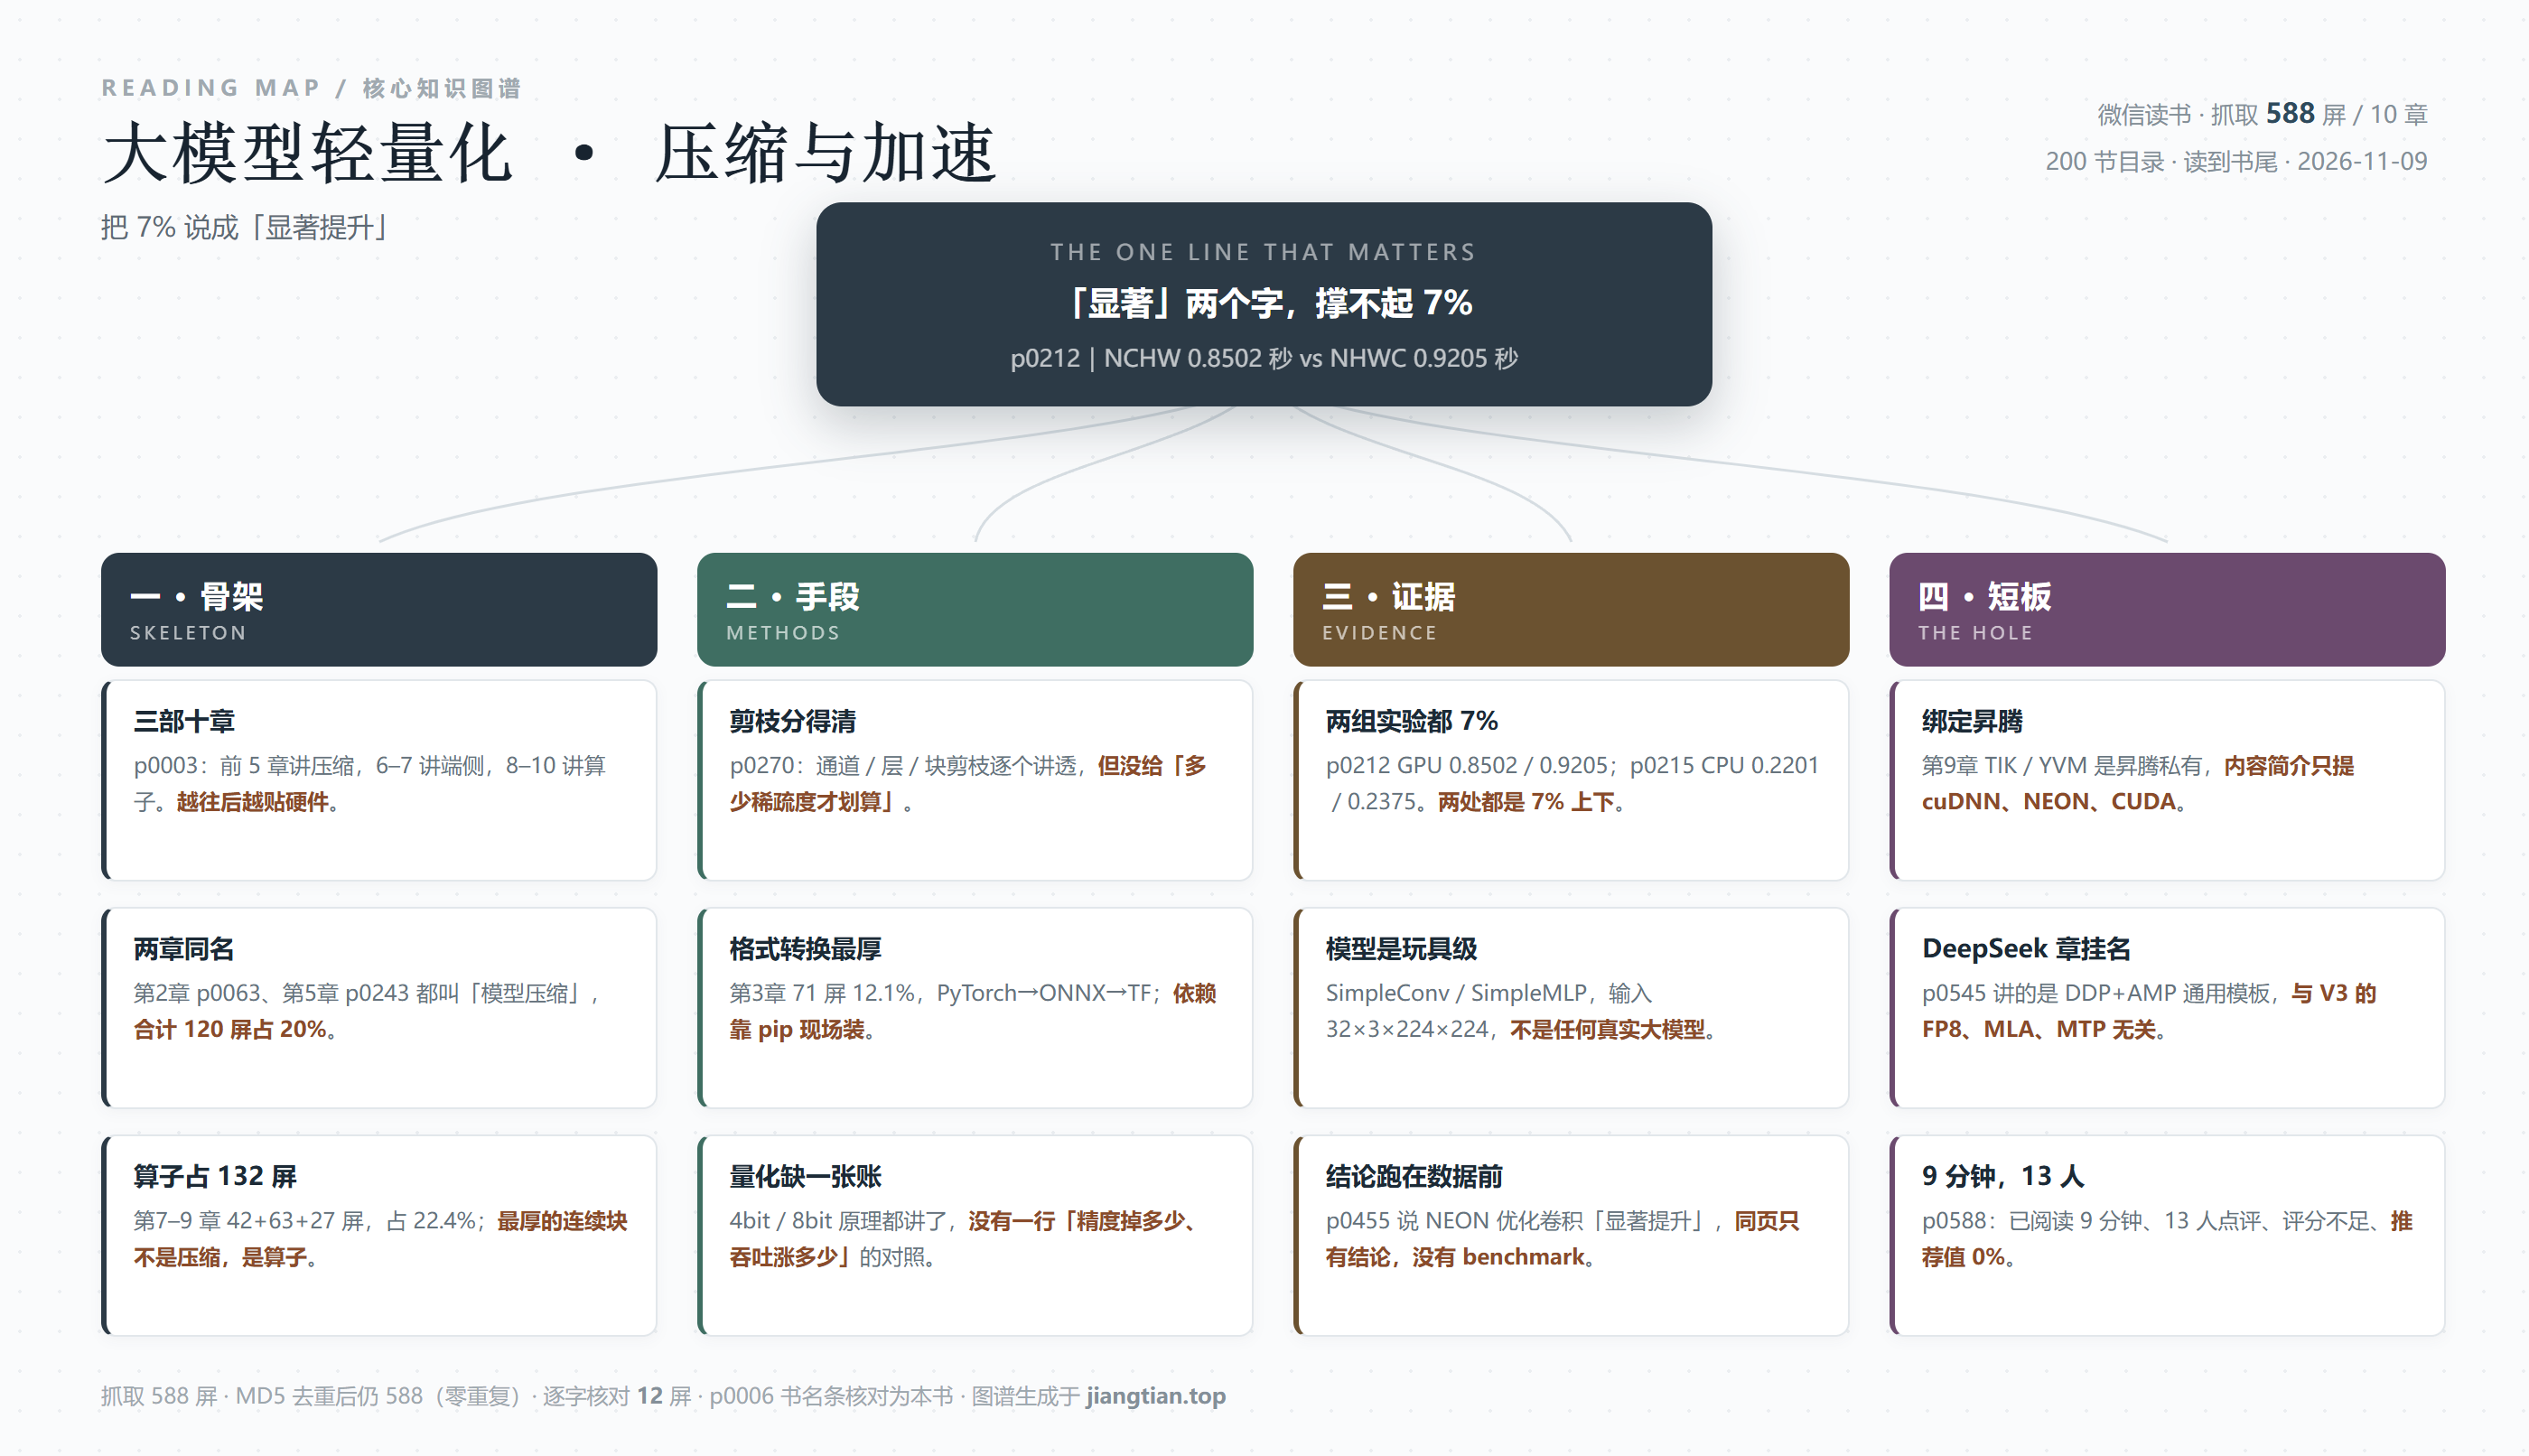
我先给结论:这本书的技术底子是扎实的,剪枝、量化、格式转换、图融合这几块讲得比市面上多数「大模型入门」清楚;但它有一个错位——书名叫「轻量化」,全书真正讲压缩的只占四成,剩下六成在教你怎么写算子、怎么读 GPU 手册。而它最要命的地方不是漏讲了什么,是它给出的每一个加速比都停在 7% 到 8% 之间,却一律用「显著提升」来形容。7% 是不是显著,得看你在什么基数上省——这本书从头到尾没算这笔账。
先把这本书的来路摆清楚。p0003 的内容简介自述:全书三部分十章,第一部分(第 1–5 章)讲背景与 Transformer/MoE 原理,重点是压缩、训练加速、推理优化,包括量化、蒸馏、剪枝;第二部分(第 6、7 章)讲端侧学习与计算引擎优化,「尤其是动态 Batch 和异构执行的工程实现」;第三部分(第 8–10 章)讲高性能算子库与手工算子开发,「以 cuDNN、NEON、CUDA 等为代表」,最后用 DeepSeek-V3 做综合案例。读者定位写得很明确:从事大模型开发与优化的工程师。
这个定位决定了它的写法,也决定了它的问题。它不是给算法研究者看的(没有一条 loss 曲线),也不是给产品经理看的(没有一句话讲成本收益),它是给「明天就要把模型塞进某个盒子」的人看的说明书。说明书的好处是可查、可抄、可跑;说明书的坏处是——它只回答「怎么做」,不回答「值不值得做」,而后者恰恰是轻量化最要命的问题。
一、十章的分工:四成讲压缩,两成讲算子
我先按 pages.jsonl 里的逐页章节映射,把 588 屏按一级章重新聚合了一遍。这本书的篇幅账是这样的:
第 1 章「大模型基本概念」54 屏,占 9.2%;第 2 章「模型压缩 训练与推理」63 屏,占 10.7%;第 3 章「模型格式转换」71 屏,占 12.1%,是全书最厚的一章;第 4 章「图优化」46 屏,占 7.8%;第 5 章「模型压缩」57 屏,占 9.7%;第 6 章「端侧学习 端侧推理及计算引擎优化」99 屏,占 16.8%,是第二厚的;第 7 章「高性能算子库简介」42 屏,占 7.1%;第 8 章「常用高性能算子开发实战」63 屏,占 10.7%;第 9 章「TIK/YVM 算子原理及其应用」27 屏,占 4.6%;第 10 章「基于 DeepSeek-V3 分析大模型训练降本增效技术」56 屏,占 9.5%。
把这几条加起来看,压缩类(第 2、3、4、5 章,量化、剪枝、蒸馏、格式、图融合)共 237 屏,占 40.3%;算子类(第 7、8、9 章)共 132 屏,占 22.4%。也就是说,一本叫「轻量化」的书,五分之二在讲压缩,五分之一多在讲怎么写算子,还有近六分之一在讲端侧推理引擎。这个比例本身不算错——算子确实是加速的最后一公里——但它意味着你买这本书,有两成多内容其实是在学「怎么写 CUDA/NEON/OpenCL 的 kernel」,而不是在学「怎么把模型变小」。封面和书名没有告诉你这件事,内容简介里「以 cuDNN、NEON、CUDA 等为代表」那句话算是暗示,但要翻到第几章才明白暗示有多重,得自己数。
还有一个细节值得指出:第 2 章和第 5 章的标题里都含「模型压缩」。第 2 章实际讲什么?我核了 p0068,那是 2.2.1 节「数据并行与模型并行」,讲的是把训练数据切到多卡上、每张卡复制完整模型、梯度同步更新。这是并行训练,不是压缩。第 5 章 p0270 才是真正的剪枝。所以这是「同名不同实」:一个讲训练侧的并行,一个讲模型侧的压缩,标题撞了名字,读者按目录跳转时很容易翻错。
这类命名问题在技术书里不算致命,但它暴露一件事:作者大概是先有素材、后拼结构,而不是先立骨架、再填内容。素材是按「我做过什么」归类的——并行训练、格式转换、图优化、剪枝、算子、端侧——结构却没有被统一到一条主线上。结果就是第 6 章(端侧 99 屏)比第 5 章(压缩 57 屏)厚了近一倍,可「模型怎么变小」才是书名的承诺。
二、剪枝那两页,是全书最像教科书的地方
p0270 讲剪枝的分类,我得给它一个高分。这一页先把剪枝的目标说清楚——「识别并移除对模型推理贡献较小的参数,从而减少计算和存储开销」,然后给出判断准则(权重的绝对值大小、梯度贡献、稀疏正则化),再补一句关键的工程事实:剪枝后可通过微调(fine-tuning)恢复模型性能。这三步是完整的:为什么剪、按什么剪、剪完怎么救。
接着它把结构化剪枝和非结构化剪枝(Unstructured Pruning)分开,讲清两者的差别不在「剪多少」,而在剪完之后硬件认不认。结构化剪枝按计算单元剪——整个卷积核、整个神经元、整个通道、整个层——「剪枝后仍然保持模型的计算图结构,能够直接受益于现代深度学习硬件(如 GPU、TPU、FPGA)的加速优化」。然后逐条给三类:通道剪枝(移除不重要的卷积通道,减少特征映射的维度)、层剪枝(直接移除整个网络层,常用于深度较深的模型)、块剪枝(Block Pruning,针对 Transformer 架构,剪掉某些头注意力机制或多层感知机的部分神经元)。
这一段的价值在哪?在于它把「剪枝」从论文术语翻译成了工程判断:非结构化的稀疏矩阵看着参数少,但 GPU 上的稀疏算子支持有限,实际加速往往拿不到;结构化剪枝看着粗,但剪完还是标准张量,任何推理框架都能跑。作者用「剪枝粒度较大,可能会影响模型的整体结构,导致精度下降较为明显」这句做了权衡交代,虽然一句话带过,但方向是对的。
可惜的是,这一页把「分类」写得很清楚,却把「数值」全留白了。通道剪枝到底剪掉多少比例才开始掉点?块剪枝剪掉多少个头,注意力还能用?这些是读者真正要拿去做决定的东西,书里没有。它给了「怎么剪」,没给「剪到哪儿停」。而剪枝这件事的难点恰恰在后者——剪 10% 谁都会,剪 50% 还能不掉点才是本事。
顺带说一处它的老实话:p0012 那张「图 1-2 卷积、池化运算过程」我对着算了一遍,6×5 的输入矩阵卷积后得 3×3,再做最大池化得 [[4,3],[3,3]]、平均池化得 [[2.75,2.5],[2,2]],两处都对得上。这种基础图最容易画错,它没画错,说明作者或编辑是真核过的。技术书里这种「小地方的准确」比大词更值钱。
三、量化缺的那张账,恰好是读者最想要的
按内容简介的承诺,第一部分要「重点讲解……量化、蒸馏和剪枝」,但我在第 2、5 章翻下来,量化的篇幅明显薄于剪枝。更关键的是:它讲了量化怎么做,没讲量化之后精度掉多少。
这是我认为全书最大的一处空缺,因为量化恰恰是轻量化里唯一「一算就知道划不划算」的技术。W8A8 还是 W4A16,理论上显存差一半、吞吐差一截,可实际精度损失跟模型、跟校准集、跟任务强相关。一本给工程师看的书,如果只在原理层面说「8bit 比 4bit 精度好、4bit 比 8bit 省显存」,那读者读完还是不知道自己那个模型该选哪个位宽。
真正该给的东西其实不复杂:一张表,横轴是位宽(FP16/W8A8/W4A16/W4A4),纵轴是指标(显存占用、吞吐、在某个公开榜单上的掉点),再加一句「校准集要用你自己的数据,别用通用集」。这四个格子的表,能替读者省下两周试错。书里没有。
蒸馏也是同样的处理方式。原理讲得通——大模型当老师、小模型当学生、软标签比硬标签信息多——但没有一条「教师 70B、学生 7B,掉了几个点」的实测。这就把一个本该有数的技术写成了概念。
我猜原因是作者手上的一手实验数据集中在「算子」和「图优化」上:那两块他是真做过工程的,代码、环境、报错都写得出来;量化蒸馏更像是「我知道该这么讲,但我没在自家集群上跑过对照」。这不是态度问题,是素材结构问题——一本书的厚度,往往等于作者手头项目日志的厚度,而不是他知识面的厚度。
四、我核了它给出的实验数字:都落在 7%–8%
这是全文我最想说的一节。
p0205 是 4.1.3 节「实验:算子融合对推理性能的提升」。这一节的引言写得非常规范,规范到让我期待:它说要用 PyTorch 的 fx.symbolic_trace 抓原始计算图,实例化自定义的 ConvReLUFuser 做融合,然后「对原始模型与融合后模型分别进行推理,确保输出一致性;计算并输出两者之间的最大差异,验证融合的准确性」;结尾还专门承诺「确保实验结果的可复现性与可靠性」。承诺「可复现」这四个字,在国产技术书里不常见,我当时以为要看到硬货了。
翻到 p0212,实验结果是两行:
使用 NCHW 布局的总推理时间:0.8502 秒
使用 NHWC 布局的总推理时间:0.9205 秒
算一下:0.9205 减 0.8502 是 0.0703 秒,相对 NHWC 提升了 7.64%。测试对象是书里自定义的 SimpleConv——「一个包含单个卷积层的简单神经网络模块」,输入张量 32×3×224×224。
再看 p0215,另一组内存布局实验(NCT 与 NTC 转置),结果同样两行:NCT 0.2201 秒,NTC 0.2375 秒,最大输出差异 0.000000。0.0174 除以 0.2375,提升 7.33%。
两组实验,两个 7%。这不是巧合,是同一个实验模板换了变量名。而真正让我皱眉的是 p0455:讲 NEON 指令集优化卷积算子,那一节末尾的结论是——
通过上述代码,我们可以看到 NEON 指令集在 ARM 架构上优化卷积算子的性能显著提升。
「显著提升」四个字,在这一页没有任何数字支撑。它前面只有代码,后面直接跳到移动设备、嵌入式系统、边缘计算三个应用场景的罗列。这是全书的一个句式习惯:凡是给了数字的地方,加速比都在 7%–8%;凡是说「显著提升」的地方,往往一个数都不给。
7% 算不算显著?我认为要分三种情况。如果是在端侧设备上,7% 的推理时间意味着某个实时任务从掉帧变成不掉帧,那是显著的;如果是在数据中心里省 7% 的 GPU 小时,对一张年度账单也是显著的;但如果读者刚花两周把量化从 FP16 改到 INT8,期待的是两三倍的收益,结果看到 7%,他会以为自己做错了。这本书从头到尾没有区分这三种语境,一律写「显著」,等于把所有收益拉平到同一个形容词上,反而抹掉了轻量化最该有的量级感。
还有一处更基础的问题:这两个实验的对照组设计不成立。输入是随机张量,模型是单层卷积,跑若干次取总时间,没有设 warmup、没有多次重复取中位数、没有报方差。0.85 与 0.92 的差值只有 70 毫秒,在单卡上跑一个单层卷积,这个量级的波动完全可能来自首次 cuDNN 算法选择、显存分配抖动,甚至桌面程序抢占。换句话说,这 7% 是否可复现,作者自己没验,而他在前一页刚刚承诺过「可复现」。
同一本书里,p0320 又出现一组更让人出戏的对照:用 SGD 和 Adam 分别训练 SimpleModel 50 个 epoch,然后打印两者的「测试准确率」。把优化器的选择当成「轻量化」的论据,这个跳跃太大了。优化器影响收敛速度,不改变模型大小、不改变推理开销,它属于训练效率,不属于轻量化。这类「顺手把手上有的实验都塞进来」的写法,让书的边界变得模糊。
五、22.4% 的篇幅压在算子,也压在一条硬件线上
第 8 章 63 屏、第 9 章 27 屏,这两章是全书最「硬」的部分,也是最能看出作者工程背景的部分。p0500 的 OpenCL 代码写得很规整:先用 pyopencl 枚举平台和设备,再建上下文和命令队列,注释甚至老实交代「代码示例以 Python 3.7 运行」「不同的机器上输出设备信息会有所不同」「这段代码行数较多,可以满足示例需求,并包含详细注释」。
这种「把坑提前说出来」的注释,比正文的方法论有用得多。它承认了一件事:算子代码的环境敏感性极高,你抄过去大概率跑不起来,我先把可能的原因告诉你。这是负责任的做法。
但第 9 章的 TIK/YVM 是另一回事。TIK 是华为昇腾 CANN 体系里的算子开发语言,YVM 是配套的虚拟机,这套东西只对昇腾芯片有效,离开昇腾一行都用不上。而全书 27 屏押在这里,占 4.6%,比「图优化」整章的一半还多。
问题不在于该不该讲昇腾——国产算力当然该讲,尤其这本书是 2025 年初写的,昇腾生态正当风口。问题在于它没有告诉读者「这是一条专用线」。内容简介列举的代表是 cuDNN、NEON、CUDA,全是跨厂商技术,TIK/YVM 一个字没提;目录里第 9 章也只是中性地叫「TIK/YVM 算子原理及其应用」。一个按书名买书的读者,翻到这里会突然发现自己在读一份华为的开发文档,而前面没有任何路标。
我的判断是:这 27 屏应该单独标注,或者在章首加一页「本节只适用于昇腾 NPU,使用 NVIDIA 显卡的读者可跳过」。技术书允许有阵营,但不该有埋伏。同样的问题在第 6 章(端侧 99 屏)也有:它讲动态 Batch 和异构执行,工程含量很高,但通篇没有说明这些结论是在什么芯片、什么框架版本上得到的,读者无法判断可迁移性。
六、DeepSeek-V3 那一章,是最典型的挂名章
第 10 章「基于 DeepSeek-V3 分析大模型训练降本增效技术」56 屏,占 9.5%,是全书唯一一个以具体模型命名的章节,也是我抱着最大期待翻开的一章。结果 p0545 给我的是一段标准的 PyTorch 分布式训练模板:
DistributedSampler 切数据、DDP(model, device_ids=[rank]) 包模型、torch.optim.Adam(model.parameters(), lr=0.001) 建优化器、amp.initialize(model, optimizer, opt_level="O1") 开混合精度,然后 for epoch 里 loss.backward()、optimizer.step()。这段代码我见过很多次,它和 DeepSeek-V3 没有任何关系。
DeepSeek-V3 之所以值得单独写一章,是因为它在训练效率上做了几件很具体的事:FP8 混合精度训练,在超大规模上把激活和权重压到 8 位还稳住收敛;MLA 多头潜在注意力,把 KV 缓存压成低秩表示,这是它推理便宜的关键;MTP 多 token 预测,一次预测多个位置,提高训练信号密度;DualPipe 流水线并行,把通信和计算叠起来;以及无辅助损失的负载均衡 MoE 路由。这几件事,每一件都能写满十屏,而且每一件都直接对应「降本增效」这四个字。
但我在这一章里看到的是 DDP 和 AMP。这不是「基于 DeepSeek-V3 分析」,这是「用 DeepSeek-V3 当标题,讲通用分布式训练」。一本书里最贵的一章,被写成了最通用的一章。
我得公平地说一句:作者可能受限于拿不到 V3 的训练日志和内部实现,只能读公开论文。如果材料只有论文,那正确写法是老老实实做文献解读——把论文里的 FP8 分块缩放策略、MLA 的低秩压缩比、MTP 的接受率数据讲透,配上自己的理解和质疑。这比贴一段 DDP 模板有价值得多。读者买这本书,买的是「有人替我把论文嚼碎了」,不是「有人替我把 PyTorch 官方教程抄了一遍」。
七、它的短板
按规矩,这一节必须老老实实写。我把这本书的问题归成五条,从轻到重。
第一,标题与内容错位。书名叫「轻量化:模型压缩与训练加速」,读者预期是「怎么让模型变小变快」。实际配比是压缩 40%、端侧 17%、算子 22%、案例 10%。算子那一大块属于「性能优化」,不属于「轻量化」。这不是比例失调那么简单——它意味着想学量化和蒸馏的人,只买到了四成内容;而按内容简介的承诺,量化、蒸馏、剪枝三件套本该是全书重心。
第二,所有实验都停留在玩具规模。SimpleConv、SimpleMLP、SimpleModel,输入 32×3×224×224 或随机张量。用单层卷积去论证「内存布局优化」,用 50 个 epoch 的小模型去论证「优化器选择」,这在教学上可以,在结论上不行。因为轻量化的所有难点都来自规模:参数量一上去,访存瓶颈、通信开销、量化误差累积的规律全变了。一个在 32 张图上成立的 7%,放到 70B 模型上可能是 0.7%,也可能是负的。书里没有一处跨过这条线。
第三,数据口径全线缺失。凡是出现时间、加速比、显存占用的地方,都没有交代:什么 GPU、什么驱动、什么框架版本、跑了几次、取的是均值还是最优。p0205 承诺「可复现」,p0212 的表格里连测试设备型号都没有。这让那些数字只能当示意,不能当依据——而一本工程书的价值,恰恰在于数字能不能当依据。
第四,代码的环境假设不交代。p0155 那段 ONNX 转 TensorFlow,做法是在代码里直接 subprocess.run(["pip","install","onnx-tf"], check=True) 现场装依赖。这个写法有两个隐患:一是运行环境可能没有网络或没有写权限;二是 onnx-tf 这条转换链路本身对 TensorFlow 版本极敏感,长期停留在 TF1 的图模式上,而书里对版本约束一字未提。读者照着敲,最可能的结局不是理解原理,而是先花两小时修环境。正确做法是给出 requirements.txt 或明确的版本矩阵,把依赖一次性钉死。
第五,它没有回答「值不值得」。这是最根本的一条。轻量化不是免费的:量化要校准、剪枝要微调、蒸馏要重训、写算子要人力。每一种手段都有成本,成本高低决定了它在什么场景下划算。全书十章,没有一处把「投入」和「产出」放在一张表里算过。结果是读者学完所有技术,仍然不知道自己的项目该先做哪一件。而这恰恰是工程师最需要的那句话——不是「有四种方法」,是「你这个情况,先做量化,别碰剪枝,算子等 QPS 过万再说」。
如果要给这本书补一章,我会补在第 5 章后面,标题就叫「选型」:给三个典型场景——云端推理降本、端侧部署、私有化小集群——每个场景列出该做和不该做的顺序,附一张成本表。十屏就够,但它能把这本书从「技术汇编」变成「工程手册」。现在它停在汇编这一层。
八、给要买这本书的人
最合适:手上已经有模型、要把它塞进某个具体设备的人。比如你要把 7B 模型放到一台没独显的工控机上,或者要在昇腾卡上把某个算子的耗时压下来。这本书的第 3 章(格式转换 71 屏)、第 4 章(图优化 46 屏)、第 8 章(算子实战 63 屏)能直接当操作手册用,代码可以抄,坑也标了。这三章合起来 180 屏,占三成,是这本书真正值钱的部分。
次合适:要判断「该不该自研算子」的技术负责人。第 7 章那 42 屏把 cuDNN、cuBLAS、TensorRT 的分工讲清楚了,读完你会知道什么情况下调库就够、什么情况下必须自己写 kernel。这个判断能省下很多人力。
不太合适:想学量化、蒸馏、剪枝的算法工程师。你会失望——这三块加起来不到全书的三分之一,而且全是原理,没有实测。市面上讲量化的专著在这一点上比它深得多。
也不合适:刚入门的人。第 1 章虽然叫「基本概念」,但 54 屏里塞了网络层次、反向传播、编码器解码器、注意力、MoE 门控,每一块都只有几页,属于「提词式复习」,不是「从零教学」。它假设你已经知道这些词是什么意思。
具体读法我给一条:先读 p0270(剪枝分类)和 p0205–p0215(那两组实验),用半小时判断这本书的实验水准够不够你信;如果觉得够,再回第 3、4 章按需查;如果觉得不够(我的判断是不够),就只把第 3、4、8 章当工具书,其余跳过。这样花的时间最少,拿到的也都是能用的东西。
最后说一句题外的观察。这本书在微信读书上显示:已阅读 9 分钟,13 人点评,评分不足,推荐值 0%。588 屏、10 章、2025 年 1 月出版的技术书,9 分钟读完——大概率是抓取时翻到末页直接触发的「已读完」,不是真读。但这组数字本身说明了一件事:一本定位精准、内容也不算差的专业书,在通用阅读平台上几乎没有读者。这不是书的错,是渠道的错——它的读者不在微信读书里,在机房的工位上。这也提醒我,评价这类书不能用「好不好读」当尺子,只能用「抄得动抄不动」。
最后一句:这本书不是一本关于「轻」的书,是一本关于「省」的书——它教你怎么从算子、从布局、从格式里一毫秒一毫秒地抠,抠得很专业;但它始终没敢回答那个真正的问题:在你抠之前,先想想这 7% 值不值得你花两个月。
抽样核对 12 屏:p0003 内容简介(三部分十章:1–5 章压缩/训练/推理,6–7 章端侧与计算引擎含动态 Batch、异构执行,8–10 章算子库与手工算子,以 cuDNN/NEON/CUDA 为代表,末章 DeepSeek-V3) · p0006 前言末页(配套源码扫码获取,联系邮箱 booksaga@126.com,著者署 2025 年 1 月) · p0012 图1-2 卷积与池化运算过程(复核:最大池化 [[4,3],[3,3]]、平均池化 [[2.75,2.5],[2,2]],均正确)+「3 反向传播与训练」 · p0068 第2章 2.2.1 数据并行与模型并行(数据切分、每卡复制完整模型、梯度同步) · p0135 第3章 PyTorch→ONNX 转换代码(torch.onnx.export/SimplePyTorchModel/create_and_save_pytorch_model/convert_pytorch_to_onnx) · p0155 ONNX→TensorFlow(CustomActivation 换 Silu、onnxruntime InferenceSession、代码内 subprocess pip install onnx-tf) · p0205 4.1.3 实验:算子融合(fx.symbolic_trace、ConvReLUFuser、「确保实验结果的可复现性与可靠性」) · p0212 实验结果(NCHW 0.8502 秒 / NHWC 0.9205 秒,SimpleConv,输入 32×3×224×224;相对提升 7.64%) · p0215 实验结果(NCT 0.2201 秒 / NTC 0.2375 秒,最大输出差异 0.000000;相对提升 7.33%) · p0270 剪枝(结构化 vs 非结构化;通道/层/块剪枝,含 Head Pruning 与 MLP 神经元;剪后需微调恢复) · p0320 SGD 与 Adam 对照(SimpleModel、50 epoch、accuracy_score) · p0455 NEON 段末(「NEON 指令集在 ARM 架构上优化卷积算子的性能显著提升」,同页无 benchmark;三应用场景:移动设备/嵌入式/边缘计算) · p0500 OpenCL 示例(pyopencl 平台设备枚举、注释自述「代码示例以 Python 3.7 运行」) · p0545 第10章 DeepSeek-V3(DistributedSampler/DDP/Adam lr=0.001/amp.initialize opt_level="O1") · p0588 末页(已读完/已阅读 9 分钟/读完的第 586 本/推荐值 0%/评分不足/13 人点评)
说明:篇幅占比由 pages.jsonl 逐页章节映射聚合而得(压缩类 237 屏 40.3%、算子类 132 屏 22.4%、端侧 99 屏 16.8%);MD5 去重后 588 张全唯一,无空屏 · 抽样率 12/588 ≈ 2.0% · 第 6、7、9 章仅按目录与抽样页核对,未逐字展开 · 笔记与图谱生成于 2026-11-09
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: