
Claude Code技术架构深度解析:它卖的不是模型,是裹在模型外面的那层壳
微信读书《Claude Code技术架构深度解析:Harness工程与AI编程新范式》· 抓取 401 屏 / 5 篇 13 章 / 102 条目录
逐字核对 13 屏 · p0006 书名条核对为本书 · 全书读到末尾 · 2026-11-09
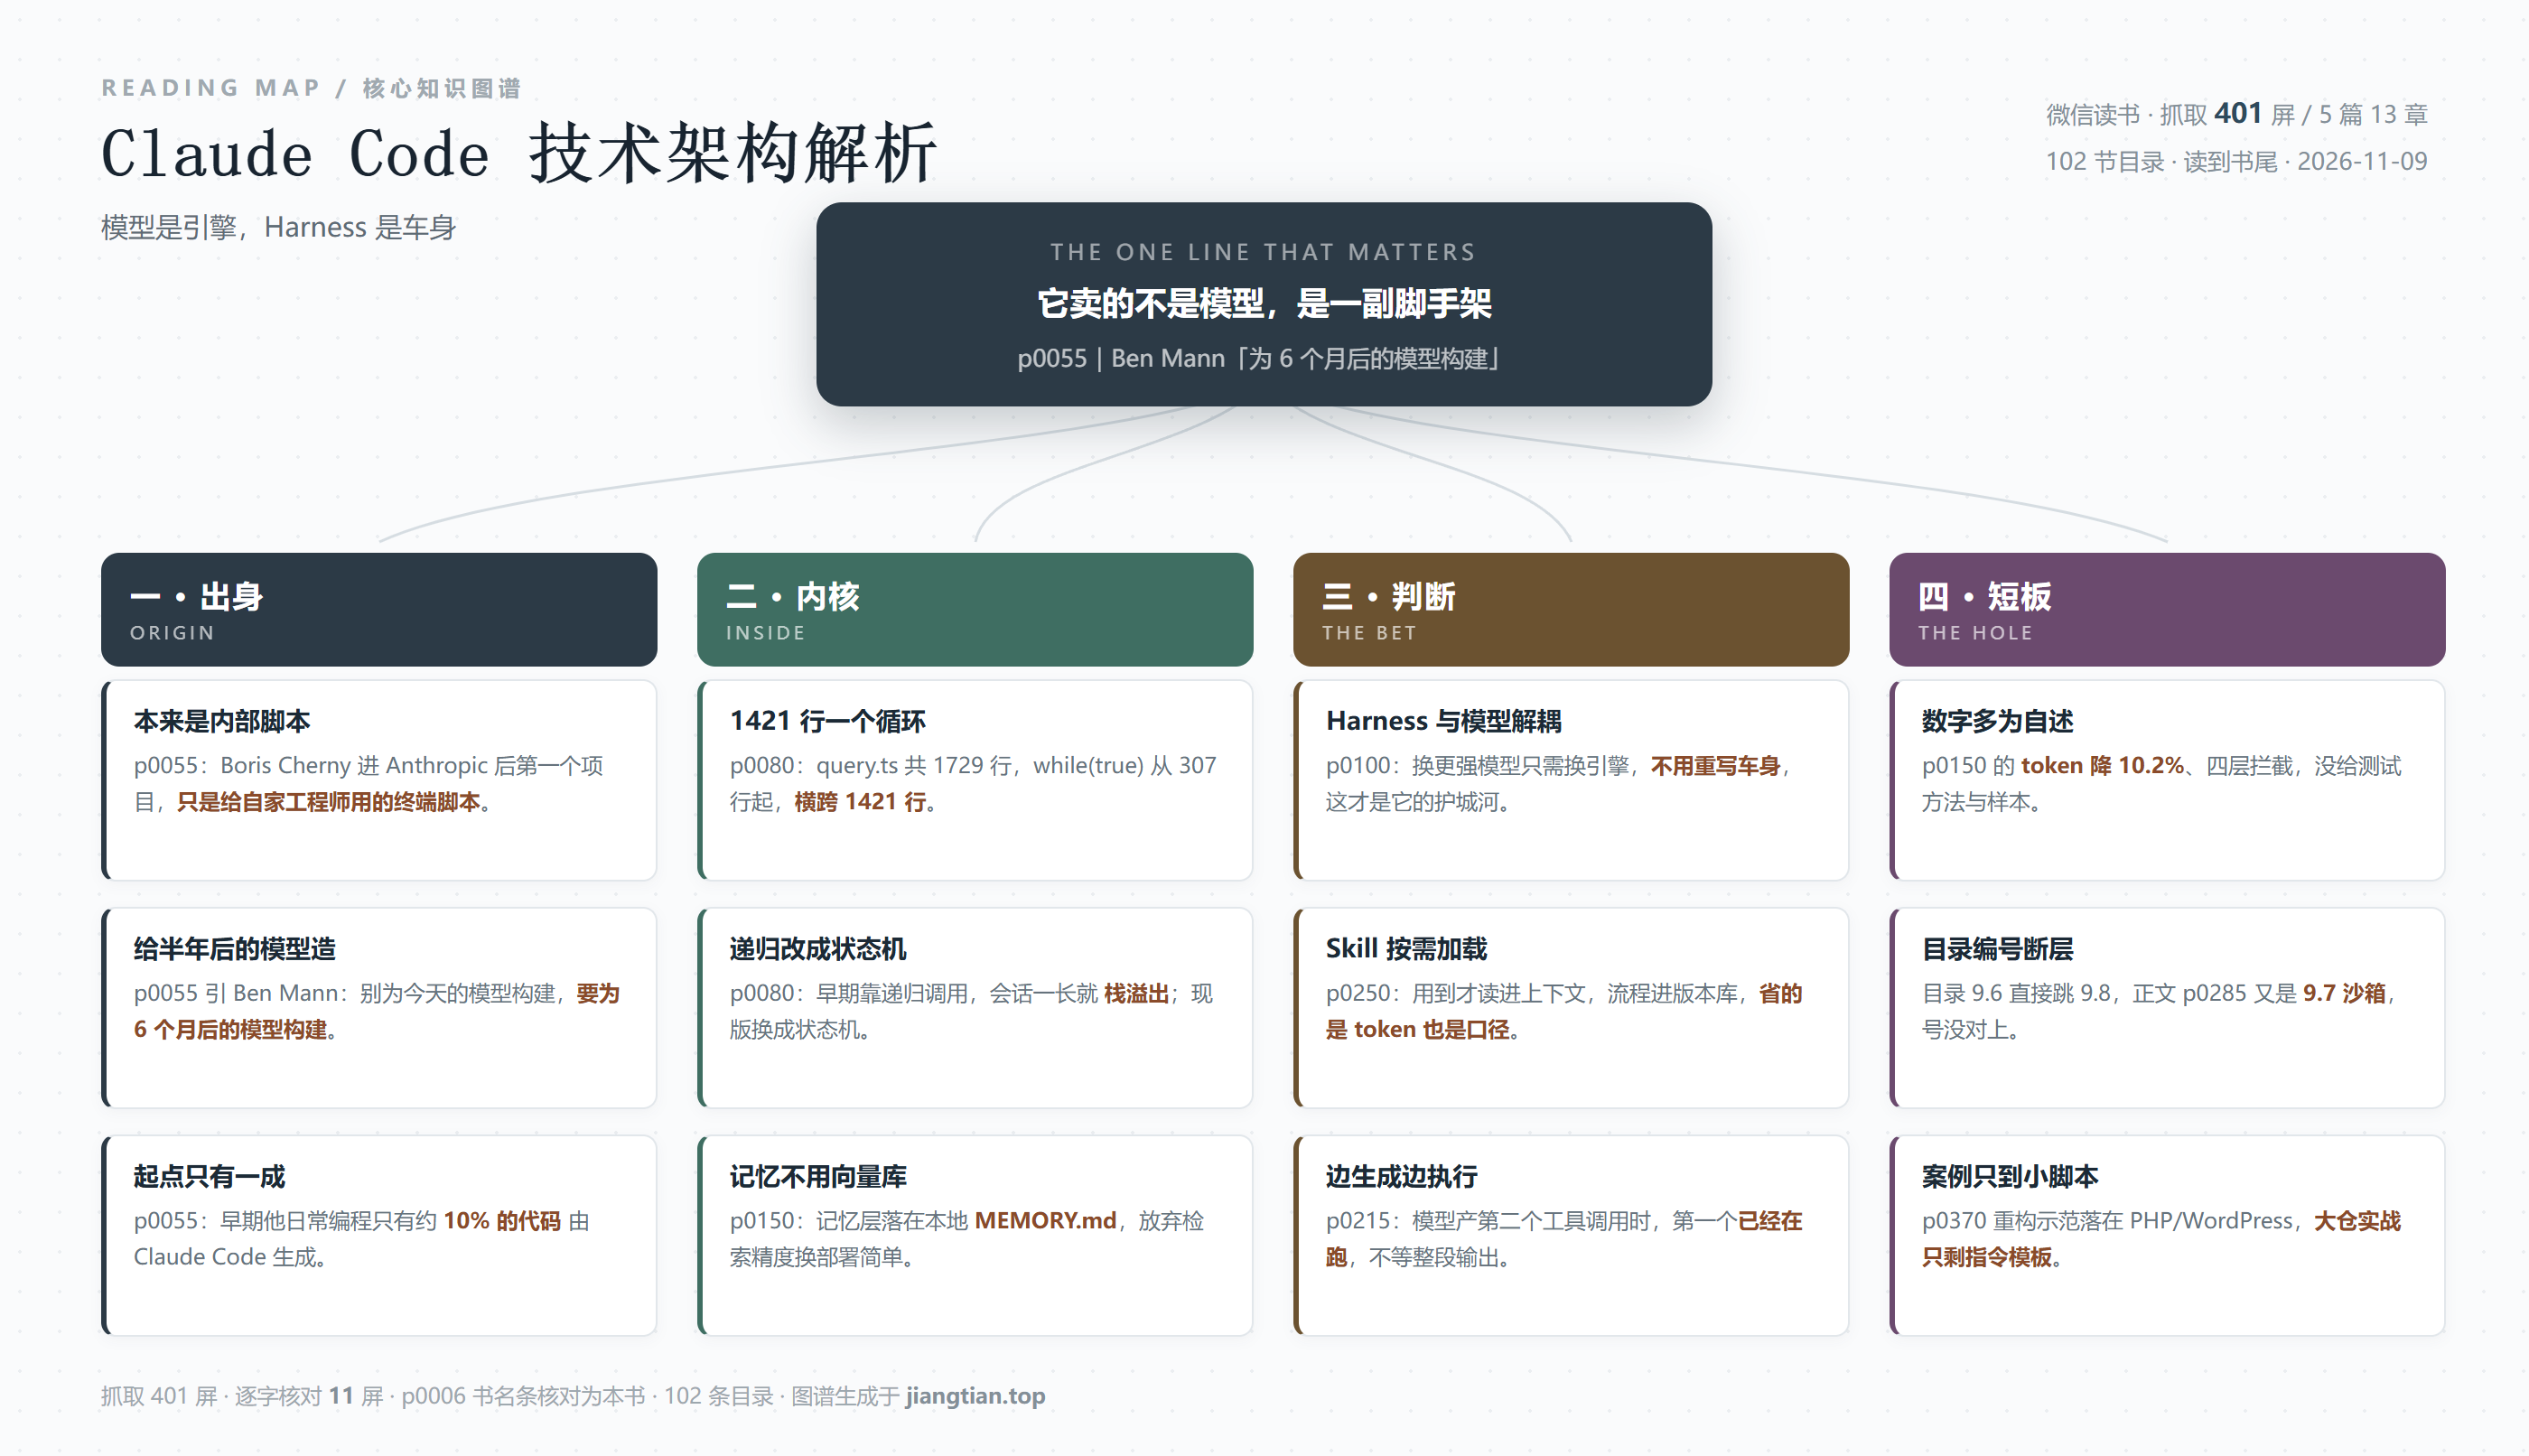
先说边界。401 屏从版权页一路走到第 13 章小结,meta 里 102 条目录、5 篇 13 章都对得上,抓取完整。我逐字核对了 13 屏,抽样率约 3.2%,抽样标准不是随机翻,而是专挑「作者给了具体数字和源码行号」的页面——这类架构书的可信度全押在这两种证据上。核对下来,两种证据都有,但都缺一样东西:版本号。
我先给结论:这本书真正想说的只有一件事——Claude Code 卖的不是 Claude,是裹在 Claude 外面的那层壳。它用 12 层封装、14 步执行、三级压缩,反复论证同一个命题:模型能力是外部变量,工程结构才是产品。这个命题是对的,也比市面上绝大多数「AI 编程工具评测」有价值。问题是,它用来证明这个命题的全部证据都不可复核——没有版本号,没有测试环境,没有一行读者能跑通的代码。
它最像一份产品拆解报告:把 Claude Code 这个闭源分发的产物当黑盒,从行为反推结构,再用「Harness 工程」这个概念把反推出来的结构串成一套说法。第 3 章定义概念,第 4 章给总图,第 5 到 9 章按模块拆(工具、权限、观察反馈、协作记忆、交互扩展),第 10、11 章回到用户视角,第 12、13 章谈趋势。好处很明显:它把「AI 编程」从玄学拉回了工程。这个领域里绝大多数讨论还停在「模型有多强」「提示词怎么写」,而它一上来就把注意力挪到了上下文怎么组装、工具怎么调度、权限怎么拦截、上下文怎么压缩——这四件事恰好是模型厂商不会写进发布博客、却决定你日常体验的四个地方。
一、那句被引用两次的话,才是全书的地基
p0055 讲 Claude Code 的诞生,是全书最值钱的一页。它写了三件事:2023 年在 ChatGPT 引发的浪潮下,Boris Cherny 决定加入 Anthropic,书里引了他的原话——「我读了很多科幻小说,对AI可能带来的风险有深刻的认知。Anthropic 是我唯一想去的地方,因为我想在这里,以最小巧的方式,确保这件事情能够顺利进行。」
第二件,他进公司后的第一个重要项目,是「一款内部使用的 AI 编程工具」,书里说「该工具最初只是一个简单的终端脚本」。第三件最关键:项目早期模型能力有限、实际效果并不理想,他日常编程中只有约 10% 的代码由 Claude Code 生成。这时他的经理 Ben Mann(Anthropic 联合创始人之一)给了一句指导:
不要为今天的模型而构建,要为 6 个月后的模型而构建。
这句话在 p0100 又被引用一次,并落成两条设计:模型无关的架构(Harness 体系与具体模型解耦,新一代模型发布时可无缝切换,无须重构核心架构)、可扩展的工具系统(统一 Tool Interface 接口,新增工具只需按规范接入,不改动 Agent Loop)。
我想在这儿停一下,因为这句话常被读成鸡汤。它其实是一条成本极高的赌注:为 6 个月后的模型构建,直接含义就是你今天交付的东西在当下的模型上一定跑得不够好。10% 就是代价。一个团队愿意在主力工具只有一成采纳率时继续投入,靠的不是乐观,是判断——模型能力会沿可预测的曲线往上走,而工程结构一旦定型就很难改。宁可让今天的体验难看,也不让结构迁就今天的模型。
副产品是全书最值得学的一课:当模型是变量时,唯一能沉淀成资产的是不依赖模型的部分。对读者有直接操作含义——写在提示词里的技巧三个月过期,写在配置文件和流程里的约定能活三年。
二、1421 行的一个 while(true):把「聪明」降级成「不崩」
2.4 节「Agent Loop 初探」给了全书最具体的数字(p0080):
Claude Code 的 Agent Loop 核心代码位于 query.ts 文件中,这是一个长达 1729 行的异步生成器(Async Generator)函数。整个 Agent Loop 的核心是一个从第 307 行开始、到第 1728 行结束的 while(true) 循环,单个循环体跨越了 1421 行代码。
然后是那个「鲜为人知的演进故事」:早期版本用递归调用实现 Agent Loop,query 函数在需要继续执行时调用自身,设计简洁直观,但有个致命缺陷——长时间会话中随着工具调用次数增加,调用栈不断增长,最终栈溢出;当前版本换成状态机。
第一遍读,这是个重构故事;第二遍才看出它在讲什么:Agent 的「智能」问题,最后是被当成控制流问题解决的。递归的语义其实更贴合 Agent 本质——模型说「再查一次」就再进一层。但工程上它必死,因为真实会话长度不可预测。改成状态机等于承认:Agent 不会「结束」,它只会「停在某个状态」。这个转变跟模型能力毫无关系,纯粹是软件工程对不确定性的让步。
图 4-1(p0135)把循环画成五步:上下文 → 模型推理 → 工具调用解析 → 工具执行 → 结果追加 → 下一轮。同一页有句容易被跳过的话:「上下文的质量直接决定了模型决策的质量」,为此引入了「提示词缓存和动态加载机制」,并为工具设计了「并发控制与权限校验逻辑」。这个五步图谁都能画,难的是每一步后面的括号。自建 Agent 的团队大多死在同一点——不是模型不会调工具,而是上下文一轮轮灌进去,很快脏了、慢了、贵了。第 4 到 7 章本质上都在回答:怎么让无限循环里的上下文维持在「够用且不爆炸」。
三、12 层封装里最反潮流的一层:不用向量库
4.5 节「12 层渐进式封装」的 p0150 给了三个取舍,每一个都反着主流走。
记忆持久化层:Anthropic 并未采用业界主流的向量数据库方案,转而基于本地文件系统实现记忆存储。书里承认这个方案「虽然牺牲了部分检索能力,无法进行高精度语义相似度的匹配」,但「极大地降低了系统架构的复杂度和用户的部署运维成本」——「一个简单可靠的 MEMORY.md 本地记忆文件,远比需要额外部署维护的向量数据库更轻量化、更实用」。
权限校验层引入小模型分类器判别,虽然增加了少量 API 调用开销,但有效减少了不必要的弹窗确认,书里给这个取舍定了名:「以少量调用成本换取极致用户体验」。缓存优化层把工具代理列表从通用描述中剥离精简,经实测,缓存创建所需的 Token 消耗量可下降 10.2%。
三条合起来是一个很统一的偏好:能用确定性方案解决的绝不上模型,能用本地文件解决的绝不上外部服务。这跟当下「万物皆可 RAG」的风气完全相反。方向我认同,但有一句书里没说透:MEMORY.md 的真正代价不在检索精度,而在记忆会无限膨胀。向量库有容量管理和相关性排序,一个 Markdown 文件没有——写到第 500 条,它要么被截断,要么被整篇读进每次上下文,两种结果都不好受。第 8 章提到「按需加载」,但那是 Skill 的机制,MEMORY.md 自己的淘汰策略全书没有正面回答。
还有一处该批评:10.2% 是全书少数带小数的实测值,我的第一反应是「怎么测的」——对照组是什么,同一份列表精简前后,还是不同版本之间?缓存命中口径怎么算?书里没有。精确数字在架构书里的作用是建立可信度,这里反而暴露了软肋:所有精确的数字,都没有配套的方法。
四、14 步里的第 4 步,才是速度的真正来源
5.4 节「工具执行流水线:14 步执行流程」,p0215 落在第 4 到第 6 步,恰好是最有信息量的三步。
第 4 步,流式工具执行。书里称这是「最重要的性能优化点之一」:传统 Agent 先等模型输出完毕,再统一解析工具调用,最后按顺序执行;而 StreamingToolExecutor 采用流水线并行——当模型还在生成第二个工具调用时,第一个工具调用已经开始执行。实现基于 AsyncGenerator,订阅 Token 流,解析到完整工具调用就入队,无须等整个响应;队列再按 isConcurrencySafe 分并发批次与串行批次调度。
第 5 步,错误恢复。API 返回 413(提示词过长)时,紧急执行上下文压缩并重试;同时支持模型降级(Model Fallback),主模型失败可自动切到备用模型,例如从 Opus 降到 Sonnet。第 6 步是运行停止钩子,检查输出并决定是否继续生成。
为什么第 4 步最可迁移?因为它把「AI 慢」这个用户感受拆成了可分别优化的延迟段。用户在终端里等 20 秒,其实是「模型生成 + 工具执行」串行相加;让工具执行滑进生成过程中间,总时长就从「和」变成「大者」。这件事不需要更强的模型,只需要更好的调度。任何自建 Agent 的人都该对照一下:你的工具是不是在等模型说完话才开跑?
第 5 步则暴露另一层现实:健壮性靠的是预设好的失败路径。413 就压缩重试,主模型挂了就降级,输出可疑就拦住。都不优雅,但它们决定了这工具在真实项目里能不能一天跑八小时。相比之下,大量「Agent 框架」的文档只讲成功路径,一到长任务就原形毕露。
五、权限四层与沙箱:安全不是开关,是顺序
6.1.2 节「权限校验的四层递进拦截机制」,p0190 的图 6-1 只截到前三层:01 Config Rules(定义允许/拒绝规则,作为基础策略)、02 checkPermissions(工具执行前按配置校验)、03 Classifier(可选)(按模型输出分级管控)。第四层在下一页,我没有逐字看到名称——按标题是四层,图里只能确认三层,这里如实注明。同页还讲了粒度:配置语法支持通配符与细粒度路径匹配,遵循 gitignore 规范,例如 Edit(//tmp/scratch.txt) 放行绝对路径临时文件、Read(~/.zshrc) 放行主目录配置。
9.7 节讲沙箱(p0285):执行 Bash 命令时「并非直接在用户的 Shell 环境中执行,而是通过一个经过精细化配置的子进程」,该子进程在多个维度受权限与资源限制。
这两处合起来,是全书对「AI 编程安全」最实在的回答。思路不是给 AI 一个「安全模式开关」,而是把权限做成有先后顺序的管道:先用静态规则挡掉明显不该做的事(快、可预测、零成本),再按上下文做运行时校验,最后才动用模型分类器处理模糊地带(慢、贵,但能处理规则写不出的情况)。顺序本身就是设计——把便宜的判断放前面,贵的不容易误伤。图 6-1 里那个「可选」二字最诚实:它等于承认分类器不是必需品,是在「弹窗烦人」和「多花钱」之间做的权衡。
批评也在这里。这一节全篇讲「怎么拦住 AI」,却回避了更硬的问题:拦住之后,谁来判断这次放行是对的?规则是人写的,分类器是模型判的,两者都会错。书里没有一页讲误拦截率,也没有一页讲「放开权限后出过什么事」。只讲机制不讲事故,读起来像产品说明书,不像工程复盘。
六、CLAUDE.md 与 Skill:把「团队记忆」写进版本库
前面几章讲机器怎么运转,这一章讲人怎么把自己的规矩塞进机器。
p0320 讲 CLAUDE.md 的分层:这种结构适合大型团队协作,前端团队维护 code-style.md,安全团队维护 security.md,测试团队维护 testing.md,各自独立、互不干扰,彻底消除了多人协作时的合并冲突。它还支持 @path/to/file 引用外部文件,可相对、可绝对、也支持用户级全局文件(如 @~/.claude/my-preferences.md),引用可递归,但应避免链条过于复杂。同页讲 MCP:一项标准化模型与外部工具交互的开放协议,设计理念类似 LSP,任何符合规范的 MCP 服务器都能无修改接入,从而突破本地文件系统的限制。
p0250 讲 Skill 的按需加载:Skill 可以包含非常详细的步骤说明而不占用过多上下文;团队可把常用工作流封装成 Skill 纳入版本控制,实现流程标准化与知识共享,「确保所有成员(包括 AI)都能以一致的方式执行关键操作」。同页的 Plan Mode 则是先规划后动手:任务分解(每个子任务有输入、输出、验收标准)、依赖关系(区分可并行与必须串行)、风险评估(识别不确定性并准备备选方案)。
这套东西的妙处在于把「团队约定」变成了可以 diff 的资产。以前规范活在文档和评审的口头意见里,现在活在被 Git 管理的 Markdown 里,谁改了什么都有记录;Skill 更进一步,把「怎么做一件事」的流程也版本化了——AI 的行为可以被审计、被回滚。p0305 的 /init 是最好的入口:自动扫描项目结构,读 package.json(或 pyproject.toml、Cargo.toml),分析技术栈并生成定制化的 CLAUDE.md 初稿,含检测到的框架、常用命令与目录说明,用户在此基础上调整即可。
但我读到这里有个书里没回答的疑问:分层维护的 CLAUDE.md,谁保证它们不互相矛盾?前端说「组件一律函数式」,安全说「所有外部输入必须走统一校验层」,这两条在某个具体文件里可能正好打架,而 AI 拿到两份冲突规范时行为不可预测。书里说「彻底消除了合并冲突」——合并冲突确实消除了,语义冲突反而更难发现,因为 Git 不会为它报错。这是这一章最该补的一页。
七、它的短板
这本书的问题不在写得浅,而在它把自己写成了不可证伪的样子。下面几条都能在抽样里直接指出。
一、源码级细节没有版本号。这是最要命的一条。证据极其具体——query.ts 1729 行、while(true) 从 307 到 1728 行、循环体 1421 行——看起来无比扎实,但它们对应的是某一个特定版本的产物,而书里从头到尾没说清是哪个版本、哪个 commit、什么时候读的代码。Claude Code 是高频迭代的闭源分发包,行号这种证据的保质期以周计。结果就是我既无法核对,也无法反驳。一段不可检验的「深度解析」,方法上更接近文学评论。代价是双重的:读者学不到可复用的方法,作者也失去了被同行校正的机会。
二、数字都没有方法。10.2% 的 Token 降幅、四层拦截、14 步执行、12 层封装、三级压缩、5 种设计模式、5 大核心组件——带编号的体系多到需要索引表,却几乎没有测量条件。既然选择用精确数字建立权威,就得承担精确数字的举证责任。
三、编号膨胀,读起来像数零件。第 3 章五大组件、第 4 章 12 层、第 5 章 14 步、第 7 章三级压缩、第 8 章 5 种模式、第 12 章五大趋势,每章凑一个数字。好处是结构清晰,坏处是把重要性抹平了:12 层里哪三层是命门?14 步只能留 5 步,砍哪 9 步?一旦排序就必须承认「有些层没那么重要」,于是书里一律回避。读者要的是判断,拿到的是清单。
四、目录和正文编号对不上。这条很好查:meta 里第 9 章目录是 9.1 终端 UI、9.2 IDE 桥接、9.3 MCP 与插件生态、9.4 插件与 Hook 协同、9.5 CI/CD、9.6 Bun 运行时,然后直接跳到 9.8 总结,9.7 缺席;而正文 p0285 明明写着「9.7 Claude Code 的安全沙箱设计」「9.7.1 进程隔离与资源限制」。沙箱一节在正文里存在,在目录里消失。这不是排版小瑕疵,它说明这本讲「工程严谨」的书,自己的流程里漏了一道校对。
五、实战章节和读者错位。第 11 章三个场景听起来很全,但 p0370 那个重构示例,落到实处的截图跑的是 ./vendor/bin/phpunit 和 WP_Mock\Tools\TestCase——一个 PHP/WordPress 项目。我不否认 PHP 世界也需要 AI 编程,但 2026 年买这类书的人八成写 TypeScript 或 Python,他们最想看的「在十万行 React 单体里改一个跨模块接口」,书里只有一段指令模板(要求先给方案再动手、跑测试、失败就报错),没有真实执行记录和失败过程。模板谁都能写,读者花钱想买的恰恰是模板之外的部分:它真跑通了吗、卡在哪、怎么绕过去。
六、对 Anthropic 几乎没有批评。p0395 提到,公开代码里还暴露了一项有争议的隐藏模块 undercover.ts:该模块会在员工向外部仓库提交代码时自动注入系统提示词,要求 Claude 不得在提交信息或 PR 中……(句子在页末截断)。这是个什么性质的东西?一个在特定人群、特定场景下改变模型行为的隐藏开关,放在任何公司身上都该追问一句「还有多少个这样的模块」。而书里的处理是描述它「引发了信任危机」,然后翻节。一本自称深度解析的书,遇到这类问题时的态度,比它拆得多细更能说明立场。
七、案例只来自一家公司。全书结构、数据、源码、图示全部指向 Anthropic 一家。定位如此,本没错,但没有横向对照:Cline、Roo Code、Continue 怎么解决同一个问题?Cursor 的权限模型差在哪?没有对照,「12 层封装」就无法判断是行业最优解还是一家公司的路径依赖——对想抄作业的读者,这两者是天壤之别。
八、适合谁,以及怎么读
最合适:正在自建 AI 编程工具或 Agent 平台的工程师。不是因为它教你写代码,而是它把一堆你迟早要踩的坑提前列了——递归会栈溢出、上下文会溢出、工具会串行等待、权限弹窗会烦死人、主模型会挂、记忆会膨胀。这些问题跟用哪家模型无关。第 4 章(12 层整体视图)、第 5 章(执行流水线)、第 7 章(上下文压缩)可以直接当设计清单用。
次合适:要给团队定 AI 编程规范的 Tech Lead。第 6 章(权限)、第 9 章(MCP 与插件)、第 10 章(CLAUDE.md 分层)给出了一套现成的组织方式。搬过去不一定全对,但至少是一个可以讨论的起点。
不太合适的两类人。一是想学「怎么用 Claude Code 提效」的普通开发者:401 屏里真正讲操作的只有第 10、11 两章。你想找「功能在哪、快捷键是什么」,它给你「这个功能分几层实现」。二是想要源码解读的人:它引用行号,但不给代码,也不给版本,没法跟着读。
具体读法:先读 p0055 和 p0100,再读第 4 章的 12 层总图,然后跳到 5.4 的 14 步流水线和 7.4 的三级压缩,最后才回头看第 3 章的概念定义。这样排序,你先拿到「它在哪些地方做了取舍」,再回头看「它给这些取舍起了什么名字」。反过来从第 3 章的 Harness 定义读起,会被一堆自造术语按住,读到第 5 章还不知道这些词对应什么实际问题。
还有一件读完就能做的事,成本很低:给自己项目写一份 20 行的 CLAUDE.md,只写三件事——技术栈、禁止改动的目录、提交前的检查命令,然后跑一周看有没有被遵守。这一周的体会,比书里 12 层封装更能让你理解 Harness 工程在解决什么,因为它会逼你面对书里没回答的那个问题:你的规矩,机器到底读懂了没有。
最后一句:这本书最值钱的不是它拆得多细,而是它提出了一个能带走的判断——当模型每半年换一代,能留下的只有那层不依赖模型的工程结构;但它自己也证明了另一半:一层说不清版本、给不出方法的工程叙述,同样留不下来。
抽样核对 13 屏:p0055 第 2 章(Boris Cherny 2023 年加入 Anthropic 的原话;内部工具「最初只是一个简单的终端脚本」;早期「只有约 10% 的代码由 Claude Code 生成」;Ben Mann「不要为今天的模型而构建,要为 6 个月后的模型而构建」) · p0080 2.4 Agent Loop(query.ts 1729 行异步生成器;while(true) 第 307–1728 行、循环体 1421 行;早期递归导致 Stack Overflow,现版改状态机) · p0100 2.7.2(模型无关架构;统一 Tool Interface 接口) · p0135 图 4-1 Agent Loop 工作流(上下文/模型推理/工具调用解析/工具执行/结果追加;提示词缓存与动态加载) · p0150 4.5.2(记忆层放弃向量库、改用本地 MEMORY.md;权限校验引入小模型分类器;缓存优化精简工具描述使 Token 消耗下降 10.2%) · p0190 6.1.2 图 6-1(权限四层递进:01 Config Rules/02 checkPermissions/03 Classifier 可选;gitignore 规范的通配符路径匹配) · p0215 5.4(第 4 步 StreamingToolExecutor 流水线并行、AsyncGenerator、isConcurrencySafe 分并发与串行批次;第 5 步 413 → 上下文压缩重试与 Opus→Sonnet 降级;第 6 步运行停止钩子) · p0250 8.2/8.3(Skill 按需加载、纳入版本控制;Plan Mode 的任务分解/依赖关系/风险评估) · p0285 9.6 尾与 9.7(Bun 选型的社区与调试工具代价;9.7 安全沙箱、9.7.1 进程隔离与资源限制) · p0305 10.2 命令表(/plan /model /config /login /logout /init /install-github-action;/init 读 package.json、pyproject.toml、Cargo.toml 生成 CLAUDE.md 初稿) · p0320 10.3(CLAUDE.md 按 code-style.md/security.md/testing.md 分团队维护;@path 引用与用户级全局文件、支持递归;MCP 类比 LSP) · p0370 第 11 章重构实战(先给方案的指令模板;执行记录为 PHP/WordPress 的 phpunit 与 WP_Mock) · p0395 13.1/13.2(单机 Harness → 云端分布式 Harness;KAIROS 守护进程与 undercover.ts 隐藏模块)
说明:meta 目录 102 条、5 篇 13 章,与正文章节一致;第 9 章目录由 9.6 直接跳至 9.8,正文 p0285 存在 9.7 沙箱一节,编号不一致 · 抽样率 13/401 ≈ 3.2% · 6.1.2 第四层拦截的图示在 p0190 之后,未逐字确认名称 · 笔记与图谱生成于 2026-11-09
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: