
一份 SRT 字幕怎么变成一条白板手绘动画?
一份 SRT 字幕怎么变成一条白板手绘动画?
一份 SRT 字幕文件,过一道六步流水线,就能变成一条白板手绘动画,今天这条 105 秒的视频就是这么出来的。流水线的六步是:拆幕、线稿、分区落墨、渲染、合并、配音。
先说踩的坑
文章写完想变成视频,卡点在两个地方:画面不会绘制,配音不会制作。绘画需要功底,配音需要设备,两堵墙一挡,多数人就把视频这件事放下了。
我也一样,文章会写,画面不会绘制,动画更是想都没想过。买了一堆教程,收藏了一堆软件,收藏夹越来越厚,视频始终停在想法里。直到把这条流水线搭起来才发现,两个卡点都可以交给流程:画面交给线稿和落墨,配音交给上一篇的 edge-tts。
后来想明白,缺的不是手艺,是一条把活拆小的流水线。手艺要练十年,流水线今天搭今天用。把大活拆成六个小步骤,每一步都有工具接手,人就只需要做串联和检查。
这就是这篇文章最想传递的一件事:不会绘制,可以让流程替你绘制;你要做的,是把每一步要喂给它的东西准备清楚。
原理:字幕说到哪里,画面就绘制到哪里
白板动画的本质是一句话:字幕说到哪里,画面就绘制到哪里。观众看着笔尖在纸上移动,旁白说完一句,画面就多出一笔。
为什么用 SRT 文件当剧本?因为 SRT 自带时间轴,每一句话从第几秒开始、到第几秒结束,文件里写得明明白白。旁白的时间轴就是画面的分镜表,这是现成的导演脚本,不用另外制作。
SRT 文件长什么样?一个序号,一行起止时间,一句台词,三样循环往复。它本来是给播放器挂字幕用的,但是这三样东西恰好就是分镜需要的全部信息。
这就是整条流水线的地基:SRT 管时间,流水线管画面,配音管声音。三者都对齐到同一个时间轴上,成片就成立;错开一点,观众立刻能察觉出割裂。
白板动画还有一层好处:绘制过程本身就是内容。观众看着线条一点点生长,注意力会跟着笔尖走,这比一张静态图多留住好几秒。
有人担心不会剪辑。这条流水线里没有剪辑的环节,画面是按时间轴直接渲染出来的,配音是逐句对齐进去的。剪辑这件事被流程消化掉了,你碰都不用碰。
实操:六步流水线
下面按顺序过一遍六步,每一步都有今天的真实输出可以核对。
第一步,拆幕。旁白写好,保存成 SRT 文件,然后交给 parse_srt.py 拆幕。拆幕按叙事节奏分段,不是机械地按句号切,每一幕对应一个完整的叙事段落。
SRT 文件怎么来?旁白稿写好,一句一行,配上起止时间,存成 .srt 后缀的文本文件。它就是一个普通的文本文件,任何编辑器都打开得了。
别小看这个文本文件,它是整条流水线的源头。源头稳了,后面每一步才有依据。
今天的真实拆幕结果:一份完整的 SRT 被拆成 4 幕,各幕时长分别是 32 秒、29 秒、29 秒和 13 秒。每一幕讲透一件事,幕与幕之间是递进关系。
拆完顺手检查了一遍:最长的一幕 32 秒,最短的一幕 13 秒,时长差得不少,但是每一幕的意思都完整。时长不必平均,意思完整才是标准。
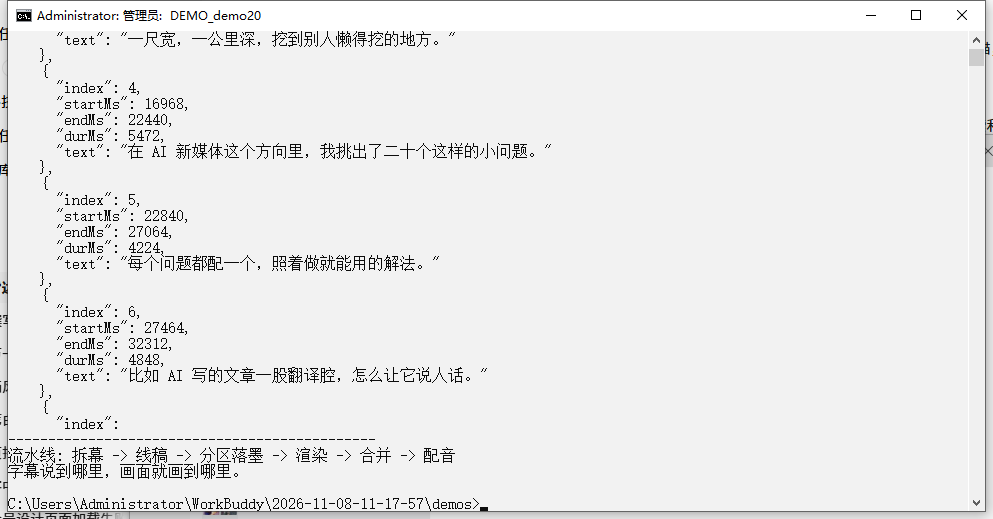
为什么按叙事节奏切,不按句号切?因为句号只管一句话的结束,不管一段话的意思完整。按句号切出来的幕,画面换了,话说了一半;按节奏切出来的幕,每幕自成一段,观众不用回头补课。
第二步,线稿。每一幕先绘制米色纸底的线稿,把这一幕要出现的元素摆好位置。线稿阶段不追求细节,追求的是构图不返工。
米色纸底不是随便选的,它是白板动画的质感来源:纸的颜色定住了,笔迹才有落点,整条视频看起来才像在一张纸上画出来的。
第三步,分区落墨。把线稿分成区域,逐区上墨。台词说到人物,笔尖就勾勒人物;台词说到数字,笔尖就写下数字。
分区的意义在顺序可控:先画什么,后画什么,跟着台词的进度排好。观众看到的每一笔,都出现在它该被说到的那一刻,这就是「说到哪里画到哪里」的落地方式。
分区还有一个隐性好处:一幕里画错了某一区,重画那一区就行,不用整幕推倒重来。误差被关在小格子里,这是流水线思维一贯的打法。
第四步,渲染。逐帧把落墨的过程渲染出来,观众看到的就是笔画一点点生长的效果。
第五步,合并。4 幕全部渲染完成,按时间轴合并成完整视频。合并这一步看似只是拼接,其实也是在核验:哪一幕接不上,回炉哪一幕。
第六步,配音。这一步直接调用上一篇的 edge-tts,17 句台湾腔配音一句一句生成,一句一句对齐。配音进片,声音和笔尖就同步了。
配音为什么要逐句生成?因为逐句生成的文件,每一句都能单独替换。哪一句的效果不满意,重新生成那一句就行,不用整条重来。
全流程结束,盘点一下今天的交付物:105 秒的成片一条,17 句台湾腔配音,4 幕米色纸底的手绘线稿。每一项都对应流水线里的一步,没有多余环节,也没有缺失环节。
这套流水线搭好一次,以后就是重复使用。下一篇视频进来,还是这六步,还是这套检查,产能就这么稳定下来了。
交付物里的数字还可以互相咬合:4 幕线稿对应拆幕的 4 幕输出,17 句配音对应 SRT 里的 17 句台词,105 秒对应整份字幕的时间轴。数字对得上,流水线才算真的成立。
两个常见的坑
这条流水线有两个常见的坑,都埋在对齐上。
第一个坑:SRT 的时间轴不准。字幕时间错了,笔尖的动作和旁白的内容就对不上,观众一眼看出割裂。SRT 里的起止时间,要按配音的实际时长来定,不能凭感觉填。
时间轴还有一个隐蔽的坑:中英文混排或者数字多的句子,配音读出来的长度和目测的不一样。保险的做法是每句配音生成之后核对一遍时长,再写进 SRT。
第二个坑:一幕塞太多东西。一幕要呈现的元素太多,笔画还没收尾,字幕已经跑到下一句。拆幕的时候守住一条:一幕只说一件事,说不完就再拆一幕。
判断一幕是不是太满,有一个简单的标准:这一幕画完的时候,台词刚好说完吗?说完了,量就合适;差得远,就再拆。
这两个坑的共同点,是把问题暴露在成片之后。对齐这件事要在拆幕的时候就抓好,核对得越早,返工的成本越低。
写在最后:系列完结
写到这里,这个系列的 20 篇全部完结。回到最开始那个主题:一尺宽,一公里深。
这 20 篇写的都是小得不能再小的问题:AI 写作的翻译腔,排版的样式丢失,封面的裁切,标签的残片,配音的门槛,字幕的变身。但是每一个小问题都给了一个能直接上手的解法,写作、配图排版、发布、运营、视频配音,五组合起来就是一条完整的链条。
小不等于不值钱。读者带着具体的麻烦来搜索,你的答案正好接住他,这就是关注发生的时刻。大词谁都写,把窄问题说清楚的人少,这就是窄问题的机会所在。
这篇文章本身也是一次示范:一条 105 秒的视频,17 句配音,4 幕线稿,全部出自前面几篇写过的工具和流程。系列里的方法不是孤立的,串起来就是一条从文章到视频的生产线。
这个系列从头到尾只做一件事:把大词换成小动作。效率这个词,换成排版从 30 分钟变成 3 秒;提效这个词,换成配音 3.0 秒生成一条;做成视频这个词,换成 4 幕线稿加 17 句对齐的 105 秒成片。小动作才能照着做,做完了才敢说会了。
如果你刚看到这一篇,不要从这里开始,回到第 1 篇,一个一个做下来。20 个问题,20 个解法,做完一遍,这些小问题就再也拦不住你。流量池就是这样一点点攒出来的,从第一篇开始,今天就是最好的动手日子。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: