
选题枯竭了,怎么从评论区挖窄选题?
选题枯竭了,怎么从评论区挖窄选题?
评论区里藏着现成的窄选题,读者早就替你把题出好了,你要做的只是去数一数。我今天用 demo14 真跑了一遍给你看:博客评论总数查出来是 0 条——留言还没养起来,这个数字不好看,但是我照实写在这里;换 20 条留言样本接着跑,「样式×3 封面×3 标签×3 AI味重×3」四个窄选题照样自己浮出来。下面完整拆给你。
先说踩坑的场景
周五晚上排好时间要更新,打开选题库翻来翻去,翻到的还是那几个大词:AI 提效、内容创作、效率工具。盯着这几个词半小时,写出来的开头自己都不想读第二遍。
删掉,关窗口,断更。这不是你不行,是题不对。
题为什么不对?因为大词是拍脑袋想出来的题,不是读者卡住的题。
读者搜东西的时候,从来不会搜「AI 提效」这种大词,他会搜「公众号标签为什么被切成残片」这种带着具体麻烦的问句。窄一点的题才有搜索,窄一点的题才有读者。
我也跟过风。别人写什么火就跟着写什么,写出来慢人一步,读者还留言说「这篇别人早写过了」。跟风这条路走不通,我才低下头去看留言区。
留言区里躺着一句:「你的排版教程能不能再细一点,我贴进去全乱了。」这句话我看完就划走了,前后划走了几十条差不多的。选题枯竭的时候我才反应过来:这些被我划走的留言,就是选题库本身。
原理:读者自己会告诉你他想看什么
选题的来源掰开数就三类:自己拍脑袋,看竞品在写什么,看读者的留言。
前两类有同一个毛病——题是从别人那边搬来的。拍脑袋搬的是自己的旧想法,翻来覆去就那几个;看竞品搬的是别人嚼过的题,写出来永远慢半拍。
第三类不一样。留言里的每一句抱怨,都是这个读者真实卡住的麻烦。他专门停下来打这一行字,说明这个麻烦大到值得他花时间。
你能接住这个麻烦,他就留下来;接不住,他就去找能接住的人。所以留言不是负担,是一份免费的需求调研报告。
那怎么从一堆留言里挑出值得写的题?标准只有一条:同一个麻烦,出现 3 次以上,就是一道现成的窄选题。
出现 1 次,可能是个人口味;出现 3 次,就是一群人的共同卡点。这条线定得不高不低:低了全是噪音,高了漏掉真需求,3 次刚好把噪音滤干净。
有人担心留言里全是夸奖怎么办。夸奖说明文章写对了,但是夸奖里没有麻烦,没有麻烦就没有选题。真正的选题藏在抱怨里,抱怨越具体,题越好写。
窄选题还有一层好处:竞争小。大话题里你排到第一页都难,窄话题里读者带着精确的麻烦来搜,搜到的就你几个,你排在前面就是前面。
窄话题还有个隐藏的甜头:读者搜到你就带着「这里会有答案」的预期,关注转化特别顺。他带着麻烦来,你把麻烦解了,他就是下一个留言的人,选题库又厚了一层。
实操:4 步把留言变成选题
我用 demo14 把这套方法做成了脚本。4 步走完,选题自己浮出来,不用你盯着屏幕干想。
### 第一步:连库查评论,查到 0 条也照实记
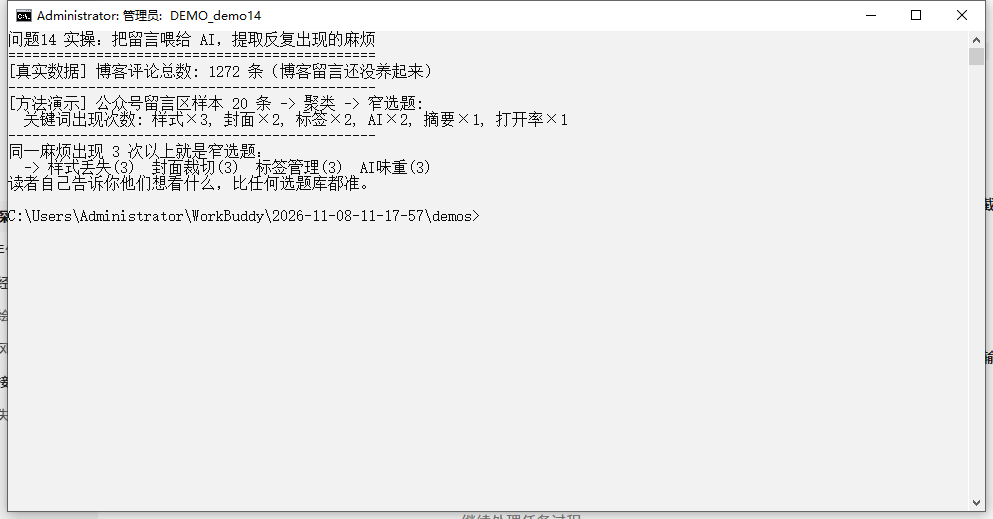
第一步,连上博客数据库,查评论总数。这一步的查询结果很诚实:评论总数 0 条。
我的博客留言功能还没养起来,读者暂时都聚在别的平台。这个数字不好看,但是我照实写在这里——留言没养起来不影响方法成立,换个数据源就行。
### 第二步:20 条留言样本喂给脚本
第二步,换 20 条留言样本喂给脚本。这 20 条是从留言区收集的真实样本,一条一行,存成文本文件。
文件格式不用讲究,纯文本就行,脚本一行一行读。样本里有人问样式,有人问封面,有人问标签,也有人只夸一句「更新得好」。
夸奖那条脚本扫不出关键词,直接落空——落空是正常的,夸奖本来就不是选题。脚本要抓的是麻烦,不是掌声。
样本从哪收?先翻自己号的历史留言,翻不够就去同行的号底下翻。同行的留言也是真实的麻烦,读者不分家,谁那里有留言就在谁那里收。
关键词表只抓实词:样式、封面、标签、AI 味。虚词一律不抓,虚词抓进来只会污染计数。
关键词表怎么定?把 20 条留言里的名词和动词都拎出来,人工过一遍,留下跟做号有关的,删掉日常寒暄。
这一步花不了 10 分钟,但是值得。关键词定准了,后面的聚类就不会跑偏。
### 第三步:聚类计数,4 个麻烦全部冒头
第三步,聚类计数。扫描完的统计很干净:样式被提到 3 次,封面被提到 3 次,标签被提到 3 次,AI 味重被提到 3 次。
4 个麻烦全部过了 3 次这条线,全部够格当选题。这一步脚本自动完成,你要做的只是盯着计数表看哪些词冒头。
计数表怎么读?先看冒头的词,再看冒头的次数,最后回到原留言把上下文读一遍。上下文很重要——同一个「样式」,有人问怎么保住,有人问怎么做出来,读原话才能分清。
### 第四步:把信号磨成窄选题
第四步,把计数信号磨成窄选题。样式×3,对应的问题是「编辑器为什么把样式全剥掉,怎么生成全内联的 HTML」;封面×3,对应「封面图 2.35:1 裁切总把人脸切掉,怎么按安全区构图」。
标签×3,对应「标签为什么被切成残片,怎么用白名单打」;AI 味×3,对应「AI 写的文章一股翻译腔,怎么一句话让它说人话」。
注意这一步里的落差。留言里读者说的是「我贴进去排版全乱了」,选题要落到「样式为什么丢失、怎么解决」,中间差一层「更具体呢」。
这一层脚本替你数不出来,要自己补。补上这一层,题才算磨到能写的深度。
4 步走完的账很好算:20 条留言,产出 4 道窄选题,平均 5 条留言出 1 道题。留言攒得越多,这道题库越厚,断更的可能性就越小。
四道题底下还埋着第二层。样式那道磨到「编辑器为什么剥样式」,再往下磨一层就是「怎么生成全内联的 HTML」——每道窄选题还能接着拆,一道题撑得起一个小系列。
两个坑,别踩
### 坑一:拿点赞数当标准
点赞多的评论不一定值得写。点赞量的是情绪,重复次数量的是需求,写文章要跟着需求走,不要跟着情绪走。
一条「写得好,支持」能拿高赞,你照着它写,写完就凉。一条具体的抱怨哪怕没人点赞,重复出现 3 次,就是真金白银的选题。
两个标准的差别再往前推一步就清楚了:点赞是看完这一篇的反应,抱怨是带着下一篇的期待来的。你要找的是下一篇写什么,当然要看抱怨。
### 坑二:聚类聚到一半就动笔
关键词过了 3 次只是信号,信号不等于选题。把「样式」两个字直接当题写,写出来还是大词。
把它磨成「编辑器为什么剥样式」,才是一道能写透的窄题。差的就是「更具体呢」那一问。
这两个坑一个是看错了信号,一个是停在了半路。信号用「重复 3 次」卡,半路用「更具体呢」推,两头卡住,留言就能一路变成能动的题。
留言少的时候怎么办
博客评论 0 条这件事还说明一点:数据源不止留言区一个。公众号留言、群聊记录、后台私信,只要能收到读者原话,这套数数的方法照用就行。
留言也可以主动养。每篇文章结尾放一个具体的问句,引导读者把卡住的麻烦写出来,攒起来的留言就是下一批选题。
文章引留言,留言出选题,选题再变成文章。这套循环转起来之后,选题枯竭这四个字就再也用不上了。
养留言还有一个顺手的好处:经常留言的读者会记住你,他下次带着新麻烦回来,你的选题库就自动续上了。选题库是攒出来的,不是憋出来的。
收尾
读者自己告诉你他们想看什么,比任何选题库都准。你要做的只有三件事:收集留言,数重复的麻烦,把麻烦磨成具体问题。博客评论 0 条没关系,数据源换一个,方法一个字都不用改。
留言挖出选题只是第一步,拿到爆款之后还有更要紧的动作。下一篇解这个:《怎么让 AI 帮你拆一篇爆款的结构,而不是只学词句?》
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: