
公众号标签为什么被切成残片?怎么用白名单打?
公众号标签为什么被切成残片?怎么用白名单打?
标签被切成残片的根子,是自动提取拿标点当分隔边界,解法是自己定一份标签白名单,发布时整体覆盖自动标签,再定期清掉孤儿标签。这套流程我在博客后台真实跑过一遍,从连数据库查标签到删残片,每一步都有记录。今天把原理和步骤拆开讲清楚。
先说我是怎么发现这件事的。有天整理后台,点开标签管理,列表里躺着一串没见过的标签:有的少了半截,有的跟别的词粘在一起,还有的只在一篇文章上出现过一次。文章是真文章,标签不是我要的标签。
再往下想危害就清楚了。读者点进一个标签,是想看同一类文章,结果标签页里既有干货又有残片,杂七杂八堆在一起。账号的垂直度,本来要靠标签帮读者建立预期,现在预期建不起来,标签反而成了杂物间。
我还发现残片有个更隐蔽的害处:稀释统计。后台看哪个主题写得多,靠的是标签计数,残片把一个主题的计数拆成两三个,数字一看就失真。数据失真,后面定选题、看趋势全都跟着歪。
这些残片从哪来的?追根溯源,全是从标题里来的。我的标题习惯带书名号和引号,比如引用一篇文章、强调一个词,标点一多,提取器的边界就密,切出来的碎片就多——风格没有错,错在把标签交给一个不认识你风格的机器。
残片是怎么切出来的
自动提取的工作方式不复杂:从标题和正文里抓高频词,拿标点当分隔边界。逗号、句号是边界,这个逻辑没有问题;问题出在书名号、引号也被当成边界处理。
举个例子:标题里出现书名号包着的词,提取器不认识书名号里面的内容是一个整体,它只认「标点就是边界」,于是一个完整的词被从中间断开,提取出来就缺胳膊少腿,成了残片。标题里书名号引号用得越多,残片就越多。
还有一类是孤儿标签:某个词只在一篇文章上出现过一次,之后再也没用过。单看每一个都情有可原,堆起来就是灾难,标签列表越来越长,能复用的越来越少。残片加孤儿,标签系统就这么慢慢烂掉的。
有人会问:不清理会怎样?短期看没大事,长期看是温水煮青蛙。标签列表从 20 个涨到 50 个,再涨到 100 个,你自己都不敢点开看,读者更没有耐心翻,标签功能等于名存实亡。
想修自动提取的边界规则?修不了,规则在平台手里,你控制不了它怎么切;能做的只有绕开,不让自动提取说了算,改用自己的白名单。白名单的思路一句话说透:标签是我的资产,不是平台的副产品,资产就要自己管,范围自己定,进出自己批。
实操:四步把标签管起来
第一步,连库查现状。我用 demo12.py 通过 SSH 连上博客的数据库,本机跑脚本,脚本里配好主机、端口、账号,连上之后第一条查询就是标签总数。数字出来那一刻,你就知道这个摊子有多大:多少是白名单里的正经标签,多少是没见过的杂音。
查总数这一步别省。不查总数,你对问题规模没有概念,清理的时候就容易手软;数字摆在眼前,哪些该删哪些该留,判断会快很多。
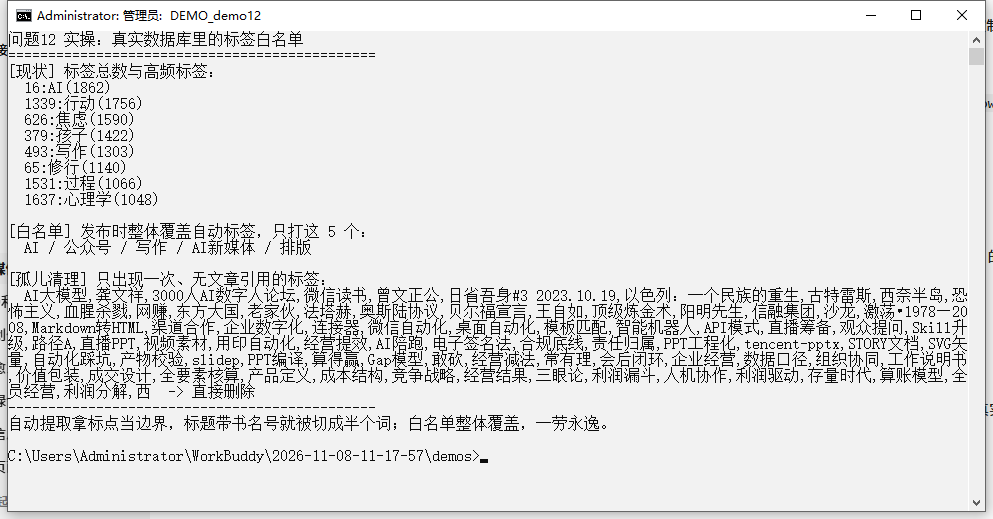
第二步,查高频标签,从里面挑白名单。查询按出现次数从高到低排,结果很清楚:AI、公众号、写作、AI 新媒体、排版,这 5 个高频标签覆盖了文章的主线。白名单就从它们里定,一共 5 个:AI、公众号、写作、AI 新媒体、排版。
白名单定几个合适?看文章主线——我的主线就五条:AI 是工具,公众号是阵地,写作是手艺,AI 新媒体是赛道,排版是细节,5 个词正好一人守一段,多一个都嫌重复。名单定了就要守住,临时想加一个,先问自己这个主题以后还会不会写,写不到 10 篇,就不配进白名单。
第三步,发布时整体覆盖自动标签。每篇文章发出去,标签从白名单里挑,AI 生成的自动标签直接覆盖掉,不给残片留入口;覆盖要彻底,自动标签一个都不留,留着一半,残片照样混进来。挑标签也有讲究,一篇讲排版的文章,挑「排版」加「公众号」,两个就够,不要把白名单全打上去。
覆盖这个动作可以交给发布脚本做,人不用手动挑。脚本里写死白名单,发布的时候自动打上,自动标签一律不要,整条链路没有人工环节,也就没有遗漏环节。
第四步,清理孤儿标签。用 group_concat(tag_Name) 把 tag_Count 小于等于 1 的标签查出来,也就是只出现过一次的标签,列出来过一眼,确认是残片和一次性的词,删掉。删除之前过一眼是必要的,万一某个低频标签是你故意埋的长尾词,误删了就可惜;我的原则很简单:残片删,一次性又不在任何系列里的删,拿不准的先留着,下个月再查一次还躺着,再删。
清理不用天天做,一个月跑一次脚本就够。脚本就在那里,跑一次半分钟,列表清爽一个月。定了节奏,这件事就从「想起来才做」变成「到时候就做」,标签系统才守得住。
每次清理完,我会把删掉的标签名记在一个文件里。记这个有两个用处:一是下次看到同样的残片,一眼就知道是老毛病;二是能看出提取器最容易在哪种标题上切错,写标题的时候就有意识地避开。
这四步里最值钱的是第二步。白名单不是拍脑袋定的,是从数据库里查出来的高频标签,它回答的问题是:我的文章到底在反复写什么。答案就是 AI、公众号、写作、AI 新媒体、排版这 5 个词,读者点进任何一个,看到的都是同一类文章——垂直度就是这么立起来的:不是宣传出来的,是标签稳定攒出来的。
标签稳定还有一个顺带的好处:系列文章互相带流量。同一个系列的文章打同一组标签,读者读完一篇,点标签就能进同系列的其他篇,一篇的流量滚成一串的流量。标签页就是你的自选货架,货架摆得整齐,读者才愿意逛。
这套标签治理看着琐碎,其实是一劳永逸的投资。白名单立住之后,每篇新文章只是从 5 个词里挑 2 个,10 秒钟的事;换来的是标签页永远整齐,读者每次点进来体验都一样。
这套治理还有一个隐性回报:你对自己写过什么一目了然。标签页就是文章的地图,哪条主线厚、哪条主线薄,点开标签扫一眼就知道,下一批选题的偏好也跟着清楚。
两个常见的坑
第一个坑:只清不加,或者只加不清。清完孤儿不做白名单,过一阵残片又长出来,因为自动提取还在工作;定了白名单不清孤儿,老残片还躺在列表里占地方。两件事是一套动作,做完一半等于没做。
第二个坑:白名单越定越长。今天加一个,明天加一个,加到十几个,每个标签下的文章就薄了,垂直度又散了。白名单的价值在「白」字上:不是全部,是少数几个反复出现的词;我定 5 个,够用就不动它,新主题真成气候了,再考虑换进来一个。
写在最后
一句话收尾:自动提取拿标点当边界,书名号引号都会把标签切残,解法是白名单加整体覆盖加定期清孤儿,标签稳了,垂直度就稳了。
下一篇讲发布环节最容易漏的几样东西:发布规范太多,怎么保证每次都不掉坑?有一篇文章群发之后我才发现三样配置没做,平台又补不了,教训惨痛,到时候把我的清单原样交出来。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: