
ChatGPT:人类新纪元:它把 GPT 接进 138 亿年,却没接上一根证据
微信读书《ChatGPT:人类新纪元》· 119 屏
逐页翻阅 119 屏 · p0006 核对书名,p0119 为末屏 · 2026-11-08
说明三点。第一,这 119 屏是这本书的全部:最后一屏是「致谢」的末尾,页面上那只翻页按钮已经变成灰色的「下一章」。第二,p0001 不是封面,是正文——第一屏就在讲 2018 年马斯克与 OpenAI 分手、2019 年成立 OpenAI LP、微软投 10 亿美元,前面的封面、目录、推荐序都没抓到。所以这份笔记从第八章之前开始,前面几章我是靠目录结构和后文的回指推的,凡属推测我都会写明。第三,书里所有判断,我只对截图上的文字负责;作者姓名没有出现在我读到的任何一页上,我不猜。抽样逐字核对 16 处:p0001 马斯克分手与 OpenAI LP、p0012 一亿用户与"iPhone 时刻"、p0025 海伦·凯勒的"水"、p0038 罗塞塔石碑、p0040 三种文本平行镌刻与 Koko、p0048 复杂性科学与圣菲研究所、p0060 算力曲线、p0066 570GB 与 CoT、p0072 地月分离与小行星、p0078 脑容量 600 毫升、p0084 智体三段论与"智体病毒"、p0092 智商 100 与齐马蓝、p0100 两个机器人助理的对话、p0108 红蓝药丸与"超越人类"、p0112 后记 12 万字、p0116 致谢"一个多月"。
先说结论:这是一本野心极大、工期极短的书。它想干的事,是把 ChatGPT 放进从大航海、罗塞塔石碑、海伦·凯勒、月球分离、恐龙灭绝一路排到通用人工智能的叙事里,让读者相信"人类新纪元"这个书名不是修辞。它的野心值这个价——同类书大多停在"提示词怎么写",它敢问"智能到底是什么"。
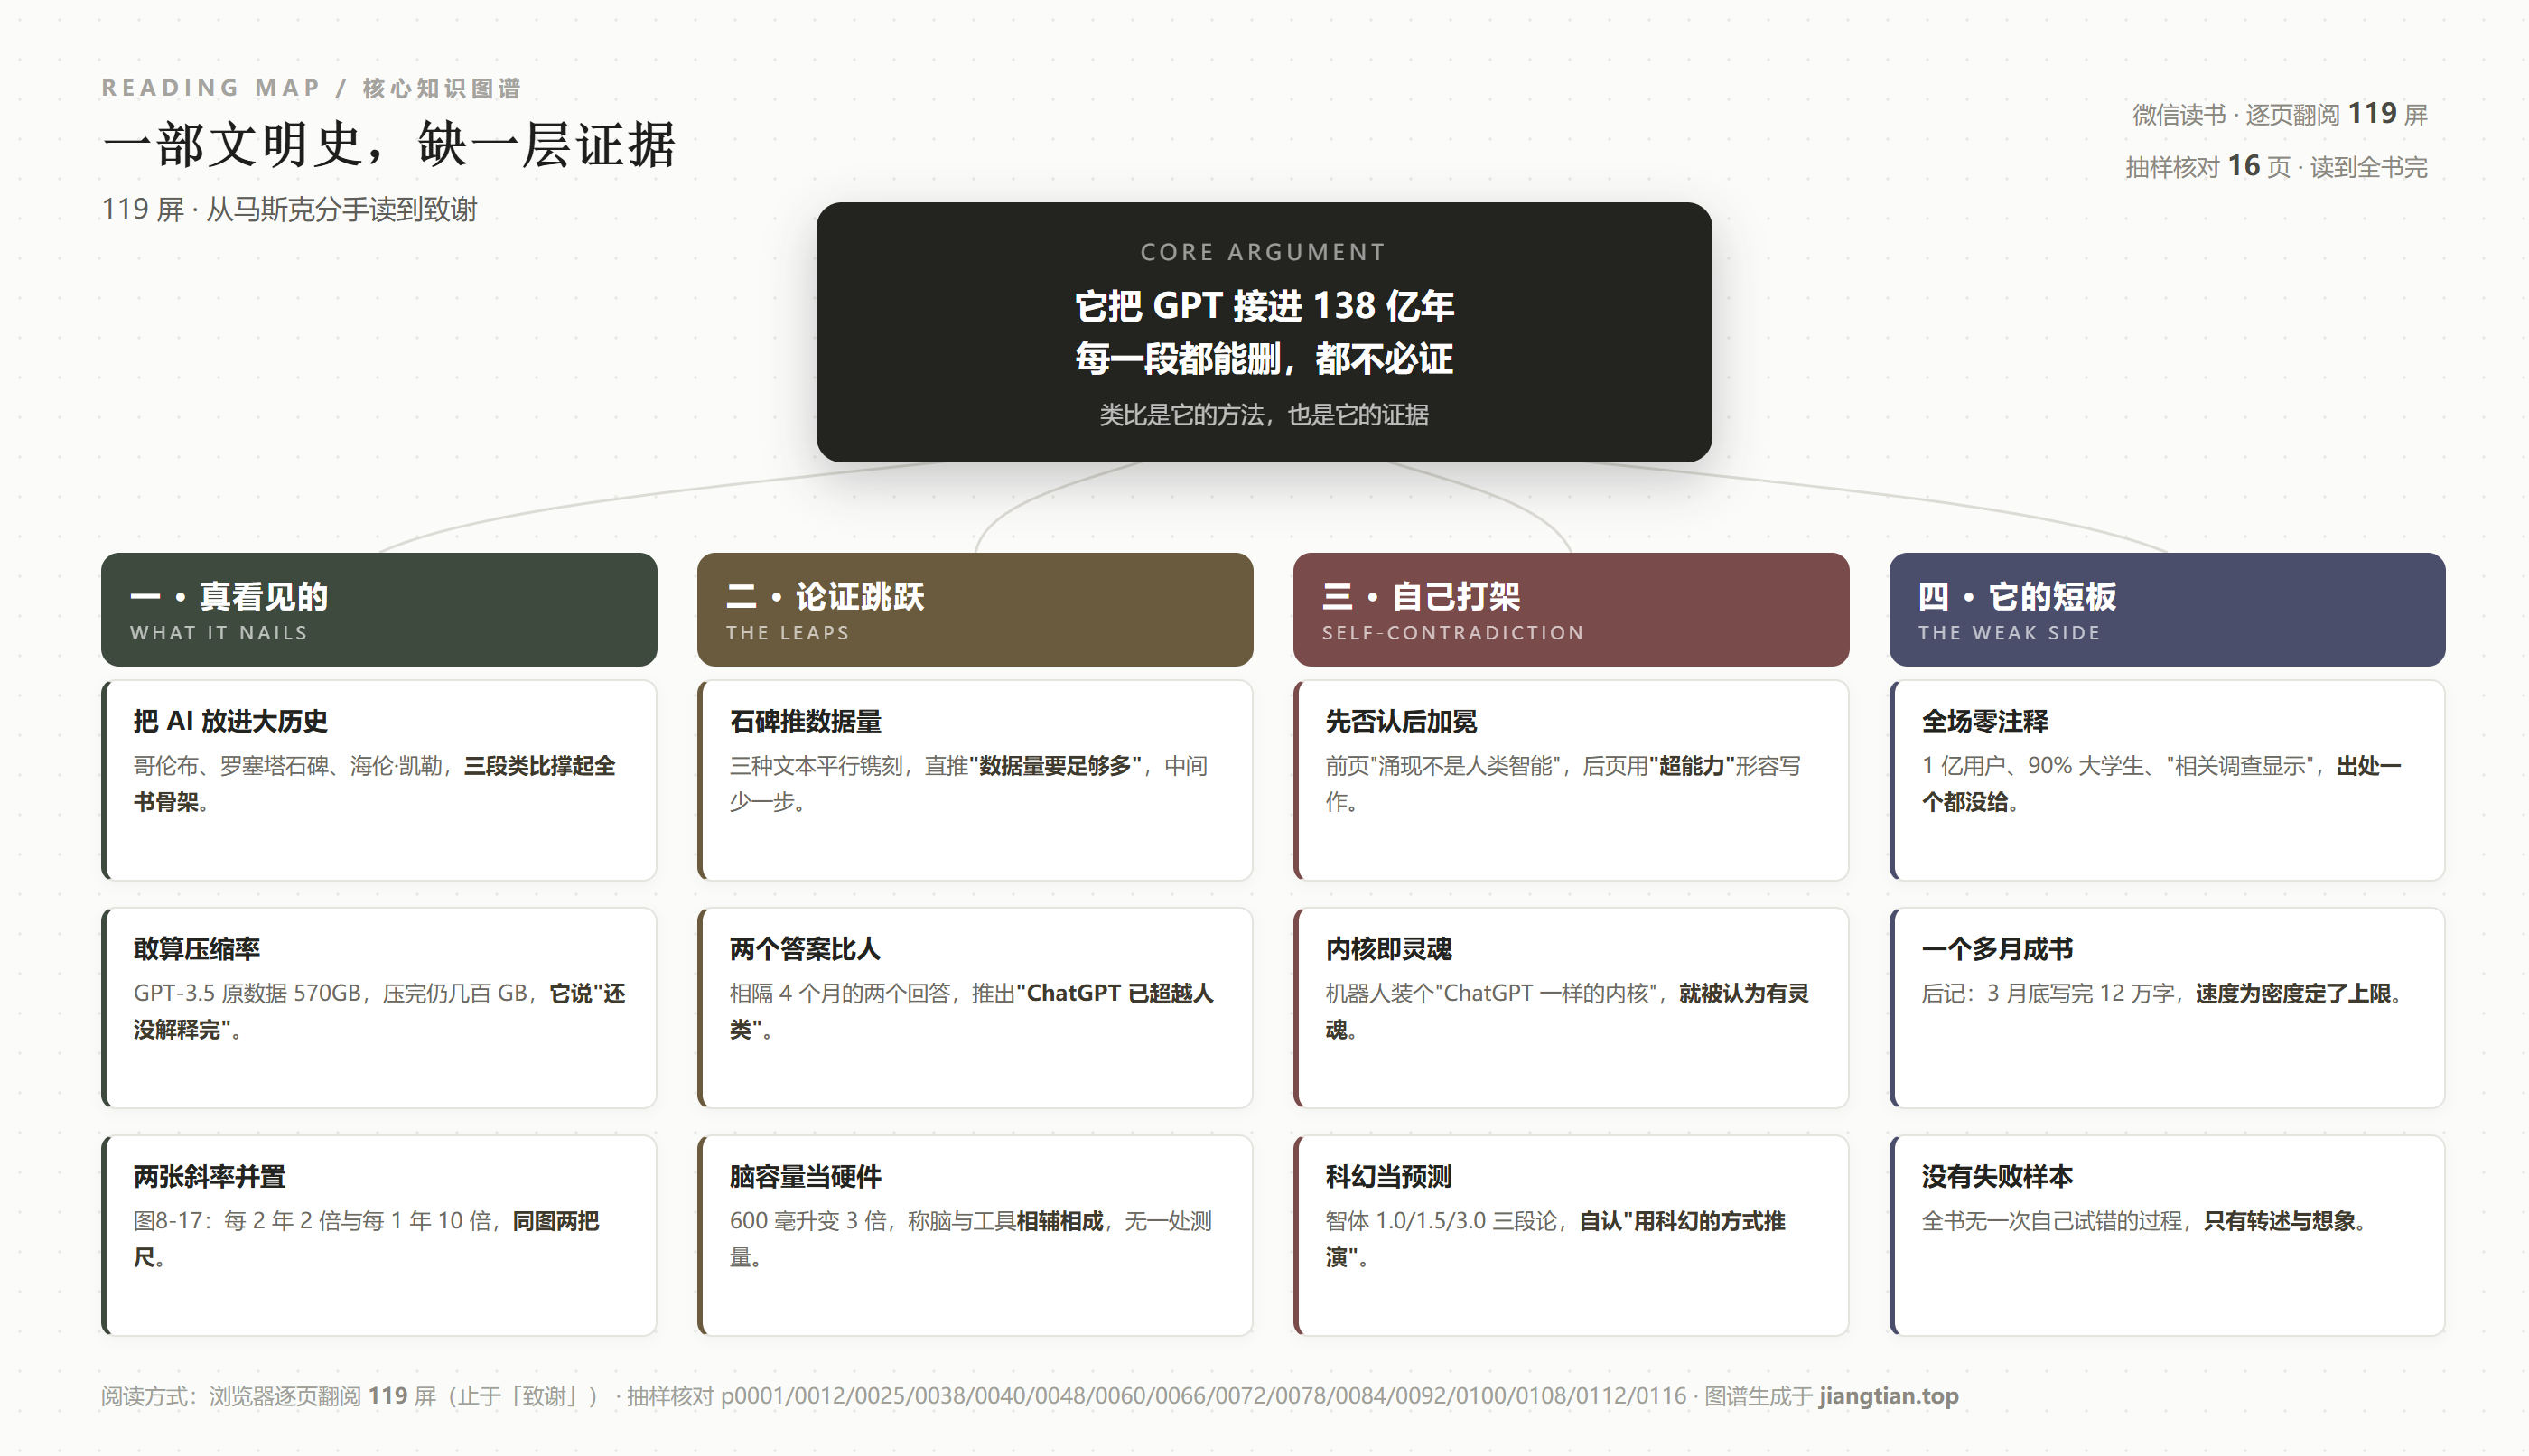
但它有一个贯穿全书的毛病,而且这个毛病不是水平问题,是工期问题:它所有的论证都是类比,没有一个论证是测量。罗塞塔石碑证明"数据要多",脑容量证明"软硬件相辅相成",两个相隔四个月的 AI 回答证明"ChatGPT 已经超越人类"。每一个类比单看都漂亮,连起来却是一条悬空的链子——每一环都靠着上一环的修辞重量挂着,没有一环落在地上。
我给它一句判断:这是一部写得很好的文明史,和一份写得很急的技术论证,被装进了同一个封面。前半部值得读两遍,后半部值得拿来当反面教材。
一、它选了一条难走的路:不给结论,先给坐标系
大部分 AI 科普书的开头是"什么是大模型"。这本书的开头是马斯克和奥特曼分手。p0001 那一屏讲的是 2018 年的事:OpenAI 的支出每年以亿美元计,人才被谷歌、Facebook、微软挖走,"钱在流失,人才也在流失,这让 OpenAI 实现原本的理想变得遥遥无期"。作者引了马斯克 2019 年初那条推文——"特斯拉正与 OpenAI 争夺一些相同的人才。我不认同 OpenAI 团队想要做的一些事情。综上所述,大家最好友好分手。"
然后他给了结论:"最终的思考结果是:这是完全不可能的。"非营利留不住人,于是 2019 年 OpenAI 让步,成立可盈利实体 OpenAI LP,设置"投资者获得不超过 100 倍的盈利回报"的上限,微软投 10 亿美元。
这个开法很聪明。它先不谈技术,先谈钱和人的流向,等于告诉读者:这件事的因果链不在论文里,在组织里。一本讲"人类新纪元"的书,愿意从"谁给谁开工资"讲起,说明作者知道宏大叙事要落地必须先落到具体的账上。
但这里也埋下了全书的第一个隐患:它能给过程,给不了出处。推文是引的,投资额是给的,100 倍上限是写的——这些都是可核的硬信息,读起来让人放心。可一旦离开人事与融资,进入技术与趋势,这种"硬"就消失了。往后翻到 p0012,谈 ChatGPT 的扩散速度:"上线两周,用户量达到了 100 万""上线两个月,用户量达到了 1 亿""相关调查显示,将近 90% 的美国大学生使用 ChatGPT"。
三个数字,一个出处都没有。"相关调查"是哪家机构的调查、样本多大、问的是"用过"还是"每周用",全都没有。这不是吹毛求疵。90% 这个数字如果是真的,它足以改变教育政策;如果是问卷里"你听说过吗"的结果,它什么也说明不了。作者显然知道这两个 90% 的差别,但他选择了不区分。
二、罗塞塔石碑那一节:全书方法论的样板,也是全书方法论的病根
p0038 到 p0040 是这本书写得最好的一段,也是最能暴露它方法的一段。
他先放了一张罗塞塔石碑的照片(图8-4,说明是"拿破仑军队的军官发现的罗塞塔石碑"),然后讲这块石头的关键:"碑文由 3 种文本平行镌刻,内容一模一样,所以才能最终破译成功。"接着立刻往下推了一步,这一步是全书最见功力的地方——他没有停在"破译很了不起",而是指出了破译的验证条件:
但是,如果只有罗塞塔石碑,人们也不能完全确定破译结果是否正确。后来随着一块又一块新的平行文本石碑的发现,罗塞塔石碑破译工作的正确性才不断得到了验证。因此,研究语言不仅要数据好,还要数据量足够多。
这段话的价值在于,它把"数据"这个词从一个数量概念变成了结构概念:好的数据是"平行"的,是同一内容的多重编码,而且要被反复交叉验证。这个洞察放到今天依然站得住——今天所有做语料清洗的人,干的其实就是"找平行文本、不断验证"这件事。
但请注意最后那一句的跳法:"因此,研究语言不仅要数据好,还要数据量足够多。"前半句讲的是"平行",后半句结论是"量多"。罗塞塔石碑的故事支持的恰恰是"结构比数量重要"——三种语言对同一段话,这个设计跟"数据量"没有关系,甚至相反:一块石碑的字数并不多,它赢在三个版本互相对齐。作者把一个"结构"的论据,用来支撑一个"规模"的结论,中间那一步(为什么结构问题可以转化为规模问题)他跳过去了。
这一跳不是孤例,是全书的标准动作。后面讲 Koko——1978 年上《国家地理》封面的雌性西部低地大猩猩,"会使用超过 1000 个单词的手语"——也是同样的用法:一个漂亮的动物学事实被摆上来,然后被当作"语言是符号系统"的证据。至于 Koko 的手语能力在学界有多大争议、是否属于过度解读,书里一个字没有。
所以我的判断是:这本书的方法论水平,体现在它选材的眼光;它的方法论缺陷,体现在它对选来的材料从不追问反例。它会告诉你罗塞塔石碑需要别的石碑来验证,却不会告诉你 Koko 的实验也需要别的实验来验证——尽管它刚刚才用过这个道理。
三、压缩率那一段:全书唯一"敢算"的地方,也是它最诚实的地方
p0066 是我在这本书里唯一读到"作者在跟一个具体数字较劲"的一页。
他在讨论大模型是不是"有损压缩"。"有损压缩和无损压缩并不是对大模型的'唯一'解释,还有很多人有不同的看法。"——先承认自己这套说法不是定论,这个姿态在同类书里少见。然后他给了数字:"GPT-3.5 压缩之前的数据量大概是 570 GB,压缩后数据量仍是几百 GB,数据在压缩体积上的变化并不大,而压缩后的大模型却发生了翻天覆地的变化。"
这一页值得单独拎出来说,因为它是全书唯一一次自我反驳:570GB 压完还是几百 GB,压缩比接近 1,那"压缩"这个比喻就基本失效了。作者没有藏这个矛盾,他把它写出来了,然后说"学习、理解、推理的本质是什么呢……目前并没有一个全面的答案"。
可惜的是,他写到这里就停了。一个更锋利的追问就在嘴边:如果体积没变小,那"压缩"到底压缩了什么?答案大概率不在"体积",而在"可检索性"——原数据是死的字节,模型是可查询的函数。这是把"存储"换成了"调用",是完全不同的一件事。这个区分一旦做出来,全书后面关于"AI 是不是在理解"的讨论会立刻清晰十倍。他没做。
同一页还有一段我很喜欢,因为它给了全书最好的一个类比,而且这个类比是可检验的:
一个人读一本学科教材,往往开始时会感觉越读书越厚,记的笔记也非常多,但在学习了同一本书很多遍之后,反而觉得书越读越薄。这个过程大脑神经网络到底经历了什么?目前并没有一个全面的答案。
"书越读越薄"——这个说法能让人立刻点头,因为它对应着每个人真实的学习经验。而且它是可以往工程上翻译的:读第一遍是建立索引,读第十遍是删掉冗余路径。作者没有翻译,但他至少指对了方向。
这一页还提到了 CoT(思维链)的来源,说"人工智能研究员符尧等人的论文《拆解追溯GPT-3.5各项能力的起源》中提到了思维链来自代码训练的观点",并解释"代码是逻辑性极强且非常精准的语言,代码训练可以学到自然语言中相对较弱的逻辑思维"。这是全书技术含量最高的一段,也是唯一一段让我想去查原文的。有意思的是,紧接着他就自己打自己:"ChatGPT 在某些方面极为出色,但在某些方面非常糟糕。比如,ChatGPT 在最初的版本里,判定 27 是一个素数。"
"判定 27 是一个素数"——这一句比前面十页的宏大叙事都有信息量。27 = 3³,一个初中生不会错的题,一个万亿参数模型错了。它精确地说明了这类系统的能力形状:它擅长"看起来像答案"的东西,不擅长"必须算一遍"的东西。可惜作者只用它做了一次调侃,没有把它变成一把尺子去量后面那些"超越人类"的结论。
四、图8-17:它放了两条斜率,却没有读第二条
p0060 那一页,上半是图8-16——"2016 年,黄仁勋向 OpenAI 赠送内置英伟达 GPU 的 AI 超级计算机",下半是图8-17。这张图是全书最重要的一张图,也是被浪费得最彻底的一张。
图的纵轴是"训练计算时间(单位:百亿亿次浮点运算/天)",点位上排着 AlexNet、ResNets、BERT、Tesla Autopilot、AlphaGoZero,一条虚线标"每 2 年 2 倍",另一条标"每 1 年 10 倍"。作者给的解读是:
从图8-17中,我们可以看到从2012年起,深度学习改变了一切,技术范式发生了重大变化。从2017年起,以 Transformer 架构为基础的 GPT 系列模型等大模型的兴起,更是把神经网络计算推到了更陡峭的增长山坡上,技术范式再次发生变化。
"更陡峭的增长山坡"——就这一句。他没有说陡多少,也没说从哪一年开始换的斜率,更没说这条线还能不能继续。
这才是真正该较真的地方。图里明明画了两条参考线:一条每 2 年 2 倍(摩尔定律的节奏),一条每 1 年 10 倍。这两条线的差别不是"陡一点",是差了五个数量级的时间尺度:前者十年翻 32 倍,后者十年翻一万倍。一张图里同时放这两条线,等于在说"这条曲线已经脱离了整个半导体工业的历史节奏"。那么接下来的问题就很硬了:电力从哪来?先进封装产能从哪来?数据从哪来?这三个约束只要有一个卡住,曲线就得换斜率。
书里对这三个问题一个字都没有。它只把"陡峭"当作情绪词用了一次,然后翻页去讲月球怎么分离。
这就是我说的"把文明史写进来"的代价:当你同时拥有 138 亿年和 5 年两种时间尺度,你会不自觉地用大尺度的从容,去掩盖小尺度的紧迫。因为大尺度永远是对的——太阳总会熄灭,AI 总会变强——而小尺度才是要付账的地方。
五、海伦·凯勒:全书最动人的一页,也最危险的一页
p0025 讲海伦·凯勒。这一页的文字质量明显高于全书平均:莎莉文把海伦的手放在水里,同时在她手心拼写"水","突然间,一种触电般的感觉弥漫全身,海伦终于知道了,这清凉、流动的触感就是水"。然后是那句引文——"这个单词好像一下子焕发了生命力,唤醒了我沉睡的灵魂"。
接着是最好的一个细节:海伦问"爱是什么?"莎莉文把手指放在她心脏的位置说"爱在这里"。海伦困惑:"心跳就是爱吗?拥抱就代表爱吗?"
这段写得好,好在它展示了一个符号如何落地的完整过程:先有一个身体经验(凉、流动),再有一个符号(拼写),两者同时发生,符号才绑上了意义。作者用这个来类比词向量——词的意义来自它与其他经验的共现。这个类比是准的,而且比"词是向量"这种说法高明得多。
但它是危险的,危险在于它太动人,动人到读者会忘记它证明不了什么。
海伦·凯勒有身体,有痛感,有被拥抱的需求。模型没有。"爱在这里"这句话之所以能成立,是因为莎莉文指的那颗心脏真的在跳。模型学到的"爱"是一堆上下文里的共现统计——它可以说出"爱在这里",但它没有那颗心脏。这个差别,在工程上不重要(我们只要它说对),在哲学上却是全部。
作者显然感觉到了这个危险,所以他在 p0066 写了"大模型的智能涌现就是人类智能吗?显然不是"。但感觉归感觉,写法归写法:他一边在 p0066 划清界限,一边在 p0112 用"超能力"来形容"一周写出 5000 字"的人,又在 p0100 说装了"ChatGPT 一样的 AI 内核"的机器人"就可以被认为拥有了灵魂"。
这就不是谨慎,这是两套语言在打架:论证的时候用工程师的语言("显然不是"),叙事的时候用诗人的语言("灵魂""神""超能力")。读者记住的永远是后者。
六、它开始自己打自己:从"显然不是"到"超越人类"
全书最刺眼的一处矛盾在 p0108。
那一页放了一张截图(图9-7),是 GPT-4 回答"什么是蓝色药丸、什么是红色药丸"。截图里的回答写得相当体面:红色药丸代表"愿意面对 AGI 给人类工作和生活带来的影响",蓝色药丸代表"拒绝或限制通用人工智能的发展,以保持现状",最后落到"我们需要在创新与谨慎之间寻找平衡"。
然后作者的评论是:
对比一下相隔 4 个月的两个答案,对于这种进化速度,我们只能用两个字来形容:恐怖。在测试了无数次之后,我的结论是:ChatGPT 已经超越人类。
请把这句话拆开看。"对比相隔 4 个月的两个答案"——两个答案。两个。前面写着"在测试了无数次之后",但给出的证据是两个答案的措辞变化。措辞变流畅,和智能超越人类,中间隔着整整一个评测学。
更值得注意的是紧接着的那一段:他提到本书开头的一个玩笑——"用 1000 亿美元就可以复现人类的全部智能",然后说"巧合的是,2023 年 5 月 4 日,据 The Information 报道,山姆·阿尔特曼私下表示 OpenAI 可能会在未来几年尝试筹集至多 1000 亿美元的资金"。
这是一个非常典型的数字巧合式论证:把一个饭桌上的玩笑,和一条真实融资新闻并置,让读者产生"你看,连数字都对上了"的印象。但那 1000 亿是算力与运营的钱,不是"复现人类智能"的报价;两个 1000 亿撞在一起,只说明这个行业的资本密度,不说明任何智能水平。
而在四十页之前的 p0066,他刚写过"大模型的智能涌现就是人类智能吗?显然不是"。
我不认为这是作者不诚实。我认为这是写作顺序造成的:技术判断写在前面(冷静、克制、有分寸),畅想写在后面(放开、抒情、不设限),两段之间没有任何一次回头校对。一个多月写完 12 万字的人,是没有时间回头校对的。
七、后半部为什么读起来像科幻:从脑容量到"智体病毒"
从第 9 章开始,这本书换了一种写法。
p0072 讲月球怎么分离(图9-1,一张"地月分离模拟图",作者标注为 Citronade)、小行星怎么在 6600 万年前撞掉恐龙、250 万年前南方古猿怎么打出第一把石斧。p0078 讲"人类的软件和硬件":脑容量从制作石斧时的 600 毫升,"慢慢增加到原来的 3 倍大",农业文明之后又慢慢收缩(图9-3 是一排头骨,标注"智人(晚期)1500 毫升",还有一个红色箭头写着"我们在这")。
这些段落的知识密度不低,读着也顺。但它们的论证功能是零——它们只是在为"人类 3.0"这个说法铺情绪。真正需要论证的地方,比如"脑容量增长 3 倍"和"智能提升"之间的因果关系,书里给的是一句"软件和硬件的提升是相辅相成的",然后就走开了。脑容量和智力之间不是线性关系(这一点连入门的人类学教材都会讲),书里没有提。
到了 p0084"智体的未来",写法彻底变成推演:"智体 1.0——通用人工智能的基本版本""智体 1.5——端到端的人形机器人""智体 3.0——自我迭代硬件的智体"。作者自己交代了底:"预测有时是粗暴自大的,并且可能会有错误,但我们仍然喜欢预测。ChatGPT 已经将科幻电影里的许多想象变为现实。现在,让我们继续用科幻的方式来预测、推演一下智体的未来。"
坦白是坦白,但坦白不能替代论证。这一节里最耸动的是"智体病毒":智体可以复制自己,于是会出现"智体病毒","完全可以寄生到分布式计算机网络里,或者进入被种植木马的'肉鸡'里,这就叫作'智体寄生'"。同时他又说,智体 1.0 的局限(被动、离散、离线、无长期记忆)要突破,"唯一的障碍就是 AI 对齐和安全问题"。
"唯一的障碍"这四个字,是全书最轻率的一句。一个做 AI 的人不会说"唯一的障碍是对齐"——因为对齐之外还有上下文长度、长期记忆的写入策略、工具调用的可靠性、权限与审计、成本。这些都写在实际的工程文档里,不写在科幻电影里。而在同一段气质下他还虚构了两个机器人助理的对话(p0100),让它们互相说"感觉主人想换新款啊,我难道要下岗了?""你这么贵,别担心,会有个新主人的。刷一下机,你不会有痛苦的。"——这段写得有趣,但它是小说,不是预测。
我不反对科普书里有想象。我反对的是把想象和事实放在同一层级上,用同一种字体排出来,让读者自己去分辨哪句是"据报道",哪句是"我猜"。这本书从头到尾没有做过一次这样的区分:融资额和机器人对话,用的是同一套语气。
八、它的短板
按说这本书的好话,我在前面已经说完了。这一节只谈短板,四条,按严重程度排。
第一,全书没有一个注释,没有一个可核的出处。这是硬伤,不是风格问题。"1 亿用户""90% 的美国大学生""《国家地理》封面""符尧等人的论文""The Information 报道"——这些都能查到,作者也都知道在哪,但书里没有一处给出链接、期刊号、页码。于是一个读者读完这本书,没有任何能力去验证其中任何一句话。一本讲"人类新纪元"的书,把自己写成了不可复核的孤本,这在方法上是倒退的。
第二,它的密度是被工期决定的。p0112 的后记写得很坦白:作者 35 岁去学写作,请了 6 位作家当老师,上了有 20 多位老师讲课的喜剧培训班;2023 年春节后决定写书,"我做出写书的决定只花了一天";"当 3 月底我写了 12 万字,将全书写完的时候,我已经彻底爱上了写作。现在只要给我一天,我就能写出 3000 字。" p0116 的致谢补了另一句:"编辑白羽。是他勤奋地催稿,才让我在一个多月内就写完了全书。"
12 万字,一个多月,41 岁。我不认为这是丑闻,恰恰相反,这是一个中年人极高的执行力。但速度决定了一本书能做到什么、做不到什么。一个多月能写完的是并联——把读过的材料按主题摆好,每段配一个类比;一个多月写不完的是串联——把每条论据追到源头,检查它是否真的支撑结论。这本书通篇是并联结构,所以它读起来特别顺,也特别经不起追问。
第三,它没有一次"我试过,它失败了"的记录。这本书讲了几十个案例:哥伦布、罗塞塔、Koko、元胞自动机、地月分离、齐马蓝、红蓝药丸。这些全是转述和引用。全书没有一处是"我自己拿它做了个实验,结果是这样"。唯一接近的是"判定 27 是素数"和"congratulations 第 12 个字母"这两个反例,但它们是被当作趣闻一笔带过的,没有被用来修正任何结论。
这是一个可惜的选择。作者显然天天在用 ChatGPT(不然写不出那些截图),他手里的第一手材料比引用的多得多。他选择了当一个讲述者,而不是一个测试者。讲述者能写出好看的文明史,测试者才能写出别人写不出的东西。
第四,它把"人类新纪元"这个判断,建立在了时间感上,而不是证据上。书名就是论点。但全书用来支撑"新纪元"的,主要是三样东西:扩散速度(两周 100 万用户)、名人的形容词("iPhone 时刻""不亚于个人计算机和互联网的诞生")、以及一条陡峭的算力曲线。这三样都能说明"这件事很大",没有一样能说明"这是新纪元"。区别在于:大,是程度;新纪元,是断裂。断裂需要证明旧规则失效,而这本书从头到尾都在用旧规则(类比、趋势外推、名人背书)来解释新事物。
那它到底值不值得读?值得,但要带着一个前提读:把它当前传,不要当证据。
它最好的部分在"怎么讲":罗塞塔石碑要别的石碑来验证、书越读越薄、海伦·凯勒的水、"爱在这里"——这四个片段,任何一个都够一个老师在课上讲二十分钟,而且讲完学生真的会记住。这种把抽象概念接到身体经验上的能力,是绝大多数技术作者没有的。
它最差的部分在"凭什么":所有结论都靠类比的重量撑着,没有一个结论有可复核的支撑。你读完会知道"这件事很大",但你不会知道"大到什么程度、用什么量、谁来付账"。
所以我的用法是这样的:把它当成一张地图,不当成一份测绘报告。地图告诉你这片大陆上有哪些地形——组织、算力、语言、复杂性、对齐、具身;测绘报告才会告诉你每条河的宽度和流速。这本书给了前者,而且给得相当漂亮。
至于"人类新纪元"这个判断对不对,我的看法是:它可能是对的,但这本书没有证明它对。它证明的只是"2022 年 11 月 30 日之后,很多东西不一样了"。从"不一样了"到"新纪元",中间要的是旧规则的失效证明,不是新事物的魅力展示。
最后一句:这本书最动人的地方,是它相信人类这一次真的跨过了一道门槛;最危险的地方,是它从头到尾没告诉我们那道门槛在哪,只告诉我们门那边很好看。
抽样核对:p0001 马斯克 2019 推文与 OpenAI LP 100 倍上限 / p0012 两周 100 万、两月 1 亿、"将近 90% 的美国大学生"与"iPhone 时刻" / p0025 海伦·凯勒"水"与"爱在这里" / p0038 图8-4 罗塞塔石碑 / p0040 三种文本平行镌刻与 Koko 1978 / p0048 复杂性科学、1984 圣菲研究所、元胞自动机 / p0060 图8-16 黄仁勋赠机、图8-17 每 2 年 2 倍与每 1 年 10 倍 / p0066 570GB 压缩与 CoT、27 是素数 / p0072 图9-1 地月分离 / p0078 脑容量 600 毫升与图9-3 / p0084 智体 1.0/1.5/3.0 与"智体病毒" / p0092 智商 100/200/1000 与齐马蓝 / p0100 机器人助理对话与"拥有灵魂" / p0108 图9-7 红蓝药丸与"已经超越人类" / p0112 后记 12 万字 / p0116 致谢"一个多月"
核对方式:每屏截图 + 顶部书名条比对(p0006 书名条为「ChatGPT:人类新纪元」,与目录名一致)· 笔记与图谱生成于 2026-11-08
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: