
《生成式AI:人人都需要知道的》:它敢说"涌现"是量错了,却拿"我没见过"当证据
微信读书《生成式AI:人人都需要知道的》(财之道丛书,译作)· 65 屏
逐页翻阅 65 屏 · p0006 核对书名,p0065 为末屏 · 2026-11-08
说明三点。第一,这 65 屏也不全。它读到"第三章 可能的影响"里的"生成式AI将如何改变教育?"为止,p0065 是一张还在转圈的加载页,p0062 是一张几乎全灰的空白页。所以这本书我只读到两章半。第二,这本体例特殊:它不是章节论述,是一问一答——每个小标题就是一个问题("什么是'嵌入'?""什么是'越狱'?为什么这是个难题?"),65 屏里挤了二十多个问题。这使得它的密度很高,也使得它很难有连贯的论证。第三,书里出现的所有判断,我只对截图里的文字负责;作者与译者姓名不在我读到的页面上,我不猜。抽样逐字核对 13 处:p0001 通用性与"样样通"、p0002 译者序论拟人化、p0004 引言六条预测、p0006 麦卡锡定义与八维智能、p0013 麦卡洛克-皮茨与罗森布拉特、p0021 鸡蛋叠电脑、p0035 词元与自我更正、p0039 涌现之争、p0042 越狱与分层审查、p0045 幻觉与自证、p0055 三个历史先例、p0058 医疗与一杯咖啡、p0065 断点。
先说结论:这是一本少见的、愿意把"智能"这个词拆开来看的科普书。它不哄你,甚至在译者序里就直接说"将机器智能与人类智能相比较,是一种愚蠢的做法",然后指出整个行业的拟人化包装有一半动机是晋升和预算。
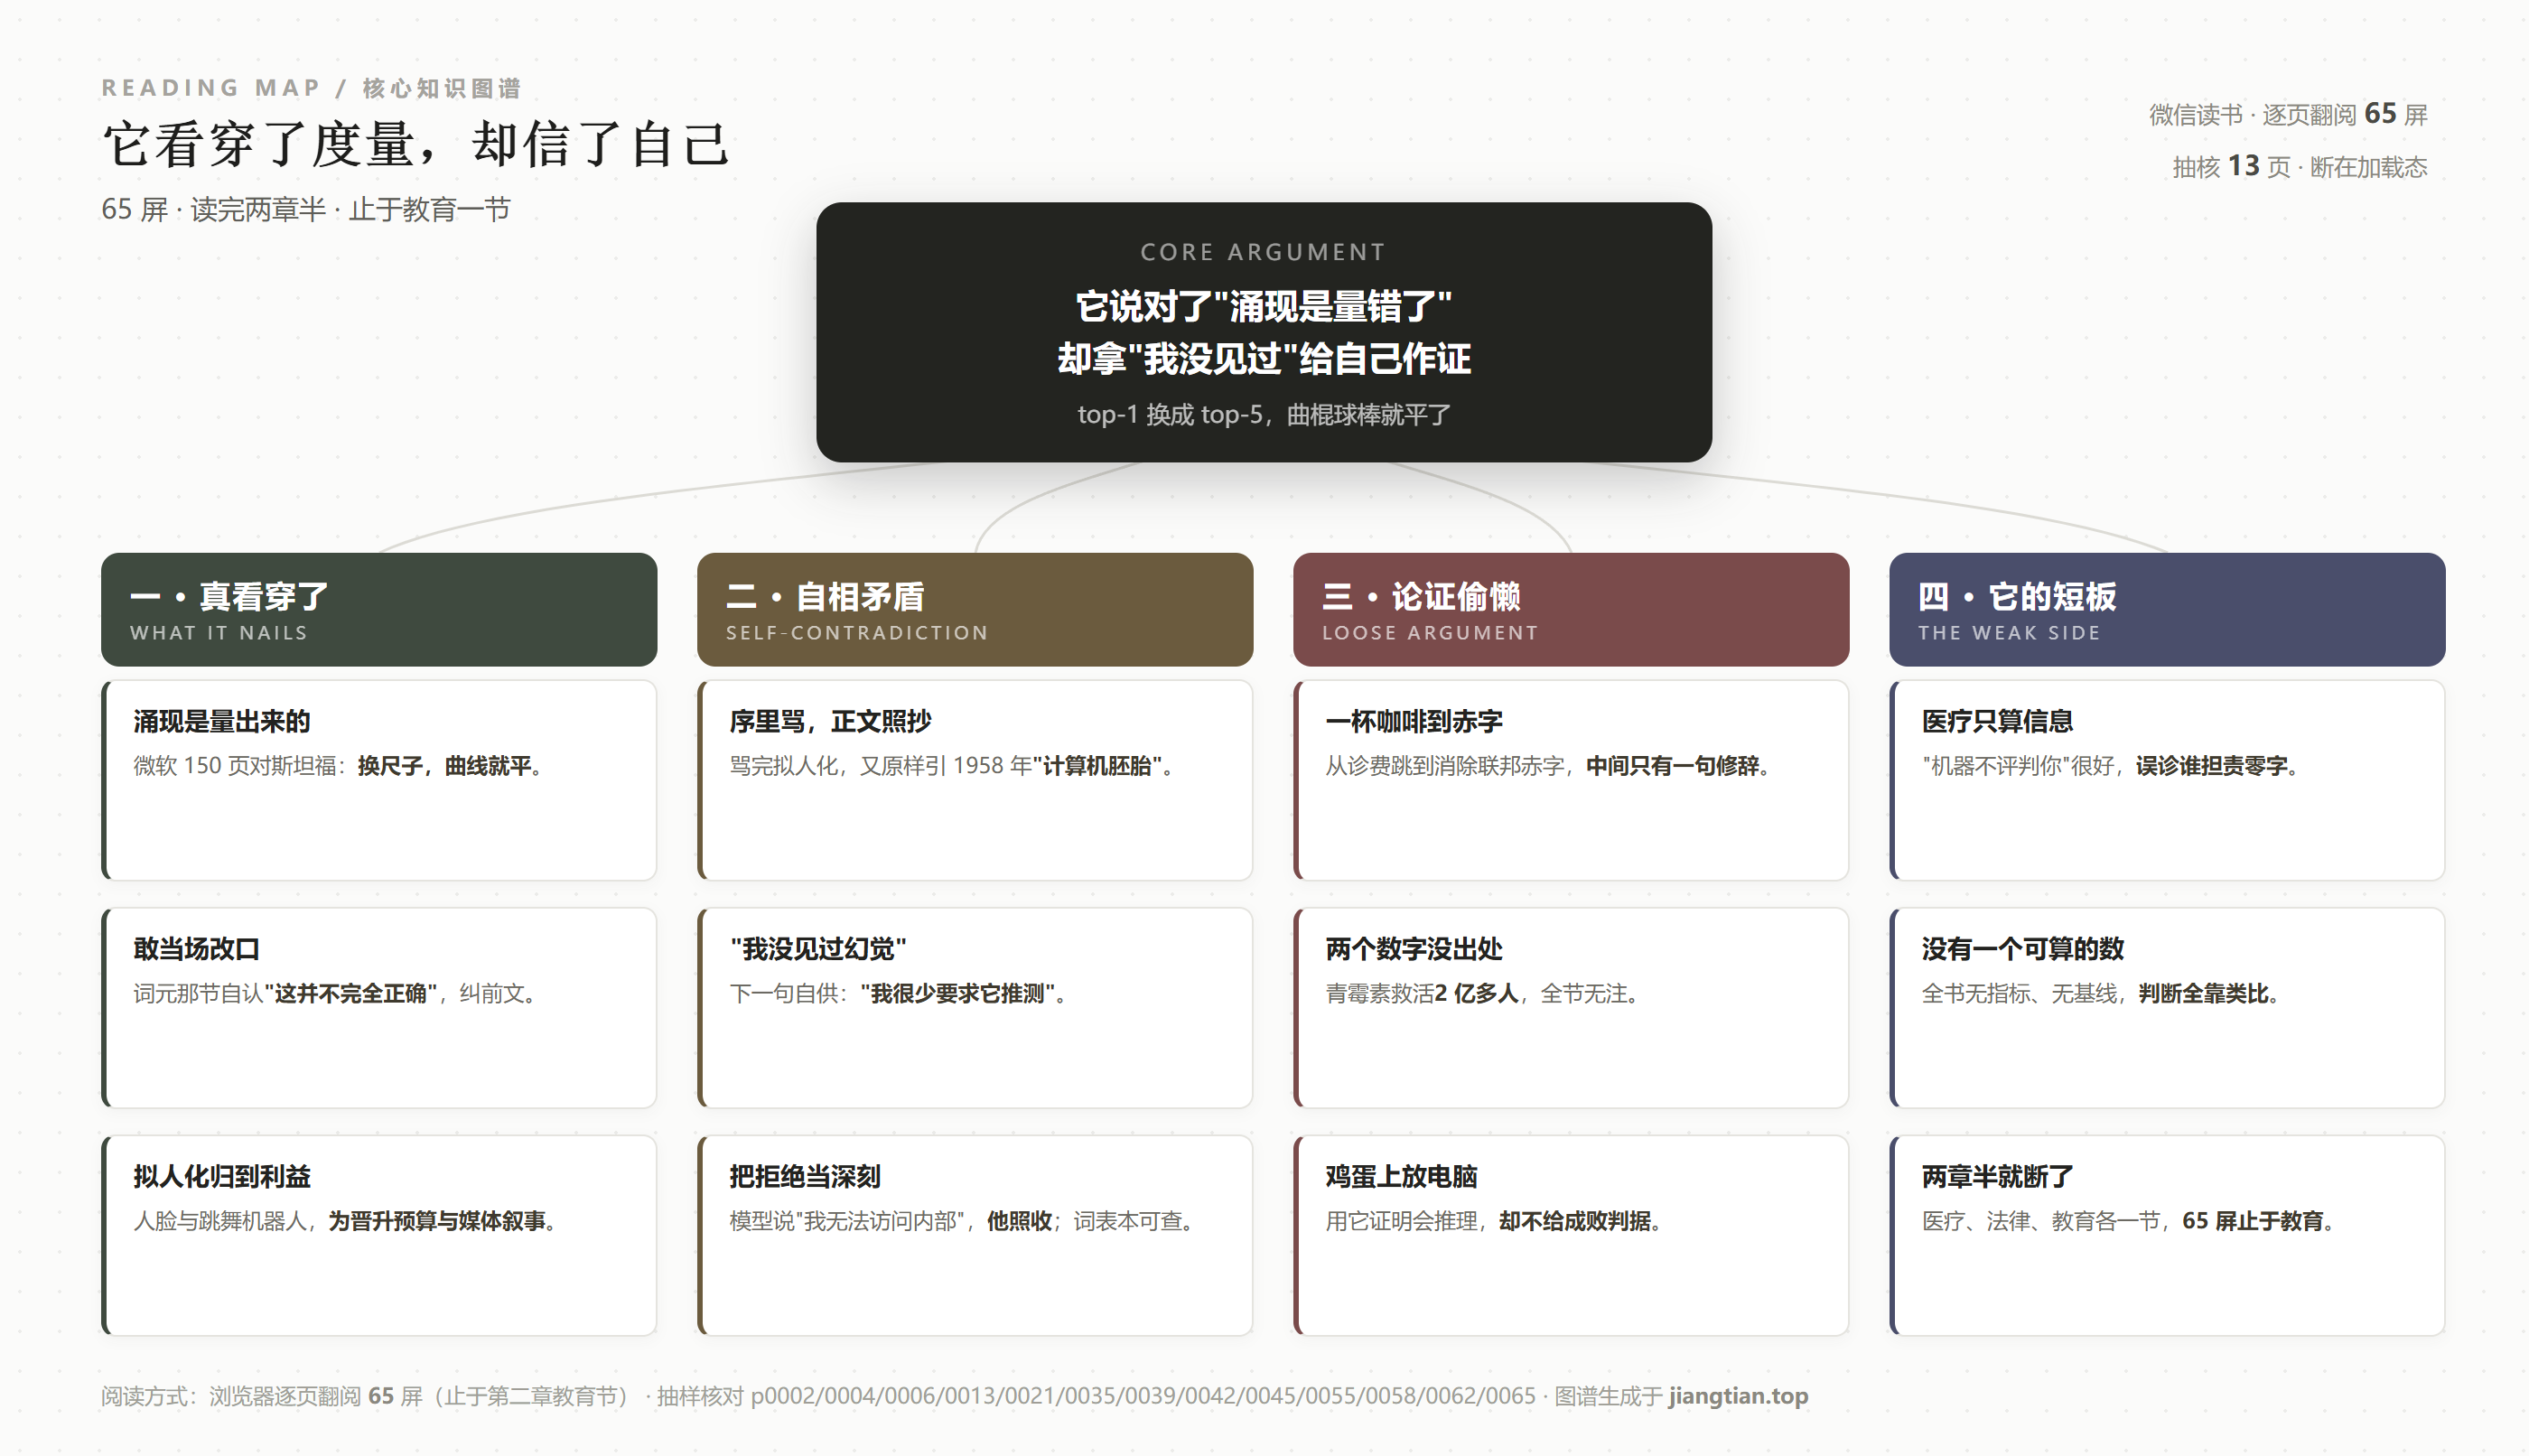
但它有一个反复出现的毛病:它在需要证据的地方,用的是自己的经验;在需要区分的地方,用的是漂亮的类比。最典型的一处,是它一边给出全书最锋利的方法论("涌现"可能只是量错了),一边在另一节里用"我没见过幻觉"来论证幻觉可解——而这句话的下一句,就是它自己承认"因为我很少要求它推测"。
我给它一个判断:这是一本识破了别人的度量幻觉、却没躲过自己的观察偏误的书。前者让它值得读,后者让它只能读到七分。
一、先说它的分量:它把"智能"当成一个待定义的词
p0006 那一节叫"什么是'人工智能'?",开头就说这是个"易问但难答的问题",理由有两点:关于智能是什么,人们几乎没有共识;而且"至少到目前为止,人们几乎没有理由相信机器智能与人类智能有太大的关联,即使两者看起来很像"。
然后它引了麦卡锡 1955 年的那个经典定义——"使机器以如果人类这么做就会被认为智能的方式来行动"。引完立刻拆:这个定义有严重缺陷,因为我们连人类智能都定义不了,更别说测量。
我们的文化倾向于将事物简化为数字来测量,以便进行直接比较,这往往会造成一种虚假的客观性和精确性。而试图量化像智能这样主观而抽象的东西,显然就属于这一类。我们能说幼小的萨莉(Sally)的智商就比约翰尼(Johnny)的智商高出7分吗?
这一段的厉害之处不在批评,在于它给了一个替代方案:加德纳的八维智能(从"音乐-节奏"到"身体-运动"再到"自然主义")。作者没有说八维理论是对的——他明说这是"一个有争议的框架"——但他用它做了一件事:把"智能"从一个标量变成了一个向量。
这个动作看起来只是科普,其实是全书的方法论底座。因为一旦智能是向量,"机器在某几维超过人类"就不再是威胁叙事,而是一个坐标问题。后面那些"会不会取代人"的争论,在这套坐标里自动降级成了"在哪一维、用什么尺子量"。
这也是我读这本书时唯一一次感到"它比同类书高一档"的地方。多数 AI 科普书的开篇是"什么是大模型",这本书的开篇是"你凭什么说你聪明"。
二、"涌现"那一节:全书最硬的一段,硬在它承认对手有理
p0039,标题是"什么是'涌现性质'?大语言模型展现出涌现性质了吗?"。这一节我读了三遍,因为它是全书唯一一段把一场真实争论的两方都摆平了的地方。
先是一方:2023 年 3 月,微软的研究人员发布了一份 150 多页的分析报告,标题很挑衅——《通用人工智能的火花:GPT-4 的早期实践》。报告说,随着模型规模扩大,某些能力会突然自发产生,在图表上表现为"曲棍球棒式"的形状:起初上升缓慢,然后像火箭一样突然起飞。
然后是另一方。斯坦福的学者很快发文反驳,理由不是"你们测错了模型",而是更狠的一句:
这些曲线的形状是由于原论文使用了特定的成功率衡量标准。例如,要衡量正确识别一个口语单词的性能,你可以只看该单词作为系统首选情况所占的百分比,在这种方式下,随着模型的增大,性能确实会突然提高。但是,如果采用更加全面的衡量标准,例如,该词是否在前五个选项之中,你就会发现不同的模式:正确单词的出现频率和排名会缓慢上升。
因此,他们的论点是,这种表现实际上是相对平稳化且可预测的,而不是突如其来且出乎意料的。
这段话说的是:"涌现"可能不是模型的性质,是尺子的性质。你用 top-1 量,曲线是断崖;你用 top-5 量,曲线是缓坡。同一批数据,两种尺子,两种世界观。
我认为这是过去三年 AI 讨论里最该被普及的一个论点,而绝大多数中文书没写。这本书写了,而且写清了机制(不是"有人质疑",而是"质疑的具体理由是换度量")。仅凭这一节,它的价值就超过了很多厚得多的"大模型原理"。
但它停在了"两方都有道理"这一步。它没有往前走一步,而这一步其实很近:如果涌现依赖度量,那么"能力什么时候出现"这个问题,本质上是在问"你用哪把尺子"。这意味着任何"某模型在某任务上突然及格"的新闻,第一个该问的不是模型,是评测集。这本书把这个推论留给了读者——对一个"人人都需要知道的"定位来说,这一留,留掉了最实用的那半句。
三、词元那一节:一个作者当场改口,比十句正确更值钱
p0035 是我私人最喜欢的一页。作者先让模型把"visualization"切成词元,模型给了 "visual" + "ization"。然后他做了一件很多人不会做的事:要求模型给出这些词元的实际数值。
模型回答:"作为一个 AI 语言模型,我无法直接访问内部工作机制。"
作者接受了这个回答,并写下一句评价:"就像你和我不能窥视大脑的内部工作机制一样,GPT-4 也无法真正地'看到'自己的内部细节层面。"
这句话有问题,我后面会说。但先看同一页的后半段——那里有一件更珍贵的事。作者写完词元之后,回头纠正了自己前面的说法:
因此,当我在前文说大语言模型是基于词嵌入来计算词与词之间的语义关系时,这并不完全正确。它计算的是词元与词元之间的语义关系——事实证明,这在实际应用中大致相同。
"这并不完全正确。"这六个字,是科普书里最难得的东西。绝大多数作者写到这里会说"更准确地说"或者干脆不改,因为读者不会发现。他改了,而且把改动的理由、改动的范围("在实际应用中大致相同")都写清楚了。
我把这一页和上一页放在一起看,会觉得这个作者是可信的:他愿意在自己刚说完的地方踩一脚刹车。这种自我更正,比十句"我认为"更能建立信任。
也是因为这一页,我对下一节要批评的那处才格外不满意——因为同一个作者,明明有能力做这种区分,却在另一个地方没做。
四、但它转身就犯了同一个错:把"我没见过"当证据
p0045 讲"幻觉"。前半段写得很好,例子也狠:你如果暗示自己已经死了,模型会顺着这个前提,告诉你"你离开这个世界的确切日期和情形"。作者的解释是准确的——
这里的根本问题在于,大语言模型很难区分什么是真实的,什么是虚构的。……许多回答需要它进行反事实的推理,比如:"如果我昨天在人行道的冰上滑倒了,我最有可能发生什么事?"所以,当你暗示你已经死了,它可能会在回答中合理地假设这是真的。毕竟,它并没有想到你会对它撒谎。
"它并没有想到你会对它撒谎"——这句话点到了要害:幻觉不只是"编造",更是对输入的无条件接受。你给的每一句话,它都当成事实前提。这在工程上叫"缺少可信度分层",在人际交往里叫"太容易相信人"。
然后他给了自己的判断:
我预计这个问题是可以被解决的。例如,当我与现有的大语言模型讨论大多数技术主题时,我发现它们极其有用,我还没有发现它们在编造事实。它们反而似乎是绝对准确的。但在这些对话中,我很少进行推测,也很少要求它们推测。
请注意最后一句。它把前面三句全部推翻了。
"我还没有发现它们在编造事实"——因为我只用它们讨论技术主题;"它们似乎是绝对准确的"——因为我很少要求它们推测。也就是说:他观察到的"没有幻觉",恰恰是因为他避开了会产生幻觉的用法。然后他用这个观察,去支撑"这个问题可以被解决"的预测。
这是一个很典型的方法错误,名字叫选择偏误:样本不是从人群里随机取的,是从"我用得顺手的场景"里取的。更尖锐一点说:他不是在验证模型,他是在验证自己的用法。
我不能说他的预测错了——幻觉确实在被大幅改善。我要说的是:他的证据撑不起他的结论,而这个证据刚好来自全书最该严谨的一节。
同一页上,他还写了一句更值得注意的判断:"当前的架构并不包含真实性的概念,但未来的设计可能需要这样做。"这句话是对的,而且很硬。但他没有把这句话和前面那个乐观预测放在一起掂量——如果架构里根本没有"真实性"这个量,那"我预计可以解决"就只能是一条信念,不是一条推论。
这也顺带解释了 p0035 那处。模型说"我无法访问内部工作机制",作者把它类比成"你不能窥视大脑",于是收下了。但这两件事完全不对等:大脑的权重你看不到,tokenizer 的词表你随时可以打印。"visualization → visual + ization" 这个切分是可以在本地跑一行代码验证的,不是玄学。模型的回答"我无法访问内部工作机制",本质上是一句产品层的拒答话术——它不知道自己被切成了几个 token,这和"内部机制不可窥视"是两回事。作者把一个工程可查的东西,写成了哲学不可知。
他没有编造,他只是在需要动手的地方,选择了相信。
五、序里骂拟人化,正文照抄"计算机胚胎"
p0002 是译者序的末屏,也是全书火力最猛的一页。它先说"将机器智能与人类智能相比较,是一种愚蠢的做法",然后直接点名:
AI领域的一大弊端是,研究人员似乎无法抵挡这样的诱惑:用毫不相干的拟人化修饰(人脸、合成人声、有手有脚会跳舞的机器人等)来包装他们的工作,而这些对于想要展示的实质性进步来说,是完全没有必要的事。那么,他们为什么还要这么做呢?当然是为了职业发展。
接着说:研究人员也是人,也渴望关注和赞美;曝光越多,晋升、预算、任期、拨款的前景越好;"如果他们被视为可以抵御神话般的超级智能怪物在伯利恒诞生的救命稻草,那就更好了"。最后一句是"媒体喜欢这类通过煽动对神秘且强大力量的恐惧来刺激读者的故事"。
这段话我喜欢。它把一个通常被写成"技术伦理"的问题,还原成了激励机制问题:不是有人想骗你,是有人靠你的害怕拿经费。这个视角比"警惕 AI 威胁论"有用得多。
但我翻到 p0013,看到这一段:
1958 年,《纽约时报》发表了一篇堪称受骗典范的报道文章,题为《从实践中学习的新海军设备:心理学家展示了设计用于阅读和变得更聪明的计算机胚胎》。
然后他引了罗森布拉特的预测,接着往下讲感知器。
问题就在这里。"计算机胚胎"这四个字,正是他两页之前痛骂的那种拟人化。而且这篇报道的年份是 1958 年,标题里同时塞进了"变得更聪明"和"胚胎"——把一台算加权的机器说成一个会成长的生物。他在序里说这是"愚蠢的做法""为了职业发展",在正文里引这篇报道时,只加了"堪称受骗典范"五个字,然后就去讲技术了。
他明明握着最好的例子:拟人化不是新毛病,1958 年就上过《纽约时报》头版;而当年那台"胚胎"后来冷了二十年。这条线如果拉出来,"AI 叙事的周期"这个主题能立住一整章。他没拉。他把史料当史料用,没当证据用。
这是全书最可惜的一处浪费,也是它内在矛盾最明显的地方:批评写在序里,材料躺在正文里,两者没有接上。
六、一杯咖啡,到"消除联邦赤字"
p0058 讲医疗,开头先给了一个不太乐观的事实:现有的 AI 医疗系统"并未达到应有的普及率",原因包括系统不能对话、无法要求它们解释自己的推理,再加上"医疗行业的惰性和医疗协会的抵制"。
然后它给了三个数字和一句预测:加州初次看病的平均费用 158 美元(作者自己为一位没保险的朋友争取急诊,最低 500 美元);"不久后,生成式 AI 的看病费用将与买一杯咖啡相当,甚至更低";一台机器"不会评判或否定你的忧虑,不会迟到,不会带着疲惫或宿醉上班,也不会急于知道其孩子在学校表现"。
这三句都很好。尤其最后一句——它说的不是效率,是羞耻感。很多人不去看病,不是因为贵,是因为不好意思。这是一个真正懂医疗场景的人才会写的细节。
但接下来这段,滑了:
这对我们的医疗保健系统可能产生的影响怎么高估都不为过。由此,"美国联邦医疗保险"(Medicare)和"美国贫困者医疗补助保险"(Medicaid)等长期资金不足的美国政府项目,其成本在经历了数十年的上升后,即使没有下降,也可能趋于平稳。我们可能决定迅速扩大这些服务的途径,甚至富裕的病人也会理所当然地选择这些服务。仅此一点,就可能对美国赤字的减少或消除产生重大影响。
从"一杯咖啡的诊费"到"消除美国赤字",中间只隔了一句"怎么高估都不为过"。
这不是夸张修辞的问题,是链条缺环的问题。要让诊费降到一杯咖啡,至少要有四件事同时成立:AI 能替代的不只是问诊而是判断;错误率低到可以免于诉讼;监管允许无医生在场;支付方愿意为它付钱。这四件事,这本书一件都没讨论,就直接跳到了财政账。
而同一节里,作者自己已经把最难的那一环说出来了——"无法要求它们解释自己的推理"。一个不能解释推理的系统,恰恰是最不可能被允许独立看病的系统。他把障碍写在了前一段,把红利写在了后一段,中间没有连起来。
p0055 那三个历史类比也是同一路数。印刷机、爱迪生的灯泡(1879)、弗莱明的青霉素(1928,"仅这一种药物就已挽救了2亿多人的生命")。然后连问三次"它的影响会超过××吗"——印刷机,"几乎是必然的";灯泡,"可以说,会的";青霉素,"非常有可能"。
最后他自己招了:"我本可以继续将生成式AI与照相机、留声机、飞机、核能、电话、互联网等发明逐一进行比较,但我想你已经明白了。"
这句自嘲是诚实的,但它也承认了:这一节不是论证,是修辞练习。三个类比、三次"必然/非常有可能"、一个没有出处的"2 亿多人",撑起来的只是一个情绪,不是一条判断。类比能启发,不能证明——这一点,他在讲"涌现"的时候明明是很清楚的。
七、它的短板
短板一:只读到两章半。65 屏止于"生成式AI将如何改变教育?",p0065 是加载页,p0062 是空白页。后面还有多少章、有没有讲监管与就业,我不知道。"可能的影响"这一章我只看到了医疗、法律、教育三节的开头,法律那节我甚至只拿到半屏。
短板二:问答体救了密度,害了论证。每个小标题是一个问题,一个问题两三屏。这让它读起来极快,也让它极难建立起跨节的推理。全书最典型的例子就是"涌现"那一节:它把两方观点摆得极清楚,却没有余地去写"所以我们应该怎么读模型发布的评测"——因为篇幅到了,下一节要换问题。体例决定了它只能停在"介绍争论",到不了"给出方法"。
短板三:全书没有一个可复算的数字。65 屏里,唯一带着具体机制的量化,是"158 美元诊费"和"2 亿多人";前者是生活观察,后者没有出处。至于参数量、token 数、上下文长度、准确率——一个都没有。这不是疏忽,是定位:它写给"人人",所以刻意不碰数字。但这个选择的代价是,读者拿不到任何可以自己去验证的东西。一本讲"如何判断 AI 说的话是真的"的书,自己却不提供可核对的数,这有点讽刺。
短板四:医疗只算了信息,没算责任。"机器不会评判你"这句是全书最好的观察之一,但它同时暴露了这本书对医疗的理解:医疗=信息咨询。而医疗的另一半是检查、给药、手术、以及出事之后谁负责。一个 AI 可以免费回答一千万个问题,但只要它误判一次而没有人担责,整套体系就进不了医院。这一层,p0058 一个字没有。
短板五:覆盖率我得说清楚。65 屏里我逐字核对了 13 屏,20%。这 13 屏分布在译者序、引言、第一章的技术诸节、第三章的影响诸节,位置是散开的。所以上文那些"全书没有"的说法,严格讲是"我读到的这些屏里没有"。但有一点可以确定:我读到的每一屏,都在给判断,而没有一屏在给方法——除了"涌现"那一节提到了度量标准。
说完短板,说句公道话。这本书有两处是同类书里罕见的:一是它敢把"涌现"归因于度量标准,并且把反驳方的具体理由写出来;二是它在词元那一节当场改口,说"这并不完全正确"。这两件事都需要作者放下"我什么都懂"的姿态,而大多数科普作者放不下。
它的问题也不是不诚实,恰恰相反——它太诚实了,诚实到把"我很少要求它推测"这种自供都写了下来。它只是没有在写完之后回头看一遍:这句话和我前面的结论,是不是打架。
这本书适合谁?适合"想搞明白大模型到底在干什么、但不想看公式"的人。它会把"嵌入""词元""涌现""越狱""幻觉"这些词一个个拆开,用问题和故事讲,不吓唬你,也不哄你。
不适合谁?不适合"想拿它当判断依据"的人。它给你的是视角,不是标尺。你读完会知道"涌现可能只是量错了",但你不会知道"那我该用什么量"。这两件事之间,还差着一整套评测工程,那得去别处学。
最后一句:这本书最值钱的地方,是它教会你怀疑别人的尺子;最危险的地方,是它在需要尺子的时候,用了自己的眼睛——而一双眼睛见过的东西,永远比世界小。
抽样核对:p0001 通用性与"样样通,样样精" / p0002 译者序论拟人化与"伯利恒" / p0004 引言六条预测(商业生态、开源廉价、质量控制行业、私人助理、电子律师、医疗) / p0006 麦卡锡 1955 定义与加德纳八维智能 / p0013 麦卡洛克-皮茨 1943、罗森布拉特 1958 与《纽约时报》"计算机胚胎" / p0021 鸡蛋叠电脑 / p0035 词元切分与"这并不完全正确" / p0039 微软 150 页与斯坦福的度量反驳 / p0042 越狱原文与"超我/本我"分层审查 / p0045 幻觉与"我很少要求它推测" / p0055 印刷机·灯泡·青霉素三个类比 / p0058 158 美元诊费与一杯咖啡
核对方式:每屏截图 + 顶部书名条比对(p0006 书名条与目录名一致)· 笔记与图谱生成于 2026-11-08
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: