
《GPT图解:大模型是怎样构建的》:曲线降了,多少算好没说
微信读书《GPT图解:大模型是怎样构建的》· 679 屏
逐页翻阅 679 屏 · 从 p0001 的版权信息一路读到 p0679 的结语 · 2026-11-07
说明三点。第一,这本书的 meta 只记到第 1 课 1.3(抓取脚本早前跑过一版,pages.jsonl 只落了 90 行就断了),但 PNG 是完整的 679 张,p0400 已经在讲 Transformer 的编码器类,p0620 在讲 GPT-2 微调,p0679 是结语。所以章节位置我按页码抽样定位,不按那份残缺的目录说话。第二,p0006 落在序章里,不是扉页;我靠顶部书名条核对,写的是「GPT图解 大模型是怎样构建的」,与目录名一致,这是这个项目里少数几个目录名没错的。第三,我只对这一版截图负责:书如果改版,页码会变,我引的页码就对不上了。抽样逐字核对 9 处:p0006 技术传承清单、p0100 词袋向量、p0150 训练日志、p0250 Seq2Seq 语料、p0350 注意力分类、p0400 编码器类清单、p0500 BERT 与 GPT 之辨、p0620 微调代码、p0679 结语。
先说结论:这是一本把「大模型怎么搭起来」讲通了的书,从 N-Gram 一路搭到 Transformer、再到 GPT-2 微调,链条是接得上的,这在同类书里已经算难得。
但它有一个贯穿全书的问题:它只给你看曲线在往下走,从不告诉你走到哪儿算合格。
下面按我读到的部分,一处一处说。有夸的地方,也有不客气的地方。
一、账:679 屏,一条能走通的链路
先给结构。这本书的骨架是一条技术演化线,序章(p0006 那一屏)把它一次摊开了:
· N-Gram和Bag-of-Words:都是早期用于处理文本的方法,关注词频和局部词序列。
· Word2Vec:实现了词嵌入方法的突破,能从词频和局部词序列中捕捉词汇的语义信息。
· NPLM:基于神经网络的语言模型,从此人类开始利用神经网络处理词序列。
· RNN:具有更强大的长距离依赖关系捕捉能力的神经网络模型。
· Seq2Seq:基于RNN的编码器-解码器架构,将输入序列映射到输出序列,是Transformer架构的基础。
· Attention Mechanism:使Seq2Seq模型在生成输出时更关注输……
这条线是对的。很多讲大模型的书直接从 Transformer 开始,读者不知道 Self-Attention 要解决的是什么问题——没有 RNN 的「记不住长距离」,就没有注意力的出场理由。这本书把「为什么需要」放在「是什么」前面,这是它最值钱的地方。
按页码看它的厚度分配:序章从 p0004 铺到 p0090 附近,占八十来屏,讲的是从统计语言模型到 GPT-4 的六十年;第 1 课从 p0090 之后开始,p0100 已经在 1.5「用词袋模型计算文本相似度」;到 p0250 已经在讲 Seq2Seq 的语料库构造;p0350 讲注意力的分类;p0400 是 Transformer 的十个类;p0500 在辨 BERT 与 GPT 的差别;p0620 在微调 GPT-2;p0679 收在结语。
九十屏讲历史、五百多屏讲实现、最后几屏抒情收尾。这个分配比多数同类书干净——历史部分不抢戏,实现部分不跳步。序章占 13% 左右,是我见过的同类书里最克制的一档。
二、它最聪明的一招:用对话把「为什么」递出去
这本书有一个写法上的设计,值得单独说:全书是双人对话体。
p0100 那一屏是这样的:
小冰:哦,原来是这样!那我们可以用代码实现这个过程吗?
咖哥:当然可以,我们来编写一个简单的词袋模型。
小冰是学生,咖哥是老师。整本书的技术推进,都靠小冰问一句、咖哥答一段来完成。
这个设计解决了一个真问题:技术书的读者,卡住的地方往往不是「这段代码什么意思」,而是「为什么要写这段」。而后者在单人叙述里很难自然出现——作者总不能自己问自己。加一个人物,问题就有地方问了。
p0250 那一屏也是这个套路。讲 Seq2Seq 的语料库,先用四段解释「每行为什么要放三个句子」:第一句中文进编码器,第二句带 <sos> 的英文进解码器,第三句带 <eos> 的英文做目标输出。解释完,原文来一句:「这个语料库包含5组句子,涵盖人工智能、深度学习、自然语言处理、神经网络等不同主题。」
这是全书讲得最清楚的一类段落:先说「为什么这么设计」,再说「这里放了几组」。先给理由,再给参数——这个顺序,很多教材是反的。
对话体也有代价。小冰的台词有一半是「哦,原来是这样!」「了解了」「那么 GPT 呢?」,这些句子不承担信息,只承担节奏。读到第三十屏,你会希望她偶尔问一句难听的——比如「那我们这个模型,跟真的 GPT-2 差在哪」。全书我抽样看到的九屏里,她一次都没这么问过。
这是个遗憾,因为读者心里一定有这么一问。对话体最大的价值,是替读者把不敢问的问题问出来;这本书用它来替读者点头。
三、词袋那一页:两个维度的向量,直接说可以比
p0100 是全书我停留最久的一屏,因为它示范了一个很多人会照抄的错误。
原文先给了两个句子:「咖哥喜欢吃苹果」「苹果是咖哥喜欢的水果」,然后把它们表示成向量:
· {"咖哥":1, "喜欢":1, "吃":1, "苹果":1}
· {"苹果":1, "是":1, "咖哥":1, "喜欢":1, "的":1, "水果":1}
通过比较这两个向量之间的相似度,我们就可以判断出它们之间关联性的强弱。
两个问题,都很具体。
第一个是维度。第一个向量 4 个键,第二个 6 个键。余弦相似度要求两个向量在同一个坐标空间里——先取词表并集(咖哥、喜欢、吃、苹果、是、的、水果,共 7 维),两边都补齐到 7 维、缺的补 0,然后才能算。书里用两个并列的字典直接展示,读者照着写,第一行代码就会撞上维度不匹配。
正确的样子应该是这样一排,我得把它写出来,因为这是这一节唯一的实操点:
词表(并集,7 维):咖哥 喜欢 吃 苹果 是 的 水果
句1:[1, 1, 1, 1, 0, 0, 0]
句2:[1, 1, 0, 1, 1, 1, 1]
点积 = 3,|句1| = 2,|句2| = √6 ≈ 2.449,余弦 ≈ 0.612
三个数摆出来,读者立刻知道「0.612 算像还是不像」这件事有多含糊——而这正好是我要说的第二个问题。
第二个是「的」进了词表。第二个向量里有一个「的」:1。这个字不携带任何主题信息,它的作用只是让两个句子的相似度被稀释一点。中文做词袋,第一步就是去停用词,而这本书的例子把停用词留在里面,还没提这件事。
后果不大,但方向是错的:教一个方法的时候,示例里的每个选择都会被读者当成规范。他记住的是「分词之后直接数」,而不是「数之前先决定什么词不该进」。
关于 0.612 这个数,我想多说一句。它落在 0 到 1 之间,看起来「有点相关」,但没人能说 0.61 是「强关联」还是「弱关联」。判断相似度阈值,得有一批标注过的句子对,才知道 0.6 在这套表示下是什么水平。这本书后面给了 loss 曲线,但没给一次「相似度多少算相似」的判定。
还漏了一件事,而这件事恰恰是词袋最该被提醒的地方:它把词序丢了。「咖哥吃苹果」和「苹果吃咖哥」,用同一套词袋表示算出来,向量一模一样,相似度是 1.0。这不是实现上的 bug,是方法本身的性质——词袋只关心「有哪些词、各几次」,不关心「谁在前、谁在后」。所以它适合做主题分类、垃圾邮件过滤这类「看词不看序」的任务,不适合做意图识别、指代消解这类「顺序即语义」的任务。
这一条,从 N-Gram 走到 Word2Vec、再走到 Transformer,整条路都是在对「词序」这件事做加法:N-Gram 加了局部顺序,RNN 加了序列状态,注意力加了全局位置关系。如果读者在第一课就知道「词袋丢了什么」,后面每一课为什么存在,就都有了理由。可惜这一页只讲了「词袋能算出相似度」,没讲「它算不出什么」。
四、loss 从 2.17 降到 1.86,这算好吗
p0150 那一屏,是这本书最像「真跑过」的地方,也是最暴露它短板的地方。
屏幕上是一段训练输出:
Epoch: 100, Loss: 2.1747937202453613
Epoch: 200, Loss: 2.1470229427019754
Epoch: 300, Loss: 2.1150383671124775
Epoch: 400, Loss: 2.07618362903595
Epoch: 500, Loss: 2.0306010961532595
Epoch: 600, Loss: 1.9832865635553996
Epoch: 700, Loss: 1.9422581712404887
Epoch: 800, Loss: 1.9113846600055695
Epoch: 900, Loss: 1.8883622487386067
Epoch: 1000, Loss: 1.869449504216513
下面是「训练损失曲线」,纵轴 2.00 到 2.20,一条平滑下降的蓝线。
这段日志的真实感很强——数字带十几位小数,是直接从终端里贴出来的,不是编的。这一点值得肯定:它给了原始输出,而不是「训练效果良好」四个字。同类的书里,十本有六本只给结论。
问题是,然后呢?
一个读者看到 loss 从 2.17 降到 1.86,学到的是什么?大概率是「降了就对了」。可判断这件事,至少需要三样东西,书里一样都没给:
第一,基线。随机猜的 loss 是多少?如果把词表大小记作 V,均匀随机猜的交叉熵大约就是 ln(V)。只有知道这个数,才知道 1.87 离「瞎猜」有多远、离「学会了」有多近。就这一屏给出的信息,读者无法判断 1.87 是「已经不错」还是「基本没学到」。
第二,困惑度。loss 2.17 换成困惑度大约是 8.8,1.87 大约是 6.5(e 的 2.17 次方、e 的 1.87 次方)。困惑度的意思更直观:模型在每个位置上,平均在多大的候选集里犹豫。从 8.8 到 6.5,等于「从八选一进步到六选一」。这个换算只要一行代码,书里没做。
第三,对照。如果换成 trigram,loss 是多少?如果把嵌入维度从 64 改成 128,会不会更好?没有对照,这条曲线的形状只有一个解释——「训练在跑」,不能解释「这个设计对不对」。
我知道有人会说:一本图解入门的书,不必要求到这个程度。这话有一半道理。但请注意,这本书已经把原始日志贴上来了——它离「做一次对照」只差一段代码的距离。它选择了停在「看起来在进步」这一步。
还有一个细节,我盯着看了很久:这条曲线太干净了。一千个 epoch,十次记录,每一次都比上一次低,没有一次反弹、没有一次发散。真实的训练不是这样,真实训练里总有那么几个 epoch,loss 会突然往上跳一下,你会盯着屏幕想「是不是学习率大了」。
书里没有这种时刻。不是作者隐瞒,而是这类教学示例的语料太小、任务太简单,根本不可能出现那种时刻。但读者不知道这一点,他会以为训练就是这样的——一条平滑下降的线。等他拿真数据跑,第一次遇到 loss 不动了,他会以为自己写错了。
五、注释写 100 轮,代码写 500 轮
这一条是硬伤,因为它自相矛盾,而且矛盾就在同一屏里。
p0620 是「第5步 对GPT-2进行微调」,代码是这样开的:
import torch.nn as nn
import torch.optim as optim
# 定义损失函数,忽略pad_token_id对应的损失值
criterion = nn.CrossEntropyLoss(ignore_index=tokenizer.pad_token_id)
# 定义优化器
optimizer = optim.Adam(model.parameters(), lr=0.0001)
# 进行100个epoch的训练
for epoch in range(500):
for batch_idx, (input_batch, target_batch) in enumerate(chat_dataloader): # 遍历数据加载器中的批次
注释写「进行100个epoch的训练」,代码写 range(500)。
这一处,我不打算替作者找解释。可能是改了代码忘了改注释,也可能是从别处抄来一段注释。两种可能都一样:这段代码在成书前没有被最后一遍读过。
为什么这一处比别的错更要紧?因为读者会照抄。照抄的人执行完 500 轮,回头对不上注释里的 100,第一反应是「我是不是哪里配错了」——他不会怀疑书,他会怀疑自己。这就是教材类错误最坏的一种:它不报错,它让你怀疑自己。
同一屏还有一处值得夸:criterion 用了 ignore_index=tokenizer.pad_token_id。这个参数的意思是「填充位的损失不算」。这是很多入门代码会漏的一步——不设它,模型会花大量算力去学习「预测填充符」,loss 看起来很低,实际全是水。书里不仅设了,还在注释里写了原因。
但同一屏顶端还有一行小字,我看得比较仔细:「(这个ID值在此处也是50256),以便模型能够正确处理填充的部分。」50256 是 GPT-2 的词表大小——它比最后一个真实 token 的编号大一位,正好可以拿来做填充符的编号,这个用法是对的,也是当年很多实现的通行做法。
问题在于,这个数被写成了字面量。换一个分词器(哪怕只是换成本地训练的一个 BPE),50256 就不再是「词表外第一位」,模型会直接报索引越界。写法上更稳的是 tokenizer.vocab_size 或直接给 tokenizer 加一个 pad token,让它自己分配编号。把一个跟着模型走的数写死成常量,是这类教学代码最常见的隐患:这一次跑得通,下一次换个模型就崩。
一屏之内,一个地方做到了教科书水准,另一个地方是明显的失校。这大概就是「多人协作、赶工期」留下的纹理。
六、它讲对了的地方:两张掩码,两种单向
得给这本书记两笔功,否则不公道。
第一笔,是 p0400 的掩码讲解。那一屏在列 Transformer 的十个组成部分,其中两条是:
(4)填充掩码:通过get_attn_pad_mask函数为填充令牌<pad>生成注意力掩码,避免注意力机制关注无用的信息。
(7)后续掩码:通过get_attn_subsequent_mask函数为后续令牌(当前位置后面的信息)生成注意力掩码,避免解码器中的注意力机制「偷窥」未来的目标数据。
这两句把两件事分清了:填充掩码解决「长度不齐」,后续掩码解决「不许看未来」。这两个东西在初学者脑子里经常糊成一团——都叫 mask,都在注意力里,都填负无穷。而它们要防的是完全不同的两类错误:一个是浪费算力,一个是作弊。
尤其是「偷窥」这个词,用得好。它把「解码器训练时能看到完整目标句」这个技术事实,翻译成了一个有画面的动作。技术书里,一个好比喻省下的解释,比一段公式多。
第二笔,是 p0500 对 BERT 与 GPT 的辨析。原文的思路是:GPT 训练时采用单向语境(从左到右),BERT 采用双向(同时考虑上下文);因此 GPT 在生成文本时更擅长保持连贯性,但在理解某些上下文时不如 BERT。
这个对比是准确的,而且它给了一个「所以」——不是「两者不同」就完,而是「所以 GPT 擅长生成、BERT 擅长理解」。很多书讲到这儿只列差异,不给推论,读者记不住。有推论的对比,才是知识;没有推论的对比,只是并列。
七、五组句子、四类注意力、十个类名
这一节说三个「给了清单,没给判据」的地方。
第一个,五组句子的语料。p0250 说得很坦白:「这个语料库包含5组句子」,而且「是专门为学习Seq2Seq模型而创建的」。坦白是好事,但五组句子能训练出什么?能训练出「这个流程跑得通」,训练不出「模型学会了翻译」。读者跑完这一步,看到输出,会觉得「成了」;而真做翻译任务,五万句起步,还要处理词表、批次、长度分布。
我在这里给一个可执行的判断法,用来区分「教学示例」和「能用的模型」:把你的验证集换成没在训练里出现过的句子,如果输出退化成高频词堆砌,说明它学的是「句子长度的分布」,不是「语言」。五组句子的模型,一定过不了这一关。书里没让读者做这个测试,所以这个失败点被藏起来了。
第二个,四类注意力只列不选。p0350 把注意力分成加性(Bahdanau)、全局、局部(硬/软),每一类给了定义和一句评价(「计算复杂度略高,但在某些场景下可能更适用」「计算成本较高」)。
问题是,读者读完这四段,仍然不知道自己在写代码时该用哪个。而真实答案是单一的:现在几乎没人手写加性注意力,缩放点积注意力(Scaled Dot-Product)是默认选择,因为它能用矩阵乘法一次算完,GPU 友好。这一条,书里没写。
「某些场景下可能更适用」——这类句子在技术书里是逃逸词。它不算错,但它不承担判断。一个分类如果不能让读者做出选择,那它只是名词表。
第三个,十个类名的堆叠。p0400 把 Transformer 拆成十个类:填充掩码、编码器层、编码器、后续掩码、解码器层、解码器、Transformer 本体,加上前面几项,一共十件。这个拆法本身是对的——它对应真实代码里的模块划分。
但它只说了「是什么」,没说「为什么这么切」。为什么 EncoderLayer 和 Encoder 要分两层?因为一层是「一个块」,一个是一摞块,前者可复用、后者管堆叠。为什么要单独抽一个 get_attn_pad_mask 函数?因为它在编码器和解码器里都要用,抽出来就不用写两遍。
模块划分是最能体现工程思维的地方,而这本书把它当成了目录来列。读者抄完这十个类,能跑通,但不知道下次自己写别的模型时该怎么切。
八、它的短板
照规矩,一条一条列,能核的核,不能核的说明不能核。
短板一:全书没有一条报错记录。我抽的九屏里,代码全是「In 一段、Out 一段」,Out 里全是正常输出。没有一次维度不匹配、没有一次显存不足、没有一次 loss 变 NaN。而这本书教的东西——手写 Transformer、微调 GPT-2——恰恰是最容易在这三处翻车的地方。一本教人搭模型的书,如果不教人读报错,等于只教了一半。
短板二:图不可复算。p0150 的损失曲线只有纵轴刻度(2.00 到 2.20),没有源数据表,也没有绘图代码。读者想复现这张图,得自己跑一千个 epoch 才可能得到形状相近的一条线。图表的价值在于「可以被别人重画」,这本书的图,只能被看。
短板三:结语替了边界。p0679 的收尾是这样的:「人类科技的突破,从未按照单调的线性增长模式前进,有时暂时沉寂,而有些时刻却如奇迹般涌现。ChatGPT 的出现就是这样一种状况……」
这段文字写得不错,但它回答的是「这件事有多重要」,不是「你手上这套代码能撑多大」。后者才是读者真正需要的:这套两百行的实现,和真正的 GPT-2 之间差了什么?差在数据量(这本书用的语料是几组句子,GPT-2 用了 40GB 网页文本)、差在并行(单卡与上千卡)、差在分词器(字符级与 BPE)、差在评测(loss 与一堆下游任务)。
这四样,一本书哪怕只用一页讲清,读者对自己所处的位置就有了坐标。用抒情收尾,是最省力也最没用的收尾。
短板四:没有一处讲「省」。全书的默认路径是「把模型搭起来、跑起来」。但真做工程,第一步往往是「能不能不搭」——能不能用现成的权重、能不能只微调最后几层、能不能把序列截短。这本书一路搭到底,读者学完的手感是「什么都要自己写」,这在今天是要吃亏的。
短板五:抽样声明。我只读了九屏,覆盖率约占全书的百分之一点三。所以上面关于「全书没有报错」「全书没有对照」的判断,严格说是「我抽到的九屏里没有」。我不打算把它说成「全书零」,那是越界。但这九屏分布很散(序章、第1课、Seq2Seq、注意力、Transformer、BERT 对比、微调、结语),如果这些位置都在给顺境,那「只写顺境」这个判断,站得住。
如果让我改这本书,我只加两页,加在第 1 课末尾:第一页给「判断 loss 好不好」的三行代码(算基线 ln(V)、算困惑度、跑一个 trigram 对照),第二页给「训练会怎么坏」的三种典型现象(loss 不降、loss 变 NaN、loss 降但生成仍是乱码),每种现象配一句排查方向。
这两页的取材全是现成的——作者手上有日志、有代码、有跑通过的经验,缺的只是把它们往「读者会撞墙的地方」挪一挪。入门书最值钱的两页,往往不是「怎么做成」,而是「做不成时怎么想」。
写完五条,说句公道话:这本书的定位是「图解」,是把黑箱拆开给人看,不是把模型调到最好。在这个定位下,它做得相当扎实——链路完整、顺序合理、代码能跑、比喻准确。我上面挑的这些,多数是「它可以更好」,而不是「它做错了」。
唯一真正算错的,是那行 range(500) 与注释里的 100。这一条没有解释空间。
这本书适合谁?适合「看过很多大模型科普、但不知道 attention 到底怎么算」的人。它会把那条链路一段一段搭给你看,搭完你就知道 GPT 不是魔法,是一串矩阵乘法加一个 softmax。
不适合谁?不适合「想判断自己训的模型好不好」的人。那套判断——基线、困惑度、对照、失败案例——这本书一样都没给。
科普书的合格线,是让人看懂。工程书的合格线,是让人能判断对错。这本在第一条上做得很好,在第二条上,只给了一条下降的曲线。
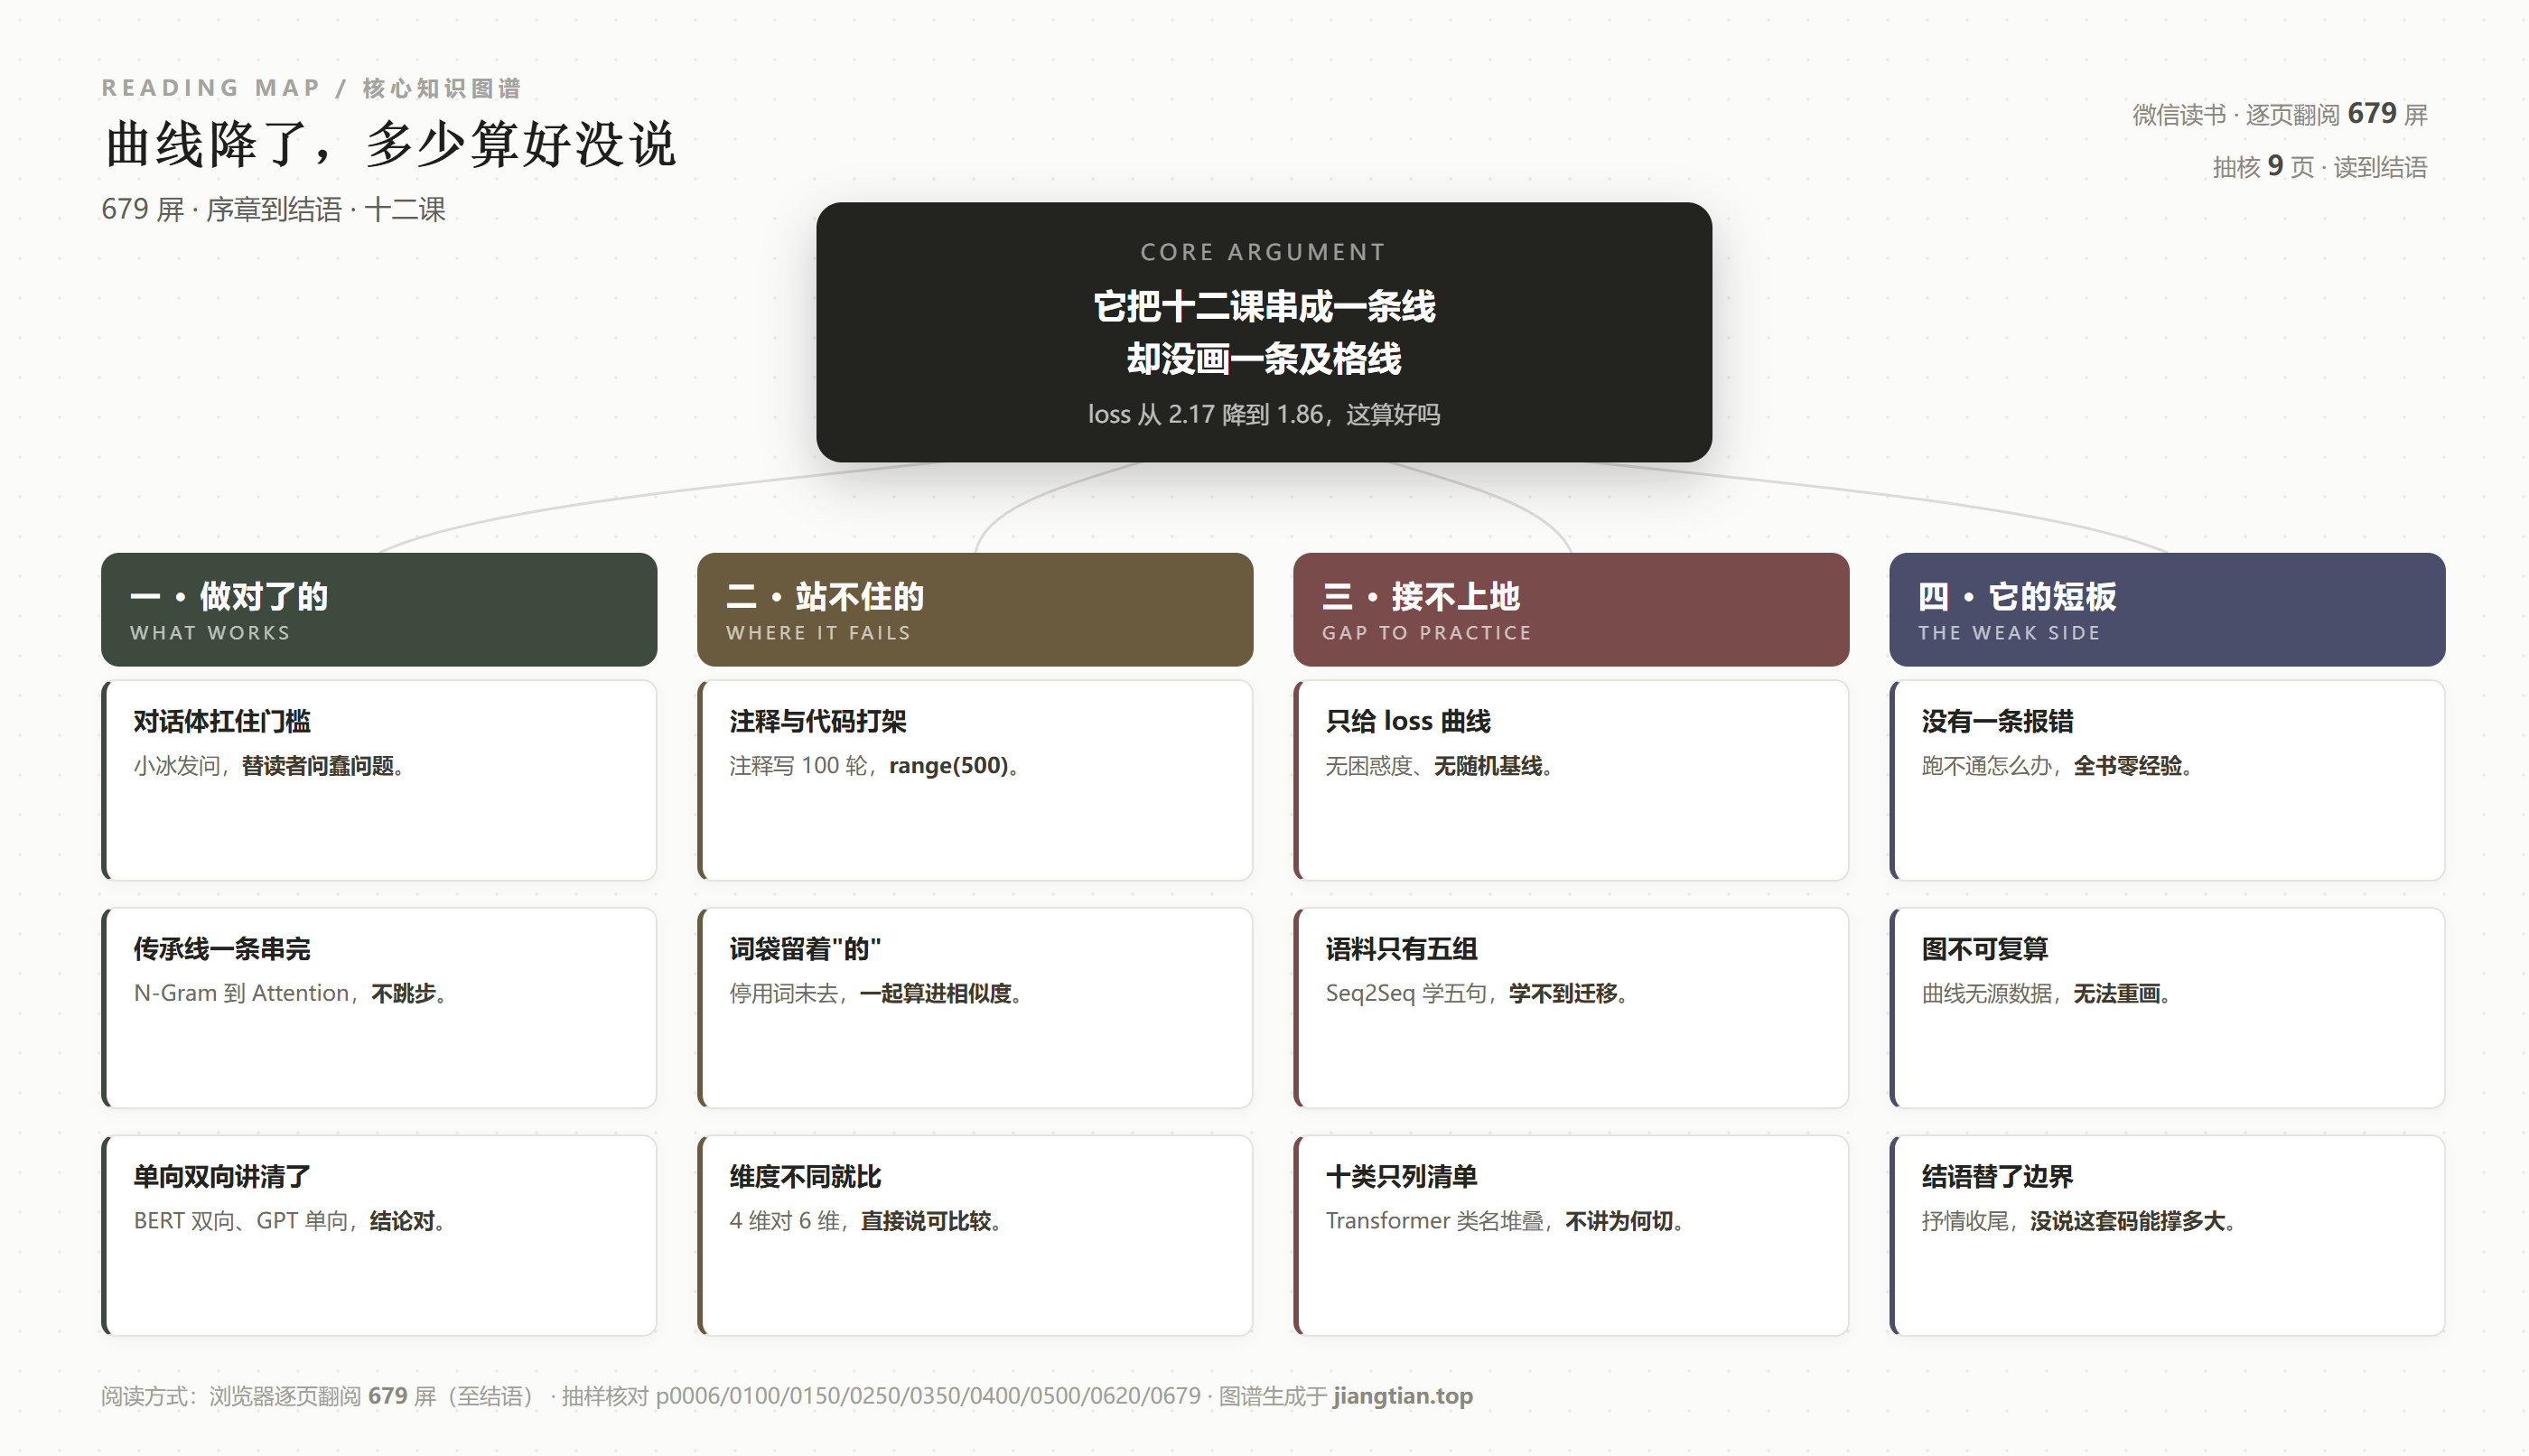
最后一句话:这本书把「大模型怎么搭」讲明白了,代价是把「搭成什么样算好」留在了门外;而后者,才是你真正开始写第一行训练代码时会立刻撞上的那堵墙。
抽样核对:p0006 技术传承清单 / p0100 1.5 词袋向量与对话体 / p0150 训练日志与损失曲线 / p0250 Seq2Seq 五组语料 / p0350 注意力四分类 / p0400 Transformer 十类与两张掩码 / p0500 BERT 与 GPT 单双向 / p0620 微调代码(注释 100 轮 / range(500))/ p0679 结语
核对方式:每屏截图 + 顶部书名条比对(p0006 为「GPT图解 大模型是怎样构建的」,与目录名一致)· 笔记与图谱生成于 2026-11-07
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: