
可灵AI视频与AI绘画从入门到精通:它只教到「图出来了」那一步
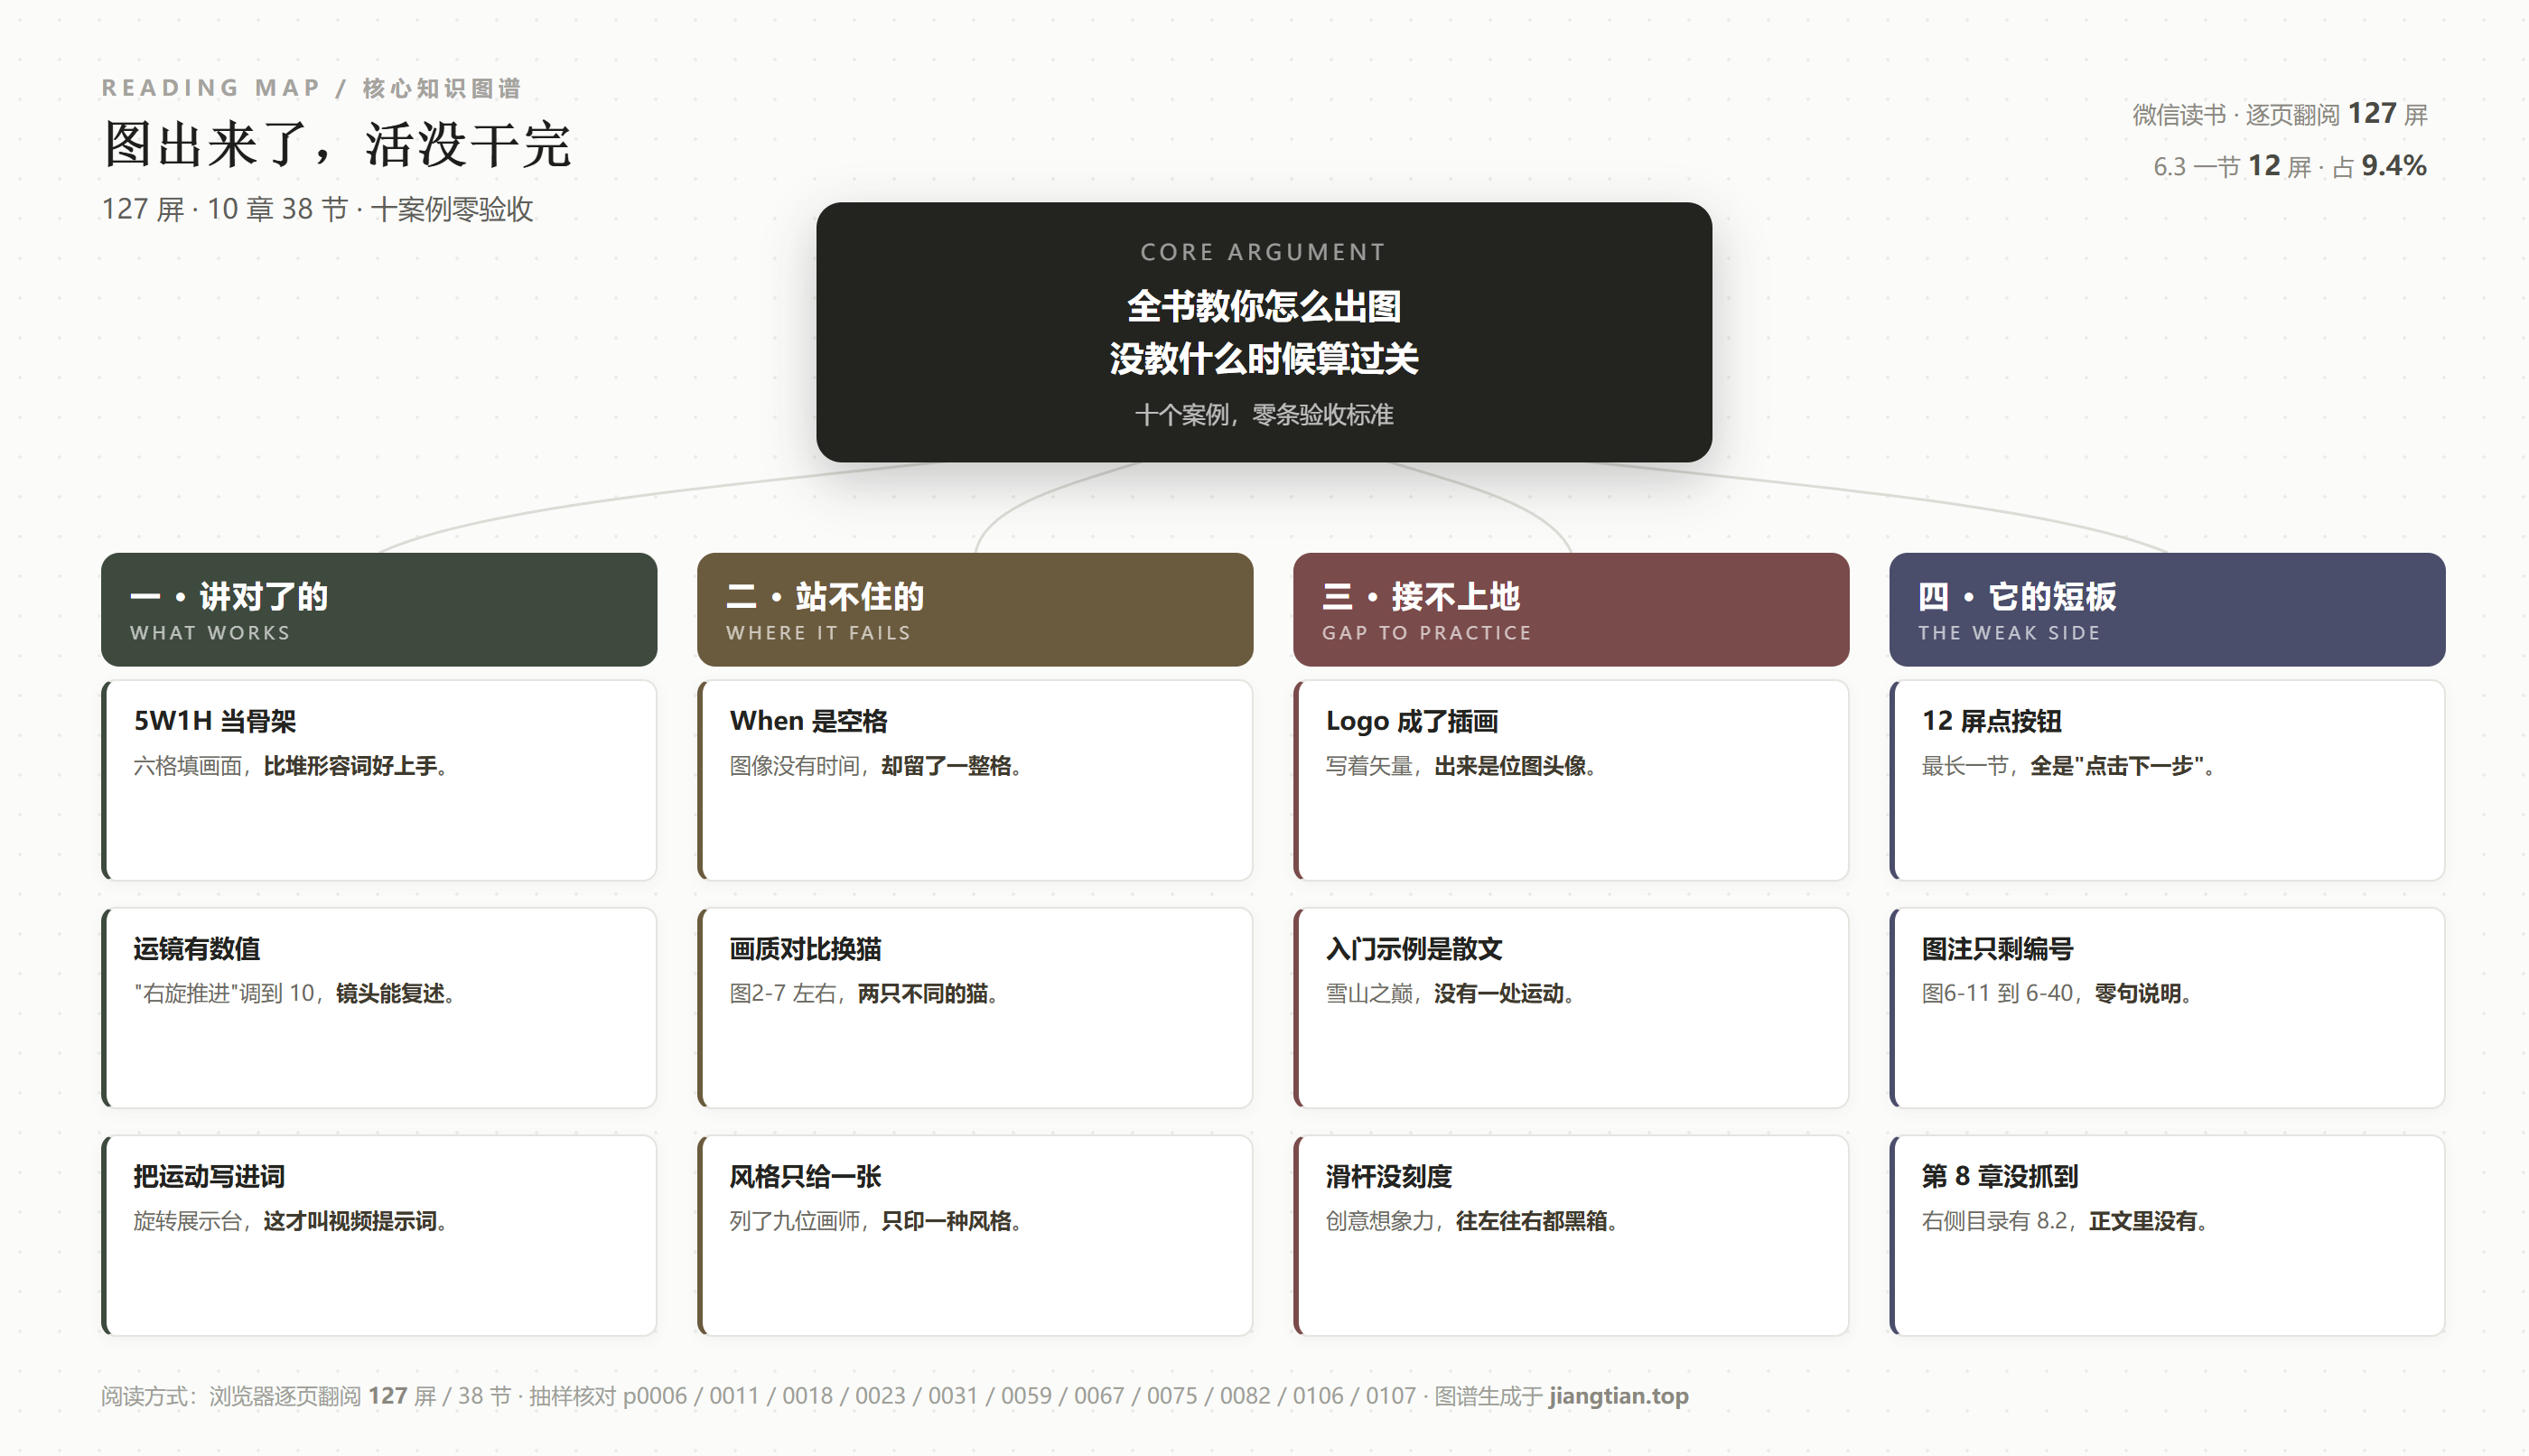
微信读书《可灵AI视频与AI绘画从入门到精通》(黄文卿 于亮 梁峰慈)· 10 章 38 节 · 127 屏
逐页翻阅 127 屏 · 从 p0001「AI绘画篇」读到 p0127「10.4 动态绘本制作」,页面显示「当前读到 88%」· 2026-11-07
说明:127 屏是微信读书的屏幕数,不折纸页。章节顺序连续,但有两处断裂我必须先讲清:一是第 8 章整章不在我读到的范围里——p0079 是「第7章 文生视频与实战案例」,p0089 直接是「第9章 可灵与其他工具联动」,中间 10 屏属于第 7 章;而 p0106 的右侧目录面板清清楚楚列着「8.2 视频延长功能」「8.3 创意视频生成实战」,所以第 8 章是存在的,是我没读到,不是书里没有。二是 p0048 出现回退:4.4 之后又标了一次「4.1 使用可灵生成不同类型的画作」,三屏内容与前文重复。书名核对:p0006 顶部书名条为「可灵AI视频与AI绘画从入门到精通」,与目录名一致。逐字核对 11 处:p0006 图1-7、p0011 图1-21、p0018 图2-7、p0023 表2-1、p0031 图3-11、p0059 图5-19、p0067 图6-11、p0075 图6-37、p0082 图7-8、p0106 目录面板、p0107 图10-8。
这本书有个挺好的开头。2.4 节它没有一上来就教「多写形容词」,而是给了一张六格表:Who、What、When、Where、Why、How,对应「谁」「长什么样」「什么时候」「在哪里」「做什么」「更多的画面细节」,然后按下表拼出一句提示词。
这是全书我唯一想给它鼓掌的地方——它把「写提示词」这件事,从玄学变成了填空题。填空的好处是可检查:写完一句,回头对六个格子,哪格空着,就知道自己漏了什么。
但也是从这张表开始,问题露出来了:六格里有一格,图像根本装不下;另一格的解释,跟格名对不上。而这两处没人管,因为这本书从第一页到最后一页,都没有一个地方回答过那个最要命的问题——图出来了,什么时候算过关?
一、账:127 屏怎么切的,最长的一节在教点按钮
先给数。127 屏、38 个章节变点,平均每节 3.3 屏。按大篇切:AI 绘画篇从 p0001 到 p0050,50 屏,占 39.4%;AI 视频篇从 p0063 到 p0127,65 屏,占 51.2%;中间 p0051 到 p0062 是第 5 章的创意应用,跨在两边。
这个比例是合理的——书名里「视频」在前,视频多给十几屏不算错。真正刺眼的是单节排序。全书最长的一节不是任何一个案例,是第 6 章第 3 节「视频制作领域的 AI 工具」:12 屏,占全书 9.4%,比整个第 10 章的四节里三节都长。
我把它从头翻到尾。6.3 的正文长这样:
「02 点击需要上传的视频素材,点击「下一步」按钮,如图6-37所示,进入选择模板界面,如图6-38所示。」
前后十几屏,句式都一样:编号、动词、图号。中间插着图6-36、图6-37、图6-38……一路排到图6-40 之后。我在这一节里没有找到一句解释「为什么选这个模板而不是那个」「模板之间的差别在哪」「哪类素材不适合套模板」。
12 屏的信息量,等于一张流程图的四分之一。这是这本书的结构性问题:它把「截图能证明我点过这个按钮」当成了「我已经讲清楚了」。而截图能证明的只是路径存在,证明不了判断。
顺便说个目录上的事,因为它是可核实的:书里第 1 章、第 2 章、第 6 章都没有章标题,直接从「1.1」「2.1」「6.1」起;目录从「7.2 创意视频生成实战」直接跳到「第9章」。我一开始以为第 8 章被删了,后来在 p0106 的右侧目录面板上看见 8.2、8.3 都在,才改判成「我没读到」。这类误判很危险——如果我只看了 meta 目录就下笔,这篇文章会凭空多出一条「本书缺章」的假证据。写书评的人得先假定自己是错的,再去图上找反证。
二、六格里有一格是空的,还有一格的解释跑偏了
回到表 2-1。这是全书的地基,值得逐格过一遍。
When / 什么时候——图像是静态的。一张图里没有「什么时候」,只有「什么样的光」。黄昏和正午的差别,不是时间在起作用,是色温、光角、影子长度在起作用。表里给 When 配的格子,实际能填的只有「清晨」「傍晚」这类词,而这类词之所以有效,是因为它们各自绑定了一套光照。也就是说,When 是 Where 和 How 的别名,它不是独立的一维。
书里紧接着给的示例,正好暴露了这一点:
「一位穿着白色大褂的科学家手持试管在未来某一天的高科技实验室进行实验,未来主义风格,高对比色调,俯视视角。」
「未来某一天」——这五个字在生成模型那里等于零。模型读不出「某一天」是哪一天,它只能读出色调、材质、光。写这句的人其实知道,所以后半句老老实实补了「高对比色调」「俯视视角」,而那才是真正起作用的部分。
Why / 做什么——这一格的名字和解释也不对。书里的原文是「Why 代指为什么会出现画面里,也是对画面主体在干什么的疑问」,例子是「阅读书籍、弹钢琴、绘画、喝咖啡」。这讲的是动作,不是动机。Why 问的是「他为什么读书」,答案会是「备考」「失眠」,而这两个答案在画面上长得完全不一样,模型也无法从「备考」推出画面。
所以这张表真实可用的只有四格:谁、长什么样、在哪里、什么细节。四格也够用了——提示词的骨架本来就是「主体 + 场景 + 风格 + 视角」四段,硬凑成六段,反而让读者以为漏填了两格。
如果我来改这一页,只做两件事:把 When 换成「光」——时段、色温、光位、硬光还是柔光,这四个是可写的;把 Why 改名成「动作」,并补一句「动作要写成能被相机拍到的一瞬」。改完还是六格,但每一格都填得进去。
三、两张猫:一次没锁变量的「对比」
2.2.1 讲画质提示词。原文说:在提示词中加「8K,杰作,精致,高对比度,摄影级真实感」,可以要求 AI 生成更高分辨率、更清晰的图像。然后是一句很有底气的话——「如图2-7所示为添加画质提示词和没添加提示词生成的图片效果对比」。
我盯着图2-7 看了很久。左图:一只正面端坐的狸花猫幼崽,大眼、竖耳、浅灰蓝背景,毛发明亮。右图:一只侧身伏卧的猫,头微侧,深灰蓝背景,蹲在一块织物上,整体偏暗。
这不是同一只猫,也不是同一个构图、同一个视角、同一种光。
如果要用这张图证明「加了画质词更清晰」,读者需要先接受一个前提:左右两图除了画质词以外全都一样。而图上摆出来的,是两只不同的猫。那么「差异」到底来自画质词,还是来自换了一张图?无法判断。
这就是对比图的第一条硬线:只允许一个变量动。做法也不难——同一个提示词、同一个随机种子(可灵有这个参数,7.1 的参数面板里就有)、只改画质词那一段,出两张,并排。如果出图有随机性,就各出四张,取中位数那张。这些工序不比现在写的多几行,但它把「我觉得更清晰」变成了「你看这两张,只差这一处」。
更值得说的是:这本书里其实有做对的地方。7.1 讲运镜的时候,作者给了具体值——「设置'运镜控制'为'大师运镜:右旋推进',并将数值调整至 10,如图7-9所示,添加运镜是更好地模拟穿越机的灵活性」。有方向、有数值、还说了为什么。同样的严谨度,为什么到对比图这儿就断了?
我的判断是工序问题,不是能力问题:图是先用着、文字是后配的。作者知道什么样的图好看(双猫并排,一明一暗,很有对比感),但没意识到「好看」和「能证明」是两件事。教学书里的插图,第一位是证据,第二位才是美观。 如果要重做这张图,五步就够。第一步,把提示词拆成两段:一段描述猫(品种、姿态、背景),一段是画质词。第二步,前一段固定不动,后一段留空,先出四张,挑一张构图最好的,记下它的种子。第三步,把这个种子填回去,前半段不变,后半段加上画质词,再出四张。第四步,两张并排,用同样的显示尺寸(不要一张大一张小)。第五步,图注写清「同一提示词、同一种子,右图仅追加画质词」——这一句图注,比整段正文都有用。 这五步没有任何技术门槛,全部在可灵的界面上就能完成,也不会多花多少时间。真正要花的,是「意识到需要这么做」的那一下。
四、九个画师名字,只印了一种风格
3.2 节「可灵生成风格化图像」是全书信息密度最高的一屏。它列了九位日本漫画家、动画家,每位配一部代表作:新海诚《你的名字》、手冢治虫《铁臂阿童木》、宫崎骏《千与千寻》、尾田树《海贼王》、平井久司《高达》、武内直子《美少女战士》、井上雄彦《灌篮高手》、鸟山明《龙珠》、三浦美纪《樱桃小丸子》。
然后正文写:「下面展示分别在提示词中加入不同艺术家名称生成日系插画的效果,由此可以看出风格差异明显。」
往下翻,图3-11 只有两张。两张都是红裙短发小女孩、绿树浓荫、日式街道、柔和逆光——同一套《樱桃小丸子》的配色和笔触。正文说「不同艺术家」,图上只有一个艺术家。第三种、第四种、第五种到第九种,全都没有图。
一句「差异明显」,靠两张同风格的图来支撑。这是前面那张猫图的同一种病:承诺的对照规模,和实际给出的样本量,差了一个数量级。九位画师里去掉一位当示例,还剩八组对照可以做,八组图也就一页半。
这一节还有两个更该说、书里一个字没提的问题。
第一,把在世的创作者名字当风格参数用,是有代价的。风格模仿在多数法域里不直接等于侵权(风格本身通常不受著作权保护),但「以某位画师的名义/风格」用于商业产出,会踩到姓名权、商品化权、以及平台自己的使用条款。这本书的读者是电商、自媒体、设计从业者——正是最需要知道这条边界的人。书里给了九个名字,零句提醒。
第二,一个名字印错了。书上写「尾田树,代表作品《海贼王》」,通行译名是尾田荣一郎。这种错在教人「用名字当关键词」的章节里格外要命——读者照着敲,敲的是一个不存在的人名,模型不会报错,只会给他一张跟《海贼王》无关的图,而他不会知道为什么。
这一节最该给的不是名单,是名单的用法:风格词适合当前期探索的起点,不适合当交付标准;要稳定,得走「参考图 + 垫图」,把风格钉在一张图上,而不是钉在一个名字上。这一段,书里没有。
五、它讲对的地方:视频提示词里必须有「动」
前面批了三节,这里必须给它记一功,否则这篇文章就成通稿了。
7.1 有一屏是全书最实用的一屏。参数面板上一共五项:创意想象力(一根没有刻度的滑杆)、生成模式(标准/高品质)、生成时长(5s/10s)、视频比例(16:9、9:16、1:1)、生成数量(1 条)。五个参数里,四个是离散可说的,只有「创意想象力」是滑杆。
而对这根滑杆,书里确实没给刻度,这是一处短板(后面再算)。但它在同一节里做对了另一件事:把「运镜」当成一个必填项来讲。
「03 设置'运镜控制'为'大师运镜:右旋推进',并将数值调整至 10,如图7-9所示,添加运镜是更好地模拟穿越机的灵活性。」
这句话里藏着视频和图像最本质的区别:图只要「是什么」,视频还要「怎么动」。而「右旋推进」+「数值 10」是一个可复述的指令——别人听到这四个字加一个数,能复现同一个镜头运动。这跟前面「8K、杰作、精致」那种形容词完全不是一个层级。
第 10 章 10.1.1 的运动鞋动图,把这件事做得更彻底。提示词是:
「一个可以旋转的展示台……全方位展示运动鞋的细节,明亮的环境,简洁……」
「可以旋转的展示台」——这七个字是全书我读到的最专业的一句提示词。因为它把「动」写成了画面里一个具体的东西(展示台在转),而不是一个抽象的要求(要动起来)。模型能画出转台,画不出「要动起来」。
这两处说明:作者不是不懂视频,他在案例里是懂的。问题在于懂的地方没有前移。入门那一屏(1.4.2 文生视频)给的示例是「雪山之巅,银装素裹,云雾缭绕,仿佛仙境一般」——四个形容词,零个动作,零个镜头。一个读者如果只读了入门就上手,他写出来的每一句都会长这样,然后疑惑「为什么我的视频像一张会呼吸的照片」。
入门示例教的东西,读者会一直用。把 10.1.1 那句「可以旋转的展示台」提到 1.4.2 当第一个例子,这本书的教学顺序会好一大截。
顺手把视频提示词该有的三段列在这里,算是我替这一节补的一张卡:一段写画面(谁、在哪、什么光、什么风格,这部分和生图一样);一段写运动(什么东西在动、往哪个方向动、动多快,比如「展示台匀速旋转」「水花向下溅落」);一段写镜头(推、拉、摇、移,或者直接在运镜面板里选,配一个数值)。三段各一句,比一段长长的散文好复现,也好改——出问题的时候,能立刻知道是哪一段没写对。这三段,1.4.2 一屏就能讲完,成本几乎是零。
六、从「图」到「货」:Logo 案例暴露的验收缺口
5.1 讲可灵在设计领域的应用,第一个案例是女装店铺的 Logo。提示词原文:
「Logo设计,女装店铺,扁平化,白色背景,简洁风,矢量,2D,」
31 个字符,界面右下角显示「31/500」。这句提示词本身没毛病,该有的都有。问题在结果。
图5-20 给了三张产出:三个圆形徽章式的图案,中间是女性头部侧影,红黑两色线条,一个戴宽檐帽、一个短发、一个卷发,都带点插画感。往下正文写:「04 执行操作后,单击'立即生成'按钮,即可生成相应的 LOGO 图片,如图5-20所示。」
然后这一节就结束了。
可 Logo 是有硬性交付标准的,三条,任何一家品牌方都会问:一,能不能无损放大到广告牌?二,去掉颜色、只剩单色,还认不认得出?三,缩到 16 像素的网站图标,还能不能分辨?这三条与「好不好看」无关,是「能不能用」的问题。而图5-20 的三张,是位图,是彩色,是细线条的女性侧影——缩到 16px,会糊成一个红点。
「矢量」两个字写进了提示词,但扩散模型不会因为你写了「矢量」就输出 SVG。把设计规格当成咒语,是这一节最大的误解。正确的工序是:模型出的是概念稿,概念稿要进 Illustrator 描一遍、简化成几何、去掉渐变,才叫 Logo。
同一屏还有个细节,能佐证这本书对「平台界面」的观察不够细:提示词输入框下面有一行灰色推荐词,「推荐尝试:霓虹城市 山峰 海水 小鹿 港风美女」。这是可灵给通用生图准备的兜底模板,和「女装店铺 Logo」一点关系没有。书里把它一起截进去了,但一个字没提。读者照着点一下「霓虹城市」,会得到一张和 Logo 无关的图,然后以为自己哪步错了。
这类「截图里有、正文没接住」的地方,是判断一本实操书认不认真的最快办法:作者看得比读者多,但写得比看得少。 如果让我改这一节,只加三张图、三百字。第一张,把三张产出缩到 64 像素,并排放在一张图里,标题写「缩到网站图标大小,还认得出吗」——一眼就能看出问题。第二张,把其中一个图案转成黑白,看它是否还成立。第三张,给一个「可交付版本」的对照:同一立意经人工描摹简化之后的标志,说明从概念稿到成品之间还差几步。三张图都不需要新工具,Illustrator 里十分钟能做完。加上这三张,这一节就从「我出图了」变成了「我知道什么能交、什么不能」。
七、十个案例,零条验收标准
我把这本书的案例数了一遍:4.1 到 4.4(四类画作)、5.1 到 5.3(设计、摄影、电商广告)、7.2 创意视频、10.1 到 10.4(电商动图、自媒体、MV、绘本),十一个案例段落,零条验收标准。
每一个案例的结构都一致:给提示词 → 给参数 → 给成品图 → 结束。没有一个案例回答「这张图哪里不行」「如果出得不对,改哪个词」「出到第几张可以停」。
举一个最典型的:10.1 电商网页动图的第二步,图10-8 是一个区域控制面板,上面的信息密度是全书画面的顶点——「区域1 轨迹2 删除2」「区域2 轨迹2 删除2」一直到「区域6」,下面还有「添加静止区域」,输入框里写着「静止区域」。这是一个能做局部动效、能锁住瓶子不动只让水花动的面板,专业度很高。
而正文对这一屏的全部说明是:「05 执行操作后,单击'立即生成'按钮,即可自动生成相应的视频,如图10-9所示。」
六个区域、每个两条轨迹、加静止区域——这一屏是全书唯一需要「设计」的地方,被一句话带过了。哪些东西该锁、哪些该动、轨迹怎么画才不穿模,一个字没有。读者会照着点,但不会知道自己在做什么。
这就是「能出图」和「能交付」之间那道坎。前者靠试,后者靠判据。这本书把全部的篇幅给了前者。
如果让我给它补一节,只要一页,四条判据:一,主体有没有变形(手、字、logo 边缘);二,画面里有没有多余元素(多出来的手指、断掉的路灯);三,动效有没有穿模(物体互相穿过);四,成品尺寸和平台规格对不对(16:9 还是 9:16,几秒)。四条,每次出图后过一遍,不合格就改提示词的对应那一格。这一页能救回前面十个案例的一半价值。
八、它的短板
按老规矩,把这本书的问题老实列出来,不挑软的。
第一,第 8 章我没读到。p0079 是第 7 章首页,p0089 是第 9 章首页,中间十屏全在第 7 章。而 p0106 的目录面板列着「8.2 视频延长功能」「8.3 创意视频生成实战」——第 8 章存在,是我漏了。所以我不能评价第 8 章,也不能说书里缺章。这一条是自我声明,不是批评。
第二,p0048 有回退。4.4 讲完 CG 插画,目录标记又跳回「4.1 使用可灵生成不同类型的画作」,后面三屏的内容与前面 4.1 高度重复。可能是翻页时阅读器回滚,也可能是抓取时的重拍。不管是哪种,我的「38 节」这个数里,至少有 3 屏是重复的,实际独立内容约 124 屏。
第三,图注只剩编号。我抽了十二处:图1-7、图1-21、图2-7、图2-18、图3-11、图5-19、图5-20、图6-11、图6-12、图6-37、图7-8、图10-8。十二处里,没有一处图注带说明文字,全部是「图X-X」四个字。图注的功能是回答「这张图在证明什么」,编号回答的是「这张图排第几」。一本有 40 多张插图的书,等于雇了四十个演员上台,一个都不给台词。
第四,「创意想象力」这根滑杆没有刻度。7.1 的参数面板上,其余四项都是离散选项,只有它是滑杆,而且没有数值、没有取值范围、没有「往哪边调会怎样」。这一项恰好是影响成片风格最大的一个。可它连一句「偏左更贴提示词、偏右更自由」都没有。
第五,篇幅分配与难度不匹配。6.3「视频制作领域的 AI 工具」12 屏(9.4%),全是点击流水;10.2「自媒体视频制作」只有 4 屏;而 10.1 电商动图里最关键的区域控制面板,1 屏带过。多给 6.3 一屏,就要从一个真正需要解释的案例那里拿走一屏。篇幅是价值观,比前言里的目录更可靠。
第六,它默认你在付费区。p0018 顶部有一条提示:「你正在使用会员卡阅读付费部分」。这不是书的问题,但意味着这本书的读者画像被平台筛过一遍——它写给「已经愿意为一个工具付费的人」,所以全书没有一处讨论免费额度、生成成本、以及「这张图值不值得再跑一次」。一本教人批量出图的书,不谈成本,是不完整的。
说完这些,也要说回它成立的地方。它的语言是干净的,没有那种「赋能」「抓手」的行业黑话;它的案例是真的跑出来的(图里的界面元素、参数、随机种子位置都对得上);它把 5W1H 这种笨办法引进提示词教学,虽然有两格是错的,但方向对——把玄学变成清单,是入门书最该做的事。
所以这本书适合谁?适合完全没碰过 AI 绘画、想在一个下午之内搞明白「输入框在哪、参数有哪些、出图长什么样」的人。它会让你在半小时内出第一张图、第一段五秒视频。但它不会告诉你什么时候该停——而这个判断,恰恰是「入门」和「精通」之间唯一的那道门。
书名里有「从入门到精通」。我读完 127 屏的判断是:入门这部分做到了,精通这部分,它把「会用」当成了「精通」。这两件事中间隔着的,不是更多的案例,是验收标准。
抽样核对:p0006 图1-7 / p0011 图1-21 / p0018 图2-7 / p0023 表2-1 / p0031 图3-11 / p0059 图5-19 / p0067 图6-11 / p0075 图6-37 / p0082 图7-8 / p0106 目录面板 / p0107 图10-8
核对方式:每屏截图 + 顶部书名条比对(p0006 为「可灵AI视频与AI绘画从入门到精通」)· 笔记与图谱生成于 2026-11-07
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: