
AI绘画大师:Stable Diffusion快速入门与实战技巧:种子讲了五屏,对比图一张也没锁
微信读书《AI绘画大师:Stable Diffusion快速入门与实战技巧》· 3 章 37 节 · 95 屏
逐页翻阅 95 屏 · 从 p0001「版权信息」读到 p0095(该屏显示「加载失败,请点击重试」)· 2026-11-07
说明:95 是微信读书的屏幕数,不折纸页,章节顺序连续,没有跳页。但最后一屏没有读到——p0095 是加载失败的空页,它属于 3.7「差异随机种子」,那一节因此只剩一个标题。全书正文到我实际读到的范围是 p0001–p0094,止于第 3 章。前言承诺的「图生图、脚本、ControlNet 插件」在我读到的 95 屏里一次也没有出现,我不据此判断书里没有,只标注「我没读到」。书名核对:p0006 顶部书名条为「AI绘画大师:Stable Diffusion快速入门与实战技巧」,与目录名一致。逐字核对 13 处:p0006 前言、p0012 本地部署、p0024 扩散模型、p0031 Embedding 启动器、p0036 Hypernetwork、p0040 LoRA 对比、p0057 饮食词表、p0065 权重语法、p0069 渐变语法、p0075 采样方法、p0080 面部修复设置、p0081 图3-16、p0083 图3-18、p0084 图3-19、p0092 种子参数行、p0095 加载失败。
这本书有一个很特别的品质:它知道自己该给什么。
p0092 那一屏,作者的截图里带着 Stable Diffusion 的参数行,十二个字段一个不少:步数、采样器、CFG、种子、尺寸、模型哈希、模型名、重绘幅度、Clip skip、ENSD、放大倍数、放大算法,连耗时 26.02 秒都在。这是可复现的最小集,任何一个跑过图的人都知道,抄下这一行,别人就能在你机器上复现同一张图。
而同一本书里,讲面部修复对比的那三屏,一句参数都没有。
这篇想说的就是这个落差:它懂得什么是可复现,却没有在自己的对比实验里做到可复现。这不是知识问题,是工序问题——图是先出好的,文字是后配的;图是挑好看的,不是挑能对照的。
一、账:95 屏里,12 屏在教装软件
按章分:第 1 章「认识 Stable Diffusion」20 屏,第 2 章「基础模型及原理」26 屏,第 3 章「文生图」49 屏。
第 1 章再往里切:1.1 主流 AI 绘画工具 2 屏,1.2 SD 的独特优势 1 屏,1.2.2 本地部署 2 屏,1.3 安装 1 屏,1.3.1 本地安装 2 屏,1.3.2 云端安装 4 屏。加起来 12 屏,占全书 12.6%,全部在讲「怎么把软件装起来」。
12 屏装软件不算多,很多 SD 书要花三十屏。但把它和另外两个数字并排放,意思就变了:三组「效果对比」小节合起来 5 屏(面部修复 3 屏、高清修复 2 屏),占 5.3%。装软件是看效果的 2.4 倍。
这不太合理。软件装不上,读者会去搜教程、问客服、换整合包,一天之内必解决;而「开了面部修复到底有没有用」这个问题,搜不到答案,只能靠书。书把篇幅给了前者。
另一笔账更值得说。前言里列了这本书的覆盖范围:「文生图、图生图、图片高清放大、提示词、脚本、ControlNet 插件」,还点了四个行业(游戏、电商、插画、建筑)。我读到的 95 屏里,出现的是文生图、提示词、高清放大。图生图、脚本、ControlNet,一次都没有。
这里必须说清边界:我只读到第 3 章末,95 屏,最后一屏还加载失败。所以正确的表述是「我读到的部分没有」,而不是「书里没有」。但这本身也是一个信息——一本标着「从快速入门到实战技巧」的书,前 95 屏(将近一半篇幅)里,「实战」的部分是零。
二、它讲对的那一屏:为什么是加噪,不是删像素
第 2 章有一节,我认为是全书最好的一节,好在它回答了一个「为什么」,而不是「是什么」。
「扩散模型主要用于生成图片。它在图片压缩降维后的潜在空间进行操作,输入和输出均为潜在空间中的图像特征,而不是原始图片的像素。」
这句话有两个关键点,都准确:一是「潜在空间」,二是「输入输出是特征不是像素」。很多入门书讲到这里就滑过去了,读者以为模型在 512×512 的像素格子上直接涂色,于是怎么也想不通「为什么 8GB 显存能跑」。讲清「它在压缩后的空间里操作」,这个问题自然就通了。
更难得的是图2-1 后面那段解释:
「为什么要使用逐步添加和去除噪声的方式来生成图片呢?这是因为直接删除像素会导致信息丢失,而逐步添加噪声则可以让模型更好地学习图片特征,同时随机噪声的引入还可以增加生成结果的多样性。并且,逐步进行的节奏有利于控制生成过程,并提高去噪过程的稳定性。」
这段话回答了一个我见过的、几乎所有人都问过的问题:既然是「去噪」,为什么不直接糊掉、再让它补?答案是「直接删像素会丢信息,加噪不会」——因为加噪是可逆的,每一步都能算回去;删像素是不可逆的,丢了就没了。
这就是「机制解释」和「名词解释」的差别。前者让你能推出结论(比如「所以步数太少会崩,因为每一步去掉的噪声有限」),后者只让你记住一个词。
可惜,这一节在目录里查不到。这就是下一节要说的。
三、目录里没有 2.1.2,正文里有一整节
翻目录,2.1 下面是这样的:2.1 三大生成模型 → 2.1.1 CLIP 模型 → 2.1.3 VAE 模型。2.1.1 之后直接跳到 2.1.3。缺 2.1.2。
翻正文,p0024 的标题清清楚楚印着「2.1.2 扩散模型」,底下是完整的两段正文加一张图2-1。
内容在,索引不在。这不是「书里少了一节」,是「目录漏了一节」——而漏掉的这一节,恰好是第 2 章唯一讲生成机制的地方。CLIP 讲的是文本怎么变成向量,VAE 讲的是潜空间怎么还原成图,中间那个「怎么从噪声走到图」的过程,就是 2.1.2。
同样的问题还有一处,而且更隐蔽。p0003 上方有一张四格图,图注写「图1.2-1」。可目录里,1.1「什么是AI绘画」之后直接就是 1.3「Midjourney 简介」,1.2 根本不存在。
图号是排版时按小节自动编的。「图1.2-1」这个编号能印出来,说明排版文件里确实有过 1.2 这一节。它可能是被删了而图留下了,可能是被合并进 1.3 但编号没改,也可能只是目录页生成时漏抓。三种可能,对读者的结果是一样的:按目录找,找不到。
这种「索引失效」在工具书里是要命的。因为工具书不是拿来通读的,是拿来查的——读者遇到问题,翻目录,找关键词。而这本书的两个关键节点(扩散模型、1.2 那一节)都在目录里消失,读者只会得出一个结论:这本书没讲。
打个比方:图书馆把最有用的一本书放进了闭架,还在检索系统里删掉了条目。书还在,但你找不到它,于是它等于不存在。
四、五类模型:分工讲清了,用法停在「放哪里」
2.2 那节是这本书结构最清楚的地方。它把 SD 生态里的模型分成五类,一节一类,屏数也分得明白:Checkpoint 2 屏、Embedding 4 屏、Hypernetwork 4 屏、LoRA 5 屏、VAE 4 屏。
五类的区别,是新手最容易糊的地方——「大模型」「LoRA」「Embedding」这些词混着出现,谁改画风、谁改人物、谁管色彩,全靠猜。这本书的做法是把三件事分开讲:它改什么、文件放哪个目录、用的时候怎么调出来。
Embedding 那节(p0031)给了两张截图:一张是启动器的「模型管理」页,里面能看到 EasyNegative 这个文件——28.06 MB,创建时间 2023-06-01 23:29:05,作者 Toybox;另一张是 Civitai 的筛选界面,模型类型里勾着「Textual Inversion」。这两张图是有信息量的:前者告诉你文件长什么样、多大、放哪;后者告诉你这类模型在社区里叫什么名字(Textual Inversion 就是 Embedding 的正式名)。新手最常犯的错就是「下载了 LoRA,放到 Embedding 目录」,这两张图能救他。
Hypernetwork 那节有一句我很喜欢的话:
「Hypernetwork模型可以对Stable Diffusion生成的图片进行有针对性的调整,相当于粗糙版的LoRA。Hypernetwork模型的应用领域较窄,主要用来训练画风,实现画面风格的转换。反过来说,应用领域垂直是它的优势,也是它被使用至今的原因。」
「相当于粗糙版的 LoRA」,六个字把定位说清了:同一个生态位,精度更低,所以先学 LoRA。而且它没有吹——直接承认「应用领域较窄」。一本工具书肯写「我这个东西用处不大」,可信度反而上去了。
问题是每节的实操都长一个样。Hypernetwork 那节:迭代步数 30、采样方法 Euler a、放大算法 R-ESRGAN 4x+、尺寸 512×768、其他设置选项保持默认。LoRA 那节:放大算法 R-ESRGAN 4x+、尺寸 512×512、其他设置选项保持默认。Checkpoint 那节、VAE 那节,也是同一个句式。
「其他默认」这四个字,是复现的断点。因为「默认」里装着模型的 checkpoint、采样器、CFG、种子——恰好是最影响结果的四项。一本教人「怎么调参数」的书,把四个最关键的参数归进了「默认」。
这不是苛求。同一本书的 p0092 已经证明作者知道该写什么——那里十二个字段一个不漏。所以问题不在于他不知道,而在于他在讲原理的节里偷了懒,在讲种子的节里才认真。
五、三组对比,一组也没锁种子
这是全书最该被追问的地方。
第一组,面部修复。正文写得很像要做实验:「当我们想要生成一个人物相关的图片时,是否选择面部修复的选项,其效果是否一样呢?我们可以对此进行测试。例如,我们要生成一张女性人物的图像,面部修复前后的效果如图3-16、图3-17所示。」
用了「测试」这个词,说明作者知道这是实验。但翻开图3-16 和图3-17:图3-16 里的人穿白衬衫、长裙、背双肩包,图3-17 里的人穿黑皮衣、短裙。两个不同的人,两套装束,两种光线。
这就是问题所在。「前后」变成了「两张」,读者看到的差异,可能来自面部修复,也可能来自换了提示词、换了种子、换了衣服。三个变量同时变,一个结论也得不出来。
第二组,高清修复。这组好一些,图3-18 和图3-19 是同一个人(黑皮衣,公园)。但姿势变了:3-18 是站直、双手垂下,3-19 是手插口袋。构图裁切也不同。
而正文是这样写的:
「在图3-18中,很明显,图像中女人脸部的细节处理得比较粗糙,五官都有些变形。而在图3-19中,高清修复时采用的是R-ESRGAN 4x+放大算法,使人物面部刻画得更加立体饱满,细节处理也更加自然。」
「很明显」「五官都有些变形」——作者请读者去看脸。可图3-18 是一张全身远景:人站在公园小路上,从头顶到鞋底都在画面里,脸大概占整张图宽度的十五分之一。在微信读书的一屏上,那张脸不到四十个像素宽。
四十像素能看出什么?能看出「有个脸」,看不出「五官变形」。作者要求读者验证一个在给定图上无法验证的结论。这不是作者眼花,是他看的是原图(几千像素),读者看的是印刷图(几百像素)——他忘了介质换了。
顺带一句,这组对比里唯一给出的参数是「R-ESRGAN 4x+ 放大算法」。而高清修复的效果,恰恰还取决于重绘幅度(denoising strength)——0.3 和 0.7 是两个完全不同的结果。这个数没给。
第三组,LoRA。p0040 写:「使用LoRA前后的图像分别如图2-18、图2-19所示,我们看到这是两种截然不同的风格。使用LoRA后的图像成功复刻出了赛博国风的人物特点。」
我翻到那一屏,只看到一张图(图2-19)。「前后」的两张,读者只拿到一张。而「两种截然不同的风格」这个判断,需要两张并排才成立。
三组对比,三种失法:一组换了人,一组换了构图,一组少了一张。合起来是一件事——这些图是当插图挑的,不是当证据做的。
最刺人的地方在于:这本书的第 3.6 节,花了 5 屏讲随机种子。它写得挺清楚:「当随机种子为-1时,则表示未使用种子,后续出图都是随机状态」「绿色的循环三角图标……作用就是重用上一次的随机种子数」「当保持种子数不变时,不管改动提示词,还是调整其他参数,其出图效果都会参考固定种子」。
它知道种子能锁住画面。它只是没在自己的对比图里锁。
六、它知道该抄什么:那一行十二个字段
把 p0092 的参数行抄下来,是这样一串:
Steps: 40, Sampler: DPM++ 2M Karras, CFG scale: 7, Seed: 1382075347, Size: 512x512, Model hash: 7f96a1a9ca, Model: anything-v5 PrtRE, Denoising strength: 0.7, Clip skip: 2, ENSD: 31337, Hires upscale: 2, Hires upscaler: R-ESRGAN 4x+ Anime6b, Time taken: 26.02s
十三项,去掉耗时是十二项。这十二项就是「可复现的最小集」:有模型(名字 + 哈希,哈希防同名不同版)、有采样器(连 Karras 这种调度器后缀都带着)、有步数、有 CFG、有种子、有尺寸、有重绘幅度、有高清修复的两级参数。
这一行是整本书最值钱的东西,而它是截图自带的——不是作者整理的,是 WebUI 生成图片时自动写进 PNG 元数据的。作者把它截进了图里,当装饰用;正文一个字没提。
这就形成一个很尖锐的对照:
讲种子的那一屏,参数行十二项全在图上(虽然没抄进正文);讲 LoRA、讲面部修复、讲高清修复的那几屏,参数只写「放大算法、尺寸、其他默认」。
同一个作者,同一台机器,两套标准。差别不在能力,在他有没有意识到「这一屏的图是要被读者拿来复现的」。
如果要改,这一改能省下很多篇幅:把参数行直接印在每组对比图下面,一行小字,灰度 60%,读者要复现就抄,不要就跳过。十二项一印,全书至少二十屏的解释性文字可以删掉——因为那些文字在做的事,本来就是「用形容词描述参数差异」。
顺带说一个细节,值得所有写 SD 书的人抄走:参数行里同时有「Model: anything-v5 PrtRE」和「Model hash: 7f96a1a9ca」。名字是给人看的,哈希是给机器认的。同一个名字的 checkpoint,社区里可能有三个人分别训过,画风差得很远;有哈希,才能确认「你用的和我用的是不是一个文件」。这本书的截图里恰好两样都有,正文却一个都没提——它把最严谨的那部分留在了图里。
七、提示词那 11 屏:从单词到句子,中间那步没讲
3.1 这一节共 23 屏,是第 3 章最长的部分:3.1.1 功能 1 屏、3.1.2 常用提示词 8 屏、3.1.3 语法 11 屏。
3.1.2 那 8 屏,我原以为是范文,翻开是词表。全是中英对照的两列表格,比如表3-7「描述传统饮食的提示词」:
A stick of sugar-coated haws — 冰糖葫芦 Beijing Roast Duck — 北京烤鸭
Box lunch — 盒饭 Eight-treasure rice pudding — 八宝饭
Glass noodles — 粉丝 Guotie — 锅贴 Hot pot — 火锅
Jellied bean curd — 豆腐脑 Konjak tofu — 魔芋豆腐
Lotus Root — 莲藕 Rice noodles — 米粉 Rice tofu — 米豆腐 Set meal — 套餐
前一张表是「材质」:bone 骨头、filigree metal design 精密图案的金属、Plastic 塑料、wax 蜡、ice 冰、dry ice 干冰、pattern 花纹、relief 浮雕、Rose quartz 玫瑰石英、Ruby 红宝石。
这张表里混着三个不属于材质的词:mist(薄雾)、vapor(水汽)、perfect lighting(极好的灯光)。前两个是天气/氛围,第三个是光照。它们被塞进「材质」类,说明这些表不是按一个分类体系整理出来的,是从素材库里按关键词抓的。
词表本身有用——至少告诉你「冰糖葫芦」的英文是 a stick of sugar-coated haws,这个真的查不到。但它解决的是「词」的问题,不是「句子」的问题。
而写提示词真正难的是造句:十来个词,按什么顺序排?哪些必须在前,哪些可以省?主体、外观、动作、环境、光照、风格、参数,这七段怎么衔接?把这十三个食物词丢给模型,它会给你一张杂烩图;写成「夜市街景,前景是冰糖葫芦摊,中景有三五个人围坐吃火锅,暖黄灯光,浅景深,胶片颗粒」,才是一张图。
这个「七段式」不是我的发明,是跑图的人普遍在用的顺序:主体(谁)→ 外观(长什么样)→ 动作(在干什么)→ 环境(在哪)→ 光照(什么光)→ 风格(什么媒介)→ 参数(比例、步数)。越靠前的词权重越高——这不是玄学,是 CLIP 的分词顺序决定的:排在前面的 token 参与的条件更强。这句话如果写进 3.1,那 8 屏词表才算接上了地。
用这本书里的词表演示一遍,成本很低:拿「冰糖葫芦」+「火锅」+「北京烤鸭」三个词,写成「a night market street, a sugar-coated haws stall in the foreground, three people sitting around a hot pot in the middle ground, roast duck hanging under warm yellow light, shallow depth of field, film grain」,再配一张用这句生成的图。一张图一句词,就把「词表」和「造句」之间那道沟填上了。可惜书里 8 屏词表之后,直接跳到了语法符号。
3.1.3 讲语法,11 屏,讲了三样:权重、交替、渐变。
权重那段我觉得表述有坑:「给提示词加上圆括号,并在提示词后面加冒号和权重数值,这表示提示词的权重增强了对应数值的倍数……例如,(1girl:3)即表示『1girl』这一提示词的权重数值增大了3倍。」
「设为 3 倍」和「增大了 3 倍」是两个数。前者是 ×3,后者是 ×4(1 + 3)。在参数书里,这种含糊会直接导致读者调不出效果,然后怀疑自己。同一段的下一句又说「直接给提示词加上圆括号则表示提示词的权重数值增大1.1倍数」——这次用的是「增大 1.1 倍」,实际是 ×1.1,也就是增加 0.1 倍。两句用了同一个词(增大 N 倍)表达两种运算(×N 和 ×(1+N)),读者没法自洽。
渐变语法那段反而写得好:「该语法的书写格式为[Tag1:Tag2:数字]……当数字 n 大于 1 时,可以理解为第 n 步前 Tag1 生效,第 n 步后 Tag2 生效;当数字 n 小于 1 时,可以理解为总步数的第 n% 步前受 Tag1 影响,之后受 Tag2 影响。」例子是「a girl,long hair[white:yellow:16]」。
这段是全书少见的「规则 + 两种情形 + 一个可抄的例子」三件齐全。可惜这样的密度只有两三屏。
八、它的短板
第一,所有对比都不锁变量。三组对比,一组换人、一组换构图、一组少一张。这是本书最实质的问题,因为它的卖点是「实战技巧」——而技巧的价值全在「照做能复现」。复现不了,技巧就退化成描述。
第二,参数永远「其他默认」。五个模型例子,五个「其他设置选项保持默认」。而默认里装着 checkpoint、采样器、CFG、种子。「其他默认」这四个字,是读者照做失败时唯一找不到原因的地方。
第三,分类表是拼的。材质表里塞进薄雾、水汽、灯光,说明分类不是体系,是关键词堆放。这样的表能查词,不能帮人建立「该写哪几类词」的结构感。
第四,目录丢了两节。2.1.2 扩散模型正文完整、目录没有;图注印着「图1.2-1」而目录里没有 1.2。前者让读者找不到机制解释,后者让读者找不到那一节的图。工具书的目录不是装饰,是唯一的人口。
第五,承诺的覆盖面没有兑现。前言说涵盖「文生图、图生图、图片高清放大、提示词、脚本、ControlNet 插件」,还点了游戏、电商、插画、建筑四个行业。我读到的 95 屏里,前两项有,后三项没有,四个行业的案例一个也没有出现。这里再强调一次:我只读到第 3 章末,这是我的覆盖边界,不是判决。
第六,末屏加载失败。p0095「加载失败,请点击重试」,属于 3.7「差异随机种子」——这一节只剩标题。差异种子(Variation seed)恰恰是对比实验里最有用的一个参数(同种子微调,看哪一个变量引起的差异),而我恰好没读到它。这一屏的缺失,让这本书「懂对比」这条辩护,少了最后一页证据。
第七,「调研」这个说法无法验证。前言写「作者在创作本书前在两万余人的大型社群内充分进行了市场调研和信息搜集,确保本书内容能满足初级读者从认识到上手的切实需求」。两万人是个很大的样本,但调研方法、问卷、结论都没有出现。而如果真做过调研,「新手最想先看什么」的答案,大概不会是 12 屏怎么装软件、5 屏对比实验。
如果只允许我提三条改法,我会这么改:
① 每组对比图下面印一行参数(步数 / 采样器 / CFG / 种子 / 模型 + 哈希 / 重绘幅度 / 放大算法),灰度小字即可。三组对比,三行字,把「两张不同的图」变回「一次实验」;
② 把「其他设置选项保持默认」全部删掉,换成「checkpoint = ×××、采样器 = ×××、CFG = ×××、种子 = ×××」。四个模型例子,四行参数,读者照抄就能复现;
③ 在每个词表后面加一条成品句:把这一类的五个词串成一句完整提示词,并配一张用这句生成的图。词表教「词」,成品句教「句」。
三条都是编辑层面的改动,加起来不到十页。但它们会把这本书从「参数词典」变成「实验手册」——而后者才是「从入门到实战」这五个字该有的样子。
最后说句公道话。这本书在「讲清五个模型的分工」这件事上,做得比多数同类书扎实:它把 Checkpoint、Embedding、Hypernetwork、LoRA、VAE 五个概念拆成五节,每节都回答「改什么、放哪里、怎么调出来」,还给了启动器和 Civitai 的实拍截图。一个完全没接触过 SD 的人,读完这 26 屏,至少不会再犯「把 LoRA 放进 Embedding 目录」这种错。
它对机制的解释也舍得花力气。扩散模型那一节讲「为什么是加噪不是删像素」,是真正的解释而非名词堆砌;「相当于粗糙版的 LoRA」这六个字,比一整页对比表更让人记住 Hypernetwork 的位置。
它甚至有一处很诚实的自我限制:「Hypernetwork 模型的应用领域较窄」。一本工具书肯说自己的工具有短板,读者的信任就是这么一点点攒起来的。
问题在于,这份诚实只用在了「介绍工具」上,没有用在「验证效果」上。它在讲原理时像个懂行的人,在给对比时像个赶稿的人。而读者买这本书,买的恰恰是后者。
它把种子的原理讲得明明白白,却在每一张该锁种子的图前面,松了手。
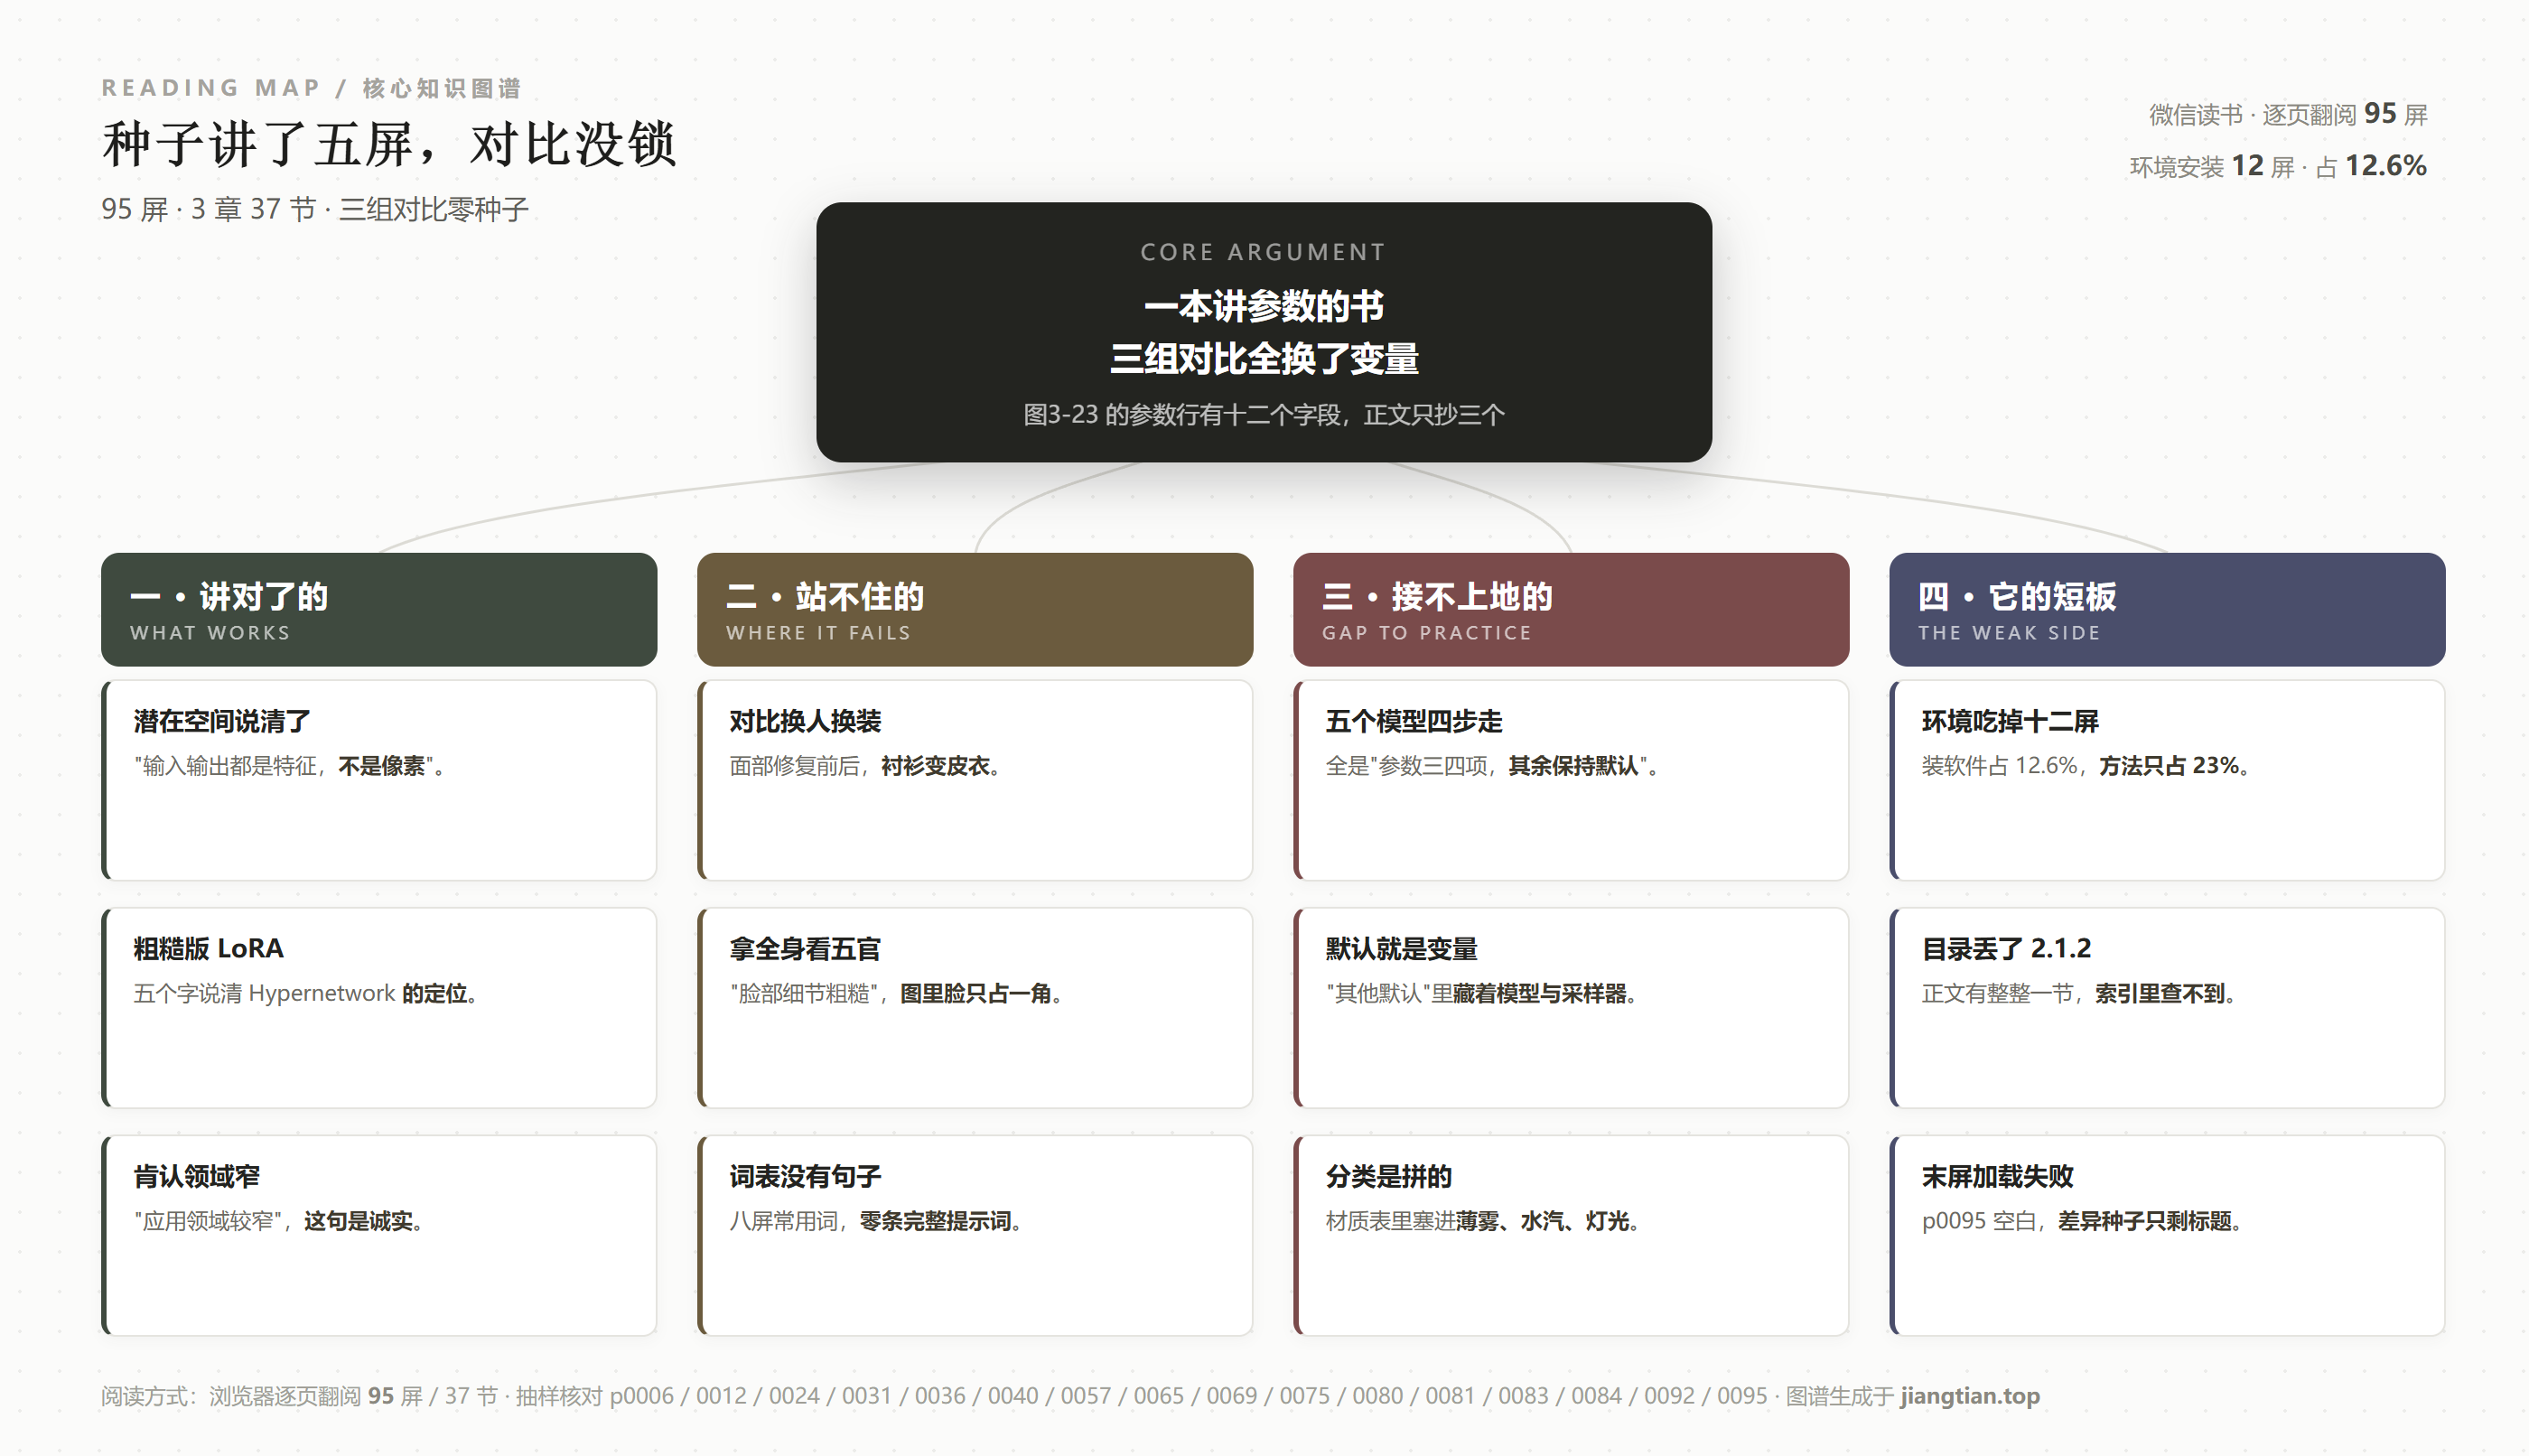
阅读记录:微信读书《AI绘画大师:Stable Diffusion快速入门与实战技巧》· 95 屏 / 3 章 37 节 · 逐页翻阅 p0001「版权信息」至 p0095(该屏「加载失败,请点击重试」,未读到内容)· 章屏数:第1章 20 屏(其中环境安装 12 屏,12.6%)、第2章 26 屏、第3章 49 屏 · 三组对比合计 5 屏(5.3%)· 目录缺 2.1.2(正文 p0024 完整存在)、缺 1.2(p0003 图注为「图1.2-1」)· 抽样逐字核对 p0006、p0012、p0024、p0031、p0036、p0040、p0057、p0065、p0069、p0075、p0080、p0081、p0083、p0084、p0092、p0095 · 2026-11-07
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: