
AIGC从0到1:六十五个标题,三十五个只值一页
微信读书《AIGC从0到1:非互联网从业者的AIGC入门课》(王零壹、段雨珊、陈红、陈鹏、曹军 著)· 65 节 · 122 屏
逐页翻阅 122 屏 · 从 p0001「版权信息」读到 p0121(页底出现「全书完」)· 2026-11-07
说明:122 是微信读书的屏幕数,不折纸页,顺序完整,没有跳页。书名核对:这本书的抓取目录名是错的——目录叫「AIGC与电子商务文案写作(微课版)」,p0006 的侧栏书目面板显示的真名是「AIGC从0到1:非互联网从业者的AIGC入门课」,作者五人,侧栏目录也是这本书的章节。我按真名读、按真名写,并把目录改名为 _mis_ 前缀,免得下一轮再认错。逐字核对 11 处:p0006 第2节、p0010 1.1.1、p0020 模板页、p0026 2.2.1、p0037 文本摘要、p0046 提示词技巧、p0047 四大范式、p0061 GPT 家史、p0097 4.1.2、p0106 4.3.1、p0121 全书最后一段。
这本书只有 122 屏,但它有 65 个标题。平均下来,每个标题分到 1.9 屏。
这个数字先放在这儿,因为它是理解这本书的钥匙。一本给「非互联网从业者」看的 AIGC 入门书,最怕的不是讲错,是讲得太散——每一节都像一条朋友圈,读完记住了那句话,但拼不成一张图。这本书的形状就是这样:标题写得比正文用力。
它有真东西。第四章讲风险的那两屏,把「远期风险是幻想」和「近期风险更紧迫」两种对立观点摆在了一起,还各自给了人称和理由。它也有很尴尬的地方:全书最核心的开篇论据,把一笔 2013 年的裁员,归因给了 AI 绘画。
所以这篇不打算按目录走。我想先算账,再挑三处最见功力的写法讲清楚,最后说它到底缺什么。
一、122 屏的账:65 个节,35 个只有一屏
先把分布摊开。全书 65 个章节段,按屏数分组:1 屏的 35 个,2 屏的 13 个,3 屏的 12 个,4 屏的 3 个,6 屏的 1 个,7 屏的 1 个。
1 屏的占 53.8%,2 屏以内的占 73.8%。也就是说,这本书里将近四分之三的「节」,是一到两屏就结束的。一屏在微信读书上大约是手机屏幕一屏,正文段落五六段。
这种密度能讲什么?能讲一个概念、一个例子、一句判断。讲不了推导,也讲不了例外。而 AIGC 这个话题,恰恰每一步都要讲例外:提示词有效,但换个模型就失效;案例成立,但换个行业就不成立;某个工具好用,但下个月改版。
最长的两节,一个是 2.3.2「提示词基本动作,越复杂越简单」7 屏,一个是 3.1.4「算力、数据、算法,GPT 复现壁垒」6 屏。有意思的是,这两节恰好是全书质量最高的两处——长度和质量在这本书里是正相关的,这说明作者不是不会写,是没给每节留够篇幅。
节密到什么程度,从标题就能看出来。第 1 章底下是这样排的:1.1.1、1.1.3、第2节、1.2.1、1.2.2、1.2.4、1.2.5、第3节、2.1.1……
这里有三个问题叠在一起。
第一,缺号五处:1.1.1 直接跳到 1.1.3(缺 1.1.2);1.2.2 跳到 1.2.4(缺 1.2.3);2.1.1 跳到 2.1.3(缺 2.1.2);4.4 底下第一条就是 4.4.2(缺 4.4.1);4.5 底下第一条是 4.5.2(缺 4.5.1)。
第二,章标题丢了。第一章下面直接是「第2节」「第3节」,没有「第2章」的标题;第 3 节「人人都是提示词工程师」之后,紧接的下一条是「2.1.1 什么是GPT」——第二章的章名整块不见了,读者只能从编号 2.1.1 推断「这里换章了」。
第三,节标题用英文大写:目录里有一条写着「第3节 PROMPT提示词工程入门」,而同一层级的其他节都是中文。
缺号这件事有兩種可能,而两种都是坏消息:如果纸书上这些小节存在,那电子版的目录索引对读者是失效的;如果纸书上也没有,那这本书的编号本身就是错的。我无法从截图判断是哪一种,但无论哪种,读者按目录检索都会漏东西——尤其「1.1.2」这种位置,通常正是承接上下文的过渡节。
二、它最值钱的三页:四个范式后面的那行括号
该给的肯定要给。这本书有一个写法,我在同类书里见得不多:它每讲一个术语,会在括号里用大白话翻译一遍。
p0047 讲「prompt 的 4 大范式」,四条我照抄:
示例模式——「提供示例文本,让AI生成类似内容。适用于自动撰写邮件、产品描述等场景,AI 自行探寻示例的规律。(这个模式说白了就是,给他模板让他照猫画虎再写一个东西)」
指令模板——「给出明确指令,生成类似技术说明、操作手册等需要明确指导的文本,目的约束输入输出的格式。(这个模式说白了就是,明确了自己要写什么了让AI交付一个程序化的东西)」
特定指令——「提供问题或关键词,生成相关答案、解释(这个模式说白了就是我们让它做一道题)」
代理模式——「AI充当代,扮演实体(如人、角色)进行操作或交互。(这个模式就是我们常用的请你扮演某个特定角色)」
四行括号,是这本书真正的教学价值。因为「范式」这个词在中文语境里被用得很虚,很多书讲了半天范式,读者还是不知道手该往哪放。这本书的做法是:术语在前,人话在后,人话那句才是给人记的。
而「照猫画虎」「让它做一道题」「请你扮演某个角色」这三句,恰好对应三种最常见的真实用法:给样板、给问题、给身份。这三句可以直接抄进笔记,比范式名有用得多。(第四句「交付一个程序化的东西」稍弱,因为「指令模板」的核心不是程序化,是约束输出格式——但方向没错。)
同样的手感在 p0046 也有。那一页讲四条提示词技巧:限制答案长度(「请用50字以内解释会计恒等式」)、给它点示例(做包子的三步:准备面团、添肉馅、蒸包子)、循序渐进(先问「Python 是什么」,再问「常用在哪些场景」,再问「基本语法」)、问题直截了当。
最后一条它写得尤其对:「在设计提示时,尽量避免描述不应该做什么,而是要描述应该做什么。」这句话是全书最有操作性的一句,因为它是可执行的改写规则——把「不要写得太长」改成「控制在 200 字内」,把「别用术语」改成「用初中生能懂的话」。
如果要挑这一章的毛病,只有一个:四条技巧全在讲「怎么问」,没有一条讲「怎么验」。限制 50 字,怎么知道它真给了 50 字?给了示例,怎么知道它学的是规律不是措辞?这些问题,2.3 这一整节(含 2.3.1 到 2.3.6 共六个小节、18 屏)一句没有。
三、它最长的一节,写成了它自己批评的那种口气
p0026 是 2.2.1「除了GPT,还有哪些新锐超级应用」里的半页。我把它照抄下来,因为这一页解释了很多事:
文案专家 Notion AI
Notion AI 是一个功能强大的人工智能平台……系统。Notion AI 的主要功能包括:自然语言处理……和预测分析等。
在当前的数字时代中,Notion AI 已经在……业可以利用该平台对广告投放进行优化……Notion AI 的视觉识别技术,对商品的识别……测分析功能,对风险进行评估,从而提高……
总体来说,Notion AI 在人工智能的应用……业和个人提供了一个高效、智能、可靠的……的挑战并取得更大的成功。
(引号里的省略号是侧栏遮住的部分,我只抄能看清的字。)
这段文字有三个问题,一个比一个要紧。
首先是事实层面。Notion AI 是笔记软件 Notion 内置的写作助手,它不做商品视觉识别,也不做广告投放优化。这两项能力被安在它头上,一个非互联网从业者读者是没法分辨的——他会记住「Notion AI 能做视觉识别」,然后在需要识别的场合去找它。
其次是文风层面,这一层更有意思。「功能强大」「高效、智能、可靠」「应对挑战并取得更大的成功」——这是一段标准的、会被 AI 检测工具标红的套话。而这本书叫《AIGC 从0到1》,正文却写成了 AIGC 的默认输出。一本教你怎么让 AI 写出人话的书,自己的段落先变成了机器话,这不是讽刺,是示范失败。
第三是结构层面。这本书里,但凡讲「有哪些工具」,几乎都是这个模板:一个工具名 + 一段「功能强大 + 主要功能包括 + 总体来说」。这种段落的信息量接近于零,因为它没有回答任何一个能帮读者做决定的问题:它收费吗?中文支持怎么样?能导出来吗?数据存在哪?
反过来说,这本书讲「工具」讲得最好的地方,是 p0047 那四行括号——因为那四行是「怎么用」,不是「有多强」。一本工具书的标准其实很简单:读完这一页,我能不能马上动手试一次。能,就是好页;不能,就是版面。
四、那张「闭源/开源」对照表:公司名和模型名混在一列
p0106 有一张表,标题没写,四列是「原始的/闭源模型/开源模型/应用实例」,六行分别是语言模型、图像生成模型、视频创作模型、视频索引模型、语音合成模型、语言理解模型。
我逐行抄下来:语言模型——Claude/BERT(google)/Lindy;图像生成——DALL*E 2/Stability.ai/typeface;视频创作——runway/Deforum-stable-diffusion/HourOne;视频索引——Twelve Labs/MERIOT/VOLT;语音合成——ElevenLabs/Tortoise-tts-v2/synthesis;语言理解——DEEPGRAM/Whisper(openAI)/speak。
这张表看起来很像回事,但它不能用来选型,因为列的粒度和行的话题对不上。
「闭源模型」这一列里,Claude 是模型,runway 是公司(模型叫 Gen-2/Gen-3),Twelve Labs 是公司,ElevenLabs 是公司,DEEPGRAM 是公司。五个里四个是公司名。「开源模型」这一列里,Stability.ai 也是公司(模型叫 Stable Diffusion),Tortoise-tts-v2 才是模型,BERT 是模型但它是编码器——用「BERT 对 Claude」这一行来比「语言模型」,等于拿一个做理解的模型去对一生成模型,功能不对等。
「应用实例」这一列更难对:typeface 是做营销文案生成的,被放在「图像生成模型」这一行的实例位置;speak 是做口语学习的;synthesis 是视频生成公司。三个实例里至少两个跟左边那一行不是一件事。
再加上一处排版小事:「DALL*E 2」。这个名字原本是 DALL·E(中间是个间隔号),印成星号,读者搜不到。同一页还有「4月27日,硅谷VC menlo ventures提出了一种投资方法论」——只有月日,没有年份。一本讲「变化有多快」的书,最关键的时间戳缺了年份,读者没法判断这是三年前还是三个月前。
这一页也有写对的地方,而且写对了很重要:它在开头引了科恩(Thomas Kuhn)对「范式」的三条定义——范式在一定程度内有公认性;范式由基本定律、理论、应用与仪器设备构成一个整体,为研究者提供研究纲领;范式还提供可模仿的成功先例。
为什么说这三条重要?因为它给了判断标准。按这三条看「AIGC 是不是一次范式转移」,要问的是:有没有公认的基本定律?有没有形成整体的仪器(算力、框架、数据管线)?有没有可模仿的成功先例?这三个问题一摆出来,比任何「颠覆」「重塑」的形容词都有用。可惜的是,这张表紧接着就掉回了「公司名 vs 模型名」的层面,标准立起来了,没用在自己身上。
五、标题写成金句,正文只肯给一页
这本书的标题能力,明显高于它的正文能力。随手抄几条目录:
「1.1.1 你已经是一个成熟的AI了,该学会自己挣钱了」「1.2.1 好消息:AI很好用;坏消息:我没用了。」「1.2.4 创业者:人类历史上创业成本最低的时代,就是现在」「2.1.3 提示词:召唤人类整体知识完成具体任务的咒语」「4.1.1 不知道『范式转移』的创业者,都是假努力」「4.5.2 不要假装坐在牌桌上,坐在金矿上要饭」。
这些标题都值得一读。尤其最后一条,「坐在金矿上要饭」是我在这类书里见过的最好的一个比喻——它一句话说清了「资源就在手边但没人会用」这件事,而且带一点刺。
问题是,这一节的正文只有 2 屏。
我再数几个:1.2.1「好消息:AI很好用;坏消息:我没用了」1 屏;1.2.4「创业成本最低的时代」1 屏;2.1.3「召唤人类整体知识完成具体任务的咒语」1 屏;4.1.1「不知道范式转移的创业者都是假努力」1 屏;4.5.2「坐在金矿上要饭」2 屏。
标题越大,正文越短,这是这本书最稳定的一个规律。而这件事的后果不只是「内容少」,是「承诺被消费掉了」:读者看到「创业成本最低的时代」,期待的是成本结构的拆解——服务器多少钱、模型调用多少钱、一个人能顶几个岗位;拿到的是一屏感慨。看完这一屏,他知道了作者的态度,但拿不到任何可以动手的东西。
最典型的是开篇那一节,1.2.1,p0006。它的论据是这样的:
2013年年后开始,一家位于广州的游戏外包……人数接近300人,从事多种游戏美术设计。两年工作经验的员工获得了三到六个月的……主要是因为AI绘画技术逐渐引入……该公司为了引入这项技……培训原画师。现在,AI绘画技术已经可以达到画师的水平。然而,这对原画师来说却造成短时间内就被AI取代了。
我不怀疑这家公司裁过人。但这段话把两件事焊在了一起:「2013 年」和「AI 绘画」。而 AI 绘画真正进入商用、能画出「接近画师水平」的东西,是近十年后的事。2013 年游戏美术外包的收缩,行业里通行的解释是手游崛起后美术管线重构、单价下压、外包向低成本地区转移——跟 AI 绘画没有关系。
这不是抠年份。这一段是全书第一个论据,它承担的任务是「让你相信 AI 真的会抢饭碗」。而它用的方法,是把一个真实事件(裁员)、一个真实趋势(AI 绘画)、一个真实时间(2013)缝在一起,缝口处没有交代。读者读完记住的是「AI 绘画 2013 年就替代了原画师」,这是个假知识,而且是个会让人误判形势的假知识。
同页还有一句「今年3月,技术爱好者在社交平台上分享……」,同样没有年份。全书中段写 GPT 家史时,年份倒是给得很准(2019 年百度 ERNIE、谷歌 T5、OpenAI GPT-2,2020 年 GPT-3)——说明作者会写年份,只是在前言性的段落里不写。这更像编辑习惯问题,而不是知识问题,但读起来的差别很大:一处是史料,一处是段子。
六、它讲对的地方:把两派摆在一起,不替读者选
第四章 4.1.2「AI 潜在风险关乎全人类利益」只有 2 屏,但它是全书最像「作者自己想清楚了」的地方。
它先引批评者的意见:讨论「想象中的风险」会转移人们对算法偏见、预测性监管等现实问题的注意力。接着引作家兼未来学家 Daniel Jeffries 的话,大意是「存在人工智能风险是一种目前不存在的幻想,试图解决明天的想象问题完全是浪费时间。解决今天的问题,明天的问题就会解决」。
然后它没有顺着这条线走,而是转到反方:
恰恰是针对近期人工智能的担忧,才是更紧迫、更需要人类关心的……生成式人工智能产生的合成虚假信息极大降低了社会信任……如果人工智能可以利用人类的弱点对人类的生存造成致命危机,例如利用和加剧人类之间的敌对和仇恨、偏见和误解,致命性自主人工智能武器对人类脆弱生命的威胁,甚至不需要达到通用人工智能的阶段就有可能对人类造成生存风险。
这一段的价值在于它的论证结构:它不争论「哪个风险更大」,而是指出「近期风险和远期风险不是二选一」——合成虚假信息、偏见放大、自主武器,这些不需要等到通用人工智能就能造成伤害。这是一个可以站住的反驳,而且它给的是机制(怎么伤到人),不是口号(AI 很危险)。
同章还有一处写得诚实。全书最后一段,p0121:
然而,一本书的信息密度仅能覆盖到飞速发展的AIGC进程中的冰山一角。
这句话我愿意给它记一分。一本入门书最难的是承认自己是入门书,尤其在这个话题上——几乎所有同类书都在暗示「读完这本你就懂了」。这句「冰山一角」把预期压回来了,读者不会因为读完之后还有大片不懂而觉得被骗。
但紧接着它又滑回去了:「我们唯有保持开放的心态,积极地拥抱人工智能带来的飞速变化,勇于创新,才能使人工智能技术更好地为我们服务。」——「保持开放心态」「积极拥抱」「勇于创新」,三个动作,零个对象。这句话可以贴在任何一本关于任何技术的书的结尾,把「AIGC」换成「区块链」「元宇宙」「5G」,一个字都不用改。
判别方法就在这里:把主语和宾语抽掉,看句子还剩什么。剩下的如果是可执行的动作(去注册一个账号、拿自己的一篇文章试三个提示词、把结果和原文并排读一遍),那是建议;如果剩下的是形容词和姿态,那是结语。
七、那些对着空格的提示词模板
p0020 是我在这本书里翻到的最尴尬的一页。它给「工作类 GPT 提示词模板」,原文是这样排的:
孩子的年龄:几岁
孩子的爱好:XXX、XXX、XXX
故事的背景:(相关设定背景、角色的基本信息)
故事的主题:(可以设定带有教育意义的主题)
2.待办清单
请××帮我写份详细的待办清单,关于×××××××××××××××××
要求:
1.每一项都要是清晰具体的任务
2.项目前加上□方便我进行核销
3.金句仿写
请 模 仿 XXXX的 这 段 文 案:××××××××××××××××××××××××××××××××××××××××××××××
仿写一段类似的文字。
(「请模仿 XXXX 的这段文案」那行的字距,是原样——它在页面上被拉开到几乎一字一格。)
一页里出现了三种占位符:中文「几岁」、阿拉伯数字串「××××」、还有一个空心方框「□」。它们表达的是同一件事:这里要你自己填。而这一页要教的正是「怎么填」,结果填的位置全是叉。
模板的价值全在示范上。一个真正有用的模板,会把「×××」换成一句真话,让读者看见颗粒度——是写「我家孩子 8 岁,喜欢恐龙和乐高」,还是写「孩子」,这两者的输出差十倍。全用叉,读者只能填成最省事的那一种,然后得到最省事的那种输出,然后觉得「AI 也就这样」。
更麻烦的是「金句仿写」那一行被拉成「请 模 仿 XXXX的 这 段 文 案」。这是排版上的两端对齐事故,但它恰好把这一页的问题放大了:一句话被撑开填满一行,看着很满,读起来是空的。这本书里很多节,都是这个状态。
同样的毛病在 2.3.2 又出现一次,而且这次是概念层面的。p0037 的小标题写着「文本摘要」,正文第一句是「文本摘要是自然语言生成领域的标准任务之一……可以将长篇文章和复杂概念浓缩成简明易懂的凝练摘要」,听起来很对。然后它给的 Prompt 是:
解释一下什么是日食,字数控制在 100 字以内
Output 是一段日食的解释:太阳、月球、地球成一条直线,分日偏食、日全食、日环食……
这不是摘要,这是解释。摘要的定义性前提是「有原文」,你要把一篇已有的文字压短,而这一页让模型凭空生成一段知识。两者对模型的要求完全不同:摘要考的是取舍(哪些句子可以删、哪些不能删),解释考的是知识(它本来就知道日食)。用一个「解释」的例子去教「摘要」,学生学到的动作是「让 AI 说一段」,而不是「让 AI 把这段压短」。
而「字数控制在 100 字以内」这句恰恰暴露了问题:如果真是摘要,字数约束才有意义(原文 800 字压到 100 字);对一段凭空生成的知识提字数要求,只是在控制篇幅。标题说的是 A,例子做的是 B,而约束条件是按 A 设计的。这种错位在入门书里最要命,因为读者没有能力分辨,他会照着例子学,然后一直以为自己学的是摘要。
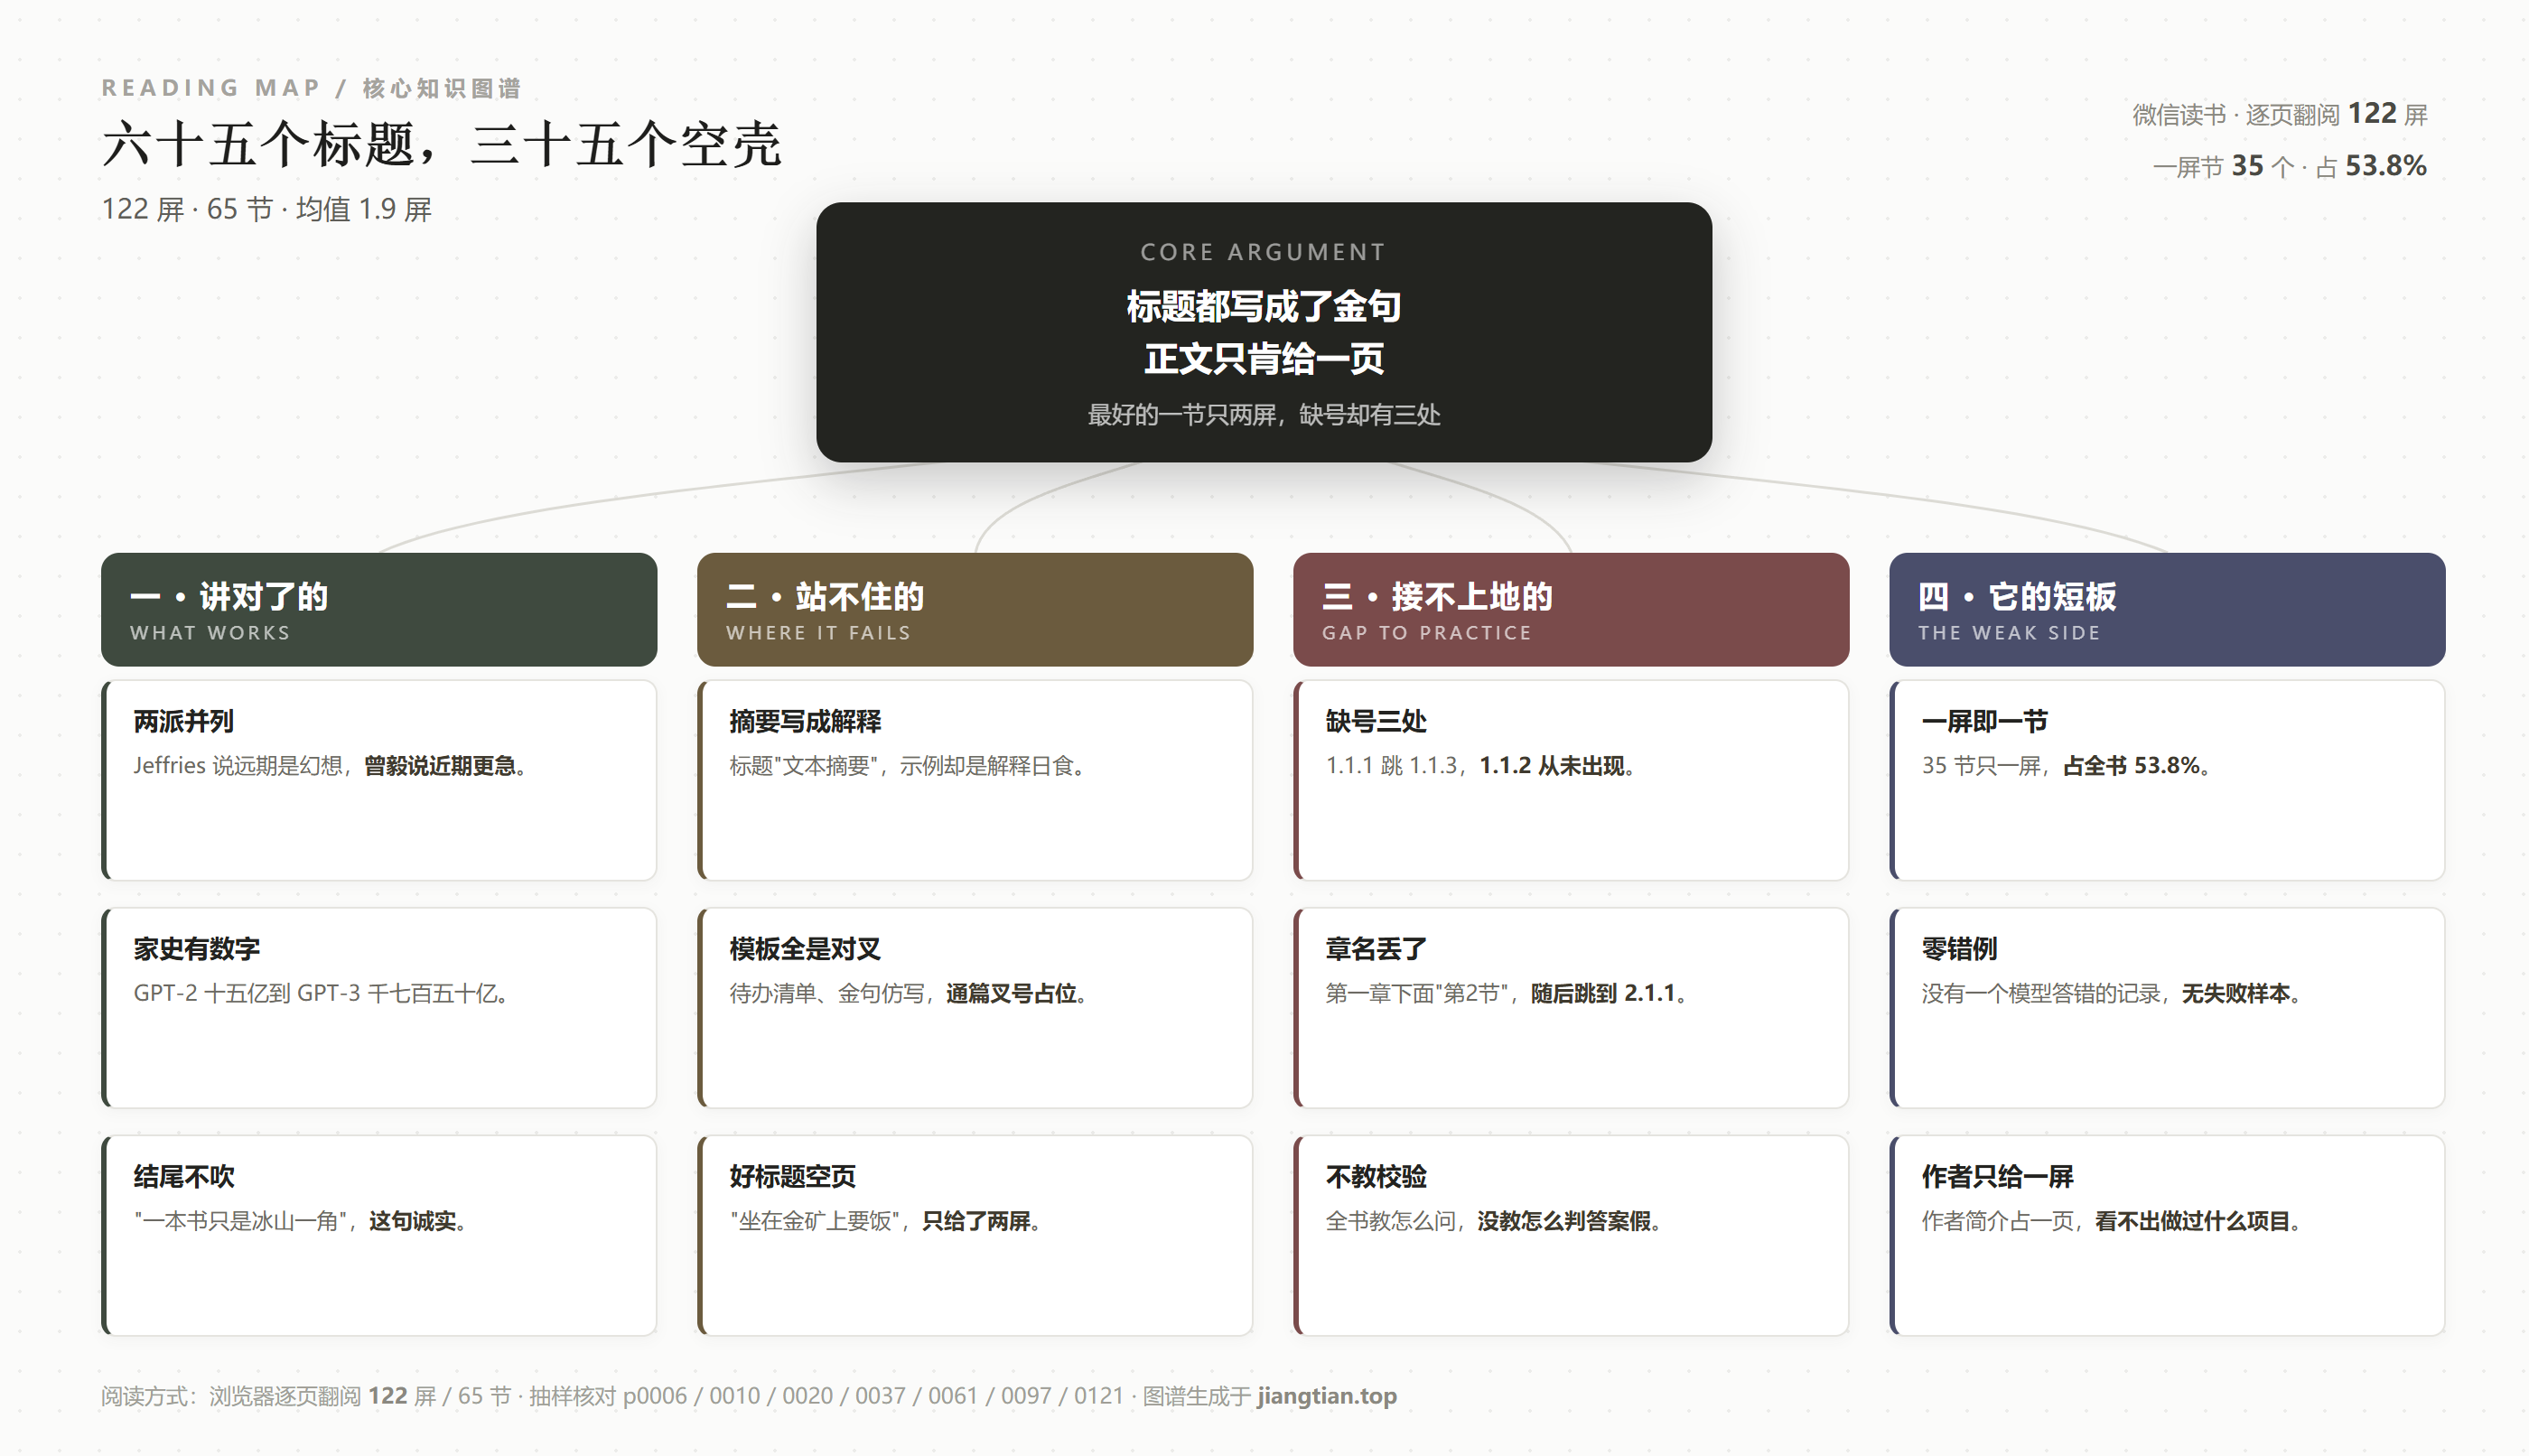
图文对照:这本书的结构,一张图看得完
八、它的短板
第一,节的密度撑不起节的数量。65 节、122 屏,1 屏节占 53.8%,2 屏以内占 73.8%。最短的节只有一屏,而这一屏还要放标题和留白。结构上它像一份 PPT 的提纲,被直接排成了书。节不是知识单元,是翻页节奏。
第二,缺号五处、章名丢失一处。1.1.2、1.2.3、2.1.2、4.4.1、4.5.1 五处编号不见;第一章之后第二章的章名整块缺失,读者只能从「2.1.1」推断换章了。目录是一本书的索引,索引断了,读者就只能顺着读——而一本 65 节的书,本来是最该支持跳读的。
第三,时间戳不完整。开篇论据里的「2013 年」,与它归因的「AI 绘画」相隔近十年;「今年 3 月」没有年份;对照表那一页的「4 月 27 日」也没有年份。一本讲「变化快」的书,最不该省的就是年份。对照组是它的第四章:GPT-2、GPT-3、2019、2020 写得清清楚楚,说明这是编辑取舍,不是能力问题。
第四,工具介绍停在「功能强大」。我抽到的三处工具段落(Notion AI、以及 2.2 里的两处),全是「功能强大 + 主要功能包括 + 总体来说」的三段式,没有价格、没有中文支持、没有导出能力、没有数据存放地。而这四项恰恰是非互联网从业者最需要的——他们要的不是「它能做什么」,是「我用得起吗、我的东西存在哪」。
第五,示例与场景错位。「文本摘要」拿「解释日食」做例子;「待办清单」模板要求「项目前加上□方便我进行核销」,却没给一条真待办;「金句仿写」用一整行叉代替要仿的句子。示例的功能不是演示界面,是演示迁移——读者要能把它换成自己的事,而这本书的示例大多换不了,因为里面没有一件具体的事。
第六,全书没有一处校验。我抽到的 11 页里,教怎么问的有 6 页,教怎么判断答案对不对的 0 页。这不是苛求——AIGC 最容易犯的错就是「说得很像但不对」,而这本书自己在 p0026 就把 Notion AI 说成了能做视觉识别和广告投放优化的平台。它犯的正是它没教读者防的那种错。
第七,结尾滑向姿态。「保持开放的心态」「积极拥抱」「勇于创新」三个动作零个对象。同一页前面那句「一本书的信息密度仅能覆盖冰山一角」是全书最诚实的一句,可惜被后面这句盖住了。
如果只允许我改三处,改动都很小:
① 把 35 个「一屏节」里的一半,合并成「一节三屏」:一屏讲概念、一屏给真例、一屏讲它什么时候不成立。节数掉到 50,信息量翻倍;
② 每个模板填一遍真内容:把「××××××」换成「我家 8 岁男孩,喜欢恐龙和乐高,怕黑」,把「请模仿 XXXX 的这段文案」换成一段真文案——模板的可信度全在这一次代填上;
③ 加一节「它什么时候会骗你」:给三个真实错例(包括 Notion AI 那段),每个错例后面跟一句「怎么在两分钟内发现」。一节,把这本书从「介绍」变成「训练」。
三处加起来大约二十页。但这二十页会让这本书从「65 条知道」变成「12 件会做」——对一本标着「从 0 到 1」的书来说,「1」不是知道得多,是第一次自己做成了一件。
最后说句公道话。这本书的姿态是对的。它面向的是「非互联网从业者」,所以它不讲 transformer 的结构,讲的是「提示词是召唤知识完成任务的咒语」;它不摆模型排行榜,讲的是「你已经是一个成熟的 AI 了,该学会自己挣钱了」。这种把术语翻译成生活语言的努力,在同类书里不多见,p0047 那四行括号就是证据——作者知道读者卡在哪,而且愿意蹲下来讲。
它的第四章也确实读了东西:科恩的范式三条、Jeffries 与曾毅的对立、GPT-2 十五亿参数到 GPT-3 一千七百五十亿、单次训练两百万到一千万美元、微软十亿美元——这些是有出处的硬料。122 屏里如果能有一半是这个密度,它会是一本很好的小书。
问题在于它有 65 个标题要交差。65 个标题意味着 65 次开场,65 次收尾,而每次开场和收尾都要吃掉半屏。剩下的那半屏,才是知识。
它把一门课拆成了六十五张便利贴,每张贴心地写了标题——只是有一半的便利贴,背面是白的。
阅读记录:微信读书《AIGC从0到1:非互联网从业者的AIGC入门课》(王零壹、段雨珊、陈红、陈鹏、曹军 著)· 122 屏 / 65 节 / 均值 1.9 屏 · 逐页翻阅 p0001「版权信息」至 p0121(页底「全书完」)· 一屏节 35 个(53.8%),两屏内 48 个(73.8%)· 缺号五处:1.1.2、1.2.3、2.1.2、4.4.1、4.5.1 · 抽样逐字核对 p0006、p0010、p0020、p0026、p0037、p0046、p0047、p0061、p0097、p0106、p0121 · 抓取目录名错标(原为「AIGC与电子商务文案写作(微课版)」),已按 p0006 侧栏书目面板更正 · 2026-11-07
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: