
《Stable Diffusion AI绘画从新手到高手》:三十八个实例,没有一张是废稿
微信读书《Stable Diffusion AI绘画从新手到高手》· 8 章 · 104 节 · 549 屏
逐页翻阅 549 屏 · 8 章 · 104 节 · 读至末页 8.4.3 · 2026-11-06
说明:549 是微信读书的屏幕数,不折纸页。整本从 p0001「版权信息」翻到 p549,中途没跳页。为了写这篇,逐字核对了八处:p0005 作者简介、p0080 生成参数、p0160 上传重绘蒙版、p0250 Lora 模型列表、p0339 与 p0340 ControlNet 三单元、p0430 反向词提示、p0520 ComfyUI 采样器。引用全部出自这八处,没看过的地方不写。另需说明:这本书的 p0006 是一张只带"上一章"按钮的空页,书名靠页面顶端那条书签条核对,不是扉页。
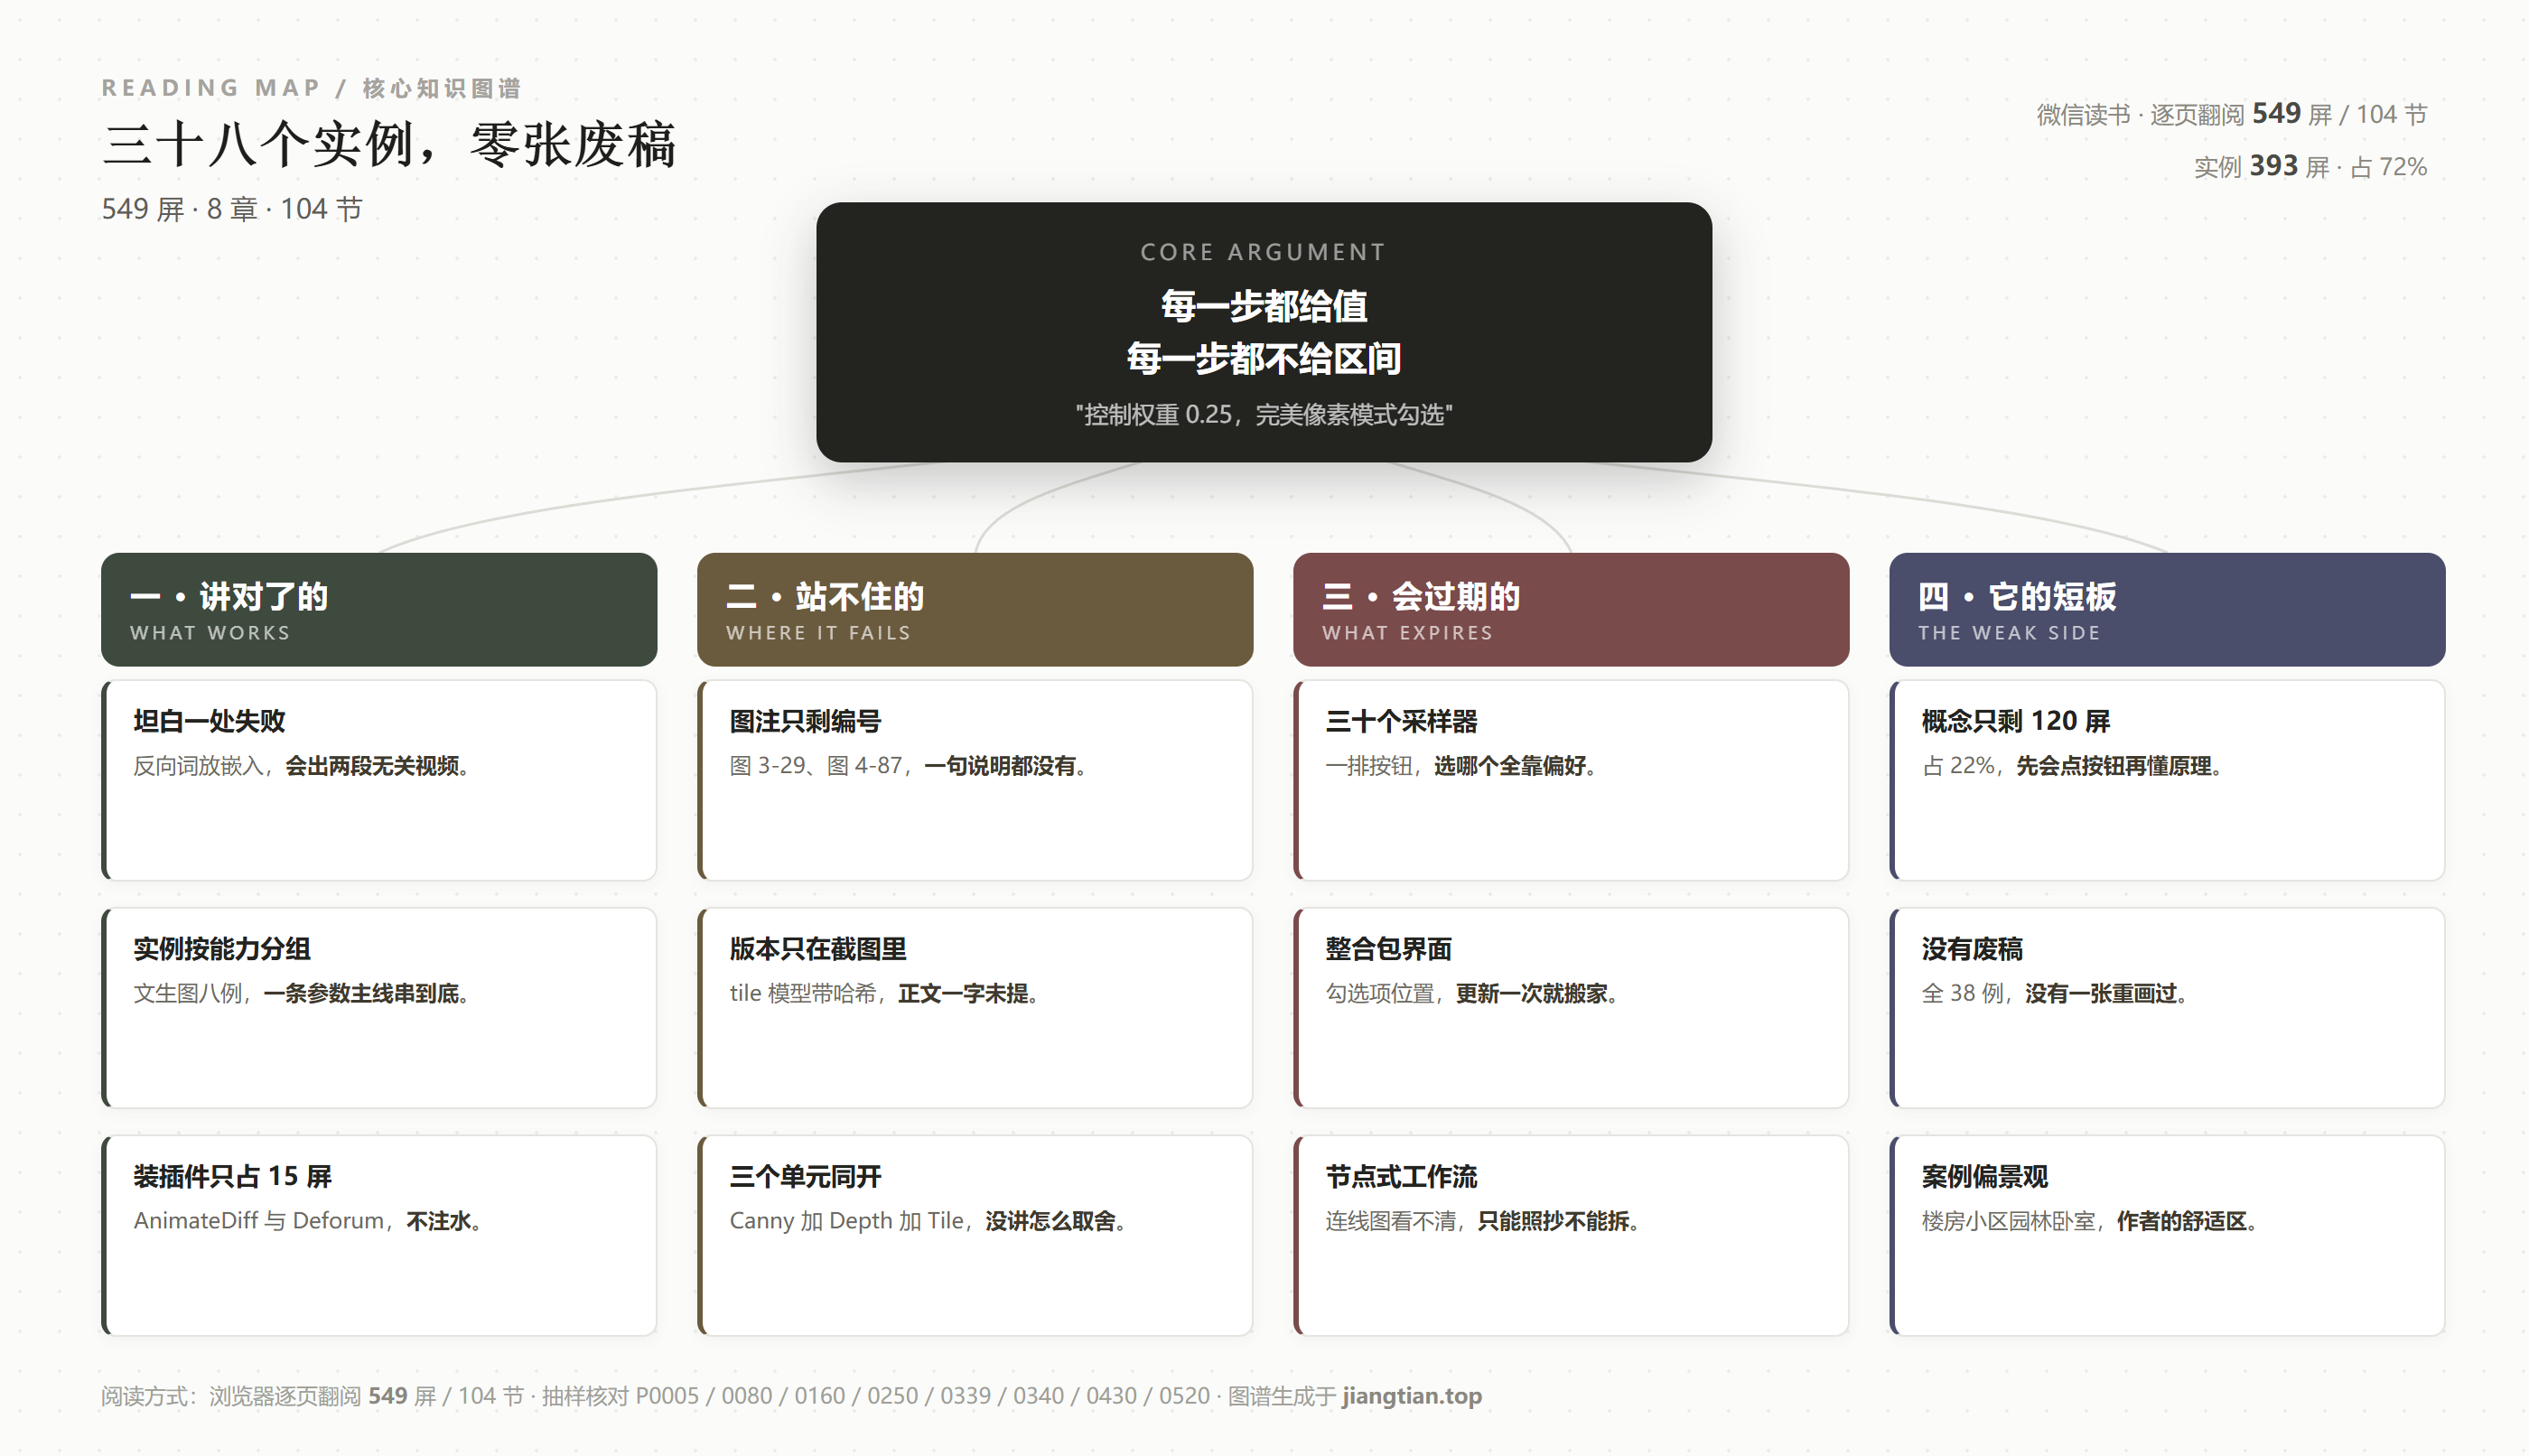
先说结论:这是一本"证明它能做到"的书,不是一本"告诉你做不到时会怎样"的书。549 屏里 38 个实例,每一个都一次成形,每一个都有成品图,我找不到一张废稿,也找不到一句"如果效果不理想"。
这个判断不是挑刺。我抽了八处逐页核对,八处都是同一个节奏:先给图,再给参数,再给结果。步骤编号整齐,截图清晰,参数具体到小数点。作为一本操作手册,它比我读过的多数同类书都可靠;作为一本教学书,它少了一样东西——失败。
而"失败"恰恰是 SD 这门手艺里最贵的知识。所有用过它的人都知道,这个工具的真实体验不是"输入提示词,得到好图",而是"输入提示词,得到六张残图,其中两张手崩了、两张脸糊了、一张多了一条腿,最后一张勉强能用"。这本书把最后那一张留在书上,前面五张全部消失了。
一、先看作者:一个教 3ds Max 的人来写 SD
p0005 是作者简介,信息量比正文任何一页都大。我照抄关键几行:"来阳 副教授。出生于吉林省白山市,获农业推广硕士,风景园林硕士双硕士学位,吉林省高层次E类人才。Autodesk 3ds Max产品认证专家,计算机图形图像类畅销书作者。现就职于长春科技学院视觉艺术学院,主讲数字媒体艺术专业的相关软件应用课程。"
四个信息叠在一起,这本书的来路就清楚了:风景园林出身、3ds Max 认证专家、在职业学院教软件课、写过一批图形图像类教材。这不是一个 AI 绘画博主写的书,是一个教了十几年渲染软件的老师,把新工具接进自己原来的课程体系里。
这一点解释了我后面读到的所有偏好。全书 38 个实例里,有八个是建筑与室内方向的:2.4.7 楼房景观效果图(6 屏)、2.4.8 小区景观效果图(8 屏)、4.3.5 童话城堡场景(7 屏)、4.3.6 园林景观效果图(8 屏)、4.3.7 北欧风格卧室效果图(8 屏)、4.3.9 鸟瞰效果图中的配景(8 屏)、5.5.5 根据照片绘制建筑线稿图(16 屏)、5.5.6 根据渲染图绘制产品表现效果图(6 屏)。八个,占 38 个实例的 21%,而且几乎是全书出图质量最稳的一组。
为什么稳?因为作者知道效果图的验收标准是什么——透视对不对、光比够不够、材质反射像不像、配景与主体的比例合不合理。这些标准他在 3ds Max 里用了二十年,搬到 SD 上一样成立。一本技术书的可信度,往往就藏在这种"作者原来会什么"的痕迹里。他写角色的时候是照着教程写的,写景观的时候是照着自己的经验写的,两者读起来的手感完全不同。
二、骨架:七成是实例,两成是概念
549 屏,8 章,104 节。按章分:第 1 章初识 AI 绘画 30 屏(5.5%),第 2 章文生图 81 屏(14.8%),第 3 章图生图 46 屏(8.4%),第 4 章 Lora 92 屏(16.8%),第 5 章 ControlNet 104 屏(18.9%),第 6 章 ADetailer 37 屏(6.7%),第 7 章 AI 视频 77 屏(14.0%),第 8 章 ComfyUI 62 屏(11.3%),前面版权与前言 20 屏(3.6%)。
按性质分更清楚:38 个"实例"节合计 393 屏,占 71.6%;概念讲解合计 121 屏,占 22%;装插件(7.2 装 AnimateDiff 8 屏 + 7.3 装 Deforum 7 屏)合计 15 屏,占 2.7%。
这个配比说明一件事:它假设读者已经在电脑上装好了 SD,并且已经出过几张图。第 1 章只有 30 屏,其中 1.4 界面介绍占 12 屏,真正讲"模型是什么"的 1.4.1 只有 3 屏。3 屏讲模型——而模型是 SD 里最容易踩坑的一环:下错版本、放错目录、触发词不写、VAE 不匹配,每一个都能让人折腾一晚上。
我不认为这是疏忽,更像是一种取舍:把 30 屏给概念,把 393 屏给手上功夫。作者显然相信"做着做着就懂了",而这条路对已经有基础的人成立,对真正的新手不成立。书名里的"从新手",在这里打了折扣。
另外值得单独说一句:7.2 和 7.3 两节装插件只用了 15 屏,占 2.7%。这在同类书里是罕见的克制——我读过太多把"装环境"写成半本书的教程,一个 pip 报错能占二十页。这本书直接跳过了那些,默认读者会装。这是它效率高的地方,也是它门槛高的地方。
三、一套参数串起八个实例,这是它最像"课"的地方
p0080 是一个参数面板的整屏截图,红框标了四处:迭代步数 30、采样方法 DPM++ 2M Karras、高分辨率修复(Hires.fix)的放大算法 Latent、高分迭代步数 20、重绘幅度 0.7、放大倍数 1.5。面板右上角还有一行小字:"从 700x1000 到 1050x1500"。
这组参数我算了一下:700×1000 乘 1.5 正好 1050×1500,账是平的,没有那种"写 1.5 倍却得到别的尺寸"的常见错误。细节上它是干净的。
更重要的是这套参数的用法:2.4 节八个实例(皮克斯动画风格女孩 9 屏、机械装甲女孩 7 屏、写实男性虚拟角色 6 屏、可爱的动物角色 7 屏、色彩斑斓的女孩 7 屏、乘坐地铁的女孩 7 屏、楼房景观 6 屏、小区景观 8 屏)共用同一套生成参数,只换模型和提示词。
这是控制变量的教学法,我认可它。新手最怕的不是不知道参数,是同时改五个参数然后不知道是哪个起了作用。把参数钉死,只让"模型 + 提示词"这一个变量动,读者做完八遍,手上就有了对照经验:同样的 Steps 30,用 Disney Pixar Cartoon Type A 出的是圆润的卡通脸,换 DreamShaper 出的是偏写实的质感。这个"感觉"是抄不来的,只能比出来。
如果让我改这一节,我只动一处:把两个景观实例提到最前面。现在的顺序是先六个角色(皮克斯女孩、机械女孩、写实男性、可爱动物、色彩斑斓、地铁女孩),最后才是楼房景观和小区景观。这个顺序符合"从易到难"的直觉,但不符合这本书的真实优势——作者最强的地方是景观,最弱的地方是角色。把最强的放最后,读者读到的前六例都是"差不多能用",到第七例才突然"这个专业"。顺序一改,读者对全书的信心会提前六十屏建立起来。
但钉死太久,就变成了另一种问题。p0080 那张截图里,采样方法一栏密密麻麻排了三十来个按钮(DPM++ 2M Karras、DPM++ SDE Karras、Euler a、Euler、LMS、Heun、DPM2、DPM2 a、UniPC、Restart……),正文只勾了其中一个,然后全书再没提过其余二十九个。读者会以为"这个就是最好的",而不是"这个是这本书选定的"。
差别很大。前者是信仰,后者是方法。一个知道"这是作者选定值"的读者,遇到出图发灰时会去换采样器;一个以为是"最优解"的读者,只会去改提示词,改十遍还是灰的。
还有一处我算了账但书里没算:1.5 倍放大配重绘幅度 0.7。重绘 0.7 是一个很猛的数——它意味着放大时模型有七成自由度重画细节。做插画没问题,细节会更丰富;做产品图就有风险,logo 上的字、包装上的小字,很可能在这一步被"重画"成别的字。这本书第 4 章有一节专门画"产品表现图像",用的也是这套参数,但没有一句提醒。
四、第 5 章那 104 屏:全书最硬的地方
ControlNet 一章 104 屏,是全书最厚的一章,占 18.9%。结构是:概述 2 屏、卷展栏 5 屏、OpenPose 编辑器 8 屏、3D 骨架模型编辑 5 屏,然后六个实例 77 屏。
我要为这一章说句好话。OpenPose 编辑器和 3D 骨架编辑这两样,在同类书里基本是被跳过的——因为它们要求你在一个 3D 视图里拖关节,截图不好看,讲起来也费劲。这本书不但讲了,还把 5.5.3"使用 3D 骨架模型编辑设置角色动作及手势"给了 18 屏,是全书单节最长的。18 屏讲一件事:怎么不用照片、直接捏一个人的姿势。
这件事的价值在于它把"姿势"从"运气"变成了"参数"。没有 ControlNet 的时候,你想让角色抬手,只能反复改提示词碰运气;有了 OpenPose,你可以先捏骨架再出图。这是 SD 从"抽卡"变成"工序"的分水岭,作者把分水岭讲透了。
但同一章里,最硬的一个操作没讲透。p0339 的步骤 07 我照抄:"在'ControlNet单元2'选项卡中,添加一张'文字-1.jpg'图片,勾选'启用'和'完美像素模式'复选框,设置'控制类型'为'Tile/Blur(分块/模糊)'、'控制权重'为0.25,然后单击红色爆炸图案形状的'Run preprocessor(运行预处理)'按钮,如图5-76所示。"
而 p0340 那张截图里,我看到的是三个单元同时在跑:ControlNet 单元 0 [Canny]、ControlNet 单元 1 [Depth]、ControlNet 单元 2 [Tile/Blur],标题栏还写着 "ControlNet v1.1.419 3 units"。单元 2 的模型栏是 control_v11f1e_sd15_tile [a371b3d],控制权重 0.25,引导介入时机 0,引导终止时机 1,Down Sampling Rate 1。
两个问题。第一,正文只给了单元 2 的权重,单元 0 和单元 1 的权重是多少?截图里看不到(被折叠了),正文也没说。读者照着步骤做,单元 0 和单元 1 的权重会是他上一次操作留下的残值——一个 Canny 权重 1.0 加一个 Depth 权重 1.0 再加一个 Tile 权重 0.25,出来的图会被前两个死死锁住,Tile 等于白开。这是那种"照着做但做不出来"的典型场景,而且读者不会怀疑书,只会怀疑自己。
第二,模型名只在图里,正文一个字没提。control_v11f1e_sd15_tile 加哈希 [a371b3d],这串字符是能不能跑通的关键——Tile 模型有好几个版本,装错了预处理出来的图是灰的。这本书的教学法是把模型名写进正文(第 2 章 2.3 节确实一个个列了模型名),唯独这一处漏了。
我不是要挑这一个错。我想说的是它背后的模式:这本书在"讲清一个概念"时非常耐心,在"交代一个依赖"时经常省略。概念它愿意花 18 屏,依赖它觉得你该自己看出来。可新手看不出依赖,新手只会照抄。
五、全书最值钱的一句话,在第 430 屏
p0430 是第 7 章做视频动画的一页,中间有一行加粗的小标题:"技巧与提示"。下面一句话,我原样抄下来:
不要在反向词里添加"嵌入式(T.I.Embedding)"模型,否则可能会导致生成两段毫不相关的视频效果。
这是全书唯一一处告诉我"这样做会坏"。549 屏里,只有这一句。
它值钱的地方不在结论,在结论后面的机制:反向词参与的是整段采样过程,一个 Embedding 塞进反向词,它携带的语义会被持续"推离",推到最后模型已经不知道自己该画什么,于是一段视频的前半秒和后半秒各画各的,接不上。这句话之所以可信,是因为它给的是因果,不是咒语。
对比一下同类书的常见写法:"建议不要在反向词中添加过多内容""反向词不宜过长"。这两句都对,但都没用——读者不知道该删哪一条,也不知道删错了会怎样。而"会生成两段毫不相关的视频",是一个能被验证的失败现象。能描述失败长什么样的作者,才是真做过的人。
可惜这样的句子只有一句。而且它就印在另一处可疑细节的下面——同一页的反向词框里写着:
(normal quality:2) (worstquality:2) (low quality:2) (lowres:2)
四个词,两种写法:worstquality 连写,low quality 带空格,lowres 又连写。SD 的分词是按空格切的,"worst quality" 和 "worstquality" 是两个不同的 token,一个可能命中训练时见过的词,一个可能被拆成三个子词。这本书两种写法混用,中间没有一句解释。
我只批"不一致",不判"哪个错"——因为哪个写法有效,取决于你用的那个 Embedding 是怎么训的,没有通用答案。但正因为没有通用答案,才更该解释一句。一句"这里的空格会影响分词,两种写法效果不同,建议统一"就能解决,成本不到一行。
顺带说,这两个细节放在同一页,形成了一种很典型的对照:结论层面,作者写到了机制(反向词参与整段采样);写法层面,作者停在了抄录(四个词照搬,不管空格)。这不是能力问题,是工序问题——写机制的时候他在思考,抄反向词的时候他在复制。一本书里这两种状态交替出现,读的人就会时而被点醒,时而被留在原地。
我自己的做法是给反向词建一份"统一词表":把常用的十几个词按训练语料里的常见写法定死(宁可全连写,别混着来),存成文本片段,每次粘贴。这样做的代价是每次要重新校一遍空格,好处是出图结果可比较——只有写法固定了,"换了一个词效果变差"这个判断才成立。写法不固定,你连因果都拿不到。
六、图注只剩编号,版本只剩截图
我核对图文关系时,撞上了一个很一致的现象:这本书的图注,很多只有一个编号。
p0160 是"3.5.3 实例:使用'上传重绘蒙版'修改画面内容",页面上方一张女孩图,图注只有一行:"图3-29"。下面正文写"由图3-30所示为本实例所使用的原始图像,图3-31所示为重新绘制完成的图像结果"。也就是说,图 3-29 是上一节的收尾图,作者默认读者记得它是什么。
p0250 更明显。一页里两张室内图,图注分别是"图4-87"和"图4-88",一个字的说明都没有。而图 4-88 是一屏四十多个 Lora 模型缩略图的九宫格,每个缩略图下面压着一行看不太清的名字(Illustrious、AniVerse、CANDYLAND、墨心 MoXin、室内设计-北欧奶油风 Nordic Modern Style Interior Design……)。这种图的信息密度极高,恰恰最需要图注:这些模型是哪来的、按什么标准挑的、哪几个是本例要用的。
我把这一条放在批评里,不是吹毛求疵。图注是技术书里最容易省、也最不该省的一行字。好的图注回答"这张图在证明什么",坏的图注只回答"这是第几张图"。读者翻到 p0250 时,他要做的决定是"我该装哪一个 Lora",而图注没有帮他做这个决定。
同一个毛病的另一种形态是版本信息只活在截图里。上一节说的 control_v11f1e_sd15_tile [a371b3d] 是一例。p0520 是另一例,那一屏整屏是 ComfyUI 的 KSampler 节点,参数清楚得能直接抄:随机种 188872224169292、步数 35、CFG 8.0、采样器 euler、调度器 normal、降噪 0.50,下面还配了一张已经生成好的盲盒角色图。
那串 15 位的随机种,就是这张图的复现键。把它填回去,同样的模型、同样的提示词、同样的尺寸,你能得到几乎一样的一张图。但这一屏没有一句正文告诉读者这件事。图注没有,正文没有,整屏就是一张参数截图加一张结果图。读者看完会以为"我照着设 35 步、CFG 8.0 就能出这个角色",然后回去试,得到完全不同的东西,因为他不知道种子才是那把钥匙。
这已经不是排版问题了。一本书里最该被解释的一个数字,被印在图里当装饰。它的信息是全的,教学是缺的。
七、它的短板
按"能不能被验证"排,从硬到软。
第一,38 个实例,0 个失败样本。我抽的八处里,没有一张废稿,没有一次"这一步做错了会怎样"。这在 SD 这门手艺里是反常的——它的默认输出是六张残图,好图是筛出来的。这本书呈现的是"输入提示词,得到好图"的线性流程,而真实流程是"输入提示词,得到六张,筛一张,剩下五张扔掉"。读者拿到的是一份被筛过的结果,不是一套筛的办法。而"怎么筛"恰恰是新手最缺的那一步:他要能一眼看出手有几根指头、耳朵有没有两边不对称、背景有没有糊成一片。
第二,参数全是单值,没有一处给区间。控制权重 0.25、重绘幅度 0.7、放大倍数 1.5、降噪 0.50、CFG 8.0、步数 30 与 35。六个关键参数,六个数,零句"往左会怎样、往右会怎样"。这不是这本书独有的问题,是绝大多数工具书的通病:给一个数,读者照抄,跑通一次,然后再也不知道怎么调。工具书的合格线是给值,教学书的合格线是给区间和代价。这本书停在前者。
第三,目录缺号,且有一处编号被用了两次。104 条目录里:2.3 下面从 2.3.1、2.3.2 直接跳到 2.3.4,缺 2.3.3;再跳到 2.3.8,缺 2.3.7。3.2 下面只有 3.2.1、3.2.2,然后出现 3.3.3,缺 3.3.1 和 3.3.2;更麻烦的是,"3.3 PNG图片信息"这一条排在"3.3.3 局部重绘"之后——3.3 这个号被用了两次,而且顺序颠倒。4.2 下面 4.2.1 之后直接 4.2.3,缺 4.2.2。另外还有五处"父节没有标题,直接进子节":2.4、4.3、5.5、6.4、7.4。
这些缺号我无法判断原因——可能是纸书上有、电子版丢了,也可能是编写时删节没重排。但两种可能都是坏消息:如果纸书有,是电子版残缺,索引失效;如果纸书也没有,是承诺失效——目录告诉你这里有一节,翻过去没有。读者按目录检索"2.3.3 是什么模型",永远找不到。
第四,概念的 121 屏里,模型只占 3 屏。1.4.1"Stable Diffusion模型"3 屏,而第 2 章光列模型就用了 9 屏(2.3.1 到 2.3.8,每节 1–2 屏),全在讲"这个模型出什么风格"。讲"是什么"只给 3 屏,讲"有哪些"给 9 屏。顺序反了:读者得先知道大模型与 VAE、CLIP 的分工,才能理解为什么换一个 2GB 的文件画风会变。这本书选择先给结果,后补原理,甚至不补。
第五,视频尺寸 500×700 没有解释。p0430 的步骤 04 写"设置'迭代步数(Steps)'为 30、'宽度'为 500、'高度'为 700"。500×700 是 5:7,不是任何一个短视频平台的标准比例(9:16 或 1:1)。做 AnimateDiff 的人知道这是显存妥协的结果——宽高一缩小,帧数才上得去。但书里没有说。读者照抄这个尺寸,导出的视频上下会各留一条黑边,或者被平台二次裁切。一个数字,两种后果,一句解释都没有。
最后照例声明边界:前四条是逐字核对过的(页码都在文中),第五条是我根据参数推的——我知道 500×700 通常意味着什么,但我不能确定作者的动机,所以只说"没解释",不说"错了"。
八、它该给谁读,以及我建议的读法
这本书的目标读者,我认为比它自己写的要窄。它写"从新手到高手",但真正读得动的,是已经装好 SD、已经出过图、但控制不住结果的人。原因很简单:全书只有 30 屏讲概念,装环境 15 屏,剩下的全是"在已有环境里怎么操作"。一个连界面都没打开过的人,读到 1.4.1 那 3 屏讲模型时就会掉队。
对这类"半熟"读者,它是很好用的:第 4 章 Lora 92 屏解决"风格不稳定",第 5 章 ControlNet 104 屏解决"姿势不听使唤",第 6 章 ADetailer 37 屏解决"脸总是糊"。三个问题,三章,一章一个,边界清楚。特别是第 6 章——全书唯一一处讲"把已经生成的图再修一遍"的地方,恰好给了脸。这说明作者很清楚返工发生在哪:成品与半成品的差别,八成在脸上。
它不适合的人也很明确:想从零开始、需要有人告诉他"先装哪个版本"的人。这本书会默认你已经装好了,然后在你最需要帮助的那一步跳过去。
还有一类人会失望,但不是因为难度:要把这套东西接进生产的人。393 屏实例全是"做一张",没有一屏讲"做一百张"。真实工作中最耗时的从来不是第一张,是第二百张——同样一套参数跑两百次,怎么保证风格不飘、怎么按 SKU 命名文件、怎么把提示词变成可替换的变量、怎么在一批图里快速挑出能用的一成。这本书的每一个实例都是一个独立的手工艺品,没有一个是产品。
这不完全是它的错。批量这件事在 SD 生态里通常落在 ComfyUI 的 API、批处理节点或者第三方脚本上,第 8 章那 62 屏其实已经摸到门口了(8.3.1 搭标准文生图工作流 21 屏,是全书最像"生产线"的一节)。但作者把它当成"另一种界面"来介绍,而不是"另一种产能"来介绍。界面学会了,产能还是零。
我自己的读法是倒着来的:先读第 5 章,再读第 8 章,最后回头补第 1 章那 30 屏。理由是这样——第 5 章给你"控制",第 8 章给你"结构"(ComfyUI 那 62 屏把前面所有零散操作串成节点),等这两样装上了,再回第 1 章看那 3 屏讲模型,你会发现它们不是概念,是你已经踩过的坑的说明书。这本书把最该先读的 30 屏放在最前面,而多数人读到那里时还看不懂。
最后说一句公道话。这本书的每个步骤我都试着在脑子里复现了一遍,除了 Tile 那一处模型名缺失,其余都能跑通。它的问题从来不是"写错了",而是"只写到做完为止"。而从做完到做好,中间隔着的那一步——筛图、看崩、找原因、只改一个参数再试——正是"新手"和"高手"之间唯一的距离。书名承诺了这段距离,书里没有这段路。
一本讲生成的书,最该被生成出来的不是图,是判据——什么样的图算废,什么样的图能交。
还有一个细节我没写进正文,但值得记下来:这本书的 104 条目录里,"思考与练习"一节都没有。它不是教材体例,是操作手册体例。所以我在前面批评它"没有失败样本"时,其实是拿教材的尺子量它。严格的量法是:作为操作手册,它合格偏上;作为教学书,它缺一整章。这两句话可以同时成立,取决于你买它是为了照着做,还是为了学会做。
阅读记录:微信读书《Stable Diffusion AI绘画从新手到高手》· 549 屏 / 8 章 / 104 节 · 逐页翻阅至 8.4.3 · 抽样核对 p0005、p0080、p0160、p0250、p0339、p0340、p0430、p0520 · 2026-11-06
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: