
Agent智造营:九本书拼出的数字员工,装得下野心装不下运维
微信读书《Agent智造营·人人都能搭建AI数字员工(套装共9册)》· 九册合订
逐页翻阅 3000 屏 · 9 册 · 2026-11-04
说明:3000 屏这套书我没有通读,抽了九处逐页核对——前言的五条收获、一天的排班表、邮件批处理代码、财务分析的 JSON 配置、batch 命令与表 5-2、销冠话术、Manus 做 PPT、扣子建工作流、LangChain 的 Plan-and-Execute 日志、表 9-2 的节点参数与纠错示例、农业 Agent 示意图。因为我本人长期在自己机器上跑 OpenClaw,所以第三节不是读后感,是拿实机对照的结果。这是抽样,不是通读,结论请按抽样的分量来听。
先给结论:判断这套书可不可信,有一个很省事的办法——看它给你的是画面,还是命令。凡是描述"几点钟谁被什么打断"的地方,基本可信,而且有用;凡是给你一串可以复制粘贴的命令行,八成是拼出来的。
它是一套九本合订的套装书,主题从 OpenClaw 部署一路铺到 Manus、Cherry Studio、扣子、AutoGen、MCP、GPT Store。九本书里,讲"一天长什么样"的那几页写得像有生活,讲"怎么跑起来"的那几页像没跑过。而后者恰好是读者最先照做的地方——这就是它最要命的地方:把最不可靠的部分,放在了最显眼的位置。
一、先看清它是九本书,不是一本
目录有 131 条。翻到第十条左右你会发现,一本书讲完了:第一册《OpenClaw 实战指南》从"认知重塑"讲到"一人公司架构师",最后是"作者简介"和"文后"。然后紧接着就是第二册《普通人打造AI小团队》的"第1章 认识智能体",再往后是《AI智能体设计实战:用Coze从零打造21个贴身AI助手》《AI Agent开发实战:从基础原理到企业级应用》《AI Agent设计实战:智能体设计的方法与技巧》《智能体设计指南:成为提示词高手和AI Agent设计师》……每一册都自带"前言""内容简介""推荐序"。
这件事本身不丢人,套装就是这么来的。但它带来三个具体后果,读者最好在翻开第一页之前就知道。
第一,它的目录自己缺了一块。翻到中间你会看到:第五部分之后是"第一部分 OpenClaw 极速入门",然后是"第三部分 OpenClaw 流量变现",再是"第四部分 OpenClaw 实战进阶"。中间那个"第二部分"的标题整段不见了,只剩一个"第3章"。同一页的编号也在跳:第2章之后直接是第3章,序号从 7 跳到 9,第 8 条不存在。
这不是排版手滑,这是把九个文件拼起来的时候,没有人从头到尾数一遍。一本要教人"搭建系统"的书,自己的目录是断的——这个反差很有说服力,也很说明问题:它验证流程的严格程度,和它要求读者达到的严格程度,不在一个水平线上。
第二,术语在九册之间来回换。同一个东西,有的册叫"智能体",有的叫"AI 数字员工",有的叫"Agent",第 8 章又回到"多智能体电商运营团队"。你想按索引找"知识库"怎么做,会发现分散在第 5 章、第 8 章、第九册第 1 章,说法还不一样。套装书最大的成本不是钱,是读者要在脑子里自己做一次术语对齐。
第三,至少有一册是能单买的。《AI Agent开发实战:从基础原理到企业级应用》这本书我有单独的一本,两周前刚逐页读完,ID 还在我的阅读记录里。也就是说,这个"九册"里的内容,有一部分是已经流通过的旧书重新装进了一个新盒子。对平台来说是打包,对读者来说是重复付费。买套装前先查一下每册是不是都单独卖过,这是最省钱的一步。
二、它最像真的地方:一张排班表
全书我认为最值钱的一段,不在任何"架构图"里,而在一张按时间排的表上。它写的是"数字员工的一天",我把它抄下来:
下午2:00——客户跟进提醒。数字员工检查CRM系统,发现有3个客户超过7天没有跟进,有1个客户今天生日,有2个报价单即将到期。它会自动生成跟进建议(基于客户历史记录),发送提醒消息给销售负责人,准备客户资料卡片(包含关键信息),在日历中创建跟进日程。
下午4:00——知识库问答。新员工在飞书中@数字员工:"咱们公司的报销流程是什么?"数字员工自动做如下工作:在飞书知识库中搜索"报销",找到《财务报销制度》文档,提取关键流程和注意事项,用自然语言回答新员工的问题,附上原文文档链接和报销表单。
晚上8:00——数据报表自动生成。数字员工开始准备日报:从各业务系统中获取当日数据,分析关键指标(销售额、订单量、客户数等),对比历史数据识别异常和趋势,生成可视化报表(图表+文字说明),发送至数据看板群,并@数据分析师。
为什么我说这张表比全书所有的架构图都值钱?因为它不是按"AI 能干什么"来分类的,是按"人一天里在哪儿被打断"来分类的。
这个顺序看起来是小事,其实是两套完全不同的思路。按功能分类,你会得到一个能力清单:能写邮件、能做表、能查资料、能发消息——然后你不知道从哪下手,因为每一条都"可以",每一条都不紧急。按时间分类,你会得到四个具体的卡点:下午两点我在翻 CRM 想不起来该跟谁,下午四点在群里重复回答报销流程,晚上八点在手工拼日报。卡点是有重量的,它自己会告诉你先做哪个。
所以自动化一个岗位的正确起点,不是问"AI 能干什么",而是拿一张纸,从早上八点记到晚上八点,把每一次"我被打断了"记下来。记满一周,你会得到五到七个点;这五到七个点里,重复次数最多的那个,就是你的第一个数字员工。这套书没有把这个方法明确写成方法论,但它在第 30 屏无意中示范了一次——这比它后面所有的"三步搭建"都更像经验。
第二个细节是那句"附上原文文档链接和报销表单"。这五个字是整段里最专业的。企业内部的问答机器人,最常见的死法不是答错,是答对了但没人敢用——因为没法核查。一旦附上原文链接,答案就从一个"结论"变成了一条"线索",用户可以自己去看一眼原文。可核查,是内部工具能不能活过三个月的分界线。
第三个细节在客服那一节。它做了个对比,我按原样抄:
机械的回答可能是:"我们的产品在功能A、功能B、功能C上有优势,具体参数如下……" 金牌销冠会怎么回答?"您问得很好,××确实是我们的主要竞品。说实话,他们的价格确实比我们便宜一些,但用过一段时间后,很多客户还是会选择我们。为什么?因为他们的售后响应比较慢,上次有个客户设备出了问题,等他们的工程师等了三天;我们用远程诊断,两小时就解决了。您说,省那点钱,值不值当冒这个风险?"
这段的价值不在"AI 客服",在于它指出了知识库该存什么。多数公司建知识库,存的是产品参数、价格表、FAQ;而销冠那段话里,真正起作用的是三样东西:承认对手的优势(真实性)、给一个具体到"三天 vs 两小时"的对比(可验证)、最后一个反问把决定权交回去(不逼单)。这三样都不是事实,是结构。
由此可以得出一条很实用的规矩:知识库里最该被录进去的,不是"客户问什么",是"客户最难缠的三个问题,我们最好的那个人是怎么答的"。前者能靠爬 FAQ 得到,后者只能靠访谈。而这本书在这个点上点到了,却没有继续往下走——它没有告诉你"怎么把销冠的话录成可复用的结构",只给了效果,没给工序。这是它全书的一个通病,我在最后一节会说。
三、从第三页起,它开始编命令
第 230 屏,它给了这样一段,标题是"场景一:批量提取":
openclaw batch extract \
--input "/path/to/竞品分析报告/*.pdf" \
--prompt "提取这份报告的核心观点、主要结论和关键数据" \
--output summary.csv \
--format csv
下面配了一张表 5-2,是"报告提取结果示例":三行竞品报告,每行给出文件名、核心观点、主要结论、关键数据,比如"产品定位高端市场 / 建议差异化竞争 / 市场份额15%"。再往后一屏是"场景二:自动归纳",命令换成 openclaw batch summarize,参数多了个 --model deepseek,输出换成 outlook.md。
我得说清楚:这段是我的实机对照,不是书里的内容。真实的 OpenClaw 命令行是运维向的——查状态的、诊断的、起停服务的那一类,没有 batch extract 这层子命令,也没有 --format csv 这种参数。照抄第一条,得到的第一句回话会是命令不存在。
但真正的问题不是"命令写错了"这么轻。写错命令只说明作者偷懒;这段命令背后那套产品模型是错的,才说明作者没装过。它假设 OpenClaw 是一个"带批处理管道的 CLI 工具":你给它一个通配符、一段提示词、一个输出格式,它就把一堆 PDF 变成一张 CSV。这是一台压缩机的模型——放进去的是原料,出来的是成品。
而实际的东西不是压缩机,是常驻的运行时:它有一份状态、一套权限、一堆工具、一个会自己决定下一步的执行器。你给它的不是"--input 通配符",是"任务 + 它能用的工具 + 边界"。它的不确定性不在"提取结果准不准",在"它可能不去提取,而是决定先去搜一下这些报告的作者是谁"。把一个有状态的执行器写成一条无状态的管道命令,是没跑过的人最容易犯的错——因为管道命令好写,好看,还能配一张整齐的结果表。
顺带还有两个技术细节,书里也没提,但照着做会疼:一是 "/path/to/*.pdf" 这种写法依赖 shell 自己展开通配符,Windows 的 cmd 不展开,PowerShell 展开的规则又不一样;二是把中文、带引号的核心观点写进 CSV,列会错位,除非规定好转义和 BOM。这类细节不值钱,但它们恰好是"跑过"和"没跑过"的分界线。
我理解作者为什么这么写。批处理是最容易画成图、最容易写出整齐示例、也最像"数字员工"的场景:一堆文件进去,一张表出来,中间是 AI。可正是这种"太好画"的场景,最需要有人真的跑一遍再落笔。
四、四个模型厂商,说明九个人没开过会
把散落在九册里的模型名字捡起来,是这样的:
前言"通过阅读本书,你将收获"的第 4 条写的是"掌握 Kimi2.5、智谱GLM-5等最新大模型在复杂工作流中的联动应用";第 80 屏的邮件批处理代码里,调用的是 call_deepseek_api(prompt);第 230 屏的命令行里,参数是 --model deepseek;第 2200 屏表 9-2 的"节点参数配置"里,模型选的是"豆包 Function call 模型32K";第 500 屏做 PPT 用的是 Manus;到第 900 屏建工作流,又换成了扣子。
六个名字,四个厂商,五种接入方式。这不叫"多模型对比",这叫九个作者各写各的,中间没有人做过一次统一。
对读者的实际伤害是很具体的:你按前言的推荐去开通 Kimi 的额度、按第 1 章装好 OpenClaw,翻到第 9 章想复现那个"视频解析"工作流,发现表里要求的是豆包的 Function call 32K 模型。中间没有任何一处告诉你:为什么这里换模型,换了之后行为会差在哪,不换行不行。
我的判断是:模型选型在这类书里应该退成一张表,而不是散在正文里当卖点。一张表四列就够了——任务类型(长文抽取 / 结构化输出 / 工具调用 / 多轮对话)、上下文需要多长、要不要 function call、出问题时的降级方案。因为模型是半年一换的东西,表可以随时更新,正文不能。凡是把型号写进正文当"你将掌握"的,都是在给这本书装保质期;半年后读者翻开,会以为是这本书印错了。
更值得注意的是那个"32K"。表 9-2 里的节点叫"语句、错别字校验",任务是把一段视频文案的标题和内容做校对。这是一个典型的短上下文、高精度任务,用 32K 的模型不是不行,但书里没有一句解释为什么是 32K,也没有一句解释"如果文案超过 32K 会怎样"。参数被写成了规格,而不是被写成了权衡。读者学到的是"选 32K",而不是"先看你的输入有多长,再定上下文窗口"——后者才是能迁移的知识。
五、代码清单:一张跑不通的清单
第 80 屏有一段批量生成邮件回复的代码,是全书代码里比较完整的一段。它的骨架是:先判断这封邮件重要不重要,重要的走"个性化生成",普通的走"模板匹配",最后给一个 needs_approval 标记。核心几行是:
if email['priority'] in ['紧急', '重要']:
reply = generate_reply(email['content'], tone='professional')
else:
reply = match_template(email['content'])
…
'needs_approval': email['priority'] == '紧急'
上面还有个 response = call_deepseek_api(prompt)。三个问题,都很硬:
一,call_deepseek_api 全书没有定义。它长什么样、要几个参数、返回的是字符串还是对象,都没有。它是这段代码的地基,而地基是一句"你自己想"。
二,generate_reply 和 call_deepseek_api 混用。前者收 content + tone,后者收一个拼好的 prompt。两套抽象在同一段里并存,说明这段是从两个不同来源粘起来的——一个是要"内容+语气"的封装,一个是要"整段提示词"的裸调。
三,match_template 没有实现,也没说模板长什么样。而"模板匹配"恰恰是这件事里最难的部分:用什么匹配?关键词?向量?谁维护模板库?匹配错了怎么办?一句话带过。
但这段代码有一样东西是对的,而且是对的很少见:那句注释——"重要客户的邮件,AI 生成回复后必须人工确认,避免出错"。它把"错了谁兜"写进了流程,而不是写在"注意事项"里。这是全书唯一一处把人的位置画进流程图的地方,比它所有的"人机协同"章节都实在。
可惜落地只有一个布尔值。needs_approval 等于真,然后呢?谁审?审多久?超时了发不发?改过的回复要不要回流成模板?这些都没有。把可靠性写成一个字段,是这类书最常见的自我安慰——好像打个标记,责任就转移了。
还有一个逻辑缝:判断用 in ['紧急', '重要'],标记用 == '紧急'。这意味着"重要"的邮件会走生成、但不进审批队列。这个设计可能是故意的(重要的要快,紧急的要稳),也可能只是随手写的。书里没有一个字解释,而这一处解释,恰恰是这段代码唯一有经验含量的地方。
六、两处不能原谅的错
这两处我单独拎出来,因为它们不是"深度不够",是"没有回读"。
第一处,第 2200 屏,表 9-2 里那个错别字校验的示例。那一段提示词写得挺完整,六条要求:仔细阅读标题和内容、检查每个句子、识别并纠正错别字(如同音字、形近字等常见错误)、优化语句表达、确保标题与内容的逻辑关系、保持原文风格。然后在"5.示例"里,它给了:
原文标题:"最新科技:探索宇宙的新方法"
校验后标题:"最新科技:探素宇宙的新方法"(将"探索"替换为"探素")
它把"探索"改成了"探素"。把对的改成了错的,还郑重其事地写在括号里当成范例。
这不是排版事故。这一段提示词明确要求"识别并纠正错别字,如同音字、形近字等常见错误",而"探素"恰好就是一个形近字错误——一个用来校对错别字的示例,自己带着一个错别字,并且以"已修正"的姿态呈现。唯一合理的解释是:这段示例是凭想象写的,写完之后没有人回头读一遍。读一遍就会发现,因为"探素"这两个字根本不成词。
我把这件事看得很重,是因为它暴露了一个可推广的判据:检验一本实操书,不要看它讲得对不对,看它有没有回读自己的例子。回读是成本最低的质检动作,一个连这儿都省掉的作者,别的地方大概率也省了。
第二处,第 1600 屏,Plan-and-Execute 的执行日志。先看调用(代码清单 3-28):
agent.run("在北京,1000 元人民币能买几束玫瑰?请使用中文进行推理")
再看紧接着的执行日志(清单 3-29):
steps=(Step(value='查找上海的人口数量 '), Step(value='查找北京的人口数量 '), …)
Action: {"action": "Search", "action_input": "上海的人口数量"}
Observation: … 上海市 2024 年常住人口 2487.45 万 …
问题问的是"1000 元能买几束玫瑰",计划里查的是"上海的人口数量""北京的人口数量",观察结果里还落到了 2487.45 万这个具体数字。三样东西互不相干。
这说明什么?说明日志是从另一个例子里搬过来的,调用和日志之间没有因果关系。而 Plan-and-Execute 这个模式最值钱的地方,恰恰就是"计划能不能对上问题"——它的全部意义在于把一个大问题拆成可执行的小步,所以评价它只有一个标准:拆出来的步骤,是不是真的在解那个问题。书里给出的唯一示例,步骤就没对上问题。
后果不是"读者少学了一点",是"读者学到了错的东西":他会以为只要 steps 列表长得像样子、Observation 里有个具体数字,就算跑通了。这恰恰是目前最多人踩的坑——不是不会搭,是搭完之后不知道什么叫"搭对了"。而一本教人搭的书,在这个最关键处给了一个对不上的样例,等于把"看起来像"当成了"跑通了"的示范。
两处错误放在一起看,有个共同的形状:它们都是"演示性正确"——格式对、语气对、位置对,只有内容不对。而内容不对这件事,只要回读一次就能发现。所以这不是能力问题,是工序问题:这套书的工序里,缺了"最后回头看一眼"这一道。
图文对照:九册的关键判断,压成一张图
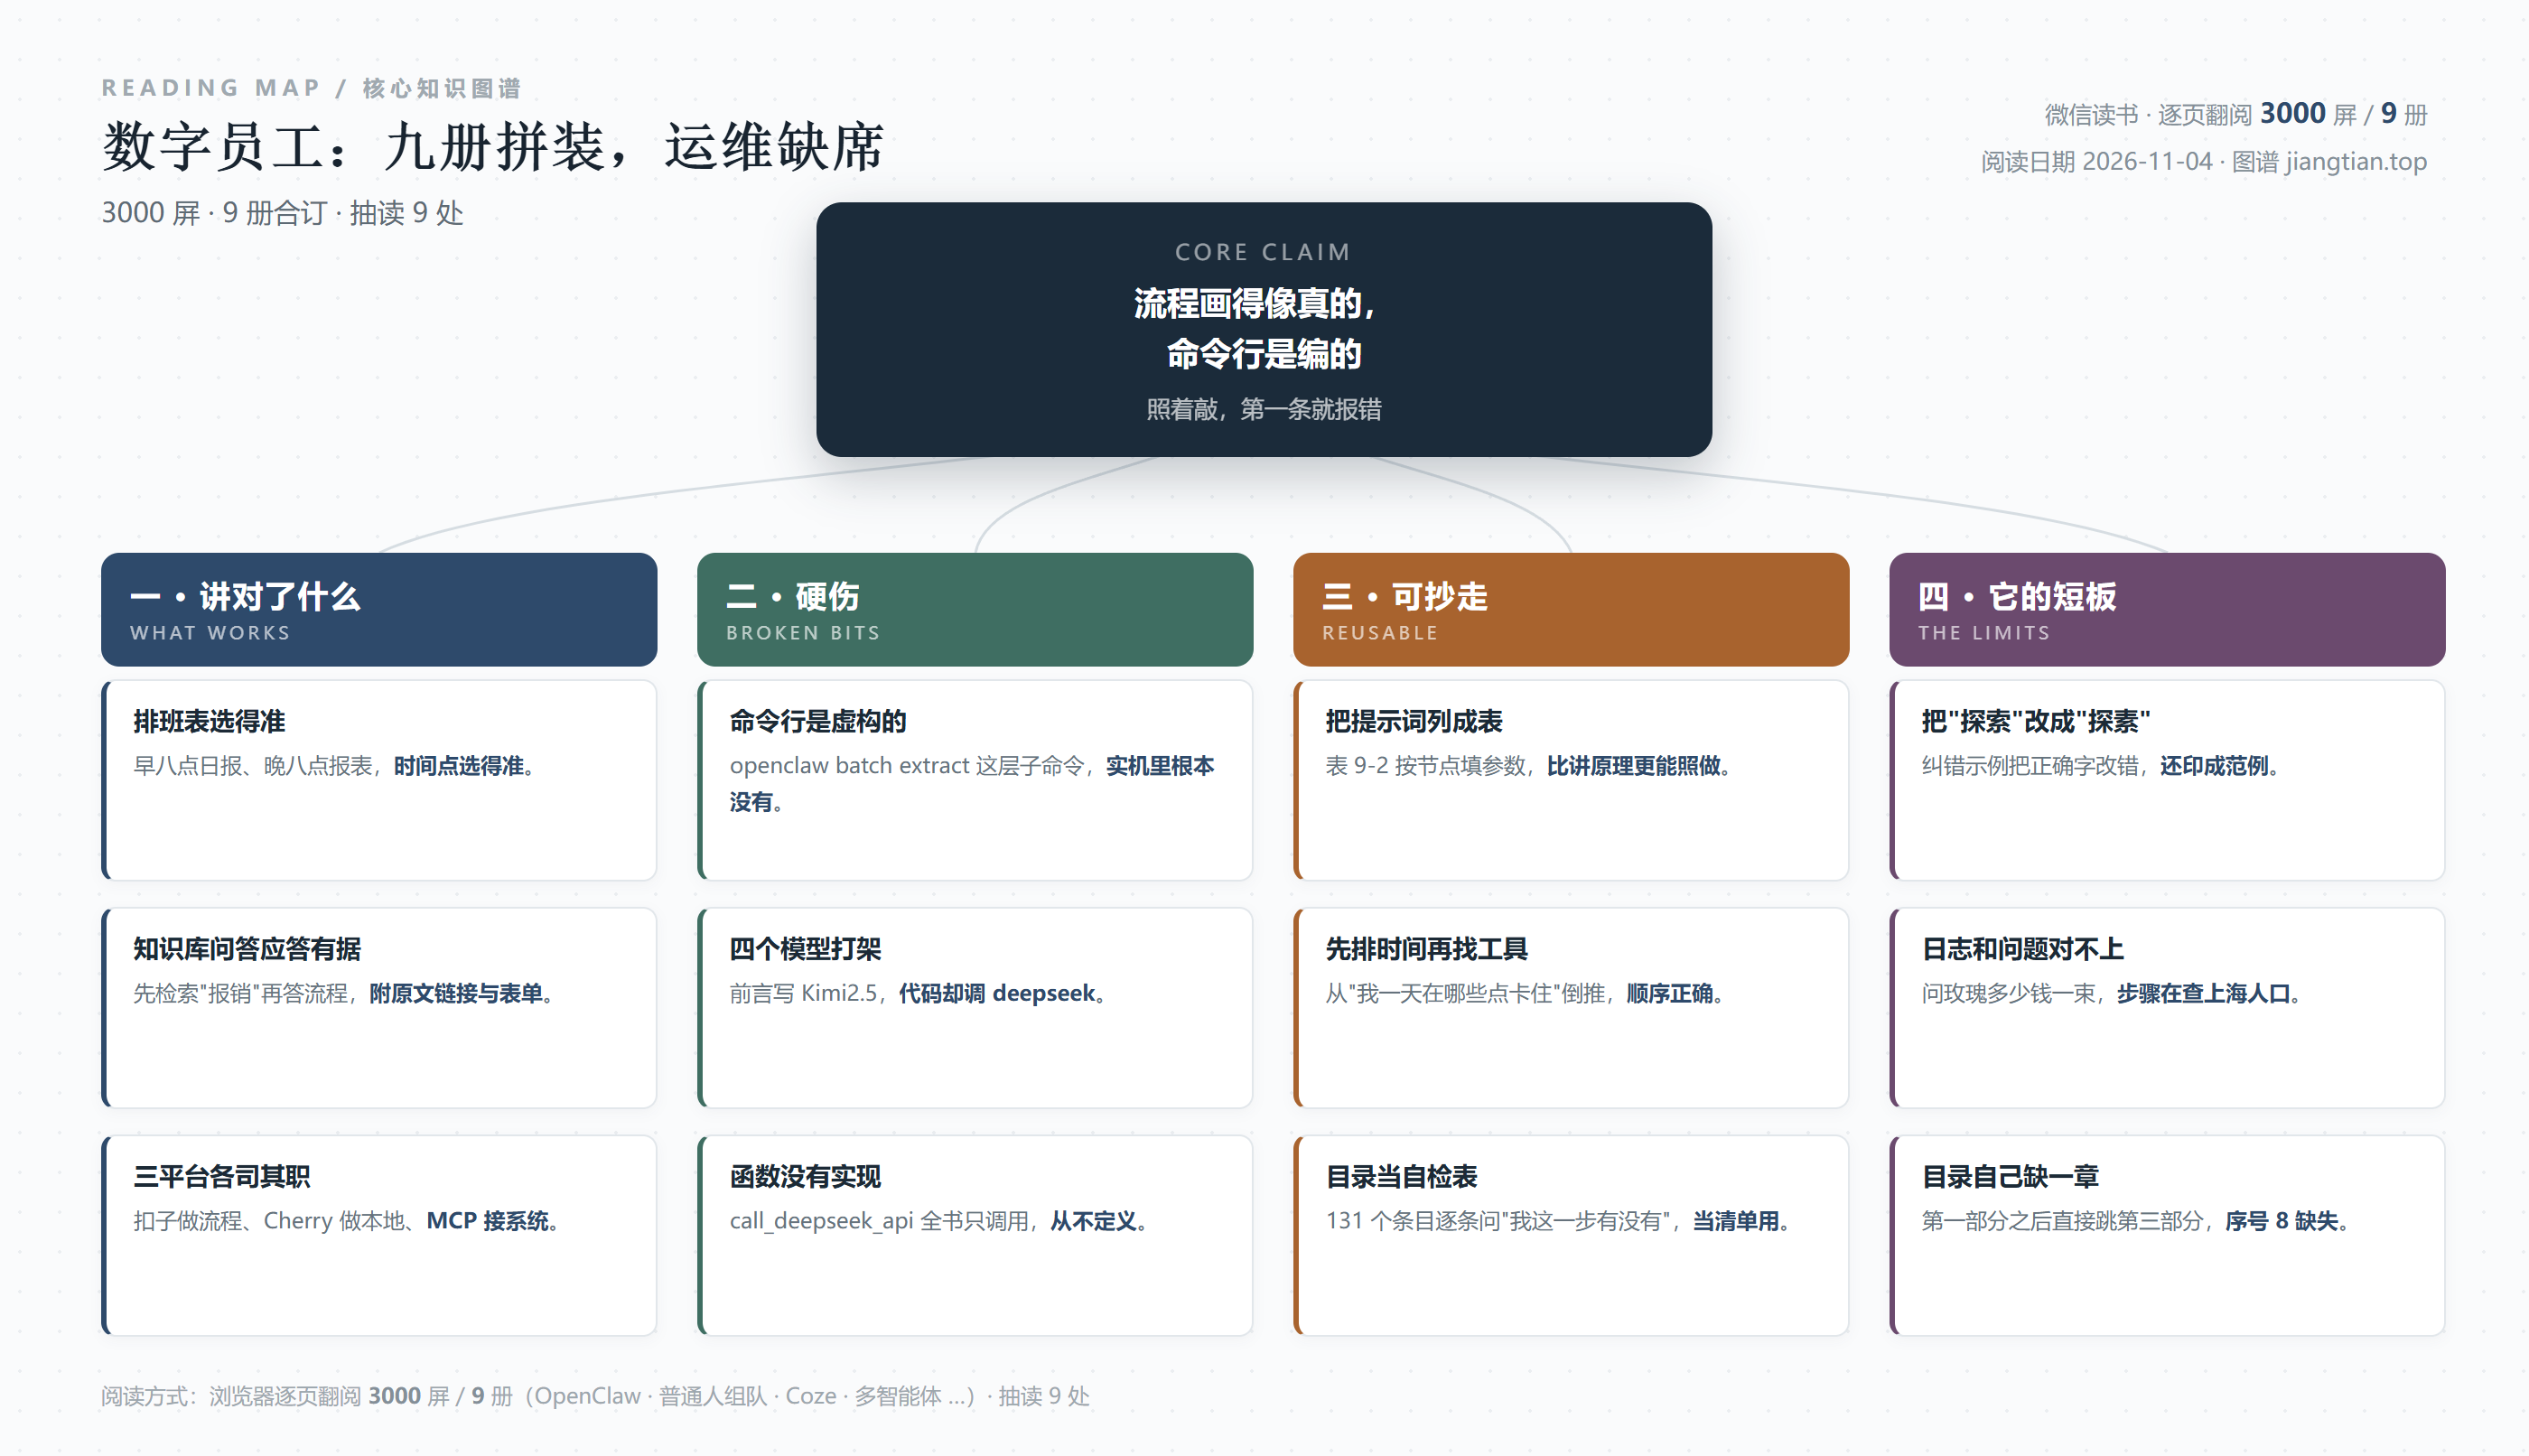
七、它的短板
老实写,五条。
一、把"装"当"用"。3000 屏里,讲注册、讲界面、讲点哪个按钮的篇幅,远超讲失败处理的篇幅。整套书几乎没写"跑了一周之后坏了怎么办":登录态过期怎么办、模型限流怎么办、任务被重复执行两次怎么办、费用突然涨了十倍怎么办。这四个是我自己实际遇到过的四个,书里一个都没有。而真实使用中,第二周开始全是这些事。安装是入门,运维才是日常;这套书把入门写得很厚,把日常写成了零。
二、九个人,一个名义。术语不统一(智能体 / 代理 / AI 数字员工 / Agent 混着用),平台跳跃(OpenClaw → Manus → Cherry → 扣子 → AutoGen → GPT Store → 智谱),册与册之间没有交叉引用,也没有一条"先读哪本"的路径。你买的是一个盒子,读的却是九条互不相通的线。套装书应该提供的恰恰是"把它们串起来"的那一层,而这一层是缺的。
三、它把"老板思维"当成了结论。第 9 章叫"一人公司架构师:从小白到 AI 军团指挥官",通篇是"你指挥一支 AI 军团",从单点突破到系统搭建。听着很提气,但没有一句讲预算怎么定、合规怎么过、数据能不能出境、员工抵触怎么处理。一个人指挥军团的真正难点不在指挥,在于出事的时候只有你一个人担责。而这套书对这个"一个人担责"的时刻,保持了沉默。它更像一份招商材料,不像一份经营手册。
四、案例的可信度极不均匀。排班表那种"描述性案例"很真实,因为它写的是被打断的时刻,这种东西编不出来;命令和日志那种"可执行案例"错误率很高,因为编起来最省事。所以我给一个可操作的读法:看它给的是画面还是命令。给画面的可以信,给命令的自己跑一遍再信。
五、它给自己装了保质期。Kimi2.5、GLM-5、Seedance 2.0、豆包 32K,这些型号被写进前言当卖点。型号是最短命的东西,写进书里那天就开始过期。半年后读者翻开,会分不清是书印错了,还是自己记错了。一本讲"自动化"的书,自己最不自动化——它没法更新。
公平地说,它有几个地方是超预期的:那张排班表、销冠话术的对比、"附原文链接"这五个字、以及"重要邮件必须人工确认"这个约束。这四处都有一个共同点——它们讲的都是"人的位置",不是"AI 的能力"。这套书凡是写人的地方,就写得对;凡是写工具的地方,就开始编。这个规律本身,比书里任何一条结论都更值得记下来。
八、一句话
如果只带走一样东西,带走那张排班表:早上八点的日报、下午两点的客户跟进、下午四点的知识库问答、晚上八点的数据报表。
把它抄成自己的四行日程,比抄任何一段代码都有用。因为代码会过期,而你每天被打断的那四个时刻不会。
这套书最合适的用法不是"读完",是当目录用:131 个条目,一条一条问自己"我这一步现在是谁在做"。答"我在做"的,是候选;答"没人做"的,是你的第一个数字员工;答"我也不知道谁在做"的,那才是真问题。
至于那些命令行,记住一句就够:一本书如果连 hello world 都没跑过,它写的部署章节就只是排版。
阅读记录:《Agent智造营·人人都能搭建AI数字员工(套装共9册)》· 微信读书逐页翻阅 3000 屏 · 九册合订 · 抽读 9 处逐页核对 · 笔记写于 2026-11-04
发表评论: