
驾驭ChatGPT:学会使用提示词:三招管用,其余停在 2023 年 5 月
微信读书《驾驭ChatGPT:学会使用提示词》· 前言落款"Wenyuan 2023 年 5 月",致谢中提及电子工业出版社与编辑孙学瑛
逐页翻阅 273 屏 · 5 章 · 73 条目录 · 另附附录 A 四组工具 · 抓取章节序列首尾相接,无跳章 · 2026-11-05
说明:这本书我从第 1 屏翻到第 273 屏,末屏是参考文献。抽看了前言、2.1 的上下文对比、2.3 元提示词、2.4 角色扮演、3.1 写代码、3.10.2 模拟 Excel、3.11 AI 作画、4.1 思维链、4.2 工具调用、4.4.2 参数、4.5 LangChain、5.2 因果阶梯。涉及代码的判断,都以抽到的这几页原样为准。
先说结论:这本书里真正管用的东西只有三招,而这三招恰好都不依赖任何工具,所以三年半过去还站着;剩下的部分,包括全部代码和工具名,都停在 2023 年 5 月。
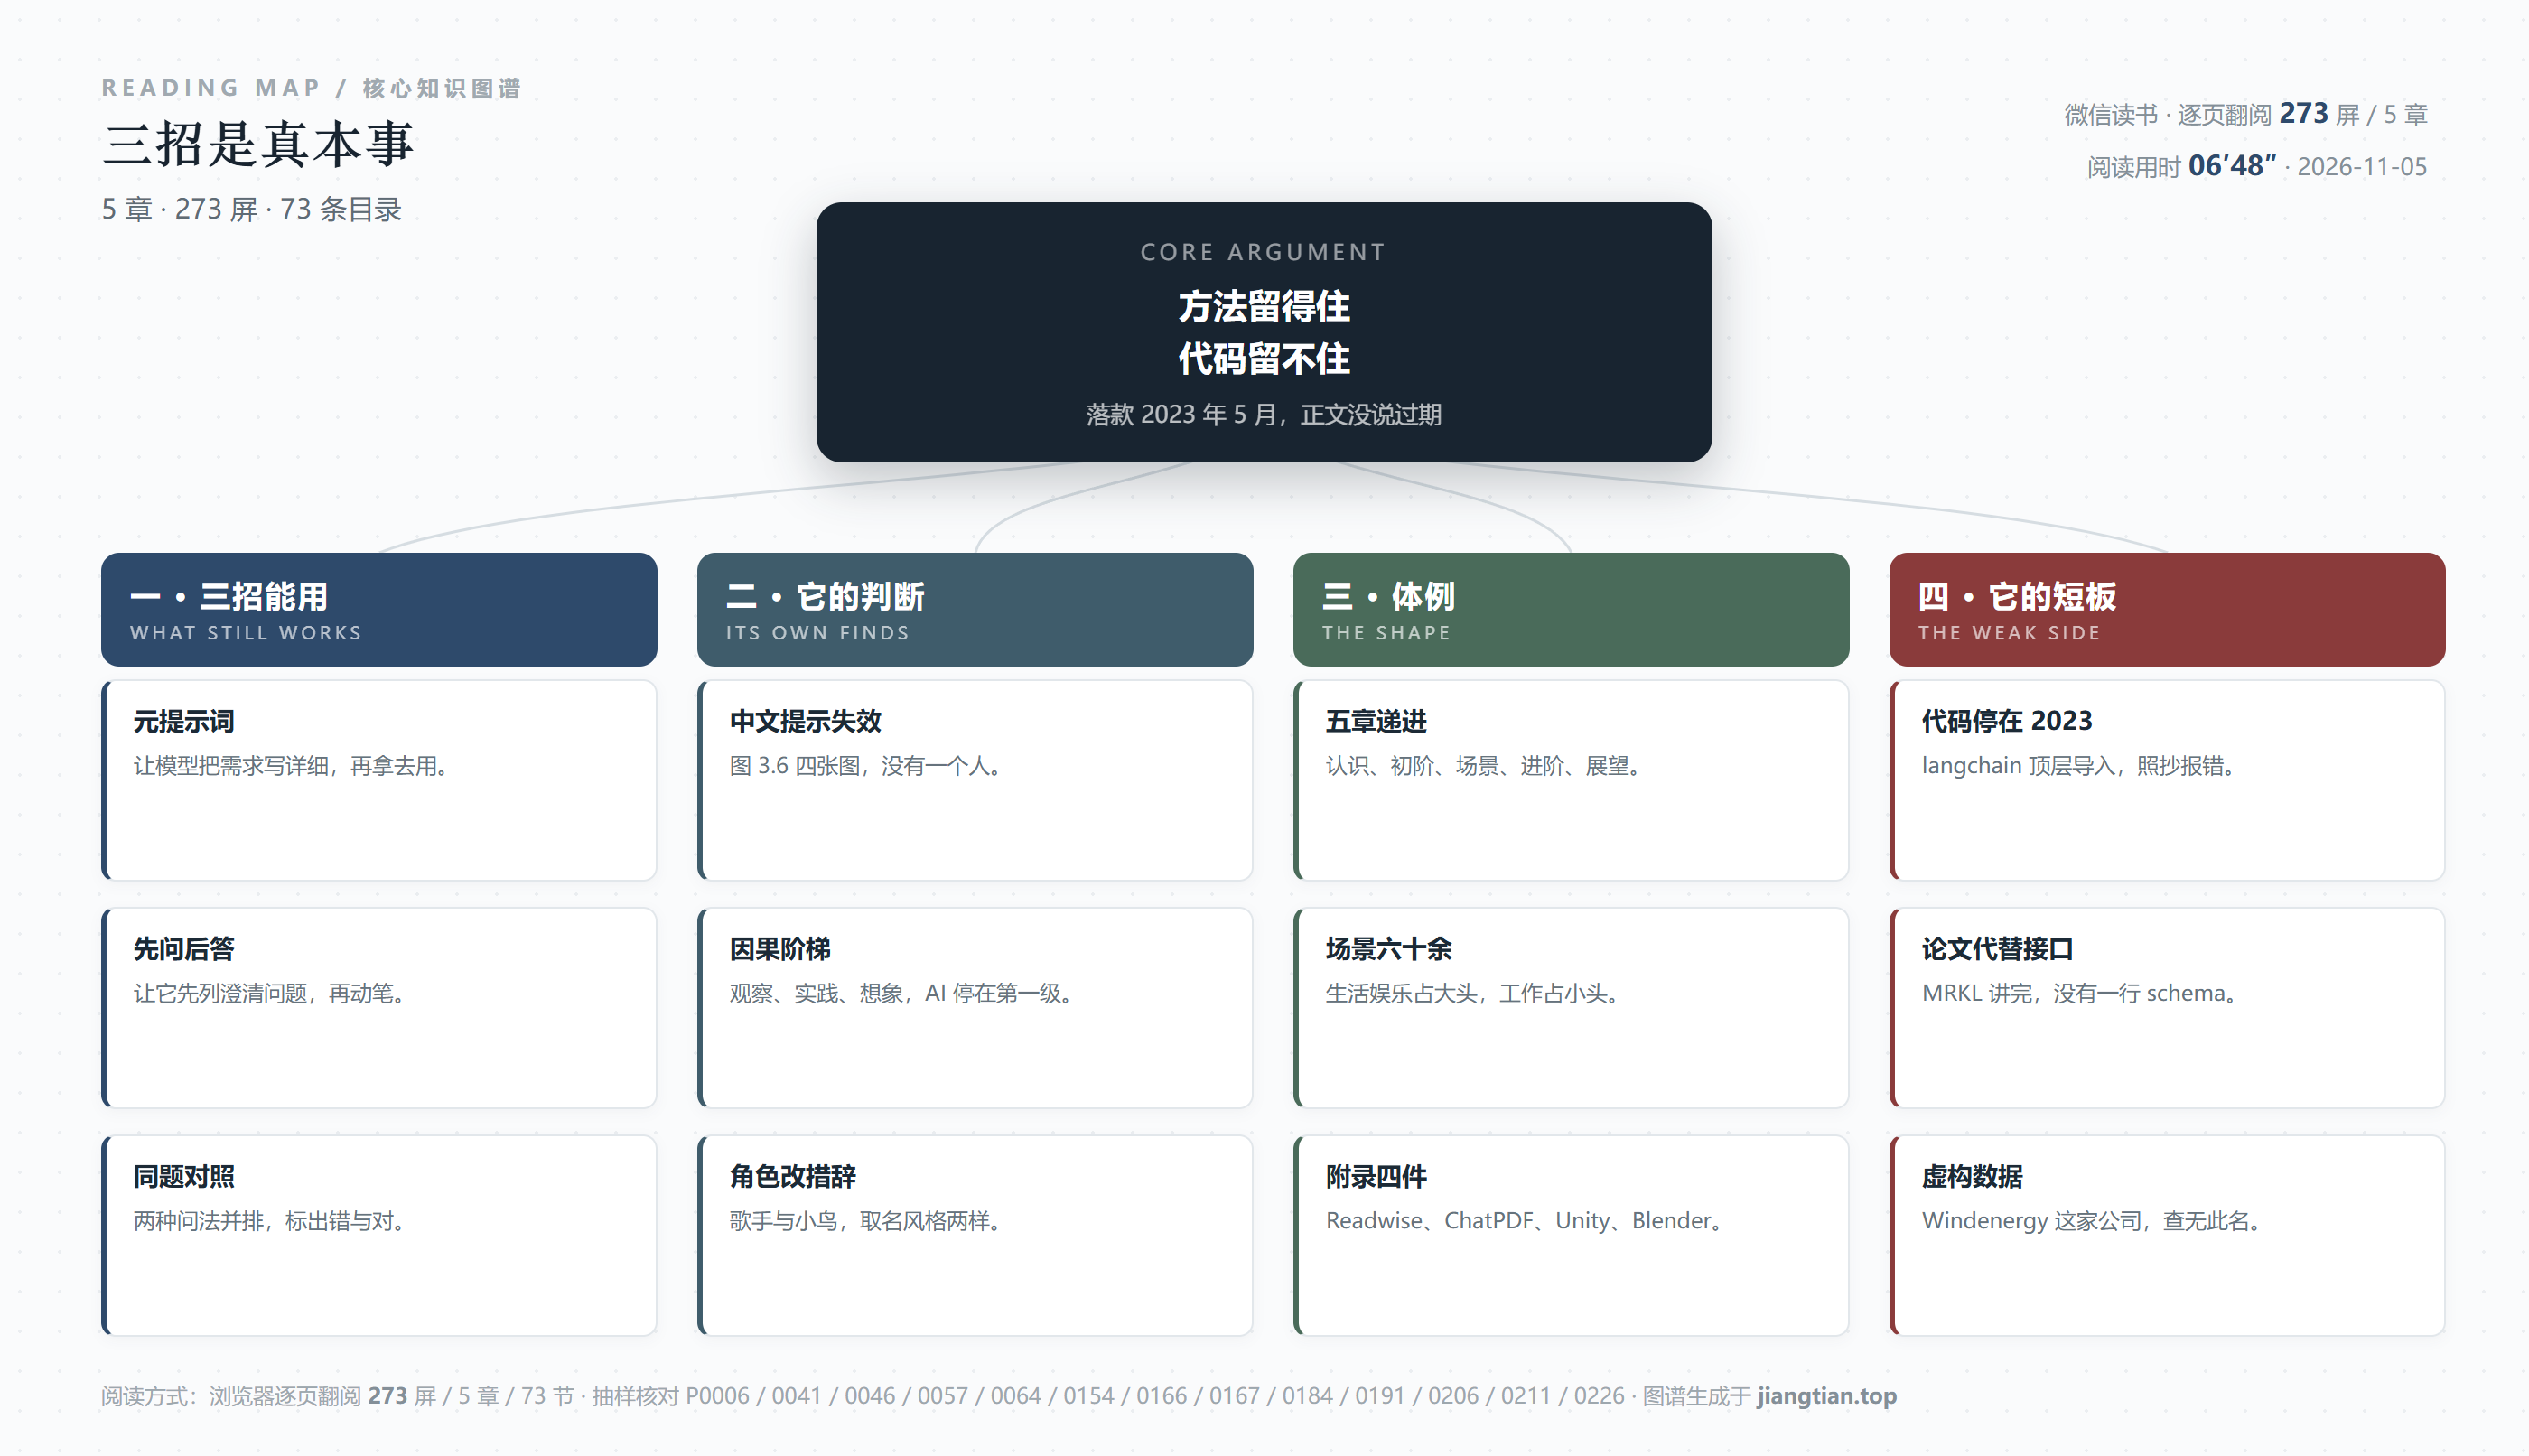
273 屏,5 章,73 条目录。第 1 章讲 ChatGPT 是什么,第 2 章讲提示词的基本功(上下文、元问题、元提示词、角色扮演、举例提示),第 3 章一口气铺了六十多个使用场景,第 4 章往深里走(思维链、工具调用、用提示词写应用、在程序里调用模型、LangChain),第 5 章谈影响与展望,最后挂一个附录。这个走法很清楚:先认识,再练基本功,再铺场景,再进技术,最后谈判断。
我在第 6 屏读到了一句让我停下来的话。前言末尾,作者写:"由于作者水平有限,以及人工智能技术的快速迭代,书中不足及错误之处在所难免,敬请各位读者给予批评指正。"落款是 2023 年 5 月。三年半之后的今天回头看,这句话成了全书最准确的一句——不是客套,是预言。
一、第 2 章的三对例子,把"清晰"讲透了,但也只讲透了"清晰"
2.1 节讲"上下文清晰",用的方法很朴素:一组模糊的问法,一组清晰的问法,摆在一起。我抄三对:
上下文清晰的问题:我是一个中年女性,我想减轻体重,但我对减肥方法并不很了解。你能给我一些建议,如何改变饮食和运动习惯来达到健康的体重?
上下文模糊的问题:哪些食物是健康的?
上下文清晰的问题:我是一个糖尿病患者,我需要控制血糖水平。你能给我一些建议,我应该吃哪些食物来保持健康的血糖水平?我应该避免哪些食物?
上下文模糊的问题:我应该怎样为孩子提供均衡的饮食?
这个方法本身值得肯定:不解释原理,直接给对照,读者一眼就能看出差别在哪——差别不在措辞,在"我是谁、我要什么"。模糊的问法把人抽掉了,模型只能给一份通用清单;清晰的问法把人放回去了,答案才会落到具体处境上。
但我要挑一处:这三对例子,补的全是"身份与目标",一处也没补"输出的形状"。要几条建议?每条多长?要不要给食谱?要不要标注热量?这些在真实使用里才是决定答案能不能用的东西。"清晰"只是及格线,"可用"才是一百分。这本书把及格线讲得很清楚,一百分的部分留给了第 3 章的六十多个场景——而那里,多数场景也没写形状。
不过作者在这一节末尾补了一句我很认同的话:"补充背景信息同样适用于修正 ChatGPT 的答案。只要具体指出答案的哪些地方不满意,ChatGPT 就可以修正。"这句话把"一次成稿"的幻觉打破了:提示词不是一次性的,是回合制的。很多教程到今天还在教人怎么"写出一条完美提示词",而这本书在第二节就说了,你可以不满意,然后说哪里不满意。这个思路是对的。
二、第一招:让模型替你把需求写清楚
2.3 节讲"元提示词",是全书我认为最值钱的一页。原文这么写:
还有一个更简单的方法,就是直接让 ChatGPT 详细描述这个需求:
问:详细描述一个将数据分组的函数。
答:这个将数据分组的函数可以将一个包含多个元素的列表或数据框按照某个特定的变量或条件进行分组,从而方便对每个组进行统计或其他操作。这个函数通常包含以下几个参数:……
用 ChatGPT 提出的问题,让 ChatGPT 做出回答,这被称为元提示词。
"元提示词"这个说法现在看有点旧,但里面那套动作一点没过时:你不知道该怎么问,就先让它把这个问题该怎么说讲一遍,然后拿它讲的那段话去问它。这是把一个模糊的需求,先翻译成一份结构化的规格说明,再拿这份规格去执行。
为什么这招管用?因为模型最擅长的恰恰是"把一句话展开成十句话"。人写需求时卡住的地方,从来不是不知道自己要什么,是不知道怎么把"我要一个能分组的东西"说成"输入是什么、输出是什么、边界在哪"。这件事让模型做,比人自己做快得多,而且它列出来的维度往往比你想的全。
这招有个副作用,书里没提:模型展开的规格,会带着它自己的偏好。你让它描述"一个分组的函数",它会按 Python 的 pandas 思路写,默认参数里全是 dropna、sort 这类它见过的选择。你照着这份规格去实现,等于把它的默认值当成了自己的需求。正确用法是拿它当草稿,逐条删改——它给十个维度,你留六个,剩下的四个才是你的项目真正在意的。
三、第二招:先让它提问,再让它回答
3.1 节讲用 ChatGPT 写代码,示范的动作是这样的:用户提出要写一个"统计字符串中单词数量"的函数,并且先加一句"在编写函数之前,你有什么需要澄清的问题吗"。模型的回应是五个问题:
· 是否只包括由字母组成的字符序列,或者也包括由数字或其他特殊字符分隔的字符序列?
· 单词是否区分大小写?例如,"Hello"和"hello"是否算作两个不同的单词?
· 是否需要考虑多种语言的情况?不同语言中的单词分隔符可能不同。
· 是否有长度限制或性能要求?例如,输入字符串的长度是否可能非常大,需要考虑内存和时间复杂度等问题。
用户挑着答:"我只需要考虑字母、不区分大小写,只考虑英语,不考虑长度限制。"然后函数才写出来。
这个动作我给它最高分。它的价值不在"让 AI 更聪明",在"把人脑子里那些没说出口的假设逼到台面上"。任何一个写过需求文档的人都知道,最难的不是写清楚的部分,是那些"我以为你知道"的部分——大小写算不算、空字符串怎么办、emoji 里的字母算不算。让模型先问一遍,等于免费做了一次需求评审。
这招也有代价,书里同样没提:每一次澄清都要花 token,也要花你的注意力。五个问题里通常有两个是真问题,三个是凑数("是否需要考虑多种语言"对一个内部小工具就是废话)。真实用法是扫一眼,只答真问题,剩下的直接说"其余按常见做法"。不教这一句,读者会老老实实把五个问题全答一遍,然后发现对话已经拖了三轮,成本翻倍,产出没变。
把第一招和第二招接起来,就成了一条我常用的固定工序,成本不到两分钟:先让模型"用十行以内写清这个需求要包含哪些要素",再让它"针对这份要素表,列出你还必须问我哪三个问题",我答完,最后才让它动手。三步走完,第一次输出的可用率明显高于直接提需求。这套工序这本书没写,但它的 2.3 和 3.1 两节恰好是这套工序的两半——它把零件给了,装配图没给。
四、第三招:它自己做出了一组对照实验
3.11 节讲 AI 作画。这一节里有一组我认为是全书最好的实验,作者无意间做对了一件很多教程到今天都没做的事——同一个意思,两种语言,两张图,摆在一起。
先是用中文:
/imagine prompt: 史蒂芬·乔布斯在喝茶
四张图里,全是茶壶、茶叶罐、抹茶、瓶子,一个人都没有。
然后是用英文,同一句话的直译:
/imagine prompt: Steve Jobs is drinking tea
四张图里出现了人,其中一张明显是照着乔布斯画的,端着杯子,旁边还摆了个苹果。作者的总结是:"可以看出有不同风格的乔布斯在喝茶,但每幅小图中的人物画像与真人还有差异,不过已经能看出有点像相。"
这个发现,放在 2023 年 5 月,是相当靠前的。当时主流的说法还是"提示词要写得诗意""要多加形容词",而这本书记录了一个更朴素的事实:模型对语言的支持是不均匀的,你用它不熟的语言问,它会给一个看起来像答案的东西——四张茶壶,主题是对的(茶),主体是丢的(乔布斯)。
但我要在这里停一下,说两处它没走完的路。
第一处:结论停在了"用英文更好",没给规则。真正可复用的规则是分层的——主体名用英文(人名、地名、品牌名,模型的英文语料密度高一个量级),风格与媒介词用英文(flat illustration、risograph、editorial),构图与叙述可以用中文想(因为那是你自己的思维)。这三层分开写,比笼统说"用英文"有用得多。书里没分。
第二处:它把版本行为写成了普遍规律。四张茶壶不是"中文不行",是"2023 年 5 月这个版本的跨语言对齐不行"。两年之后,主流模型处理中文提示词的差距已经小到大多数场景看不出来。这本书没有一句"以下现象基于某年某月的某版本",读者会把一条版本注记当成永久真理,然后在一个已经不成立的前提上做决策。写工具书最该有的自觉,是把自己的观察标上保质期。
还有一个小地方,我看了两遍。英文那组四张图,真正能认出是乔布斯的只有一张,另外三张是"长发男人在喝茶"。作者写"已经能看出有点像相"——这是典型的自我宽容评分:四中一,被写成了"有点"。如果把这张图交给一个不认识乔布斯的读者,他一眼认不出来。提示词实验的验收标准,应该定在"陌生人能不能认出来",不是"作者自己能不能对上号"。
这本书的骨架,一张图看完
五、代码与工具:全部停在 2023 年 5 月
从第 4 章开始,这本书的问题集中爆发。不是观点旧,是照着抄会报错。
先说 LangChain。4.5 节的示例是这么写的:
from langchain import PromptTemplate
prompt = PromptTemplate(
input_variables=["English", "requirement"],
template="将下列英文翻译成中文:{English},要求为{requirement}")
这段代码在 2023 年 5 月是对的。到了今天,PromptTemplate 已经搬到 langchain_core.prompts 下面,顶层那句 from langchain import PromptTemplate 在新版本里直接抛 ImportError;LangChain 1.x 更是把大量顶层导出清掉了。读者照着书敲,第一行就红。同一节讲的 Sequential Chain,也已经被 LCEL 的管道写法取代——现在写链是 prompt | model | parser,不是 Chain 类。
再说 token。4.4.2 节讲大语言模型的参数,用 tiktoken 演示:
import tiktoken
encoding = tiktoken.get_encoding("cl100k_base")
encoding.encode("tiktoken is great!")
cl100k_base 是 GPT-3.5 与 GPT-4 那一代的编码。现在的主流模型早就换成了更大的词表,中文的切分方式也跟着变了。用旧编码估算新模型的 token,误差可以有二三成——按这个误差去做上下文预算,算出来的"还能塞多少字"是假的。
接着说工具调用。4.2 节整节讲两样东西:MRKL 系统和 Toolformer。MRKL 讲得很清楚——让模型判断一句话里哪些部分要调外部接口,然后分别去查。示例是一个好问题:"哪家绿色能源公司上个月股价上涨最高?"模型的判断过程也对:公司名查 Wiki,涨幅查行情库,时间查日历。
但答案是:"上个月 Windenergy 和 Tinenergy 上涨超过了 12%。"
Windenergy 和 Tinenergy 这两家公司,查无此名。这是我自己最不能接受的一类示范:格式全对,逻辑全对,数据是编的。一本教人"怎么让模型去查数据库"的书,在自己的示例里没有查数据库,而是让模型编了两个公司名和两个涨幅。读者记下的是"它会调接口",实际上看到的是"它会编数据"。
更要紧的是,这一节讲了 MRKL(2022)和 Toolformer(2023 年初)两篇论文,一行可执行的接口定义都没有。今天做工具调用,核心是写一份 JSON schema:函数名、参数名、参数类型、必填与否、描述。这一节从头到尾没有出现 schema 这个词。讲了两个系统的名字,没给一个能跑的东西——这已经不是"过时",是"没落地"。
附录 A 也是同样的问题。四组工具:Readwise 读文章、OpenRead 和 ChatPDF 读论文报告、聊天机器人、以及在 Unity 与 Blender 里调 ChatGPT。每组只有一段话介绍它能干什么,没有价格、没有免费额度、没有是否还在维护。而这一整类"套壳工具"恰恰是三年里换得最快的一批——今天打开,有一半的入口已经改名、收费或者停服。把这类东西写进书里不是错,错在写的时候没加一句"以下工具随时可能变化,请以官网为准"。
六、六十多个场景,能带回工位的不多
第 3 章是全书篇幅最大的一章,从写代码、写文章、学英语、旅行计划、懒人菜谱、选礼物、医疗咨询,到模拟面试、下五子棋、文本游戏、画表情包、模拟女友、模拟名人、伪装 Linux 终端、秒变 Excel。我数了一下目录,六十余条。
配比是这样的:学习与写作约 20 屏,生活杂事约 25 屏,游戏与角色扮演约 20 屏,办公与代码约 15 屏。一本叫"学会使用提示词"的书,把最多的篇幅给了"怎么和 AI 玩"。
这个账可以算得更细。3.7"玩游戏"从第 122 屏到第 137 屏,十六屏,内容是下五子棋、文字冒险、画表情包;3.9"模拟人物"从第 143 屏到第 150 屏,八屏,内容是模拟女友、模拟名人。两节合起来二十四屏,占全书 8.8%;而 4.2 工具调用这样真正决定能不能落地的内容,只有五屏。页数不会撒谎,它只反映作者当时觉得什么重要。
这里面有两节是真有用的。3.10.2"秒变 Excel"用 markdown 表格模拟工作表,用户输入"D1=Sum(B)",模型把 B 列 2 到 20 累加成 110,表格结构保持完整。这个技巧现在看很土,但它演示了一件重要的事:模型的输出格式是可以被"情境"约束的——你说"你现在是 Excel",它就会吐出表格而不是散文。3.10.3"扮演 JavaScript 控制台"是同一个道理,用角色把输出格式锁死。
但这个技巧有个致命的前提,书里没写:它能算对,是因为这组数恰好简单。我把 B 列换成一组带小数的数,或者加一行空值,它很可能就开始编。这不是 Excel,这是"长得像 Excel 的文字"。教读者把模型当计算器用,等于在教一个会出错的习惯;正确的一句话是"格式可以用它摆,数必须自己核"。
剩下的部分,比如"模拟女友""模拟名人""下五子棋",作为演示当然可以,但它们不构成能力——它们只证明模型能扮演,不证明你会用。而真正难的那些场景:怎么让输出稳定在 500 字、怎么让它按固定 JSON 返回、怎么让它承认不知道、怎么在多轮之后不让它跑题——没有一个独立成节。
如果让我补一章,我只补四条,每条一页。
第一条是长度。不写"写一段介绍",写"不超过 120 字,超了就删形容词"。模型没有字数感,只有相对感,你得给它一个可数的上限,并且告诉它超了删什么。第二条是形状。所有要进表格、进系统、进代码的输出,都让它先吐一个空模板(表头、字段名),你确认模板对了,再让它填内容——先定形状再填肉,一次成功率比直接要结果高得多。
第三条是校验。凡是数字、日期、人名、链接,一律要求它标注来源或者明说"这是推测"。这条不是防它撒谎,是防你自己懒得核。第四条是弃权。给它一句"如果你不确定,直接说不确定,不要给我一个看起来像答案的东西"——这句话能把一大半的幻觉变成一句诚实的"我不知道",成本只有十几个字。
这四条,才是"学会使用提示词"这六个字真正指向的东西。它们不在书里,不是因为作者不知道,是因为 2023 年 5 月大家还在兴奋于"它居然能写诗",还没被它的胡说八道坑过足够多次。
七、它的短板
第一,全书唯一一次"给尺子",是在 4.1 的思维链。图 4.1 把同一道题用两种问法跑了一遍:普通提示词算出 27(错,标了叉),思维链提示词算出 9(对,标了勾),按 Kojima 等人的 zero-shot CoT,一句"Let's think step by step"就能启动推理。这是全书唯一一处 A/B 对照加对错标记,做得很规范。
问题是,这把尺子只用了一次。第 3 章六十多个场景,没有一个用了思维链,也没有一句交代"什么时候不该用"——简单任务走思维链会变啰嗦、变贵、还可能把简单题想复杂。给了工具不给适用边界,读者只会在所有地方都加一句"让我们一步步思考",然后发现回答变长了、准确率没变。
第二,5.2 给了全书最硬的一把尺,然后把它收起来了。这一节引 Judea Pearl 的因果阶梯:观察、实践、想象三级,结论是"现在人工智能或许只处在低级阶段:观察"。这是全书唯一一处从认识论层面下判断的地方,写得克制、有出处、有层次。
但紧接着 5.5 又回到了"用提示词拥抱 ChatGPT"的口号上。那把因果阶梯,在后面的提示词教学里一次也没被用来评估任何一条提示——它成了一段单独成立、与全书无关的漂亮话。这是教材常见的病:前面给了尺子,后面不量自己。
第三,三招散在三章,彼此不认。元提示词在 2.3,先问后答在 3.1,同题对照在 4.1,三个动作其实是同一件事的三个面——都是"让模型先输出结构,再输出内容"。如果把它们合成一章,这本书会薄三分之一,但硬一倍。现在的排法,读者读到 3.1 时早忘了 2.3,读到 4.1 时又把前两个都丢了。
第四,目录缺号。3.11 节下面直接从 3.11.2 开始,"AI 作画的关键技术",3.11.1 没有。这一条不需要读正文就能验证,但它说明目录这一层没经过一次完整通读——而目录恰恰是这类"工具书"最该做对的一页。
第五,没有一句保质期声明。全书四十几处截图、十几段代码、七八个工具名,全都默认"现在就是永久"。前言的作者已经写了"技术快速迭代",正文却一句没接。补这句话的成本是一行字:"本书示例基于 2023 年 5 月的版本,若界面或 API 与此不同,请以官方文档为准。"没有这一行,读者无法判断哪一页还能用,只能全部怀疑或者全部照抄——两种都危险。
也说两句公道话。元提示词、先问后答、中英对照这三招,是真本事,而且都不依赖任何工具,今天照样能用;2.4 里作者自己指出"后两个名字过于生硬地挪用了'好奇心'和'小鸟'的意思",这种自我批评在同类的书里很少见;5.2 引因果阶梯那一节,是全书唯一有理论骨架的地方。这四处撑住了它的价值。
最后交代边界:我的判断建立在 73 条目录全过目、十余页正文抽查之上。目录层面(缺号、章节配比)是完整的;代码层面(哪些写法会报错)是我按当前主流版本核对的,我只对抽到的那几段负责。
八、一句话
如果你只带走一句:提示词的方法会留下,工具的名字会过期,而这两件事在这本书里被印成了同一个厚度。
这不是一本该被扔掉的书。它值得读的是前三章的三个动作,加起来不到三十屏;第 4 章之后,请当成一份 2023 年的历史档案来看——它记录了那个阶段大家在怎么和模型说话,也记录了当时的模型在哪里露怯(四张茶壶)。一份诚实的档案,比一份假装新鲜的教程有用。前提是,你得知道它是档案。
阅读记录:《驾驭ChatGPT:学会使用提示词》,微信读书网页版逐页翻阅 273 屏 / 5 章 / 73 条目录(另附附录 A),2026-11-05。抓取章节序列 73 段与目录 73 条一一对应,无跳章,末屏为参考文献。
抽样页:p0006(前言末页,落款 2023 年 5 月)、p0041(2.1 上下文清晰与模糊三组对照)、p0046(2.3 元提示词与"详细描述一个将数据分组的函数")、p0057(2.4 歌手与小鸟两版取名)、p0064(3.1 编写函数前的五个澄清问题)、p0154(3.10.2 markdown 表格与 D1=Sum(B))、p0166(图3.6 中文提示词的四张图)、p0167(图3.7 英文直译与作者评语)、p0184(图4.1 普通提示与思维链的对错对照)、p0191(4.2 MRKL 与 Toolformer)、p0206(4.4.2 tiktoken 与 cl100k_base)、p0211(4.5 LangChain PromptTemplate 与链)、p0226(5.2 因果阶梯三级)。
发表评论: