
《ChatGPT使用指南》:84 条目录里,能照着做的不到十节
微信读书《ChatGPT使用指南:人人都应该掌握的AI最强工具》· 作者与出版时间未出现在抽样页内(版权信息、序、引言、序言四块只有六屏)
逐页翻阅 264 屏 · 6 章 · 84 条目录 · 章节序列首尾相接,无跳章 · 2026-11-05
说明:这本书我从第 1 屏翻到第 264 屏,最后一屏是 6.8 节的收尾,没有"已读完"页可对。抽看了引言、1.7 的判断段、2.9 的场景罗列、5.12 的表格抽取、5.15 的终端命令、第 6 章的编号与调教三段。
先说结论:这本书的价值不在它写了八十四条场景,而在它偶尔漏出来的那几句"这活儿它干不好"。
264 屏,6 章,84 条目录。章名很直白:快速入门、学习篇、工作篇、娱乐篇、代码篇、调教。前三章铺场景,第五章讲代码,第六章讲怎么把模型调成你要的样子。
我把这 84 条目录从头看到尾,也在正文里抽查了若干节。整体判断是:它是一本"目录型"的书——目录写得比正文好,标题比方法多。这不是贬义。一本 2023 年前后出的 ChatGPT 入门书,读者的真实需求是"这玩意儿能干什么",而它确实把能干的活儿列全了。问题在于,读者列完自己的需求之后,翻到对应那一节,往往只能看到"它可以帮你做这件事"这句话,看不到"具体怎么让它做"。
一、骨架很老实:六章排下来,是一条完整的学习路径
六章的排法我认可。第 1 章解决"这是什么、跟我有什么关系",第 2 到 4 章按场景分(学习、工作、娱乐),第 5 章单拉代码,第 6 章讲调教。前三章是"能用它做什么",第五章是"能拿它改什么",第六章是"能把它变成什么"。这个顺序对新手是友好的:先用起来,再往深处走。
第 1 章里有两节值得单独说。1.3 节问"ChatGPT 与 Siri、小爱同学有什么不同",1.7 节问"为什么有人觉得 ChatGPT 也就那样"。这两节的位置放得聪明,因为新手最常见的两种反应恰恰是这两个:一种是觉得神乎其神,一种是试了两下觉得不过尔尔。作者没有回避第二种,而是正面去答——这一点比大多数同类书强,多数书的做法是把"不过尔尔"那批读者当成不会用。
但骨架老实,不代表砌得整齐。第 3 章工作篇 12 节,从自动化营销、客服自动回复、生成面试题目,一路排到产品取名、广告设计、菜品开发、商家评论自动生成、装修设计、做 PPT、视频文案、和 ChatGPT 一起创业。第 4 章娱乐篇 9 节,从让你的 Siri 更智能、接入第三方输入法、让 Siri 帮忙记账,到 Iwhat 小应用、旅游规划、挖掘美食配方、日常医护知识、写情书、写歌词。
这两章的目录连起来看,有一种"把想到的都写上"的仓促感。"写情书"和"生成面试题目"各占一节,"调用 Stripe API"和"生成 SQL 语句"也各占一节——在这套编排里,它们的权重是一样的。这不是内容问题,是结构问题:一份目录如果不分层,读者就无法判断哪一节值得花时间。
第 2 章的分类也不够干净。12 节按"学习"归堆,里头有读文献、当读书书童、段落关键字提取、视频学习总结、头脑风暴、背单词、解数学题、画思维导图,这些都算学习,没问题;但"辅助育儿""阅读病历簿""科学预测与辅助"三条也塞在这儿,就有点勉强了。看化验单是家庭健康事务,不是学习;"科学预测"更是个筐,装什么都能算。分类一旦开始凑数,目录的检索功能就退化成了罗列。读者想找"帮我看懂体检报告",得先猜它被归在"学习篇"——这个猜的成本,就是分类没做好的代价。
二、但"应用场景"三个字,被写成了清单
2.9 节《教育行业学生咨询》是很典型的一节。它的写法是这样:
(1) 课程选择和规划。学生可以向 ChatGPT 咨询关于课程选择和学习规划的建议。例如,询问哪些课程适合他们的兴趣和职业目标……
(2) 学术资源推荐。ChatGPT 可以根据学生的需求和学术领域,推荐相关的书籍、论文、在线课程和其他学习资源。
(3) 解答学术问题。学生可以向 ChatGPT 提问关于课程内容、概念和技术的问题,虽然 ChatGPT 可能无法解答所有问题……
(4) 学术写作指导。ChatGPT 可以为学生提供关于论文写作、报告撰写和演讲准备等方面的建议……
(5) 考试准备和学习策略。ChatGPT 可以帮助学生制定有效的学习策略,如时间管理、复习方法和考试技巧等……
(6) 职业规划和发展。学生可以向 ChatGPT 咨询关于职业发展的建议,如实习机会、行业……
六条,每条两到三行,全是"可以向它咨询""它可以根据……推荐""它可以提供……建议"。通篇没有一句提示词,没有一个输出样例,没有一次失败情况。
这就是我说的"罗列体"。它的信息量看起来很大——六个方向都覆盖了——但读者拿走之后能做什么?只能知道"哦,这个也能问"。真正难的部分全被跳过了:问课程规划时,要不要先把自己的专业、绩点、目标行业交代清楚?它推荐的书单怎么验证真假?如果它推荐了一本不存在的书,怎么发现?
这三个问题里,第三个是最要命的。让模型推荐书单,是它最容易出错的场景之一:书名像真的、作者像真的、出版社像真的,只有那本书不存在。一个学生照着这份书单去图书馆找,找不到,再回来问,再被推荐一本不存在的——这个循环,书里一次都没提。
我不认为这是作者不知道。更可能是写作节奏的问题:84 条目录压在一本书里,平均每节不到 3 屏,能铺开写"提示词 + 输出 + 校验"的节数有限,于是大量节退化成了"能力清单"。但代价是这本书从"教程"变成了"索引":它能告诉你有什么,不能告诉你怎么做对。
拿 2.9 的第一条来示范一下,补上缺失的三样要多久。提示词可以是:
我是某高校大三学生,专业是信息管理,绩点 3.4,想毕业后做数据运营。请给我下学期五门选修课的组合建议,每门说明:它补的是哪个能力、与我目标的关联、以及可能的踩坑(比如作业量大、给分低)。如果信息不足,请先向我提问,不要直接给答案。
三句,覆盖了三件书里缺的事:先交代约束(专业、绩点、目标)、再要求它说明理由、最后给它一条"信息不足就反问"的退路。最后那句尤其重要,它把"编一个像样的答案"换成了"承认不知道"——这恰好是模型最不愿意做的事。
校验的方法也不难:把它给的五门课拿去学校教务系统逐门核对,课程号、学分、开课院系三项对上,才算推荐有效;对不上的,就是幻觉。这个过程十五分钟,比照着书里那六条自己瞎琢磨省事得多。一份可用的教材,应该把这三个环节都摆出来;而不是只摆第一个环节的"可能性"。
三、"遇强则强,遇弱则弱":全书最好的一页,只有一页
1.7 节的后半段,是全书我唯一想抄下来的一段。作者先引了凯文·凯利在《必然》里的观点——好问题比完美的答案更重要,然后往下推:
如今,获取答案变得极为简单,我们可以利用百度、谷歌和各种人工智能技术来解决问题。但同时,提出好问题变得更加困难……
ChatGPT 正是这样的工具,它遇强则强,遇弱则弱。当你向它提出一个宽泛的问题让它解答,它的回答总是让你一头雾水,似是而非。如果你能提一个好问题,并渐进式地引导它、驯化它,它的输出结果会让你觉得出乎意料的好。
"遇强则强,遇弱则弱"这八个字,比后面几十页的场景罗列都值钱。因为它解释了一个现象:同一个工具,为什么有人用出花来,有人用出废话。差别不在工具,在提问的密度。
后面那句比喻也准:"这就像你跟一个虚拟好朋友互相了解彼此的过程,当你们互相之间越来越理解对方的时候,对方给你的,便都是你想要的。"这句话把"提示词工程"这件听起来很技术的事,翻译成了"教一个人懂你",新手听得懂。
可惜这一页之后,书又回到了清单模式。1.8 节"快速入门"讲的是注册、界面、发第一句话,与前面那段判断的深度不匹配。全书最锋利的一刀,只划了一页就收了。如果按那段话的逻辑往下写,第 2 章到第 4 章就不该是"它能做什么",而该是"同一件事,问得糙和问得细,结果差多少"——每节给一组对照,粗糙提问一次、精细提问一次,把两份输出并排放。这个改法不需要更多素材,只需要换个写法。
四、5.12 那半页,是全书最抗时间的地方
5.12 节《在无结构化数据中生成表格》,是全书我读得最舒服的一节,因为它有完整的三个环节。
第一是提示词,一句话:
请根据提供的社交媒体帖子生成一个包含国家、城市、景点和停留天数的表格。
第二是输出,一张竖线表格,四列:国家、城市、景点、停留天数。两行数据:意大利 / 罗马 / Colosseum, Vatican City, Trevi Fountain / 4;西班牙 / 巴塞罗那 / Park Güell, La Sagrada Familia, Gothic Quarter / 5。
第三是提醒,两句话,我原样抄下来:
请注意,虽然 ChatGPT 可以帮助提取信息并生成表格,但它可能无法生成标准的 CSV 或 Excel 文件。你可能需要在生成的表格上进行一些后处理,以将其转换为适当的格式。
在使用 ChatGPT 处理无结构化数据时,请确保提供足够的上下文和明确的指示,以获得更准确的结果。同时,请务必检查生成的表格,以确保数据准确无误。
这两句是全书最值钱的两句。原因很简单:它说清了"到这里为止,剩下的归你"。模型输出的是带竖线的文本表,不是 xlsx;要进 Excel,中间必须有一次转换。这一步看着小,但它是"演示"和"交付"的分界线——演示到竖线表就结束了,交付要的是一个能直接打开、能筛选、能透视的文件。
更难得的是"请务必检查"这五个字。一本工具书肯在自己的示例后面加一句"你要自己核对",说明作者知道模型的输出不能直接采信。「教人用工具」和「教人对工具保持怀疑」,后者更难,也更少人写。
我把这一节当作全书的样板:一句提示词、一份输出、一条边界。这三样凑齐,一节就站得住。可惜按这个标准回头数,84 节里凑齐三样的,我数出来的不到十节。
补一句它没说清的:那张竖线表要变成能用的文件,中间其实有个更省事的走法——让模型直接输出逗号分隔的纯文本,粘进记事本存成 .csv,再用 Excel 打开;或者干脆要求它输出 JSON 数组,用几行脚本转表。书里只说了"可能要后处理",没说后处理有哪几条路、哪条最省事。这不是苛求细节,是读者到这里就卡住了:一个不懂 CSV 编码的人,把竖线表粘进 Excel,会看到所有内容挤在 A 列里。
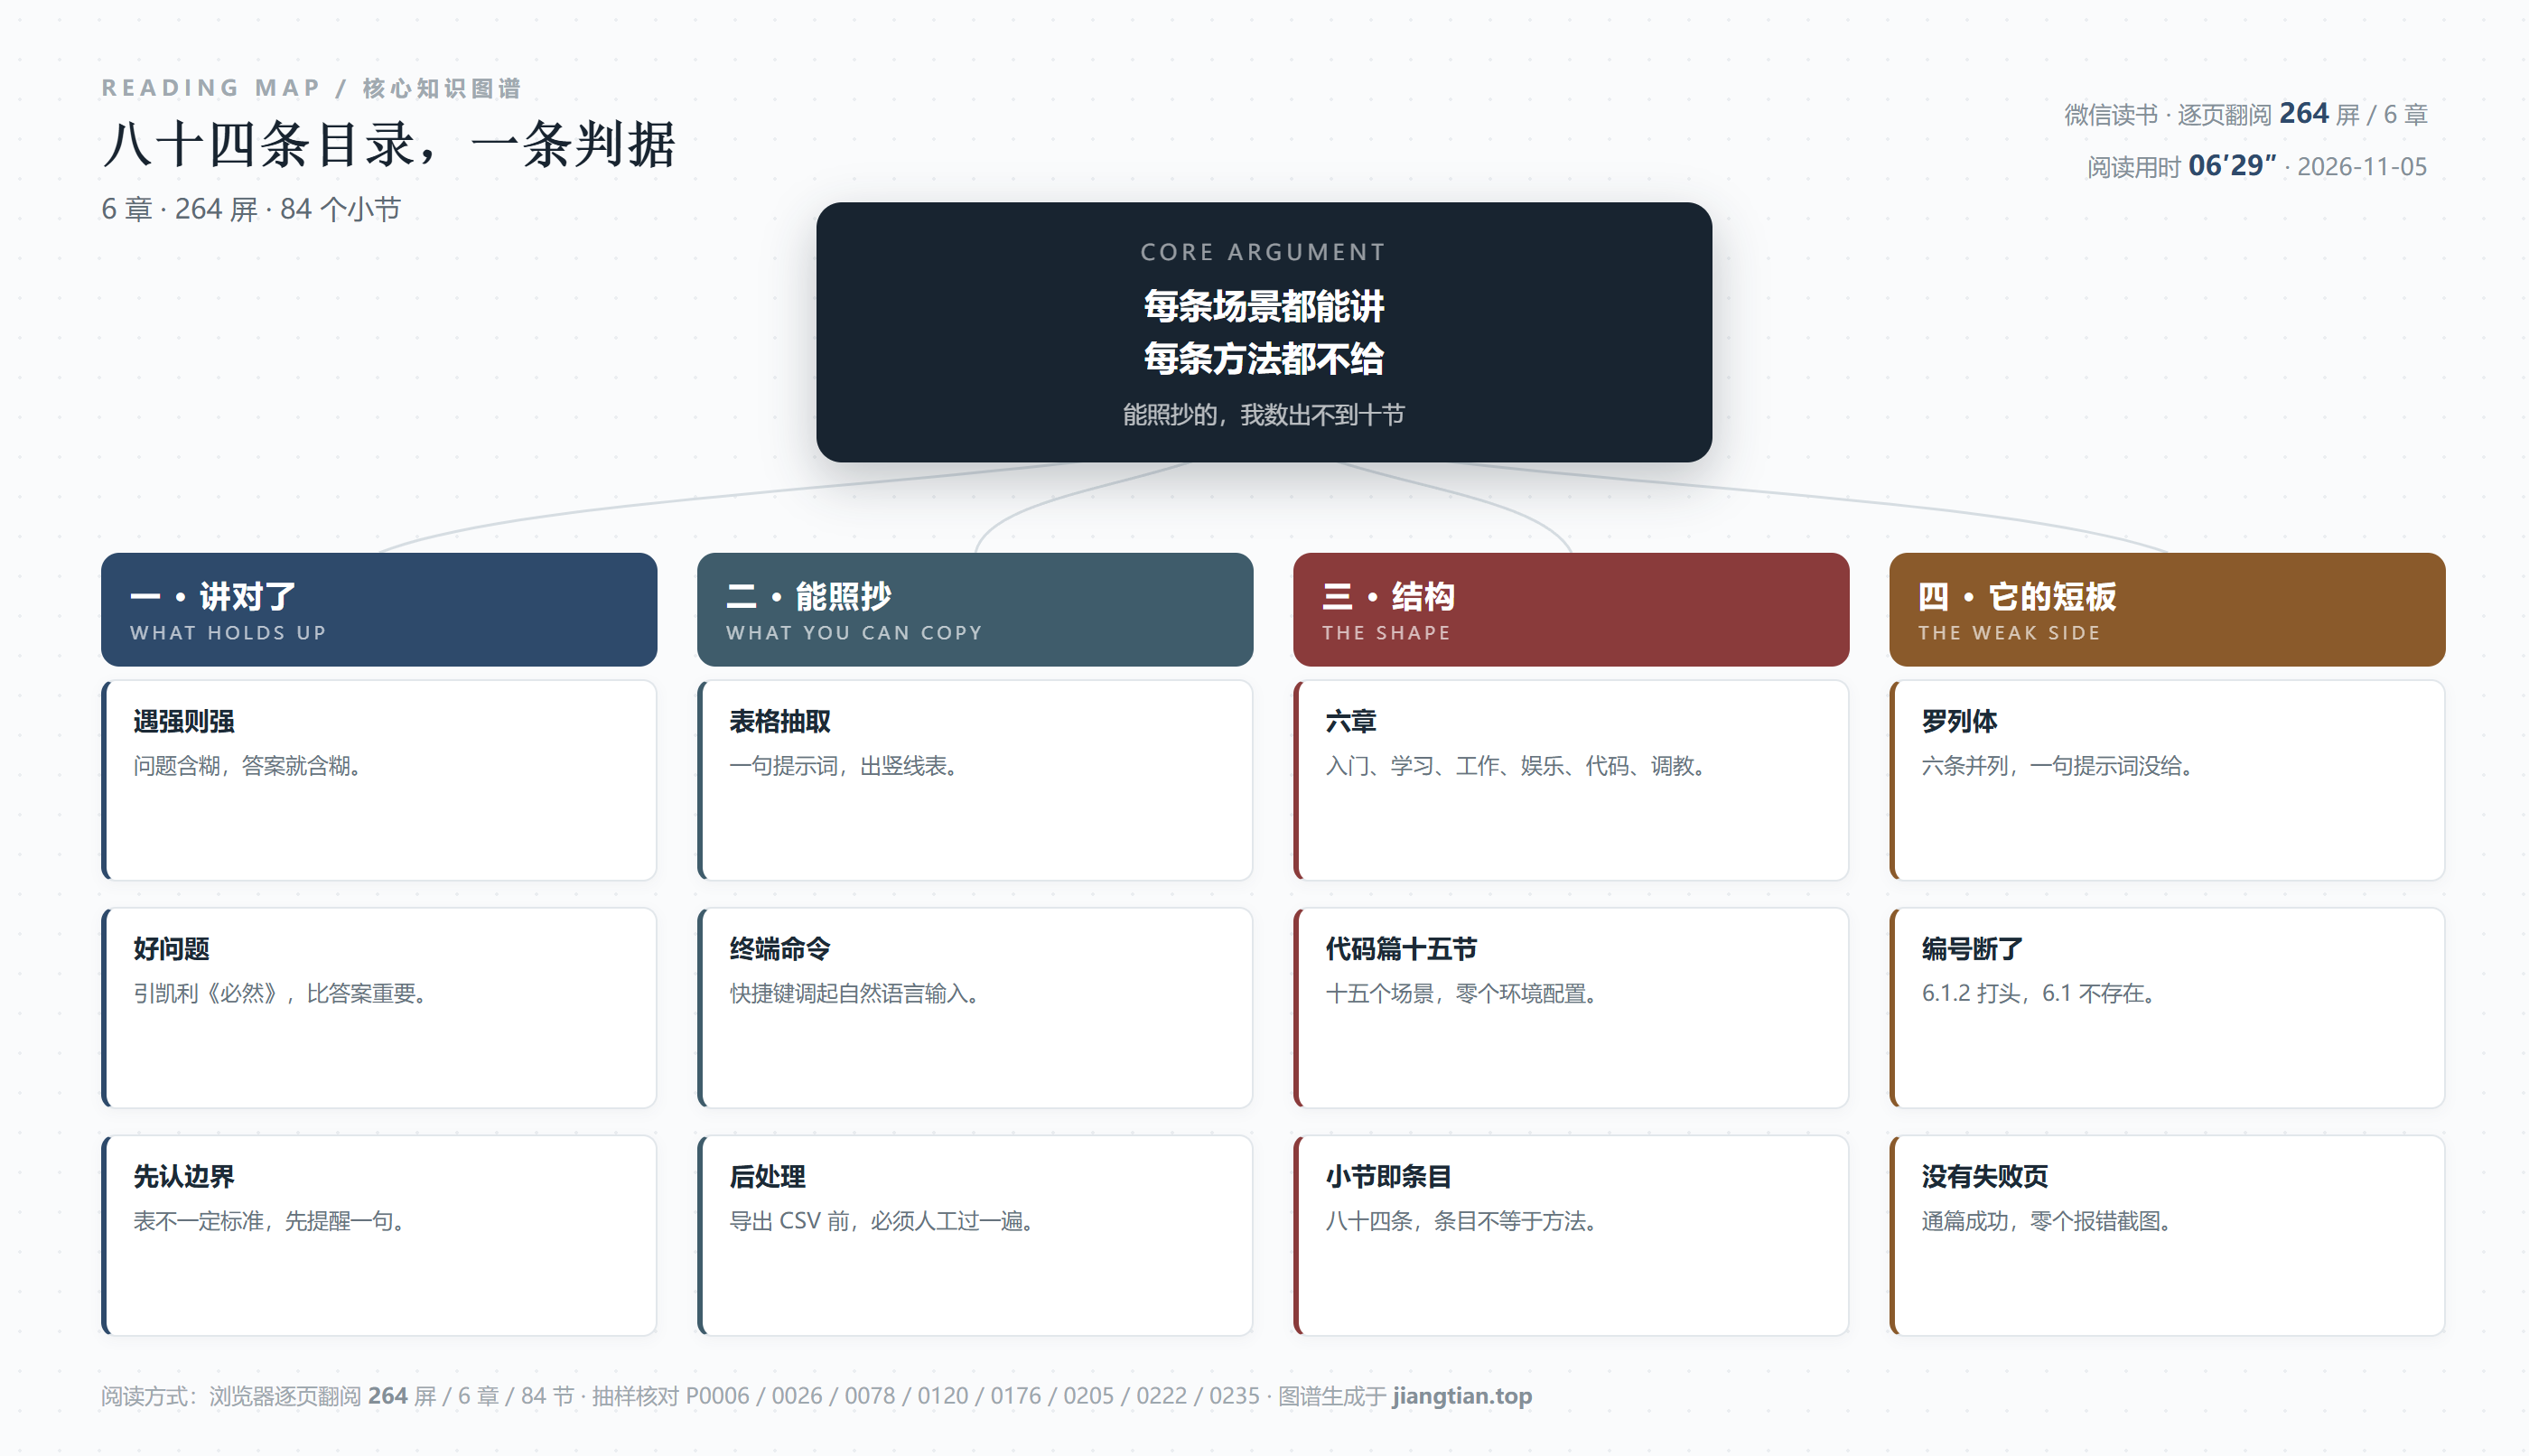
它的骨架、能照抄的部分和欠账,可以看这张图:
五、用 AI 生成一条 cd 命令:不是错,是没有排序
5.15 节讲 iTerm2:用 Command+Shift+句点 调出 Composer,用 Command+B 让 GPT 把自然语言翻译成命令。图 5-7、图 5-8 是终端截图,输入框里写着"打开当前目录"。
这一节本身没毛病,快捷键是真的,截图也能对上。但它和同一章里的 5.4《生成 SQL 语句》、5.6《解释程序代码》并列,都是"一节"——这就露馅了。
因为这两类活儿的价值差着一个数量级。"打开当前目录"这条命令,任何人打三个字母 cd 加一个空格就够了,让模型生成它,收益是负的:你要多按两次快捷键,多等两秒,还要看一眼它写对没有。而"解释这段别人写的存储过程在干什么",是一条人能省半小时的活儿。
把这两件事放进同一个层级,等于告诉读者"它们一样值得学"。一个真按目录顺着做的读者,会在 5.15 花掉十分钟学一个不需要的技能,然后在 5.4 只用五分钟。
我认为这一章真正该有的结构,是按"省多少时间"排序,而不是按"能不能做"排列。分三档:一档是省小时级的(解释陌生代码、把自然语言需求翻成 SQL、给没有文档的老项目补注释);二档是省分钟级的(改一段报错的代码、写单元测试的骨架);三档是看着新鲜但收益为负的(生成 cd、生成 echo、让它算 3 乘 7)。第三档不是不能写,是必须标明"这档别学"。
这条判据不只适用于这本书。任何一本"AI 能帮你做 N 件事"的书,都可以拿它来体检:把目录里的事按省时量分三档,看第三档占多少。占得多的,是热闹;占得少的,是教材。
我拿它把第 5 章那 15 节过了一遍。一档(省小时级):解释程序代码、生成 SQL 语句、在无结构化数据里生成表格、不懂代码也能写爬虫、生成调用 OpenAI API 的代码——这五节是真活儿。二档(省分钟级):转化代码、修改代码、精简代码、自动代码注释、生成程序文档、A/B 测试——这六节属于顺手,做了更好,不做也不致命。三档(收益为负或不成立):生成程序指令、计算时间复杂度、iTerm2 生成 cd——最后这一档里,"计算时间复杂度"尤其可疑,那要真看懂算法结构才算得对,模型的答案你没法验,也就没法用。
五比六比三。这个分布其实健康——大部分书比这糟。问题不在比例,在顺序:15 节按"看起来顺不顺"排列,把最值钱的 5.4 排在第四节,把最不值当的 5.15 放在最后当彩蛋。读者按顺序读,等于先学会用大炮打蚊子,最后才摸到打靶的姿势。
六、第 6 章的编号:从 6.1.2 开始,6.1 不存在
这一条是硬证据,读者翻开目录就能自己核对。
第 6 章《ChatGPT 的"调教"》在目录里的条目顺序是:6.1.2 微调:塑造专业领域专家 → 6.2 嵌入、微调与少样本学习:语言模型的三大法宝 → 6.2.3 少样本学习:快速学习新任务的能力 → 6.3 商业应用与角色定制 → 6.4 微调的实操步骤 → 6.5 对普通用户来说,微调还是少样本学习 → 6.6 个性化训练 → 6.6.2 如何进行个性化训练 → 6.6.3 实际案例 → 6.6.4 挑战与注意事项 → 6.7 少样本学习 → 6.7.2 如何进行 → 6.7.3 实际案例 → 6.7.4 挑战与优势 → 6.8 模型调教的挑战与优化。
数一遍缺口:6.1 不存在,6.1.1 不存在;6.2 之后直接跳到 6.2.3,缺 6.2.1 和 6.2.2;6.6 之后跳到 6.6.2,缺 6.6.1;6.7 之后跳到 6.7.2,缺 6.7.1。四处断裂,集中在同一章。
这一章偏偏是全书技术含量最高的一章——微调、嵌入、少样本学习、个性化训练,全在这儿。也就是说,最该被认真对待的一章,编号最残。
还有一个更明显的破绽在同一章里。6.2 的标题是《嵌入、微调与少样本学习:语言模型的三大法宝》——明说三样。可往下看,6.2 底下只剩 6.2.3 一条,标题是《少样本学习:快速学习新任务的能力》。三样法宝,只写了第三样;前两样连节号都没留下。如果正文里嵌入和微调另有交代,那目录就是漏的;如果没有,那个"三大法宝"的标题就成了一句空头承诺。
两种可能,都是坏消息。一种是正文里这些小节本来有,做目录时漏了,于是读者按目录检索会漏读;另一种是正文里也没有,那这几节是写到一半撤掉的,撤掉之后编号没重排。前者是索引失效,后者是承诺失效——无论哪种,读者手里那本"指南",检索功能都打了折。
我不想把这条上升成"编辑粗糙"这种泛泛之论。它更像一个信号:这一章是后加的,赶工塞进去的。而它恰恰是最难写、最需要时间的一章。一本书把最容易写的场景铺了 80 多节,把最难的调教压进最后 30 屏还编错了号,这个取舍本身,比任何一句批评都说明问题。
七、它的短板
第一,引言和正文的落差太大。引言里写"越来越多的公司在招聘新员工时,都要求候选人熟练掌握 ChatGPT 的应用",写这本书要"让你在这场智能革命中立于不败之地""让你领先于同行"。这几句是营销话术,不是教学内容。正文给的是一份场景清单,清单能让你知道有什么,不能让你"领先于同行"。
我不反对书里有点鼓动性。但鼓动性的话放在最前面,读者会带着"学完就领先"的预期往下读,读到 2.9 那样的六条并列,落差就来了。更稳的开场是给一个可验证的承诺:读完这本书,你能独立完成哪三件事。三件事说得出来,读者心里就有尺子;说不出来,只能靠形容词撑。
第二,84 节里没有一节讲失败。我抽查的每一节,从 2.9 到 5.12 到 5.15,展示的都是"它做成了"。没有一处贴过模型的错误输出,没有一处讲"它答错了你怎么发现"。这对一本工具书是致命伤,因为新手真正会卡住的地方,恰恰是它答得理直气壮但其实错了的时候。
而这本书完全有条件写这个。它已经知道边界在哪——5.12 那句"请务必检查生成的表格"就是证据。知道边界却不展示越界的样子,等于给了地图不标雷区。
第三,章节权重与难度倒挂。容易写的场景占了三章(第 2、3、4 章,共 33 节),难写的调教压成一章(第 6 章)。而按页数算,前三章加起来超过全书一半,第 6 章不到三成。这不是"内容分配"的问题,是"读者最需要什么"没想清楚:新手第一周需要场景,第三周就需要调教了。
第四,时效性没有交代。全书以 GPT-3.5 与 GPT-4 的界面为基准,1.5 节专门讲了 GPT-4 的推出。这类内容在出版那一刻就开始过期,界面改一次,截图全废。书里没有一句"以下操作以某年某月版本为准",读者拿到手也无从判断哪一页还能照着做。
这条的补救成本很低,一页就够:在前面加一句"本书截图基于某年某月的网页版,若你看到的面板与此不同,请以功能名而非位置为准",然后在正文里凡涉及按钮位置的地方,把"点击右上角"改成"找到名为某某的入口"。前者会过期,后者不会。写工具书的人都该记住一条:位置会变,名字变得慢。
第五,也是我最想说的:它把"能做什么"当成了"该做什么"。84 条目录里,写情书、写歌词、挖掘美食配方、让 Siri 帮忙记账,都各占一节。这些当然能做,但它们不构成能力,只构成消遣。一本叫"人人都应该掌握"的书,应该先回答"哪几件是必须掌握的",再回答"剩下的可以玩"。它选择了平铺。
说完这些,也说两句公道话。1.7 节那八个字,是真见识;5.12 节那两句提醒,是真负责;5.15 节给了可直接照抄的快捷键,是真省事。一本 264 屏的书能留下三处这样的东西,不算白读。我上面所有的批评,都可以归结成一句:它本来可以靠这三处立住,但它选择了靠 84 条目录立住。
另外交代一句边界:我的判断建立在对全书结构(84 条目录全部过目)与十余页正文抽查之上,不是 264 屏逐页细读。目录层面的结论(编号断裂、章节权重)是完整的;正文层面的结论(罗列体、缺失败页)是抽样的,我只对抽到的那些节负责。
八、一句话
如果你只带走一句:工具书真正抗时间的部分,不是它能做什么,是它做不到什么。
功能会变,界面会改,模型会换代。三年后再看这本书,"让它做 PPT""让它写文案"这些节大多已经过时;但 5.12 那句"它可能生成不了标准 CSV,请务必检查",一句都不过时。因为边界是由模型的构造决定的,换十代也还在那儿。
所以读这类书,我给一个顺序:先翻目录,把"能做什么"过一遍,知道自己有哪些选项;然后专找那些写了"注意""可能无法""请自行核对"的段落,那才是作者真正下过功夫的地方;最后,把每一节缺的那句提示词自己补上——补不出来的,说明这一节你还没学会。
阅读记录:《ChatGPT使用指南:人人都应该掌握的AI最强工具》,微信读书网页版逐页翻阅 264 屏 / 6 章 / 84 条目录,2026-11-05。抓取章节序列首尾相接(84 段对应 84 条目录),无跳章,末屏为 6.8 节收尾。
抽样页:p0006(引言)、p0026(1.7 遇强则强与凯利《必然》)、p0078(2.9 教育行业学生咨询六条)、p0120(第 3 章工作篇)、p0176(第 5 章代码篇)、p0205(5.12 前段)、p0222(5.12 表格输出与边界提醒)、p0235(5.15 iTerm2 与图5-7、图5-8)。
发表评论: