
LoRA 训练:成败不在参数,在你挑的那二十张图
微信读书《AI绘画+LoRA模型训练从新手到高手》· 编者(版权页未署个人姓名)· 2024 年 5 月
逐页翻阅 438 屏 · 5 章 · 读完至末页"全书完" · 2026-11-05
说明:本书五章,我从第 1 屏翻到第 438 屏,末页确认出现"全书完"。抽看了前言的书名承诺、第 3 章的提示词词汇表与权重写法、第 4 章的 BLIP 自动标注与训练流程、第 5 章的六个应用案例。另需说明:这本书在微信读书只有 5 人点评、显示"评分不足",所以下面不引用推荐值。
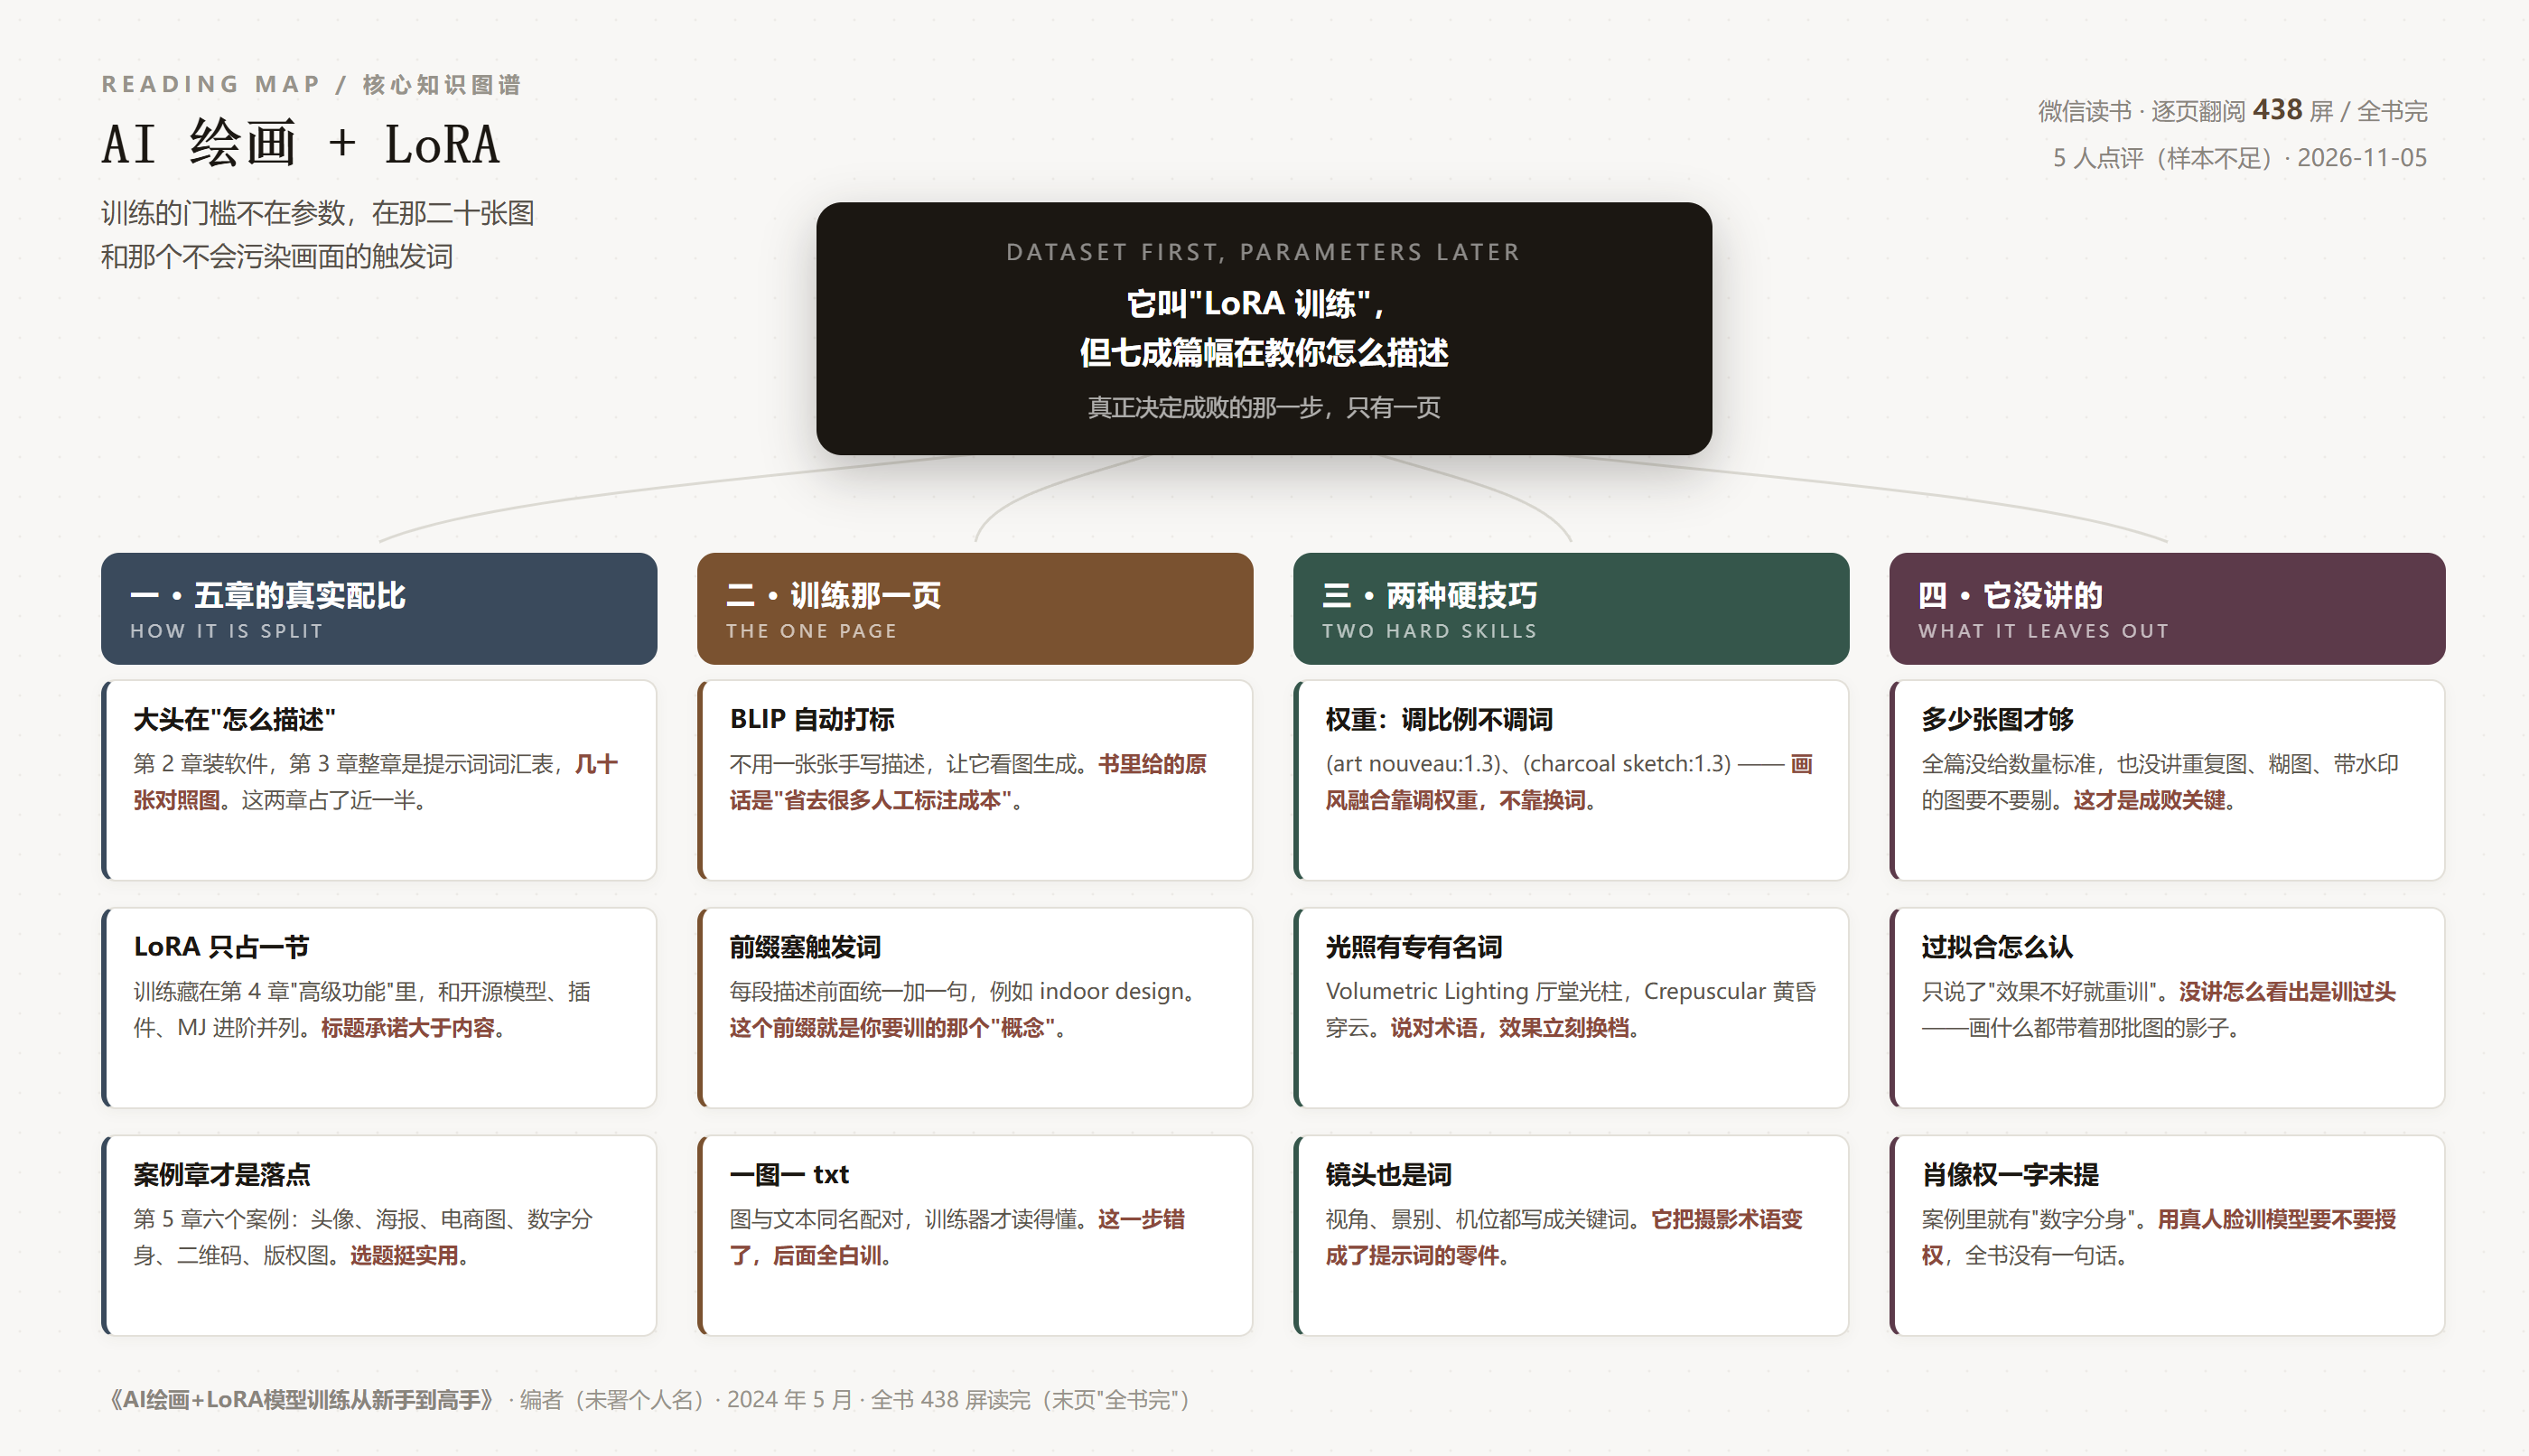
先讲一个读完才明白的事:这本书叫《AI绘画+LoRA模型训练从新手到高手》,但"LoRA 训练"在全书里只占一节。
它的实际结构是:第 2 章装 Stable Diffusion 和 Midjourney,第 3 章整章讲提示词(大量词汇与对照图),第 4 章讲"高级功能"——开源模型、插件、自定义模型训练、MJ 进阶,第 5 章给六个案例。训练这条线,塞在第 4 章里跟着别的高级功能一起讲。
这不是欺诈,是市场现实:LoRA 训练单独写撑不起一本书,得用软件操作和提示词词汇表垫起来。但对买书的人,这个结构差别很重要——你要的如果是"怎么训一个自己的模型",这本书只给了你三分之一的页数。
一、训练这一节,写清楚了最关键的一件事
第 4 章讲数据集准备,有一个细节我认为是全书最实用的:用 BLIP 给图片自动打标。
过去训 LoRA,最烦的一步是给每张图写描述——二十张图就要写二十段。BLIP 把这步变成"选一个文件夹、一键生成"。书里把界面参数也贴了:caption 文件后缀 .txt,前缀里填触发词(它用的例子是 indoor design),然后点 Caption images。
作者的解释是:
表 4-4 展示了 BLIP 自动标注的结果,前面 indoor design 是手动添加的触发词,后面是一段完整的话描述图像的内容,"a living room with a couch, chair, ottoman and a chandelier" 意思是配有沙发、椅子、脚凳和枝形吊灯的客厅,非常符合图片的内容。可以看到 BLIP 作为 AI 模型自动识别图像内容还是比较准确的,可以省去很多人工标注的成本。
这段话里有一个容易被跳过的关键:触发词是"手动加在前缀"的。
为什么这件事重要?因为 LoRA 学到的东西,是被 caption 牵着走的。你给二十张北欧客厅图,每张描述都写"a living room with...",那模型学到的是"客厅"这个概念;你在前面统一加一句 indoor design,它才学到"indoor design 这个词对应这种风格"。触发词是你给这个概念起的名字,也是你以后调用它的密码。
所以这条流程的实质是:先想好一个词,再让每张图都带上这个词,然后训练。顺序反了(先训再想起个名字),就白训。
二、提示词那一章,真正有用的是"权重"
第 3 章篇幅最大,几十张对照图。剥掉那些图例,真正称得上"技巧"的只有两类。
第一类是权重。书里给了一个画风融合的例子:
(art nouveau:1.3), (charcoal sketch:1.3) → 新艺术主义,炭笔草稿
这个写法的意义在于:风格不是"选一个",而是"配比例"。大多数人调风格的方式是换词,把"油画"换成"水彩",换来换去只有几个选项。而写成权重之后,同一个词可以从 0.6 调到 1.4,风格就变成了连续可调的——这才叫"调"。
第二类是专有名词。书里讲光照控制,给了两个词:Volumetric Lighting(体积光/厅堂光柱)、Crepuscular(黄昏穿云的光)。还有镜头控制那一节,把视角、景别都写成关键词。
这一类看着像"背单词",但它解决的是一个真问题:你脑子里那个画面,其实有专业名字。你说"好看的光",模型给你平均值;你说"Volumetric Lighting",它给你从窗口斜射进来的那道光柱。差别不在模型聪明程度,在你能不能叫出它的名字。
三、案例章选得不错,但都停在"能出图"
第 5 章六个案例:头像制作、海报、电商产品图、数字分身、二维码生成、AI 版权图片。
选题是有眼光的——这六个确实是目前 AI 绘画落地最多的地方。而且每个案例都按"确立主题 → 控制风格 → 控制脸型五官 → 控制配饰背景"拆步骤,思路清楚。
但六个案例有一个共同的终点:出图就结束了。没有一张图讲到"这张图拿去用会遇到什么问题"——比如头像用在社交平台会不会被压得看不清、电商图的比例平台认不认、二维码生成图扫不出来怎么办。这些都是实操里第一个小时就会撞上的问题,书里一个没答。
四、它的短板
第一,也是最要命的一条:没讲数据集该多大、该怎么挑。
这是 LoRA 训练真正的成败点。二十张图和三张图训出来完全不是一个东西;同一批图里混进两张糊的、带水印的、背景杂乱的,整个模型就会被污染。这些问题书里全没讲。它讲了"用 BLIP 打标",讲了"前缀加触发词",唯独跳过了"哪些图该进这个文件夹"。
我猜原因是:这一步没法截图教学,只能靠经验。但恰恰是这种"没法截图"的部分,才是新手和老手的差别。
第二,过拟合没有任何判据。书里对训练结果的处理只有一句话的意思:效果不好就重训。可过拟合不是"效果不好",它的表现是效果太好了——你让它画什么,出来的都带着那二十张图的影子,背景、构图、光影全被绑死。这个错误新手几乎必犯,而且很难自己意识到,因为"看起来挺像"。
第三,训练参数基本没给判断依据。步数、学习率、batch size 这些在界面截图里出现了,但没有一句"调大调小分别会发生什么"。这等于给了仪表盘没给说明书。
第四,肖像权一个字没提。案例里有"数字分身",这必然涉及真人照片。用真人脸训模型要不要授权、能不能商用、模型文件流出去怎么办——全书没有一句话。这不是苛求,2024 年 5 月出版的书,这个问题已经很现实了。
第五,软件操作篇幅偏大且易过期。第 2 章的安装步骤、界面截图占了大量篇幅,这类内容在软件更新后基本作废。作为"新手入门"可以理解,但读者要知道:这部分价值最短命。
五、一句话
如果你只带走一句:LoRA 训得好不好,八成取决于你挑的那二十张图和一个触发词,剩下两成才是参数。
所以别急着点"开始训练"。先把文件夹里的图一张张看一遍——糊的删掉、带水印的删掉、风格不统一的删掉,然后想清楚你要训的那个概念叫什么名字,把它写进每一段描述的前缀里。这一步做完,训练反而简单了。
阅读记录:《AI绘画+LoRA模型训练从新手到高手》,编者(未署个人姓名),2024 年 5 月,微信读书网页版逐页翻阅 438 屏 / 5 章,2026-11-05,末页确认"全书完"(该书仅 5 人点评,显示"评分不足",故不引用推荐值)。
抽样页:p0006(前言与五章结构)、p0250(画风融合权重示例)、p0310(BLIP 自动标注与触发词前缀)、p0322(MJ 镜头与光照控制)、p0330(第 5 章头像案例)、p0438(全书完页)。
发表评论: