
Agent Skills 橙皮书:会写 Skill 的人,都在删字
微信读书《Agent Skills 橙皮书:给 AI 装技能的完全指南》· 微信读书网页版逐页翻阅
181 屏,10 章 79 节(微信读书把每个二级标题都单列成"章",所以目录里显示 79 项)· 2026-11-04
说明:这是一本自出版性质的"橙皮书"小册子,不是出版社的正式书。我逐页核对的位置:P0006(七个 Skill 串成一条写作流水线,以及"不是更聪明,是更懂你")、P0030(黄金区间 500–2000 字与菜谱类比)、P0035(创作 Skill 与审校 Skill 打架)、P0063(两行 mkdir 装完,没有第三步)、P0135(多 Agent 并行的依赖图与文件协调)、P0175(16 个人物视角 Skill 的"设计亮点"表)。下面凡引用都出自这些页,凡推断都是我的判断,我会标明。
先说结论:这本 181 屏的小册子里,真正值钱的是一条带数字的规则(500 到 2000 字),和一条带失败案例的经验(两个 Skill 同时触发会打架)。剩下的篇幅,大半在教你造 Skill,而不是装 Skill。
这个错位不是小事。因为书名承诺的是"给 AI 装技能"——读者掏时间是为了用现成的;而书的重心落在"创建你的第一个 Skill""用 skill-creator 自动创建""高级设计模式"这三章上,是给作者型读者准备的。两条路需要的地图完全不同,这本书把它们铺在了同一条道上。
但它也不是没有干货。它的干货集中在两处,我先把这两处讲透,再算它的账。
一、它抓对了一件事:AI 缺的不是智力,是默认值
P0006 是全书论证最完整的一页。作者把自己写一篇文章的全过程拆成七个 Skill,一个接一个跑:
6 配图(huashu-wechat-image)
配图 Skill 知道我的审美偏好:不用赛博霓虹风格、不用深蓝色底、封面不加个人水印。它先提出 3 个配图方向让我选,确认后用 AI 生成图片,上传到图床,生成的 Markdown 链接直接内联到文章里。零 placeholder,所有图片都是可访问的网络链接。
7 社交分发(huashu-article-to-x)
文章完成后,这个 Skill 把 3000–5000 字的长文浓缩成 200–500 字的 X 平台内容。它知道要保持口语化、用具体数字、结尾加互动引导。提供金句开头、数据冲击、价值直给三种风格让我选。
然后他把整件事的收益归结成一句被框起来的话:
整个过程中,我没有解释过一次「输出格式是什么」「审校标准是什么」「配图风格是什么」。因为这些都写在 Skills 里了。AI 记住了我的工作方式。
这就是 Skills 的价值。不是让 AI 变得更聪明,而是让 AI 变得更懂你。它不再是一个什么都能做但什么都要你教的通用助手,而是一个了解你的工作习惯、审美偏好、质量标准的专属助手。
这段话值得停一下。因为它把"提示词工程"的位置重新标了一遍。
常规的提示词思路是"教模型做事":把要求说清楚、把例子给足、把格式定死。这套做法的隐含假设是模型不会,所以我要教。但 P0006 那七个步骤里,没有一步是"模型不会"——生成配图、长文压缩成推文、提出三个方向让人选,这些它能做。真正缺的是三样东西:不用赛博霓虹、不用深蓝底、封面不加个人水印。
这三样不是知识,是偏好;不是能力,是默认值。
这就是这本书最关键的一次视角转换:Skill 不是在给模型加能力,是在给模型改默认值。你不再每次说"别用深蓝色",而是让它一开始就不知道深蓝色这个选项。前者是纠正,后者是预设。纠正做一百次还是纠正,预设只做一次。
我的判断是:这个转换的收益不在质量上限,在方差。模型的智力上限由模型决定,你写多少字都提不上去;但你每次让它自由发挥,出来的东西结构都不一样——这次三栏,下次流水账,这次口语,下次公文。这种不稳定,用过的人都熟悉,却很少被当成问题去解决,因为每一次的结果"看起来都能用"。Skill 解决的就是这个:把"每次都能用"变成"每次都一样"。
不过这里有个代价,作者没提,我觉得必须提:提示词写错,只错这一次;Skill 写错,错的是每一次,而且错得很安静。因为它是"默认值",你不会再去检查它。这就是为什么"写完之后怎么验"比"怎么写"更要紧——这本册子恰好缺了这一课,我在第七节补上。
二、500 到 2000 字:全书唯一一条带数字的规则
P0030 那一页是这本册子的第二个硬货。作者说他"写了 27 个 Skill 之后",发现了一条反直觉的规律,并且给了两头的失败案例:
太短的 Skill 没用。你写「帮我写周报,要简洁」,AI 不知道你的「简洁」是什么标准。100 字算简洁还是 300 字算简洁?三栏式还是流水账式?没有足够的细节,AI 只能猜。
太长的 Skill 也有问题。我曾经写过一个超过 5000 字的 Skill,把所有边界情况都考虑到了。结果呢?AI 反而执行得不好。因为关键信息被淹没在大量细节里了。上下文窗口是有限的,你塞进去的内容越多,每条信息的「权重」就越低。
最佳区间在哪里?我的经验是:500 到 2000 字。
然后他给了三个自用 Skill 的实际字数:审校约 2000 字核心内容、选题生成约 800 字、配图约 1200 字。
这三个数字放在一起看,比那个区间本身更有意思。它们的排序,正好等于"要它做多少个判断"的排序。审校要判的事最多:格式对不对、事实有没有错、语气合不合、引用全不全,每一类下面还有细则,所以它最厚。配图次之:风格、尺寸、水印、方向数量。选题最少:方向、角度、数量。500–2000 这个区间不是玄学,它是"判断密度"的代理指标——你要它替你做的判断越多,能容忍的字数就越多;判断越少,字越少反而越准。
但作者对上限的解释,我认为给错了。
他说"上下文窗口是有限的,你塞进去的内容越多,每条信息的『权重』就越低"。这个解释把 Skill 当成常驻在上下文里的东西了。可 Skill 的实际用法是"被触发之后才读进来"——它占的不是常驻窗口,是那一次任务的输入。真正的约束不是"窗口够不够",而是"这一坨东西,它能不能一次读完就照着做"。超过 5000 字失败,不是因为窗口装不下,是因为一次读完 5000 字的规则,人也会漏,模型也会漏。
解释错了,不会让结论错,但会让读者学错方向。读者会以"字数"为目标去删——删到 2000 字以下就以为成了。而真正该做的,是把形容词换成数字。
举个我自己的例子。"要简洁"是形容词,字数一样多也照样没用;改成"每段不超过 3 句,全文不超过 6 段,不写总结段"——字数没少多少,可判定性天差地别。那 500 字里该装的是这种句子,不是抒情。判断一个 Skill 写得好不好,只有一个办法:把每一条读出来问自己"这条能不能被判对错"。判不了的,删掉或者改成能判的。
P0030 末尾那个菜谱类比,是全书最好的一段比喻,因为它顺手给出了判据:
好的菜谱不会告诉你怎么握刀、怎么开火。它假设你有基本的厨房常识。它会告诉你的是:中火翻炒 3 分钟、盐半勺、出锅前加葱花。好的 Skill 也是一样:不需要教 AI 怎么写文章,只需要告诉它你的标准和偏好。
"中火翻炒 3 分钟、盐半勺"——这两句之所以是好菜谱,不是因为短,是因为它们是可以被核对的。回头看锅,火是不是中火,时间到了没有,盐放了没有。而"适量""少许""翻炒至金黄"这种话,写了等于没写。
按这个尺子去改,一句"文风要口语化"会被改写成三条:"每段不超过三句;不用'综上所述''旨在'这类词;关键结论放在段首第一句。"改完之后字数翻了一倍,但可判定的条目从零条变成了三条。这就是为什么"500 字"这个数字本身没有意义——它可以是一百条判据,也可以是一段空话。作者给了区间,但没给这个换算关系,读者很容易把它当成一个"写短点"的提醒,而它其实是一个"写具体点"的提醒。
三、两个 Skill 打架,暴露了提示词工程的真实位置
P0035 是全书唯一一个真正的失败复盘,我觉得它比前面所有成功案例都值钱:
有一次我在写文章,同时触发了「内容创作 Skill」和「审校 Skill」。创作 Skill 告诉 AI「先写完整篇,不要中途停下来修改」。审校 Skill 告诉 AI「逐段检查,发现问题立刻改」。两个指令矛盾了,AI 的输出变得很奇怪,写一段改一段,既没写完整也没改彻底。
这个 bug 很典型,值得拆开看。它的根因不是模型笨,也不是哪条规则写错了——两条规则单看都对。它错在两条规则都没有写生效条件。一条说"别停",一条说"停下来改",模型夹在中间,选了个折中方案:停一下改一点。折中在这里是最坏的解,因为两边的目标都没达成。
作者给了三条解法:设计不重叠的触发条件、在 Skill 里声明优先级、把流程拆成阶段。三条都对,但层次完全不同,他不该把它们并列:
第一条是在入口上解决——让两个 Skill 不在同一个场景里同时出现。最便宜,也最脆。用户换个说法("帮我看看这段写得怎么样"),触发条件立刻重叠,问题回来。
第二条是在文本上解决——在 SKILL.md 里写一条"如果正在执行其他写作任务,审校 Skill 不自动加载,等用户显式调用",作者的理由是"AI 理解自然语言,这种约束它能遵守"。这句话是全书最乐观的一句,也是我最不同意的。它把可靠性押在理解力上:模型"能理解"不等于"每次都会照做",而你恰好是因为它不照做才写的 Skill。用一句自然语言去管另一段自然语言,本质是拿同一层的工具修同一层的 bug。
第三条是在流程上解决——先写完,再进审校阶段。最贵,也最稳。因为它把冲突变成了不可能:两个 Skill 不在同一个时刻生效,就不存在谁让谁的问题。
我的判断是:第三条应该是默认做法,前两条只当补丁。理由是失败模式的性质不一样。冲突发生时,输出不是"错",是"撕裂"——写一段改一段的半成品。半成品比明显的错误更难查,因为它每一段都像对的,只有通读全篇才发现没有一处完整。这种失败只能靠结构消除,不能靠一句话压住。
这一节还顺带说明了一件被忽略的事:Skill 不是能力包,是行为约束。能力包叠加越多越强,行为约束叠加越多越乱。所以"我装了 30 个 Skill"不是值得炫耀的数字——真正该看的是同一时刻有几条在生效。这个数控制在个位数,系统才稳;到了十几个,你就是在给自己造一个随时会打架的规则集。
四、"装"只占一章,"造"占了三章:这本书的重心偏了
把 10 章的目录摊开看,比例一目了然:
01 进化 / 02 本质 / 03 原理 / 04 生态 / 05 安装 / 06 实战 / 07 创建 / 08 用 skill-creator 自动创建 / 09 高级设计模式 / 10 未来。
真正教"装"的只有 05 一章,而它的核心是两行命令(P0063):
# 项目级安装
mkdir -p .claude/skills/my-skill
# 然后把 SKILL.md 文件放到这个目录里
# 全局安装
mkdir -p ~/.claude/skills/my-skill
# 同样把 SKILL.md 放进去
就这样。没有第三步。下次启动 Claude Code,它会自动扫描这些目录,发现新的 Skill 并加载。
"没有第三步"这句是对的,也确实简单。问题在后面:装完不生效,怎么办?这个问题的发生率远高于"怎么写 SKILL.md",但它被放到了 06 章末尾的排查清单里,离安装章隔了几十页。更麻烦的是"装了三个互相打架怎么办"——那个在 03 章末尾才出现,而 03 章叫"Skills 背后的原理",一个刚装完第一个 Skill 的人不会去翻。
我的判断是:这本书的目录是按"知识的逻辑"排的,不是按"读者的路径"排的。按知识排,当然先讲本质、再讲原理、再讲生态、最后才动手;按读者排,应该是"装一个 → 它没生效 → 为什么 → 怎么改 → 再造自己的"。前者让作者写得顺,后者让读者少走弯路。而这本书选择了前者。
它对谁最友好?写作者。七个例子(配图、社交分发、审校、选题、数据、slides、文章)全在内容创作这一条链路上。这对一个写公众号的人极其好用,因为他可以照着抄。但对做运维、测试、财务、法务的人,可迁移的部分一下子就少了——全书没有一个是"非内容"的 Skill 案例。这不是苛求,是定位问题:它其实是一本"内容创作者的 Skill 手册",只是名字起得像一本通用教材。
五、它给的多 Agent 建议,比它给的 Skill 模板更值得抄
P0135 讲的是多 Agent 协作,这一页是全书最"工程"的地方,也是我认为唯一不会被模型换代淘汰的部分:
多 Agent 并行听起来很酷,但有个前提:子任务之间必须真正独立。如果第 5 章要引用第 3 章的结论,它们就不能完全并行。在拆分任务时,先画依赖图,只有没有箭头连接的任务才能并行。
用文件系统或 git 做协调。不要让 Agent 之间直接通信。Agent 之间的「对话」会指数级增加复杂度。用文件和 git 分支这种「共享存储」的方式协调,简单粗暴但有效。
合并时需要人工 review。并行产出的质量是参差不齐的。有的 Agent 发挥好,有的会跑偏。合并不是简单地把所有产出拼在一起,而是需要人看、调整、确认了才算完成。
第二条值得单独说,因为它反直觉:让 Agent 互相通信,听起来是"协作",实际是灾难。
原因不是"聊不明白",是"聊不完"。N 个 Agent 两两对话是 N² 条通道,每条通道的往来都要进各自的上下文,成本指数涨;而收益只是"信息同步"这一件事。文件是 O(N) 的:每个 Agent 写自己的产出,读别人的产出,谁先谁后由目录结构和依赖图决定,不由对话决定。把 N² 的通信压成 N 次读写,这是省下来的主要成本。
"简单粗暴但有效"这个评价很准确,因为它承认了代价:牺牲实时性,换来可回溯。对话没法 diff,文件可以。你事后能 git diff 出谁改了哪一段,但你不能 diff 一段聊天记录。在 Agent 会"跑偏"的前提下,可回溯比实时重要得多。
第三条是全书唯一承认"自动化有天花板"的地方。"有的 Agent 发挥好,有的会跑偏""合并不是拼起来"——这两句话比全书任何一处"效率提升"都诚实。它也顺手给出了一个判断标准:如果你的多 Agent 流程不需要人工 review 就能收工,那大概率不是你设计得好,是你没检查。
顺便说,这三条经验反过来照出了全书的一个盲点:它讲了怎么拆任务、怎么协调、怎么合并,却没讲怎么判断拆得对。依赖图是判据之一——能不能画出无环的图,说明拆得干净。这个判据它提到了,但只用了一句"先画依赖图",没有展开成可操作的自检法(比如:抽一个子任务的输入,看它是否只依赖上游产出、不依赖下游结论)。
六、它的短板
这一节我写得直白一些,因为这本书值得被认真挑。
第一,全书的收益没有一处可验证。它反复出现"AI 记住了我的工作方式""不用再解释",但没有任何一处给出对照:装之前跑五次、装之后跑五次,输出结构的稳定性差多少?触发成功率是多少?改一版 SKILL.md,效果差异有多大?一个都没有。
P0175 那张表最能说明问题。它列了 16 个人物视角 Skill,"设计亮点"一列写着:"6 Agent 并行采集 + 三重验证 + 结构化 Skill 生成""8 个心智模型,30+ 一手来源""穷查理宝典 + 几十年股东会提炼""五卷本《不确定性》系列提炼"。这些全部是投入量的自述,不是产出质量的证据。一本书花 79 节教人"把标准写成可判定的句子",自己最关键的论证却全是形容词——这个反差有点讽刺。
第二,中英双标题是装帧,不是内容。10 章 79 节,几乎每个二级标题后面都挂一个英文括号:The Operating System Analogy、Skills vs System Prompt、Context Window and Skill Loading、The Goldilocks Zone……但正文没有一句是写给英文读者的,也从来没有术语对照表。这个成本不在排版,在阅读——每读一个标题,眼睛要多扫一遍一串不需要解码的字母,79 次。它制造的是"国际感",付出的是读者的注意力。
第三,押死在宿主目录上。05 章整章建立在 .claude/skills 和 ~/.claude/skills 这两个路径上,01 章标题说"20 多个产品已经支持",但正文既没列名单,也没标版本。而"支持"这件事在不同宿主上差别很大:有的扫目录,有的要配置文件,有的要重启,有的每次会话重扫。一旦宿主改了目录约定(这在这类工具里是常态),第 5 章整章作废——而这是唯一的"装"章。这不是作者的错,是小册子的宿命:它的有效期的确短。
第四,少了一课:怎么知道它生效了。这是读完最大的空缺,第七节展开。
第五,章节配重失衡。04 章讲生态"七大平台 + 横向对比",但没有一处给出版本号和观测日期。任何一张平台对比表,不给日期,就只是一张当时的截图。这本书里所有"当前支持""已经支持"的说法,都缺一个时间戳。
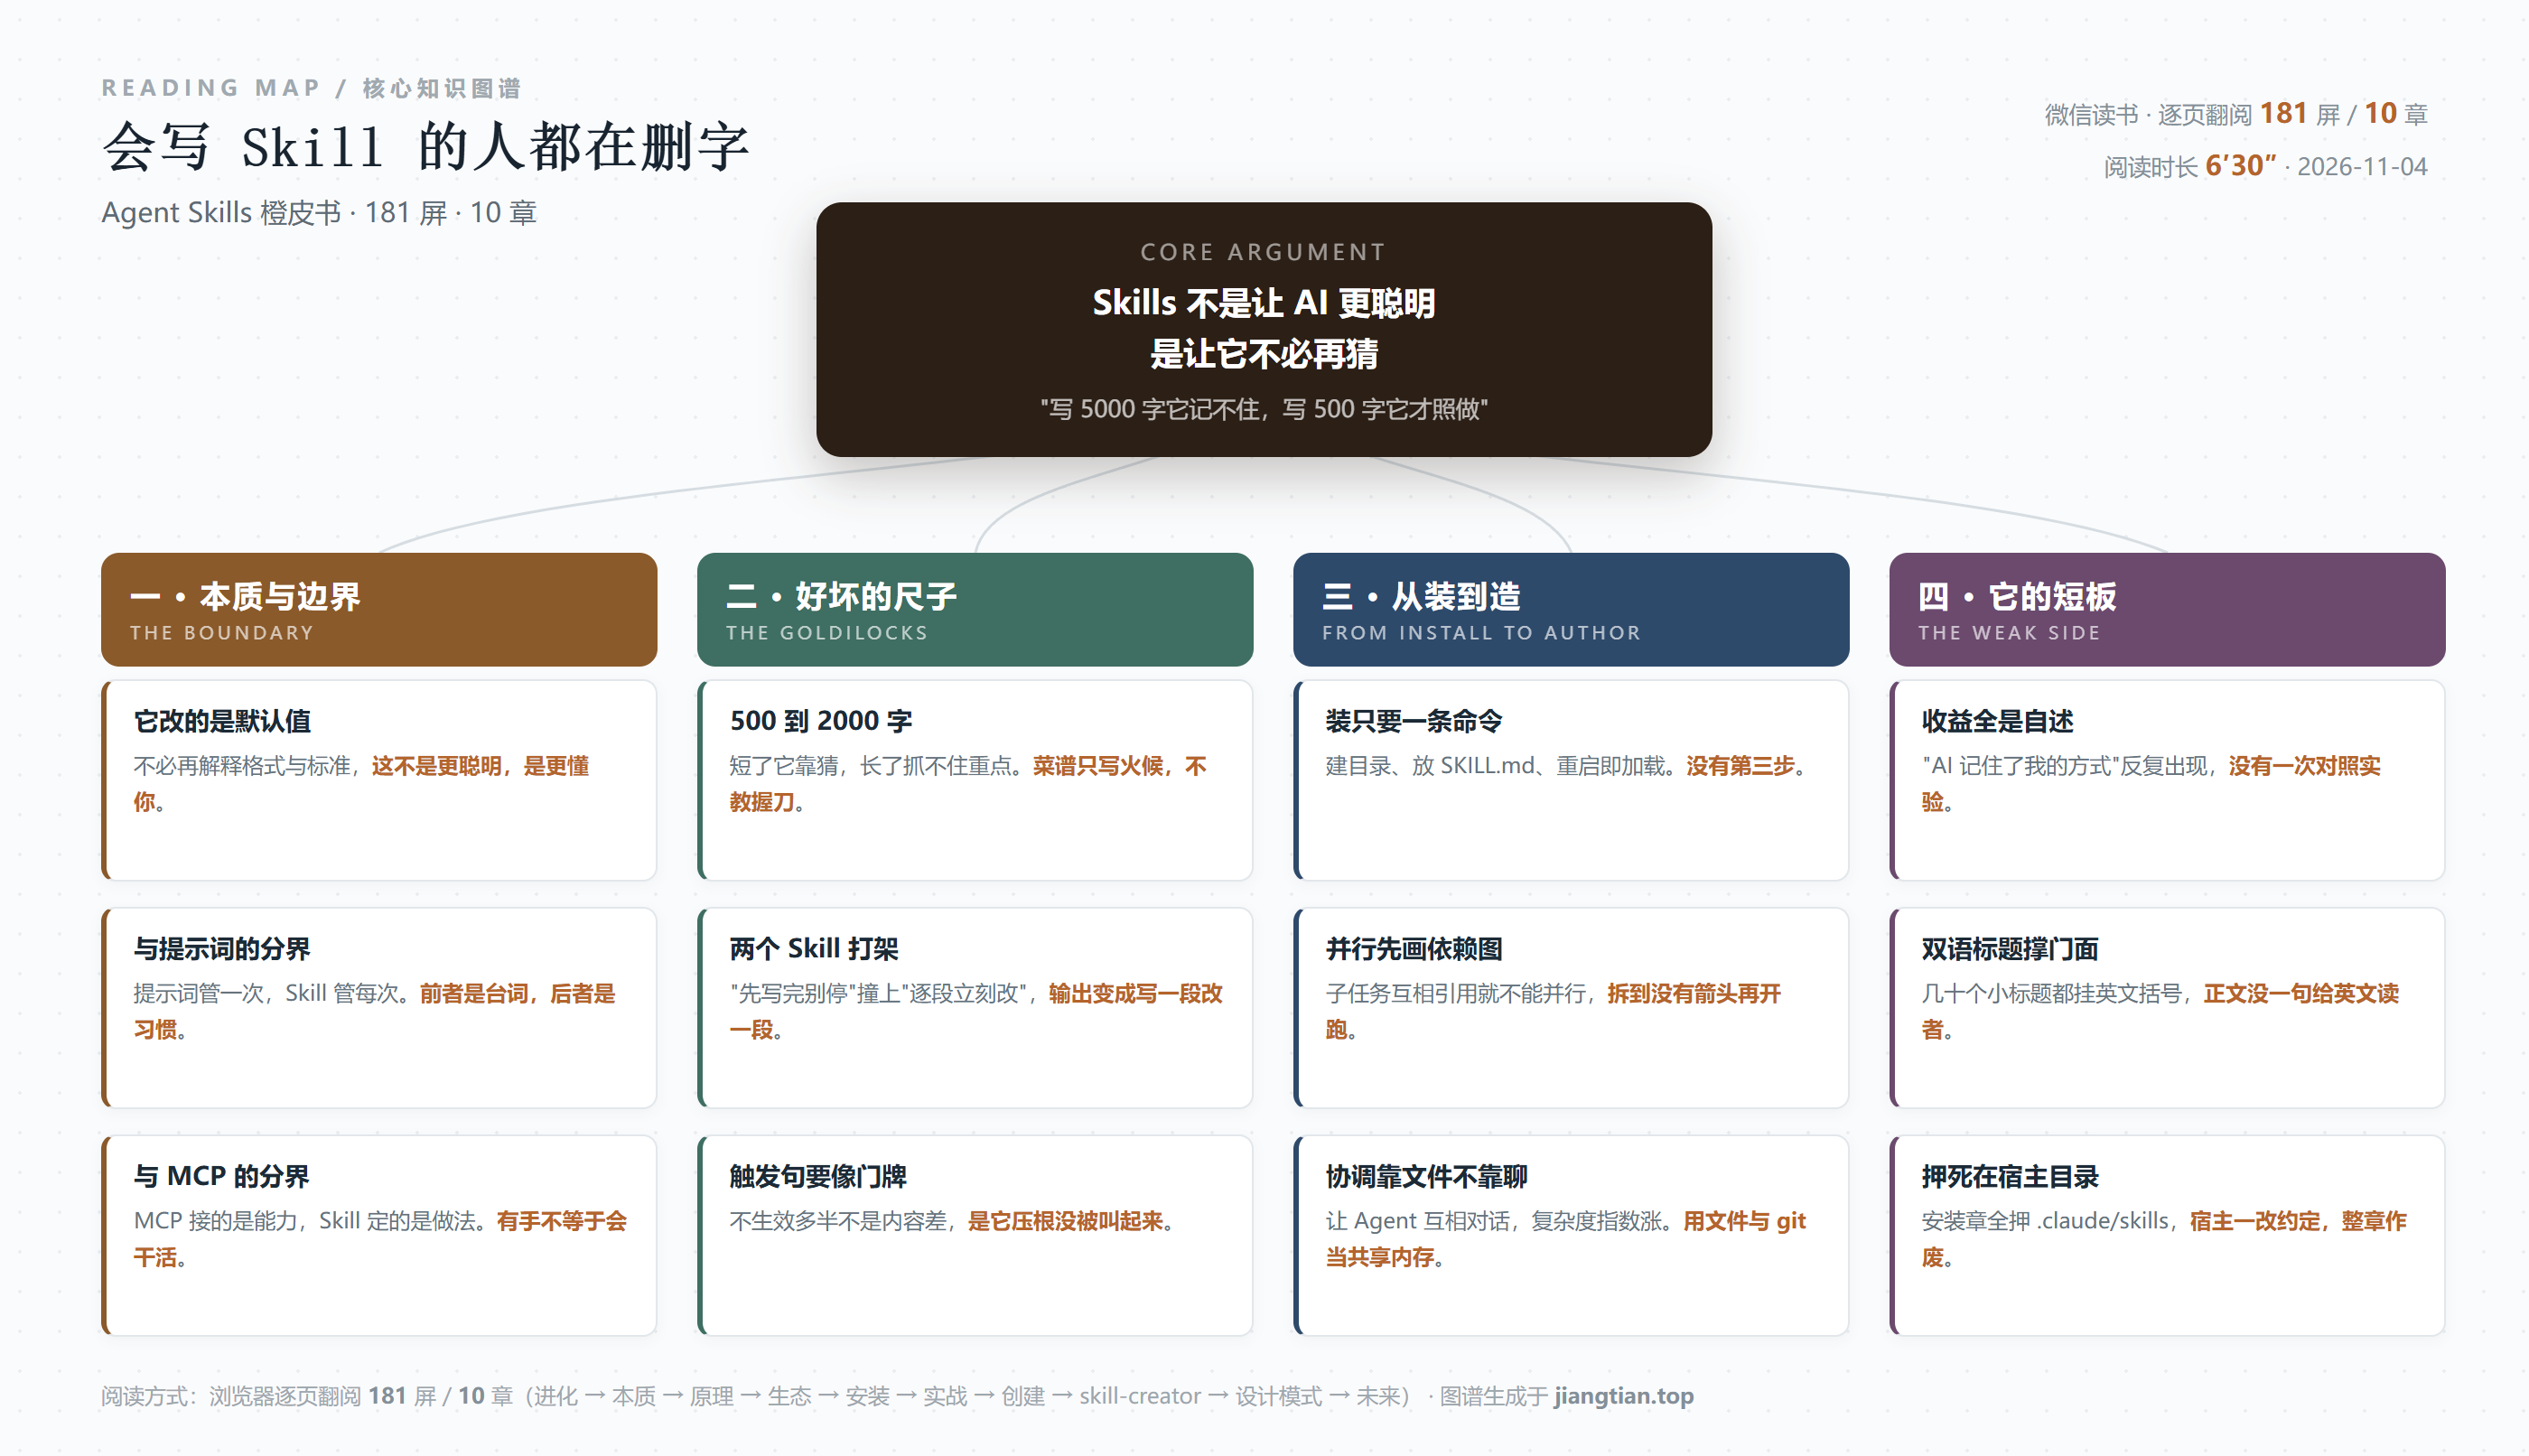
图文对照:这本书的四条线索,和我认为它最虚的那一列
下面这张图是我读完画的结构图。四列分别是:它的本质判断、写好坏的尺子、从装到造的路径、以及短板。最后一列是全书唯一没有证据支撑的地方——收益的自述。
七、它没写的那一课:三条判据
补这一节,是因为它比书里任何一章都实用。判断一个 Skill 到底装上了没有,我给自己定了三条,都能当场做:
判据一:结构稳定性。同一条提示词,连跑五次,看输出骨架是不是一致。提示词工程的收益是"这次好",Skill 的收益应该是"每次都一样好"。如果五次的骨架各不一样(这次三栏、下次流水账),说明你写的不是标准,是气氛。
判据二:触发可复现。换三种说法问同一件事,看它是不是每次都加载。P0035 那类冲突的根因多半在这里——触发条件写的是关键词,用户说的是意思。写"帮我改"就触发审校,写"你看这段行不行"就不触发,这不是模型不稳定,是门牌号写窄了。
判据三:冲突可归因。故意让两个 Skill 同时触发,看输出是"撕裂"还是"取舍"。撕裂的表现是写一段改一段这种半成品,取舍的表现是它选了其中一个并说明理由——后者是可接受的,前者必须拆阶段。
三条都能过,才算装上。过不了第一条,说明你要写的是判定条件,不是形容词;过不了第二条,说明你要写的是场景,不是关键词;过不了第三条,说明你要动的是流程,不是文本。
这三条还有个附带好处:它们可以被写成测试。把同一提示词跑五次的输出存下来,比对结构;把三种说法写成一个用例集,每次改 SKILL.md 就跑一遍。一个 Skill 仓库如果没有这套东西,它其实是在靠感觉维护。而这本册子讲了 79 节,唯独没有讲这件事——这也解释了为什么它的例子全是"我用了觉得好用"。
八、怎么读它
读 02 和 03 两章。这是全书唯一在讲"为什么"的部分,也是唯一在你换了工具、换了模型之后还能用的部分。本质那一章里"Skill 与系统提示词的区别""Skill 与 MCP 的区别"两节写得干净,可以直接当概念卡背下来。
读 P0030 那一页,但把"500–2000 字"翻译成"判断条数"。区间是结果,不是目标。目标是每一条都能被判对错。
读 09 章的三种设计模式——检查清单型、多方案选择型、多阶段流水线型。这三型对应的其实是三种任务形态:要判对错的、要给选项的、要按顺序走的。这个分类很好用,比"高级设计模式"这个名字朴素得多。
05 章两行命令看完就走,别指望它教你排错。
04 章的平台对比和 P0175 的"蒸馏宇宙"表,当广告看。它告诉你这个圈子在做什么,不告诉你做得好不好。
这本书真正教给人的,不是"怎么写一个 Skill",是一个更朴素的念头:你反复纠正 AI 的那些话,本来就该写下来。它把"每次都要说一遍"变成"说一次就够了"——这件事的价值不在省时间,在于它逼你把模糊的偏好说成可判定的句子。而一个人能不能写出好 Skill,取决于他能不能把"我要简洁"拆成"每段不超过三句",跟模型多聪明关系不大。
阅读记录:《Agent Skills 橙皮书:给 AI 装技能的完全指南》· 微信读书网页版逐页翻页截图 · 全书 181 屏、10 章 79 节 · 阅读用时约 6 分 30 秒 · 2026-11-04
核对页:P0006(七个 Skill 的写作流水线与"不是更聪明,是更懂你")、P0030(黄金区间 500–2000 字、5000 字失败案例、菜谱类比)、P0035(创作与审校打架及三条解法)、P0063(两行 mkdir 安装、没有第三步)、P0135(依赖图、文件与 git 协调、人工 review)、P0175(16 个人物视角 Skill 与"设计亮点"表)
发表评论: