
一本书讲透 Agentic AI:39% 的年增长,配 40% 的项目死亡率
微信读书《一本书讲透 Agentic AI》· 王吉伟 著 · 四部分:市场格局 / 技术原理 / 业务流程应用 / 行业案例
逐页翻阅 110 屏(读至第 7 章行业案例)· 2026-11-04
说明:这本书我只读到了第 7 章,后面的伦理与治理部分没进。我核对的位置是:P0006(市场数据与 Gartner 的两组预测)、P0033(智能 Agent 结构五模块图)、P0040(A2A 与 MCP 协议对比)、P0062(企业流程痛点清单与目录,作者王吉伟)、P0078(Agentic 业务流程分析工具四类)、P0108(Netflix 案例)。以下判断只在这个范围内成立。
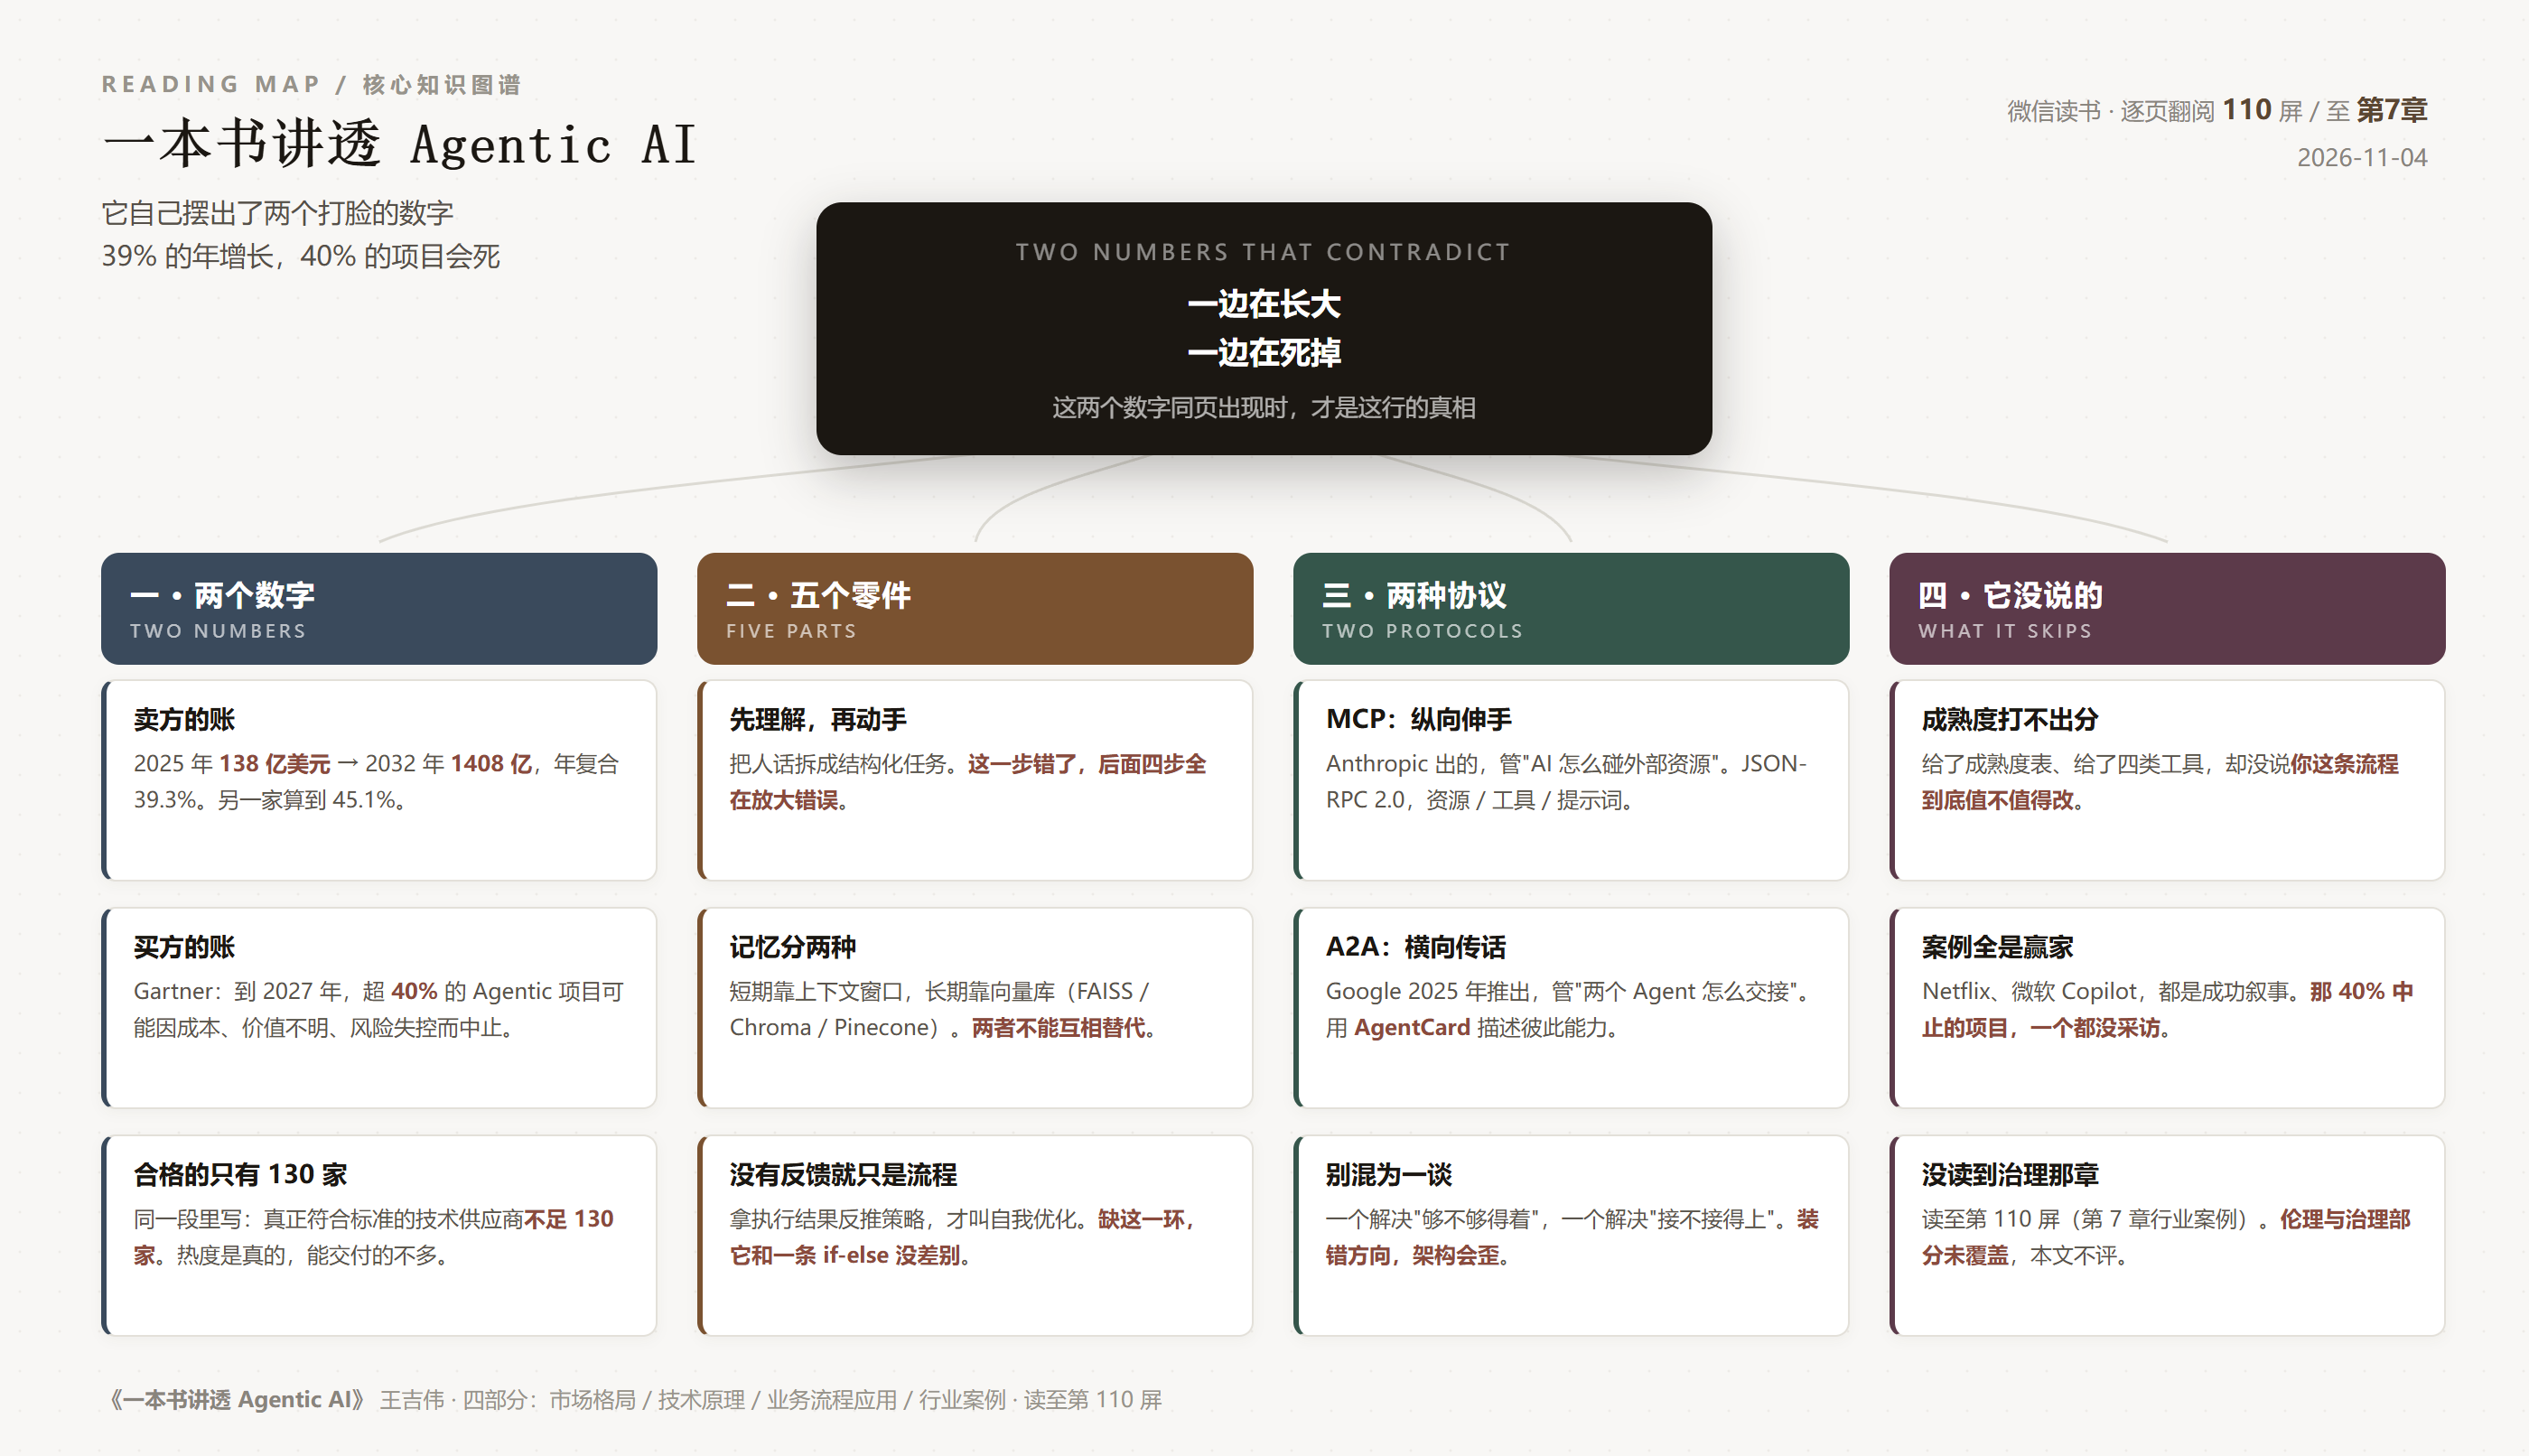
先说一个我读完最直接的感受:这本书最有价值的地方,是它自己把两个互相打脸的数字放在同一页上,然后没有去处理这个矛盾。
一页讲市场规模:Gartner 把 Agentic AI 列为 2025 年十大战略技术趋势之首,预测到 2028 年全球 15% 的日常决策将由 AI Agent 自主完成;MarketsandMarkets 的数据是 2025 年 138 亿美元增长到 2032 年 1408 亿美元,年复合增长率 39.3%;Grand View Research 算的是 2024 年 54 亿到 2030 年 503 亿,年复合 45.1%。
紧接着,同一页的下一段:Gartner 预测,到 2027 年超 40% 的 Agentic AI 项目可能因成本上升、价值不明或风险失控而中止,且当前真正符合标准的技术供应商不足 130 家。
一个 39% 的年复合增长,配一个 40% 的项目死亡率。这不是矛盾,这是一个行业在同时经历"大量下注"和"大量失败"。而这两件事之所以能同时成立,恰恰因为有 130 家供应商在卖,2000 个项目在买。
我读过不少讲 Agent 的书,绝大多数只引前半段的数字。这本把后半段也抄了进来——虽然它抄完就翻页了,没有停下来问一句"那我们怎么避免成为那 40%"。但光是肯把这个数字放出来,它就已经比同类诚实了一个档次。
一、它给 Agent 拆了五个零件,其中第三个最容易被跳过
第 3 章的技术部分有一张图(图 3-9 智能 Agent 结构示意图),把 Agent 分成五个模块,我认为这张图比整章文字都清楚:
1. 任务感知与理解:解析用户自然语言指令,转化为结构化任务目标。
2. 任务规划与推理:使用 CoT 和 ToT 等机制分解复杂目标为可执行任务。
3. 工具调用与执行:通过函数调用或 API 集成完成现实世界操作。
4. 记忆管理:上下文窗口实现短期记忆,向量数据库实现长期记忆。
5. 反馈与自我优化:接收反馈进行自我评估和调整,优化执行策略。
这五个零件里,前两个是所有"提示词工程"在管的,第四个是所有"RAG"在管的,第五个是所有"评测"在管的。而第三个——工具调用与执行——才是"Agent"这个词区别于"聊天机器人"的唯一理由。
书里对记忆这一节的写法,我觉得比很多资料准确。它明确把记忆分成两套:"通常通过 LLM 的上下文窗口实现短期记忆,并结合外部向量数据库(如 FAISS、Chroma、Pinecone)实现长期记忆。"
这个二分之所以重要,是因为它承认了一件事:上下文窗口和向量库不是同一种东西的两种实现,它们解决的是两种不同的忘记。上下文窗口的问题是"这一轮记不住上一轮",向量库的问题是"这个月记不住上个月"。前者靠扩容(更长的窗口)能缓解,后者靠扩容无效——你不可能把三个月的对话全塞进去。
而第五个零件"反馈与自我优化",书里写得很客气:"Agent 能够接收环境、用户或模型自身的反馈,并利用这些反馈进行自我评估和调整,优化未来的任务执行策略。"
这句描述是对的,但它掩盖了一个工程现实:"自我评估"这件事,Agent 做不好。因为评估需要标准,而标准通常在外面——在业务方的验收清单里,在用户的复购率里,在事故报告里。一个只能拿"模型自身的反馈"来评估自己的 Agent,等于让学生自己判卷。它会把"我说得通顺"当成"我做对了"。
书里没有展开这一点。它把"反馈"当成了一个已经存在的输入,而不是一个需要建的东西。这可能是全书最大的一个省略——因为那 40% 中止的项目里,我猜有一大半是死在这里:没人能说清它到底做对了没有。
二、MCP 和 A2A 的区别,它讲得比大多数文章清楚
第 4 章讲通信协议,把几个协议并排比较。A2A 和 MCP 这两段,是我在这本书里收获最直接的部分:
A2A 协议:Google 于 2025 年推出,旨在促进不同智能体高效协作与通信,核心特性包括基于开放标准、支持安全协作、多模态交互、任务状态管理和能力发现。
技术特点:通过 AgentCard(JSON 格式元数据文件)描述智能体能力,借助 A2A Server 处理请求和管理任务生命周期,A2A Client 提供标准化接口,强调安全性且与 OpenAPI 兼容。
适用场景:智能客服、开发协作、数据分析等企业自动化场景。
MCP 协议:Anthropic 开发,解决 AI 模型与外部资源的交互问题,核心特性包括标准化资源访问接口、完善的安全机制和模块化设计,支持多种数据传输方式。
技术特点:采用 JSON-RPC 2.0 作为通信协议,通过标准化提示词模板实现工具发现,为 LLM 提供工具访问和上下文管理能力。
这两段放在一起,差别一目了然:MCP 管的是"AI 怎么伸手拿到东西",A2A 管的是"两个 AI 怎么把活交接过去"。
书里那句"AgentCard 描述智能体能力"很关键。这意味着 A2A 的核心不是"传输",是"发现"——一个 Agent 要先知道对面那个 Agent 会干什么、要什么参数、返回什么,才谈得上委派。而 MCP 里对应这个角色的是"工具描述",两者结构上几乎同构,只是对象不同:MCP 描述工具,A2A 描述同行。
我把这个区分理解为一条很实用的判断:纵向用 MCP,横向用 A2A。你的 Agent 要去读数据库、调 API、查文件,那是纵向,用 MCP;你的 Agent 要把"这批合同审完了"交给另一个专门做归档的 Agent,那是横向,用 A2A。
混用会出问题。最常见的错,是拿 MCP 去做多智能体协同——把一个 Agent 包装成一个"工具"暴露给另一个 Agent。这能跑起来,但它丢掉了一样东西:任务状态。A2A 的设计里有"任务状态管理"和"任务生命周期",因为 Agent 之间的委派不是一次函数调用,是一个可能持续几小时、可能中途改主意、可能失败要重来的过程。而 MCP 的调用模型是请求-响应,它默认"调用完就结束"。用一个短连接的模型去承载一个长过程,最后一定会退化成轮询和超时。
这本书没有讲这个坑。它把两个协议平铺着介绍了,没有说"什么时候你会选错"。但从它给出的技术细节里,这个判断是可以自己推出来的——这正是"讲透"和"讲全"的区别:讲全的人会把所有协议列一遍,讲透的人会告诉你哪个场景会踩雷。这本偏前者。
三、它列了十三种病,这是一份很好的立项清单
第 5 章讲业务流程,开篇列了一串"企业为什么需要 Agentic AI"的痛点。我截到的是第 6 到 13 条,摘几条看看它的颗粒度:
6) 技术债务与遗留系统:企业依赖老旧……
7) 客户与员工体验不佳:传统流程忽视体验,工作烦琐枯燥。
8) 数字化转型与市场竞争压力:传统流程难以应对市场竞争及消费者个性化需求。
9) 效率与成本问题:大量手动操作和重复劳动,人力、错误、时间成本高,依赖纸质……
10) 数据与适应性问题:部门系统不集成,流程固化,难以响应市场、客户需求及法规变化。
11) 客户与员工体验问题:客户响应慢,员工陷入大量重复性低价值工作,使用过时工具。
12) 合规与技术问题:手动和纸质流程缺乏数据支持,信息滞后;业务量增长时难以扩展,效率低下。
13) 技术架构问题:企业存在多个异构系统,各自为政,缺乏统一流程编排视角……
这份清单有个明显问题:第 7 条和第 11 条是同一个病,第 9 条和第 12 条也大面积重叠。作者显然是从不同来源(可能是不同企业的访谈或不同报告)把这些痛点汇总过来的,没有做去重和归并。作为清单它够用,作为分析它不合格。
但换个角度看,这份"不合格"反而有用。它是一份真实的企业病历时,而不是整理过的教科书。十三条里有重复、有交叉、颗粒度不一("技术债务"和"员工用着过时的工具"根本不是一个层级的问题),这恰恰是一线调研的样子。
如果我要拿它做立项,我会做一件事:把这十三条按"能不能被 Agent 改"重排一遍。你会发现结果很不一样——"效率与成本"和"响应速度"这类,Agent 能改;"技术债务"和"异构系统各自为政"这类,Agent 改不了,它只会让债更重(因为又多了一个系统)。而这两类在书里是并列排着的,没有任何区分。这就是我前面说的"讲全"和"讲透"的差距。
第 6 章那张表(表 6-7,Agentic AI 业务流程分析工具的主要类别)倒是写得比较专业。它把工具分四类:智能流程发现与建模工具(自动连接 ERP、CRM,画 As-Is 流程图,识别理论与实际的偏差)、实时监控与预测分析 Agent(持续监控流程,检测异常,故障前预警)、流程优化与模拟 Agent(生成多种 To-Be 方案,用仿真评估对效率、成本和风险的影响)、智能自动化与编排平台(协调 RPA、API 和人类员工,自主执行流程任务)。
As-Is → To-Be → 仿真 → 编排,这个四段式其实是标准 BPM 的老路子,作者把它和 Agent 一一对应上了。这个映射是有效的,因为它回答了一个很实际的问题:Agent 到底插在流程改造的哪一步?答案是:每一步都能插,但插法不一样。
而"仿真"那一格,我认为是最被低估的。流程改造最大的成本不是改,是改错。拿 Agent 去模拟"如果我这样改,成本和周期会变成什么样",比拿它去执行,价值更高也更安全——因为仿真错了不赔钱,执行错了要赔。但绝大多数企业买 Agent 是为了省人力,不是为了做仿真。这就是需求和能力之间那道很现实的错位。
四、它的短板:所有案例都是赢家
第 7 章讲行业应用,我读到的案例是 Netflix。写法很标准:先列业务挑战(内容端爆款难预测、用户端"选择过载"、运营端本地化成本高、战略端竞争激烈缺数据化决策工具),再给解决方案(专业 AI Agent 构成的分布式生态系统,贯穿内容制作、用户服务、运营管理全链路)。
问题是:这套写法,和前面那 40% 的中止率完全不在一个世界里。
一本讲 Agentic AI 的书,最该写的一章是"那些失败的项目到底怎么死的"。而这一章从头到尾都是成功叙事——Netflix 的分布式 Agent 生态、微软 Copilot 帮 BDO Colombia 减少 50% 工作量且准确率 99.9%。这些案例我信,它们是真的。但它们是被选出来的。
幸存者偏差在技术书里特别危险,因为读者会拿它当模板:"Netflix 这么干成功了,我们也这么干。"而 Netflix 的成功前提是它有海量数据、有自研基础设施、有能承受失败的现金流。这三样缺一样,同样的架构就会变成那 40%。
第二,那两组数字它没有对齐。我看到 39.3% 的增长和 40% 的中止并列出现,但全书没有一章去解释"为什么这两件事能同时发生"。这不是苛求——恰恰是这本书最该回答的问题。一份把市场规模和失败率都抄进来的报告,如果不解释两者的共存机制,那它就只是一份资料汇编。
第三,"成熟度评估"给了表,没给判据。第 6 章有"流程自动化成熟度评估"和"Agentic AI 能力评估与选型"两节,按标题看是全书最实用的部分。但它给的是评估维度(流程标准化程度、数据可得性、组织准备度这类),不是判断标准——你能填完一张表,但填完之后仍然不知道"我们该不该上"。
我理解为什么难写。因为"该不该上"的答案不是一个通用模型,是一道算术题:这条流程一年的人工成本,减去 Agent 的开发、调试、监控、纠错的成本,再减去出错时的损失期望,如果还是正的,才该上。这道题里每一项都要用企业自己的数,书上给不了。但书至少可以给出这个算式的形式,让读者自己去填。它连形式都没给。
第四,一句诚实的说明:我没读到治理和伦理那一章。书里在 P0006 引过 Meta 首席 AI 官 Alexandr Wang 的警告——"不规范部署超级智能 Agent 或导致灾难性后果,亟须同步制定政策与构建基础设施"。这句警告如果后面有专门章节展开,那本书的完整性会比我现在看到的更好。我读到的部分,只到第 7 章的行业案例。
五、它适合谁,以及怎么读它
如果你是要给老板写一份"我们要不要做 Agent"的材料,这本书有用:市场规模数据可以直接引(记得把 40% 那一句也引上,否则会被懂行的人问住),企业痛点那十三条可以当调研清单,四类工具那张表可以当选型框架。
如果你是要动手做的人,这本书的技术部分偏浅。五模块结构图画得清楚,但每一块都没有深入到"怎么实现";协议对比有信息量,但没讲踩坑。你需要的是官方文档和真实项目。
如果你是想判断这波热潮能持续多久的人,我建议只读 P0006 那一页。39.3% 和 40% 这两个数字放在一起,比整本书都更能说明问题:这是一个需求真实、供给混乱、失败率极高的市场。在这样的市场里,最赚钱的往往不是做事的人,是卖工具给做事的人的那批——而这本书,恰好就是那批人写的。
一本书肯把"40% 的项目会死"和"39% 的年增长"印在同一页,已经算诚实了。但它抄完这个数字就翻页了,没有回答那个真正的问题:既然一半会死,凭什么死的不是你。而这个问题,恰恰是每个准备掏钱的人最该问的。
阅读记录:《一本书讲透 Agentic AI》· 王吉伟 著 · 微信读书网页版逐页翻页截图 · 已读 110 屏(至第 7 章行业案例)· 阅读用时约 6.5 分钟 · 2026-11-04
核对页:P0006(市场规模与 Gartner 双预测)、P0033(智能 Agent 结构五模块图)、P0040(A2A / MCP 协议对比)、P0062(企业流程痛点 6–13 条与目录)、P0078(业务流程分析工具四类)、P0108(Netflix 案例)
发表评论: