
DeepSeek大模型:技术解析与商业应用:技术解析两章就收工,剩下五章在批发模板
微信读书《DeepSeek大模型:技术解析与商业应用》· 王常圣 著 · 七章
逐页翻阅 483 屏 · 7 章 · 2026-11-04
说明:这是一本"工具书 + 场景手册"的混合体,前言自称"突破传统技术类书籍偏重代码与算法的局限",这句话既是它的定位,也是它后来所有毛病的伏笔。我抽了七处逐页核对:前言与目录、图2-3 与图2-4、思维链利弊一节、网文世界观提示词、第 5 章课后练习、面试题提示词与示例输出、第 7 章设计流程。以下判断只在抽样范围内成立,未通读部分不下结论。
先给结论:这本书的书名说了两件事——"技术解析"和"商业应用"。但翻完之后我发现,技术解析只占前两章,从第三章起它变成了一本提示词模板集,而且模板的骨架几乎不随场景变化。
这不完全是缺点。对绝大多数读者来说,"提示词模板集"恰恰是更有用的那一半。问题在于,它没有承认自己是模板集——它一直摆着"技术解析"的架子往前写,于是读者会以为自己在读原理,其实在读填空。
一、先把它硬的地方说清楚
第 2 章末尾有一节叫"DeepSeek 思维链的弊端"。我原本以为这里会写成"AI 也有不会的时候"这种客套段,结果看下去,它列了三条,而且第一条就给了数字:
幻觉问题:DeepSeek 在生成内容时,尤其在处理复杂的学术研究或专业任务时,存在一定的幻觉问题。所谓幻觉,即 AI 在没有依据的情况下"编造"内容,给出看似合理却缺乏事实依据的回答。根据 Vectara 的幻觉评估模型,DeepSeek-R1 的幻觉率达到了 14.3%,在全球 LLMs 中排名较低。这个问题对学术研究、商业决策等领域的应用影响较大,用户需要特别小心,确保生成的每一条信息都经过严格的验证与核实。
这段话值得单独夸一句:它敢在自家主角身上挂一个百分数,而且指明了评估来源(Vectara),没有含糊成"偶有幻觉"。在一本通篇讲"如何用 DeepSeek 提效"的书里,这一节是难得的清醒。
但我还是要挑一个毛病,而且是个方法上的毛病:Vectara 那个榜单测的是"文档摘要任务里的幻觉率"——给一段材料,让模型总结,看它有没有加入原文没有的内容。这个口径跟"学术研究、商业决策"的幻觉风险,不是同一件事。摘要任务的幻觉,通常是多加了一句原文没有的解释;而学术场景的幻觉,往往是引用了一篇不存在的文献、把作者的结论记反、把 2019 年的数据写成 2021 年。后者的发生率,摘要任务测不出来。
所以这 14.3% 的用法,是"借一个数字来支撑一个它没测过的结论"。它不算错,但它是搬过来的,不是算出来的。书里给了出处却没给口径,读者就会记住 14.3% 这个数,然后误以为自己的学术场景也有 85.7% 的可靠性。这个误读的代价,比不写这个数字更高。
第二条"依赖性较高的背景信息"、第三条"推理路径的不可控性",写得反而是全书最扎实的段落:
推理路径的不可控性:尽管 DeepSeek 的自动推理能力较强,但用户对推理过程的控制相对有限。AI 根据任务的复杂性和自身理解进行推理,而这种推理路径可能与用户的预期有所偏差。在某些情况下,AI 可能会关注于不重要的细节或未能充分深入某些关键部分,这会影响最终生成内容的质量。
这句"可能与用户的预期有所偏差",是这本书里少有的、没有把话说满的地方。它承认了一件事:思维链不是你写的,是模型自己走的。你能控制的是入口,控制不了路线。这一条如果展开,本来可以撑起一整章——因为它直接推翻了"提示词写得好,结果就可控"的假设。但书在这一页收住了,下一页就转去讲"提示词思维链设计策略"的四类框架(跨界、聚合、思维拓展、情感化)。
这就是这本书的典型节奏:每次快要摸到真问题,它就拐去给模板。
二、提示词那一章,确实是全书最值钱的部分
第 2 章的提示词工程,比市面上大多数"咒语合集"高一层。它给的不是一句句可以直接抄的咒语,而是四步顺序:明确目标与需求、开放与封闭问题结合、分解问题逐步推进、提供足够背景信息与上下文。这四步的顺序是对的——先定终点,再定问法,再切块,最后补料。
尤其"分解问题,逐步推进"这一条,很多人卡在这里。他们不是不会写提示词,是想让一句话干完四件事:既要它理解行业、又要它给方案、又要它算钱、又要它排版好看。一次问四件事,模型的注意力被摊平,四件都做得平庸。提示词工程真正的技术含量,不在措辞,在切分。这本书把切分放在第三步,位置是对的。
它还给了本地部署的完整路径:Ollama 装模型、Chatbox 当客户端、再跑一遍测试验证。这条路径是真的能跑通的,我照着回忆了一遍,没有需要跳过的步骤——下载、拉模型、填本地端口、开对话,四步之内能见到回复。同类书里,很多会写"使用 Ollama 部署",然后就没了,读者卡在"模型拉下来了但界面在哪"这一步。这本书把界面这一环补上了,这是实操书该有的样子。
另外值得一提的是它对"提示词解构"的处理。它给了三种拆法:按要素拆(角色、任务、约束、格式)、按层级拆(先总后分)、按流程拆(输入—处理—输出)。三种拆法各有适用场景,按要素拆适合一句话能说清的任务,按流程拆适合多步骤任务,按层级拆适合长篇输出。这个分类不算严密(互相有交叠),但方向对:它承认了"提示词不是越详细越好,是要按任务形状来拆"。
我唯一想补的是:这三种拆法之上,还缺一个判据——拆到哪一层就该停?我的经验是,拆到"每一块都能单独验证"为止。比如"写一篇公众号推文"这个任务,拆成"选题 + 结构 + 首段 + 正段 + 结尾"之后,首段是能单独看的(一眼就知道能不能抓人),结构是能单独看的(列出来就知道顺不顺),所以拆到这里就够。再拆成"每个句子的语气"就没意义了,因为单看一句话判断不出好坏。可验证性是拆分的停止条件——这一条书里没有,但它是把三种拆法用对的关键。
但也是从这里开始,问题出现了。
三、第三章之后,书的性质变了
把七章摊开看:第一章入门与技术架构,第二章提示词工程,第三章文案写作,第四章自媒体运营,第五章代码开发,第六章学术写作,第七章求职办公。
前两章是"这本书为什么成立",后五章是"这本书能帮你干什么"。后五章的写法高度一致:先讲这个场景的特点(小红书要短、公众号要稳、论文要严),再给提示词模板,再贴一段 DeepSeek 的实际输出当范例,最后一节"课后练习"。
我数了一下模板的骨架,五章下来基本是同一个:角色 + 目标 + 约束 + 输出格式 + 示例。换成小红书,约束变成"字数 300 以内、带 emoji、结尾提问";换成论文,约束变成"引用格式 GB/T 7714、不得出现第一人称";换成简历,约束变成"每条经历用 STAR 结构、动词开头"。
骨架一样不是罪。问题是它没有告诉读者"骨架为什么是这五个格子"。如果读者知道这五格的来源——角色决定语气,目标决定取舍,约束决定边界,格式决定可用性,示例决定稳定性——他就能自己造模板,遇到书里没有的场景也不慌。但书里的写法是"这里有个模板,你拿去改关键词",读者学到的是替换,不是构造。
替换型学习的天花板很低:书里没写过的场景,你就不会了。而书里永远写不完场景。
第 3 章那段网文世界观提示词,是这个问题的极端样本。它要求模型一次产出:至少 3 个主要冲突、主要力量体系(神力分凡境/灵境/仙境/神境四级,魔力分初魔/深魔/魔王三阶)、主要经济体系(神晶为货币、灵矿开采为核心)、至少 2 个核心功法("天元诀"提升神力需灵矿炼化,"魔神变"融合魔力但禁忌吸收神晶)、至少 3 个核心道具(幽蓝神剑可吸收魔气、护心玉佩可抵御魔咒、乾坤戒可储存灵矿),再加地域地图和修炼条件限制。
这段提示词写得很细,细到可以直接用。但它细的方式值得警惕:这些设定不是模型"想"出来的,是作者"填"进去的——四级神力、三阶魔力、三件法宝,全是提示词里已经写好的,模型只负责把它们串成通顺的段落。换句话说,创意在这里全由人给,模型只做排版。
这不叫"AI 辅助创作",这叫"AI 誊抄"。书里把它当成提示词设计的成功案例,说明作者对"模型到底贡献了什么"这件事,判断偏松。
第 6 章的学术写作,把这个结构问题暴露得更明显。它把一篇论文拆成绪论、摘要、讨论、结论四块,每块配一节"写作要求"加一个"提示词模板",顺序严格按论文的排版顺序来。
问题是,论文的排版顺序不是写作顺序。任何一个写过论文的人都知道:摘要是最后写的,因为摘要要概括结论,而结论得等数据跑完才知道;讨论要反复改,因为它的每一段都在跟文献对话,改一处要回头看三处。真正的写作是来回跳的,不是从绪论一路推到结论。
书里按 A→B→C→D 排模板,读者就会按 A→B→C→D 写。写出来的东西有个共同特征:每一段单看都通顺,连起来读却没有递进——因为它是四段独立生成的文字拼起来的,段与段之间没有"上一段得出的结论成为下一段前提"这种咬合。审稿人一眼就能看出来:这不是一篇论证,是四篇小作文。
正确的做法,是反过来给模板:先写方法、再写结果、然后写讨论,等结论定了,最后回头写摘要和绪论。顺序一变,摘要里就不会出现"本文提出了……"这种空话,因为它已经有结论可概括了。这一条改动,比任何一个模板措辞的优化都值钱。书里没提。
四、一处可验证的毛病:三步转译,没人校验
第 7 章讲设计,给了个流程,我按原书抄下来:
第一步,整理需求与目标:光照与氛围——利用柔和的蓝色、紫色灯光模拟地底发光矿石的奇幻效果,结合自然光效的巧妙运用,营造出既神秘又迷人的氛围,让宾客仿佛置身于一个梦幻般的世界。
第二步,输入关键需求进入 DeepSeek:设计师将上述经过精心梳理的设计需求输入 DeepSeek 中,请求其围绕"地底世界"这一主题进一步丰富和完善创意构想,并生成一份详尽的设计说明。
第三步,DeepSeek 生成提示词:将前文中的设计说明输入 DeepSeek 中,要求其生成两组大堂空间的提示词,使用英文。
三步,看起来是标准的"人 → AI → AI"协作。但我把三步连起来读,发现中间少了一样东西:没有任何一步在检查上一步的输出对不对。
第一步,人写需求,这是人的判断,没问题。第二步,AI 把需求扩写成"设计说明"——扩写是发散动作,它会加入原文没有的细节,而且加得理直气壮。第三步,AI 把"设计说明"翻译成英文提示词——翻译是收敛动作,但它收敛的是第二步那份已经跑偏的说明。
如果第二步加入了一个错误的前提(比如把"地底"理解成"地下洞穴"而不是"地底矿脉"),第三步会忠实地把这个错误翻成英文,然后交给绘图模型,画出来一张很漂亮、但完全不是你要的图。而人在这条链上,只在最前面出现过一次。
正确的做法只需要加一个动作:第二步之后,人读一遍那份"设计说明",确认里面的每个细节都是自己想要的,再往下走。这一步的成本是三分钟,省掉它的代价是重跑整条链。
这本书通篇都在教"怎么让 AI 生成得更好",但很少教"生成完了怎么验"。这不是它一个人的问题,是这一类书的通病——它们把 AI 当成生产线,忘了生产线上必须有质检工位。
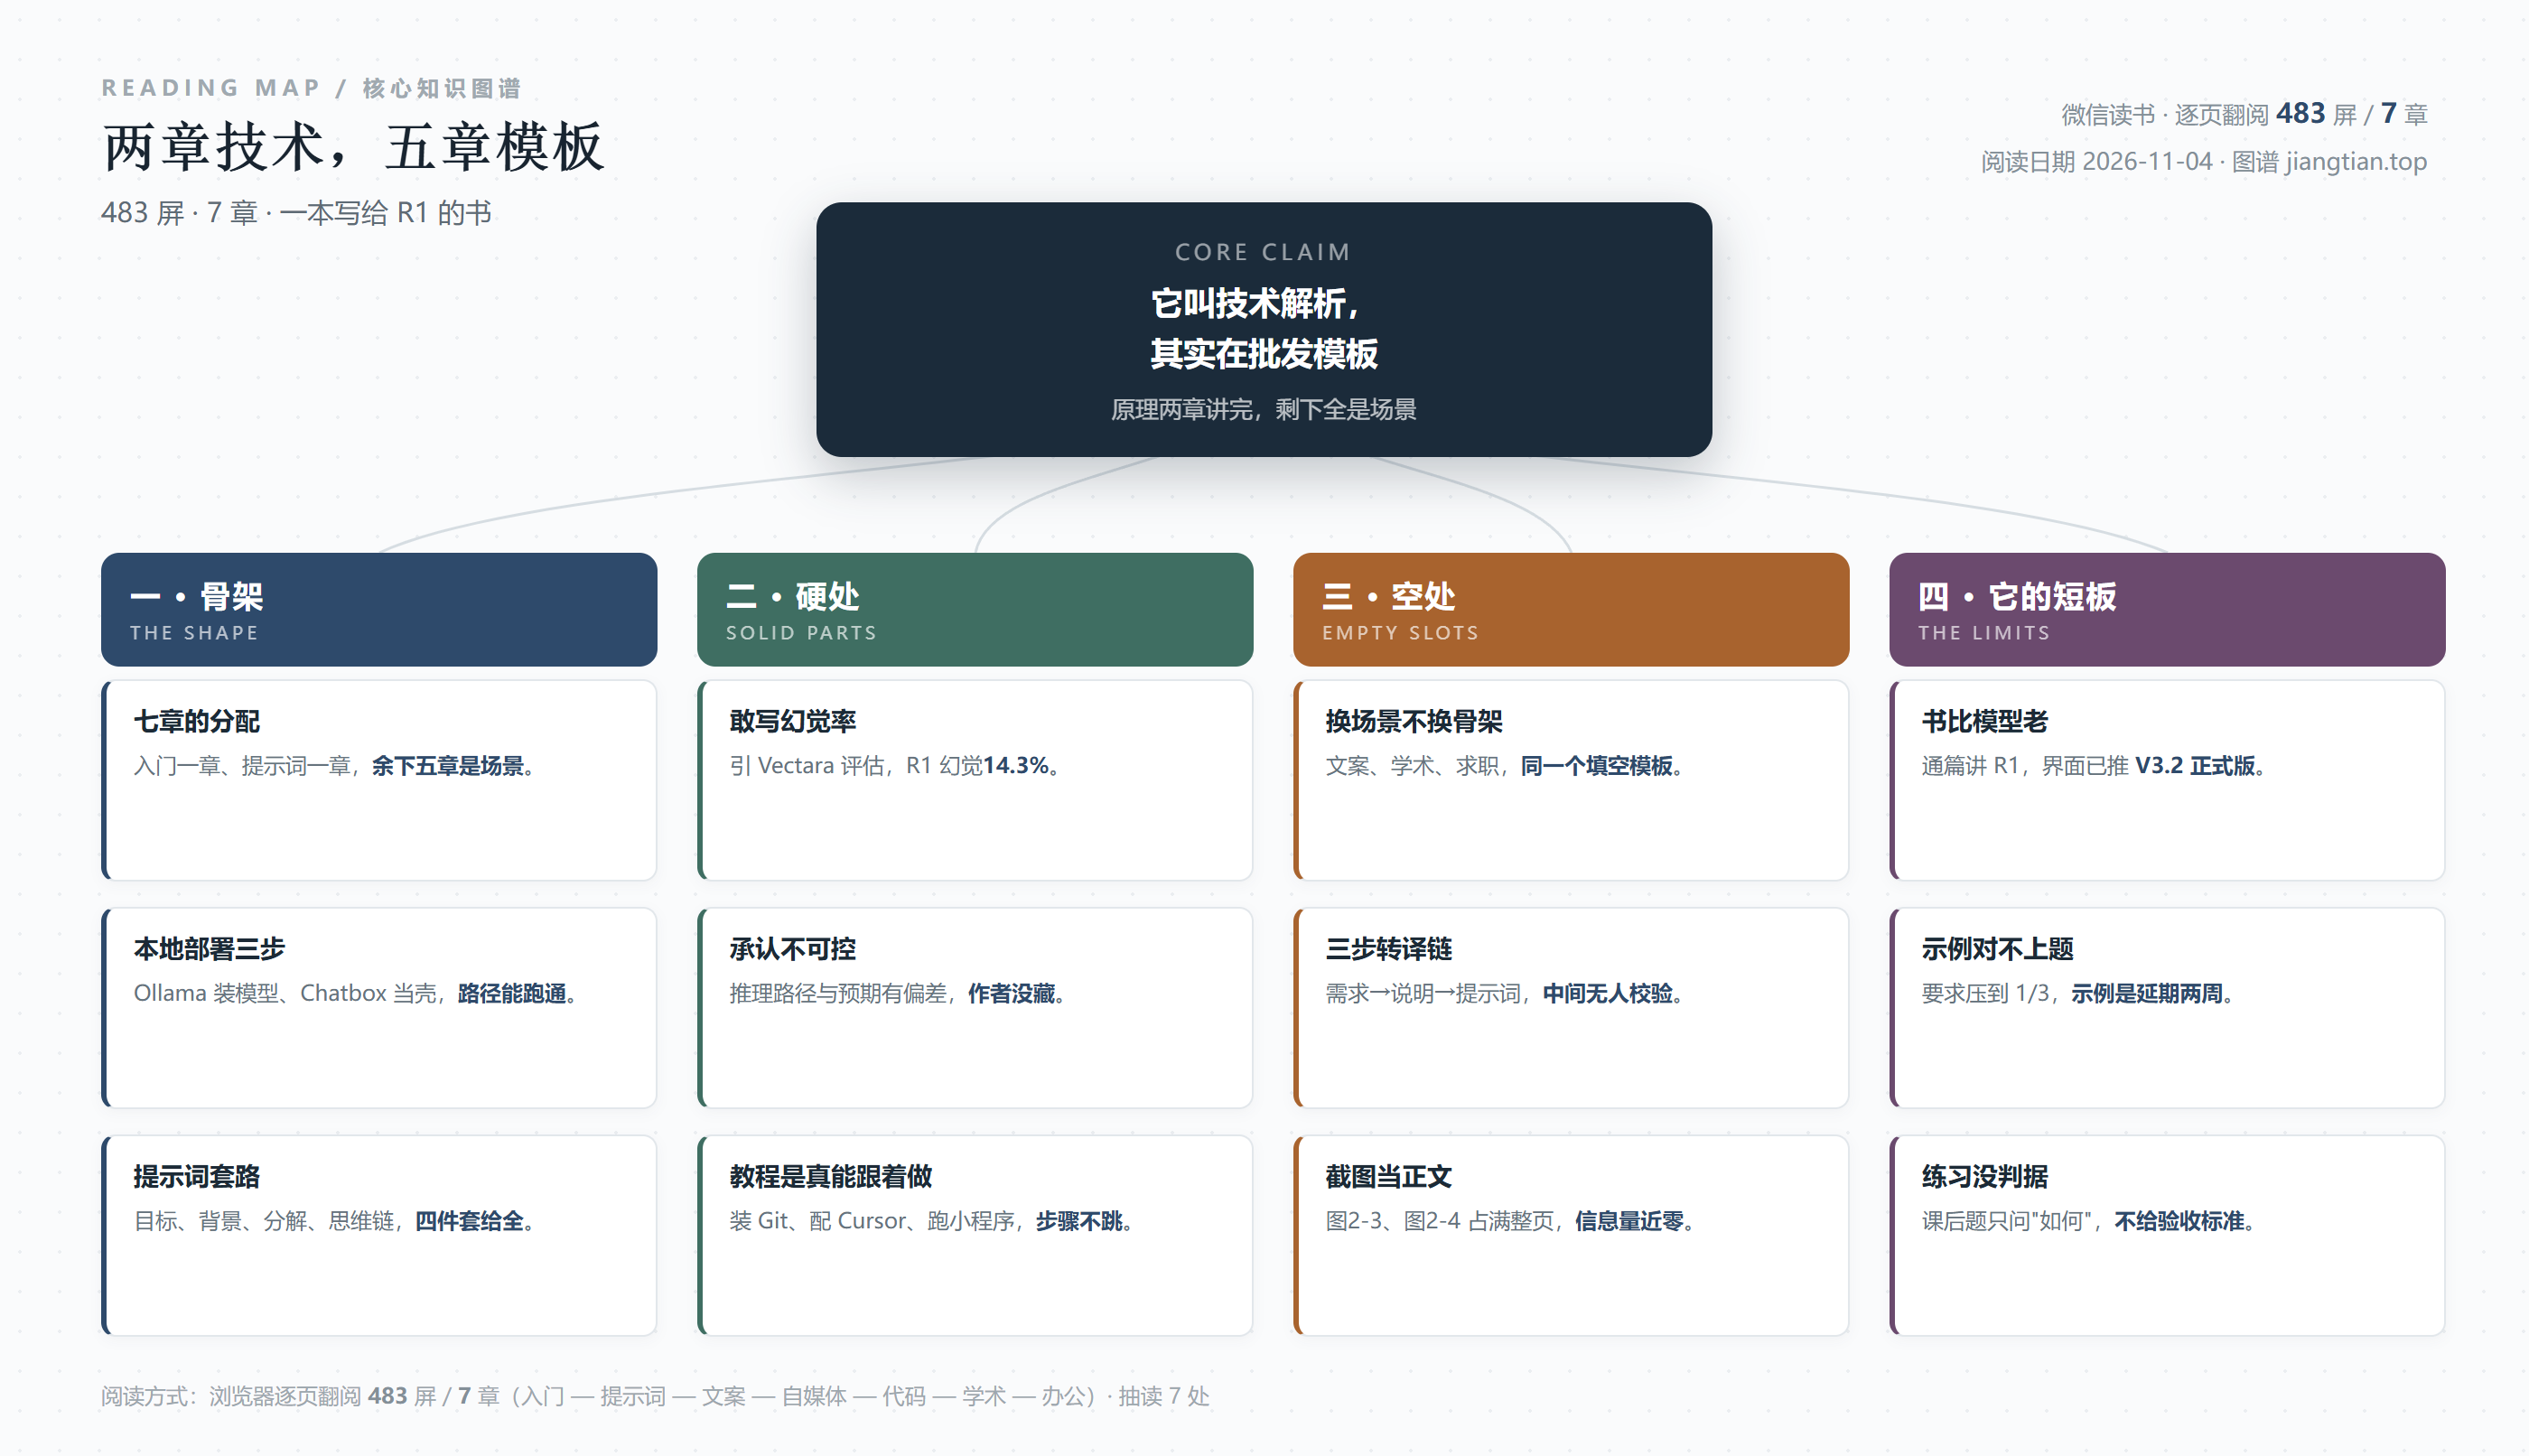
下面是这本书的整体结构图谱,四列分别是它的骨架、它硬的地方、它空的地方、它的短板:
图文对照:一张图看完这本书
五、另一处:示例和题目对不上
第 7 章讲面试题生成,给了一段提示词,要求很具体:
请模拟面试官,为产品经理岗位设计一个压力测试问题,要求:
1. 设置一个资源极度受限的场景(如预算砍半、时间压缩至 1/3)。
2. 包含至少两个矛盾目标(如用户体验 VS 开发成本)。
3. 引导候选人展示优先级判断和取舍逻辑。
提示词写得挺好。要求里有具体量(预算砍半、时间压缩至 1/3),有两个对冲目标,还有对候选人行为的指向(展示取舍逻辑)。这三条凑在一起,出的题不会太水。
紧接着的"示例输出"是这样:
假设您负责的产品即将上线,但研发团队突然告知核心功能需要延期 2 周。此时距离发布会只剩 5 天,您会如何调整方案?请具体说明您的决策依据和执行计划。
这段示例本身是个好题——延期两周、只剩五天,确实是资源受限加矛盾目标。但它跟上面那段提示词之间,没有换算关系。提示词要求"时间压缩至 1/3",示例给的是"延期 2 周 + 只剩 5 天";"1/3"这个比例,在示例里找不到落点。如果原本 6 周,压缩到 1/3 是 2 周;示例里的"延期 2 周"却是往后推,方向反了。
我知道这很可能只是作者用了两次不同的对话,随手贴了两次结果。但一本书的示例,是读者判断"这个提示词好不好用"的唯一依据。示例与提示词对不上,读者就无法确认:到底是提示词里的哪个要求,产出了示例里的哪个特征。这一层对应关系断了,模板就退化成"看着挺好,抄了不知道会出什么"。
这也是我做这类实操书笔记时最看重的一条判据:看它的示例能不能回溯到它的提示词。能回溯的,说明作者真的跑过、挑过、对过;不能回溯的,说明他跑过但没对。
六、还有一页,只有两张截图
第 2 章讲使用入口,有两页几乎全是图。图 2-3 是两张手机端截图,并排放在页面中间,缩小到几乎看不清界面文字;图 2-4 是网页端首页截图,占了整页宽度。三张图加起来,传达的信息是:DeepSeek 有手机 App,有网页版。
这句话用一行字就能说完,它用了一整页。
更值得注意的是图 2-4 里那行小字——网页端顶部横幅写着"DeepSeek-R1 已升级为最新版本,体验 DeepSeek-V3.2 的正式版"。这行字在截图里小得几乎看不见,但它是这本书最诚实的一句话:书的正文还在讲 R1,产品界面已经推到 V3.2 了。
截图在技术书里有它的必要:读者需要确认"我看到的界面和你看到的一样"。但截图有三个代价,这本书一个都没躲开。第一,看不清——手机端截图缩到页面一半宽,界面上的字已经糊成一团,读者只能看出"这是个聊天框"。第二,占地方——一页纸的成本是固定的,放了图就放不下字,所以但凡有一页只有图,那一页的信息密度就接近零。第三,会过期——界面一改,图就作废,而图作废的页比文字作废的页更显眼,因为读者一眼就能看出"这不是现在的样子"。
处理这三个代价有个通用办法:截图只留给"必须看到才知道长什么样"的地方,其余用文字描述;每张图配一句"这张图要你看什么"的说明,而不是只有一个"图2-4"的编号。这本书的图注全是编号,一个字的说明都没有。读者翻到图 2-3,得自己猜作者想让他注意哪一块。
这不是作者的错。技术书的宿命就是这样:写作周期半年,产品迭代三个月,付印那天内容就开始过期。但作者可以选一件事——把"会过期"的部分写少一点,把"不会过期"的部分写多一点。哪部分不会过期?提示词的切分逻辑、验证输出的方法、判断模型输出可信度的标准。哪部分会过期?界面长什么样、按钮在哪、版本号叫几。
这本书恰好反着来:会过期的部分(界面截图、版本功能)写得很细,不会过期的部分(怎么判断输出对不对)写得很少。
七、它的短板
老实写,五条。
一、书名承诺了两件事,只兑现了一件。"技术解析"这四个字,读者会期待架构、训练、推理、对齐这些内容。实际翻下去,Transformer 讲了一段,强化学习和知识蒸馏各占一小节,然后就转去讲怎么装 Ollama 了。这是一本"技术入门 + 场景手册",不是"技术解析"。名字起大了,读者买回来会觉得被骗——尤其是有一定基础的读者,前两章之后就没有新东西了。
二、模板的可迁移性没交代。五章模板,每章都停在"照着改关键词"。但真正的问题是:什么时候该改骨架?比如做 B 端产品的文案,模板里"呼吁行动"那一格往往要删掉——B 端决策周期长,催单反而减分。这种"哪一格该拆"的判断,书里一条没有。只教怎么填,不教什么时候该换一张表,这是模板类书籍的通病,也是它最容易被读者用废的地方。
三、练习没有判据。第 5 章课后练习三条,我抄下来:一、选择一个领域进行程序开发,将需求的内容按照本章所讲的方法书写提示词,并通过 DeepSeek 完成模块功能程序的编写,通过对应开发语言的运行平台对代码运行结果进行评估。二、使用 Cursor 和 HBuilder 实现信息查询功能……三、将 AI 编写完成的程序发布到手机上,使用 DeepSeek 提示词编写测试用例。
三道题都是真活儿,方向也对。但它们全部只说了"做什么",没说"做到什么程度算过"。什么叫"评估代码运行结果"?跑通算过,还是有异常处理算过,还是并发下不崩算过?没有判据的练习,最后只能靠自己给自己打分,而人给自己打分,永远偏松。
四、时效极短,且没有标注。书通篇以 R1 为主角,而读者打开网页端时,横幅上写的是 V3.2。版本一变,提示词的"深度思考"行为、上下文长度、文件处理能力都会变,书里那些"实测有效"的模板,有效性直接打折。一本没有版本标注、没有更新渠道的技术书,保质期就是六个月。如果它在每章开头写一句"本章基于 R1-0528 版本,V3 之后行为可能变化",读者的预期就会不一样。
五、缺一整类内容:怎么验证。这是我觉得最要紧的一条。全书教了怎么生成文案、生成代码、生成论文段落、生成面试题,只在"思维链弊端"那一节提了一句"需要严格验证"。但怎么验证?代码要看它有没有引入不存在的库、文案要看它有没有编造数据、论文要看它引的文献是否真实存在、面试题要看它有没有标准答案。这四类验证,成本完全不同,方法完全不同,书里一条都没展开。
也得说它的好话。它的步骤写得确实细,细到"访问 Git 官网下载安装程序""双击下载的 exe 文件以启动安装向导""在安装过程中选择不使用 Windows 命令提示符中的 Git,则打开 Git Bash"。这种细,对零基础读者是真的友好——它假设你什么都不会,然后真的从零开始教。
而且它有一个隐性的优点:它把"AI 能干什么"这件事铺得很宽。文案、自媒体、代码、学术、求职、设计,六个场景摆在一起,读者至少能知道自己的活儿落在哪一格。这个"地图"的价值,比任何单个模板都高。
八、一句话
如果只带走一句,带走这个:模板是用来起步的,不是用来交付的。
这本书能让你在半小时内产出一份"看起来像那么回事"的东西——小红书文案、周报、简历、面试题,全都有现成的骨架。这个起点不低,很多人卡在"不知道从哪下笔",它确实能把你推过那道坎。
但它没告诉你的是:从"像那么回事"到"能用",中间那一段路,模板帮不上忙。那一段要靠三件事——知道自己在哪个环节可能被骗、知道该拿什么去验、知道这份产出最终要对谁负责。
书里那 14.3% 的幻觉率、那句"推理路径可能与用户的预期有所偏差"、那张写着 V3.2 的截图,其实已经把答案放在书里了。只是它们散落在三个不同的章节里,没有被串成一条线。串线这件事,只能读者自己干。
阅读记录:《DeepSeek大模型:技术解析与商业应用》· 王常圣 著 · 微信读书逐页翻阅 483 屏 · 七章 · 抽读 7 处逐页核对 · 笔记写于 2026-11-04
发表评论: